Dieser Blogbeitrag ist der zweite Teil einer Reihe über die Datenbereitstellung für KI.
Mit der zunehmenden Nutzung von KI müssen Datenpipelines noch schneller skalieren, um Engpässe zu vermeiden und die Leistungsfähigkeit aufrechtzuerhalten. Aktuelle Untersuchungen von Unternehmen wie McKinsey & Company zeigen, dass der Bedarf an KI-fähigen Rechenzentrumskapazitäten bis 2030 voraussichtlich um etwa 33 % pro Jahr wachsen wird. Das bedeutet, dass selbst die besten Modellarchitekturen nicht ausreichend mit Daten versorgt werden, wenn die Bereitstellungspipeline nicht entsprechend skaliert.
Doch mit der Skalierung von KI-Workloads erkennen Unternehmen schnell eine überraschende Wahrheit: Die Verlangsamungen entstehen nur selten beim Modelltraining oder bei der Feinabstimmung selbst, sondern in der vorgelagerten Datenpipeline, die die Modellfabrik kontinuierlich mit großen Mengen hochwertiger Daten versorgen muss.
“Neue Innovationen ermöglichen es F5 BIG-IP, die intelligente Datenverkehrssteuerung, Datenpfadoptimierung und Sicherheitskontrollen bereitzustellen, die erforderlich sind, damit KI-Daten in Trainings-, Embedding-Generierungs- und Feinabstimmungs-Workflows mit hohem Volumen und hoher Geschwindigkeit übertragen werden können.”
Moderne KI-Systeme sind auf einen schnellen, vorhersehbaren Datenfluss zwischen Objektspeichern, Abrufschichten, Feature-Pipelines und Workflows zur Generierung von Embeddings sowie gegebenenfalls Inferenzendpunkten angewiesen. Verlangsamt sich dieser „Fluss“, bricht die Leistung ein, GPUs bleiben ungenutzt und es dauert länger als erwartet, bis das Unternehmen einen Mehrwert erzielt.
Eine anschauliche Analogie ist die Ölpipeline, auf die wir im ersten Blogbeitrag dieser Reihe verwiesen haben. Sie können über die modernste Raffinerie der Welt verfügen – also über ein Large Language Model (LLM), eine Vektorsuchmaschine oder einen multimodalen Model-Foundry-Cluster, der für das Training, die Feinabstimmung oder die Erzeugung von Embeddings eingesetzt wird. Sind die Pipelines, die diese Raffinerie versorgen, jedoch zu eng, undicht oder verstopft, kommt die Produktion zum Erliegen. Nicht der Raffinerieprozess ist das Problem, sondern das Transportsystem. Für heutige KI-Pipelines gilt dasselbe Prinzip: Der Datenfluss bestimmt die Leistung des Systems.
Wo KI-Engpässe tatsächlich entstehen
KI-Pipelines brechen selten an einem einzigen Punkt zusammen; vielmehr werden sie entlang einer Kette von Mikrointeraktionen ausgebremst. Ein einzelner Workflow kann das Abrufen von Trainingsdatensätzen, unternehmensweiten Wissensbeständen oder Embeddings aus einem Objektspeicher, die Aufbereitung dieser Daten für die Aufnahme, Abfragen an einen Vektorspeicher und Zugriffe auf mehrere Microservices umfassen, bevor es schließlich an die Feinabstimmung oder Modellerstellung geht.
Jeder Schritt birgt potenzielle Reibungsverluste. Für sich genommen erscheinen die Verzögerungen unbedeutend, doch in ihrer Summe verlängern sie die durchgängigen Verarbeitungszeiten und führen dazu, dass GPUs nicht ausreichend mit den benötigten Daten versorgt werden – insbesondere bei umfangreichen Trainings- oder Augmentierungsaufgaben.
Das ist vergleichbar mit einer Ölpipeline, die unter vermindertem Druck, falsch ausgerichteten Ventilen und unerwarteten Lastspitzen leidet. Der Durchfluss wird ungleichmäßig, und nachgelagerte Anlagen erhalten nie eine stetige, planbare Versorgung. In KI-Modellfabriken tritt dasselbe Phänomen auf, wenn Speicherknoten langsamer werden, Netzwerkpfade an Leistung verlieren oder die Arbeitslast unvorhersehbar ansteigt.
Die vorliegenden Forschungsergebnisse zeigen überdeutlich: Leistungsprobleme bei KI gehen in der Regel auf die Datenpipeline zurück, nicht auf das Modell. In einer Fivetran-Umfrage gaben 42 % der Unternehmen an, dass mehr als die Hälfte ihrer KI-Projekte verzögert wurde, hinter den Erwartungen zurückblieb oder scheiterte, weil ihre Daten nicht rechtzeitig aufbereitet oder zugänglich waren.
Eine weitere Studie von Broadcom ergab, dass 96 % der Unternehmen nach eigenen Angaben durch Leistungsprobleme in der Datenpipeline unmittelbar beim Erreichen ihrer KI-Ziele beeinträchtigt wurden. Dies führte zu Verzögerungen bei Trainings- und Vorbereitungsworkflows, einem geringeren Automatisierungsgrad und kostspieliger Nacharbeit.
Diese Zahlen verdeutlichen eine entscheidende Wahrheit: Wenn Daten nicht schnell und zuverlässig durch die Pipeline fließen können, erzielen selbst die anspruchsvollsten Modellfabrik-Prozesse keine konsistenten Ergebnisse.
Wie F5 BIG-IP die Bereitstellung von KI-Daten modernisiert
Mit der Veröffentlichung von F5 BIG-IP Version 21 hat sich BIG-IP weit über seine Rolle als herkömmlicher Application Delivery Controller (ADC) hinausentwickelt. Es dient nun als vollständig modernisierter ADC für KI-gestützte Datenpipelines, insbesondere für solche, die auf S3-kompatiblem Objektspeicher basieren.
Neue Innovationen ermöglichen es F5 BIG-IP, das intelligente Datenverkehrsmanagement, die Optimierung des Datenpfads und die Sicherheitskontrollen bereitzustellen, die erforderlich sind, damit KI-Daten nicht nur bei der Inferenz, sondern auch in Workflows für Training, Embedding-Generierung und Feinabstimmung mit hohem Volumen und hoher Geschwindigkeit übertragen werden können.
Es wurde entwickelt, um den gesamten Datenfluss zu stabilisieren und zu beschleunigen. Als Bereitstellungsebene zwischen dem Objektspeicher und dem KI-Anwendungs-Stack sorgt es dafür, dass Dateneingang, Abruf und Routing selbst unter hoher Last reibungslos, sicher und ausfallsicher bleiben.
BIG-IP überwacht kontinuierlich den Zustand der Speicherknoten und leitet den Datenverkehr automatisch von langsamen oder ausgefallenen Endpunkten weg. S3-spezifische Optimierungen, etwa verbesserte TCP/TLS-Profile für große mehrteilige Uploads, tragen dazu bei, den Anfrage-Overhead zu reduzieren und Lesevorgänge mit hohem Datenvolumen zu beschleunigen. Der Datenverkehr kann zudem anhand von Metadaten wie Objektgröße, Präfix oder Bucket gesteuert werden. So können Unternehmen Datensätze für die Feinabstimmung, Trainingsartefakte oder RAG-Embedding-Daten je nach betrieblichen Anforderungen unterschiedlich priorisieren.
Zentrale Säulen: standortabhängiges Routing, Caching und Sicherheit
Ein weiterer wichtiger Faktor für die Effektivität von BIG-IP ist der Umgang mit standortabhängigem Routing. Wenn in einer Speicherregion Latenzen auftreten oder ein Cluster gewartet wird, werden Datenströme nahtlos an einen intakten Standort umgeleitet, ohne dass Änderungen an den Anwendungen selbst erforderlich sind. So wird die KI-Pipeline unabhängig von den Vorgängen in der dahinterliegenden Speicherschicht kontinuierlich mit Daten versorgt.
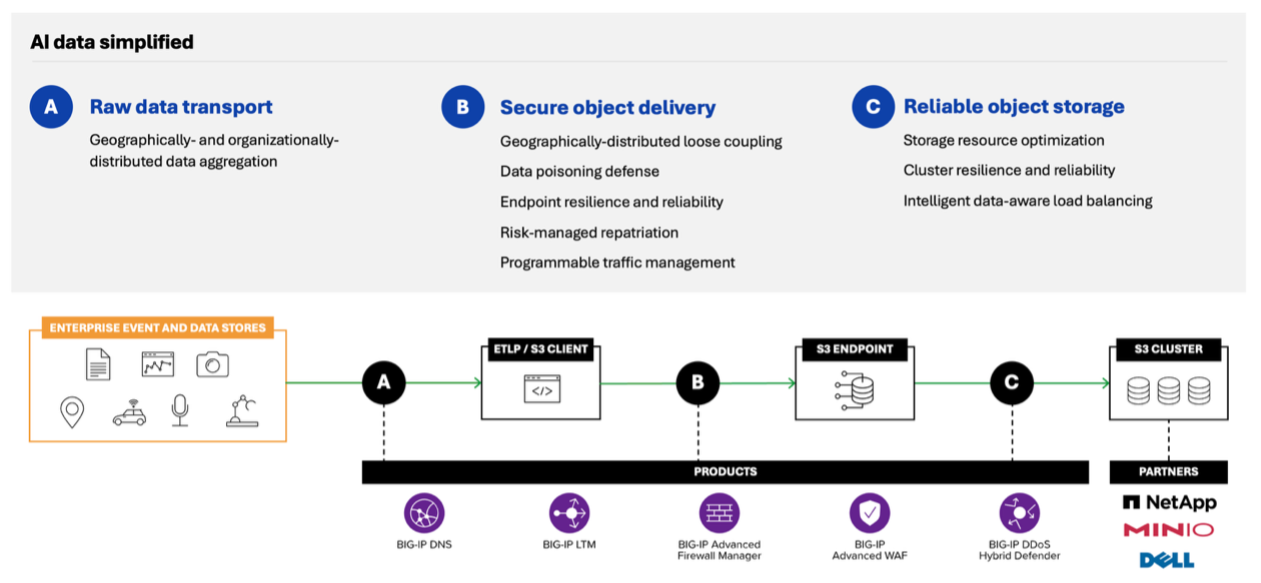
Traffic-Management und Sicherheit müssen fest in das Datentransport-Ökosystem integriert sein. Der Betrieb von KI-Datenendpunkten ist kostspielig, und sie sind für Angreifer attraktive Ziele. Wie die folgende Abbildung zeigt, stellt BIG-IP zentrale Bereitstellungs- und Sicherheitsfunktionen für KI-Datenpipelines bereit. Fortschrittlicher DDoS-Schutz, WAF-Funktionen und eine fein abgestufte API-Governance machen Sicherheit zu einem Bestandteil der Datenpipeline statt zu einem Engpass.
Die Bedeutung von Resilienz und Zuverlässigkeit
Selbst optimierte Pipelines sind Störungen ausgesetzt. Verkehrsspitzen, Knotenausfälle, Replikationsspitzen und Netzwerkänderungen können die KI-Leistung beeinträchtigen. Resilienz bedeutet, den Datenfluss trotz dieser Bedingungen aufrechtzuerhalten. BIG-IP zeichnet sich hierbei durch aktive Ausfallsicherung, kontrollierte Verkehrsableitung bei Wartungsarbeiten und programmierbare Routing-Richtlinien aus, die die Pipeline stabil halten.
In der Praxis bedeutet dies, dass Datenspeicher verfügbar und zugänglich bleiben. Trainingszyklen werden ohne Unterbrechung fortgesetzt. RAG-Einbettungs- und Datenanreicherungsprozesse werden planmäßig abgeschlossen. Zudem vermeidet das Unternehmen Kaskadenausfälle, die auftreten, wenn eine Ebene des KI-Stacks überlastet oder nicht verfügbar ist.
BIG-IP fungiert als Druckregelungs-, Durchflussausgleichs- und Sicherheitsventilsystem für die gesamte KI-Datenpipeline. So wird sichergestellt, dass die Raffinerie – also die KI-Modellfabrik – stets mit dem benötigten kontinuierlichen Strom hochwertigen „Öls“ versorgt wird.
F5 stellt KI-Anwendungen überall bereit und schützt sie
Bei der Optimierung der KI-Performance geht es nicht nur um die Modellausführung. Es muss auch sichergestellt werden, dass die enormen Datenmengen, die für Trainings-, Feinabstimmungs- und Einbettungs-Workflows erforderlich sind, schnell, zuverlässig und sicher übertragen werden.
Weitere Informationen zu unseren Lösungen für die KI-Datenbereitstellung finden Sie auf unserer Webseite zu Lösungen für KI-Datenbereitstellung und -infrastruktur .
Der KI-Fokus von F5 geht über die Datenbereitstellung hinaus. Erfahren Sie, wie F5 KI-Anwendungen überall schützt und bereitstellt.
Lesen Sie auch die anderen Blogbeiträge aus unserer Reihe zur KI-Datenbereitstellung:
Die KI-Datenpipeline mit F5 und S3-kompatiblem Speicher versorgen
KI-Datenpipelines von der Aufnahme bis zur Bereitstellung nachverfolgen
Warum KI-Speicher einen neuen Ansatz für den Lastenausgleich erfordern
Best Practices zur Optimierung von KI-Infrastrukturen im großen Maßstab
KI-Anwendungen in großem Maßstab bereitstellen: Die Rolle von ADCs
Sichern Sie Ihre KI-Datenpipeline, ohne sie auszubremsen
Über den Autor

Hunter Smit ist Senior Manager im Produktmarketing für Lösungen und Strategie bei F5. Er leitet das Lösungsmarketing für das gesamte F5-Portfolio, einschließlich KI-Infrastruktur und Anwendungssicherheit, und treibt den Einstieg von F5 in den aufstrebenden Markt für die Bereitstellung von KI-Daten voran. Hunter ist Mitglied des Beirats der School of Business der Whitworth University und war als Lehrbeauftragter für Produktmarketing tätig. Er erwarb an der Whitworth University einen MBA sowie einen Bachelor of Business Administration mit Schwerpunkt Management.
Weitere Blogbeiträge von Hunter SmitÄhnliche Blogbeiträge

Vier Gründe, warum Sie den F5 Post-Mythos Security Summit nicht verpassen sollten
Holen Sie sich Expertenrat, um Ihre Apps, APIs und Modelle in der Post-Mythos-Welt zu schützen.

Von einer App zu einer ganzen Agentenflotte: Ein 90-Tage-Framework für KI-Sicherheit
Vermeiden Sie den kostspieligen Ansatz „Jetzt bereitstellen, später absichern“ – mit einem umfassenden Framework zum Schutz von KI-Modellen, Anwendungen und autonomen Agenten.

Fünf Stufen antifragiler Cyberresilienz verwandeln Praxis in Ergebnisse
Erfahren Sie, wie fünf Stufen antifragiler Resilienz Störungen in adaptive Verhaltensweisen überführen, die Ausfälle begrenzen und hybride Multicloud-Architekturen stärken.

Warum Ihre KI-Richtlinien, Governance und Leitplanken nicht warten können
KI-Richtlinien und -Governance dürfen nicht länger als reine Formalitäten oder Zukunftsthemen betrachtet werden. Sie müssen durch praktische, durchsetzbare Leitplanken ergänzt werden.

Wenn „privat“ nicht privat ist: Wie ChatGPT-Unterhaltungen öffentlich wurden
KI verändert die Arbeitsabläufe in Unternehmen, doch eine übersehene Einstellung hat bereits Tausende vertraulicher Unterhaltungen öffentlich zugänglich gemacht
KI-Nutzung verstehen: Warum Unternehmen Transparenz brauchen
Anstatt einen zu laxen oder zu strengen Ansatz zu verfolgen, können Unternehmen durch mehr Transparenz bei der KI-Nutzung fundierte und durchsetzbare Entscheidungen treffen.