通信事業者のアーキテクトにAIクラスターの構成図を描いてもらうと、ラック、GPU、ファブリック、ストレージなど、すべてが描かれます。しかし、リクエストがそのクラスターに到達するまでの経路を描いてもらおうとすると、そこでペンが止まります。トラフィックはただ到着するものとして扱われます。クラスターの入り口まで届けば、あとはクラスターが処理するというわけです。
その盲点は、まもなく大きなコストを招きます。分散推論では、そのギャップにより、ある拠点ではGPUが遊休状態になる一方、別の拠点ではキューが過負荷になる可能性があります。国内に50の施設を持つサービスプロバイダーには、施設を2つしか持たないハイパースケーラーが購入できない資産があります。それは、ユーザーとの近接性、電力供給の多様性、主権を確保できる拠点網、そしてすでに敷設済みの光ファイバーです。
これは、単一の拠点ではなく、複数拠点のネットワークからモデルを提供する分散推論の最も有力な根拠です。しかし、50の拠点を1つの推論サービスとして機能させるには、リクエストごとに、どの拠点が応答すべきかを判断する仕組みが必要です。現在、そのような仕組みはありません。F5はNVIDIA、AMDをはじめとするAIインフラストラクチャプロバイダーと連携し、このギャップの解消に取り組んでいます。これにより、サービスプロバイダーが実際に導入しているアクセラレーターと推論スタックから得られるテレメトリに基づいて判断できるようになります。
トラフィックは魔法のようには届かない
実際には、次のような処理が行われます。DNSルックアップでサイトを選択し、グローバルサーバーロードバランサーが近接性、健全性、キャパシティを考慮してアドレスを返します。サイト内では、プロキシが接続を終端し、リクエスト元を確認してポリシーを適用した後、ロードバランサーがサーバーを選択します。この一連の処理は、アプリケーション対応ルーティングと呼ばれます。20年にわたり、あらゆるWebサービスやモバイルサービスを目立たないところで支えてきた仕組みであり、その多くをF5が構築してきました。
この一連の仕組みはAIでも機能します。ただし、判断基準が適切ではありません。グローバルサーバーロードバランサー(GSLB)は、最も近いサイトと稼働中のサイトを把握しています。しかし、どのサイトにモデルがロードされているか、そのサイトのGPUが飽和状態にあるか、また、今回のリクエストが国内の遠隔地へ転送できない音声対話なのか、それとも処理能力を安価に確保できる場所ならどこでも実行できる長時間のエージェント型ジョブなのかまでは把握していません。そのため、最も近い正常なサイトを選択しますが、そこでは高負荷で稼働している一方、200 km離れた同一構成のクラスターは半分しか使用されていない可能性があります。
アプリケーション対応ルーティングからAI対応ルーティングへ
飛躍のポイントは、アプリケーション対応ルーティングをAIアプリケーション対応ルーティングへと進化させることです。チェーン、DNS、プロキシはそのままで、新たに2つの入力を追加します。
1つ目は、AIインフラストラクチャ内部から得られるテレメトリです。各クラスターは、提供中のモデル、キューの深さ、使用中のKVキャッシュ量、処理中のリクエスト数、新しいリクエストが最初のトークンを受け取るまでの待ち時間を把握しています。F5 BIG-IP Next for Kubernetesはすでにこれらのクラスターのフロントに配置され、リクエストごとのトークン数に至るまで、あらゆる情報を把握しています。この情報を上位に送ることで、F5 DNS solutionsは、サイトの所在を示すマップを保持するだけでなく、各サイトが現時点で何を実行できるかをリアルタイムに把握できるようになります。
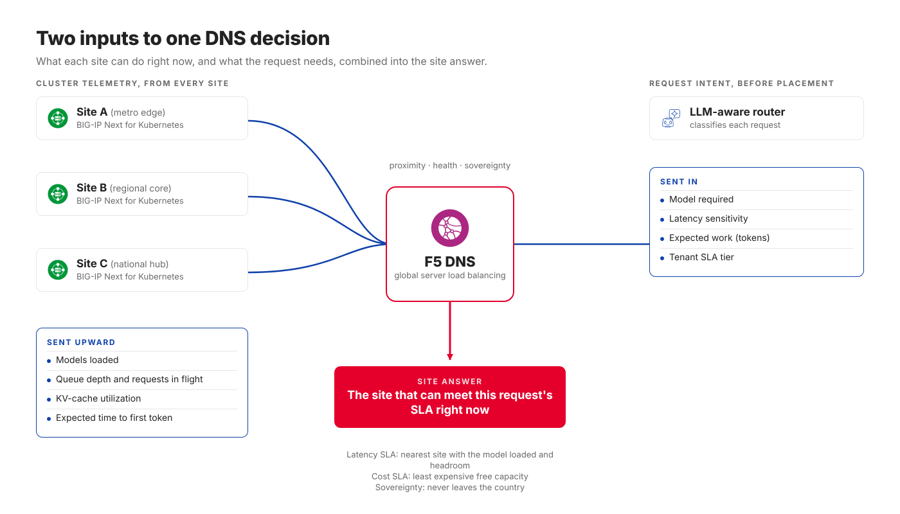
2つ目は、リクエストの意図です。LLM対応ルーターは、リクエストを配置する前に、必要なモデル、レイテンシーの影響を受ける度合い、おおよその処理量、テナントが契約しているSLA階層に基づいてリクエストを分類できます。これにより、リクエストが不適切な場所に到達した後で意図を把握するのではなく、その意図をDNS応答の判断材料として使用できます。
この2つを組み合わせることで、サービスレベル契約(SLA)は契約書の一節ではなく、ルーティングルールになります。レイテンシSLAでは、モデルがロード済みで、十分な余力がある最寄りのサイトにルーティングします。コストSLAでは、利用可能な容量のうち、最も低コストなものにルーティングします。データ主権の要件がある場合、データが国外に出ることはありません。GSLBは、これまでも可能だった判断を、従来は得られなかった情報に基づいて行えるようになります。
3段階の判断、1つの答え
配置は1つの意思決定ではなく、互いに入れ子になった3つの意思決定で構成されます。
- グローバルレベルでは、F5 DNSソリューションが、近接性、健全性、データ主権に加え、リアルタイムの推論テレメトリとリクエストの意図に基づいて、サイトまたはAIファクトリーを選択します。
- リージョン内では、リクエストは、適切なモデルと利用可能なキャパシティを備えたクラスターに振り分けられます。また、GPUにアクセスする前に、分離を適用するテナント固有のセキュリティ境界を通過します。
- ローカルでは、クラスター内でBIG-IP Next for Kubernetesがアイデンティティ、アクセス、トラフィックの各ポリシーを適用し、Endpoint Pickerがワーカーを選択します。
この最終レベルでは、ルーティングは単なるGPUへの経路ではなく、推論性能を左右する要素になります。エンジンがプロンプトを処理すると、プリフィル段階でGPUのKVキャッシュが埋められます。次のリクエストが同じプレフィックスを共有し、そのデータを保持しているワーカーに割り当てられれば、処理結果を再利用できます。別のワーカーに割り当てられると、GPUで再計算が必要になります。負荷が軽い場合、この違いはほとんど意識されません。しかし、本番環境で同時実行数が増えると、ワーキングセットがキャッシュ容量を超え、処理を再利用できるか再実行が必要かは、リクエストの配置によって決まるようになります。
BIG-IP Next for Kubernetes 2.4では、Endpoint Pickerがキャッシュプレフィックス、キューの深さ、実行中のリクエスト、KVキャッシュ使用率、最初のトークンが返されるまでの予想時間を考慮して、ワーカーを選択します。また、プリフィルとデコードの分離、およびllm-dやKubernetes Gateway API Inference Extensionなどのオープンな推論テクノロジーをサポートします。重要なのは、3つのレベルでコンテキストが共有されることです。キャパシティに基づいて選択されたサイトから、すでに上限に達しているクラスターに引き渡されることはありません。モデルに基づいて選択されたクラスターから、コンテキストを一から再構築する必要があるワーカーにリクエストが送信されることもありません。
GPUの状態を把握するネットワーク
これらを実現するために、AIインフラストラクチャとは別に新たなプラットフォームを導入する必要はありません。グローバルなトラフィック制御レイヤーはすでに存在します。クラスターレベルのインテリジェンスもすでに存在し、現在F5のお客さまの環境で本番稼働しています。現在進めているのは、これらをつなぎ、クラスターテレメトリとリクエストの意図を単一のDNS判断に反映させる取り組みです。
では、ペンを手にしたアーキテクトの話に戻りましょう。AI推論では、50か所のデータセンターは確かに2か所を上回ります。ただし、それはデータセンター間のネットワークがGPUと同じ情報を把握している場合に限られます。そうなれば、50拠点はそれぞれ孤立した処理能力ではなくなり、SLAを遵守し、国境を越えたデータ移動の制約に対応しながら、導入済みのすべてのGPUを活用できる1つの推論サービスとして機能します。
これは予告編です。どのように構築し、どのツールを使用し、何を測定したのかを詳しく紹介する本編は、近日公開します。
F5が最新のAIインフラストラクチャ全体で、分散推論、AIトラフィック管理、GPU使用率の向上をどのように支援しているか、詳しくご覧ください。
著者について
.jpg)
関連するブログ記事

F5 Distributed Cloud CDN:アプリを高速化、ワンクリックで有効化、コストを削減
F5 Distributed Cloud CDNなら、既存のセキュリティポリシーを変更することなく、ワンクリックでアプリを高速化し、オリジンの負荷とエグレスコストを削減して、コンバージョンを向上できます。

F5 BIG-IP v21.1を先行紹介:AIセキュリティ、PQC、ソフトウェアの機能強化
F5のBIG-IP v21.1がAIセキュリティとPQC対応への準備をどのように実現するかをご紹介します。

新しいAI AssistantでGuardrailsを高度化し、セキュリティを強化
F5の新しいAI Assistantは、AI Guardrailのカスタムスキャナー機能に直接組み込まれています。この機能により、企業はGenAIを活用して、自社固有のユースケースや独自のリスクプロファイルに沿ったポリシーを作成し、標準搭載の保護機能を超える対策を実現できます。
EU AI Actへの準拠がより容易に
AIシステム全体でEU AI Act、特に最も重大な禁止事項を運用に落とし込むには、どうすればよいのでしょうか。GenAIを導入するチームにとって、Article 5の「禁止されるリスク」に関する規定への対応には特有の課題があります。操作的な行為、生体認証による監視、ソーシャルスコアリングなど、最も重大な違反の多くは、従来のセキュリティツールでは容易に検出できないためです。F5のAI […]
AIレッドチームに欠けているものと、その改善方法
レッドチーミングは長年にわたり、企業セキュリティの要となってきました。しかし生成AIに関しては、多くの組織が新たな脅威環境に旧来の手法を適用しています。静的なプロンプトテスト、単発の監査、CLIベースのツールでは明らかな不具合を発見できる場合もありますが、導入後の生成AIシステムの挙動が持つ現実世界の複雑さを捉えられることはほとんどありません。 […]
欧州連合の人工知能法
AIが国際ビジネスのあり方を変える中、欧州連合の人工知能法(EU AI Act)は、AI技術の進化における重要な節目となっています。27か国で法制化されたこの重要な規制枠組みは、AIの利用を予定するあらゆる企業や組織に影響を及ぼし、AIシステムのあり方を形作ることになります。[…]