AIアプリケーションとは、実際にはどのようなものでしょうか。いくつか構築した今、その(数多くの)構成要素を分解し、運用面への影響を探るにはよいタイミングです。
これまで、AIアプリケーションについて、共通する点(多い)と異なる点(これも多い)を考察してきました。AIアプリケーションは、「予測型または生成型のAIを活用するアプリケーション」と簡単に定義できます。
確かにそうですが、こうした新しい種類のアプリケーションを構築、デプロイ、配信、保護、運用しなければならない担当者にとって、それは何を意味するのでしょうか。
まず、新たな構成要素が増えるということです。それは推論サービスだけではありません。ベクトルデータベースなど、アプリケーションアーキテクチャに標準的に追加されるようになりつつある新たなコンポーネントもあります。また、APIへの依存度が高まることも意味します。
また、これらのコンポーネントの大半がコンテナ化されていることも事実です。新しいAIアプリケーションプロジェクトを立ち上げる際には、PostgreSQLを実行するコンテナを起動し、ベクトルデータストアとして使用します。これはRAG(検索拡張生成)をサポートするためです。複数の業界レポートによると、かなりの割合のAIアプリケーションがRAGを利用しています(たとえば、Databricksのこちらのレポート)。RAGを利用すれば、モデルを自分でファインチューニングしたりトレーニングしたりすることなく、任意のデータを使って既製のAIモデルを拡張できるためです。多くのユースケースでは、これがAIアプリケーションを実装する最適な方法です。
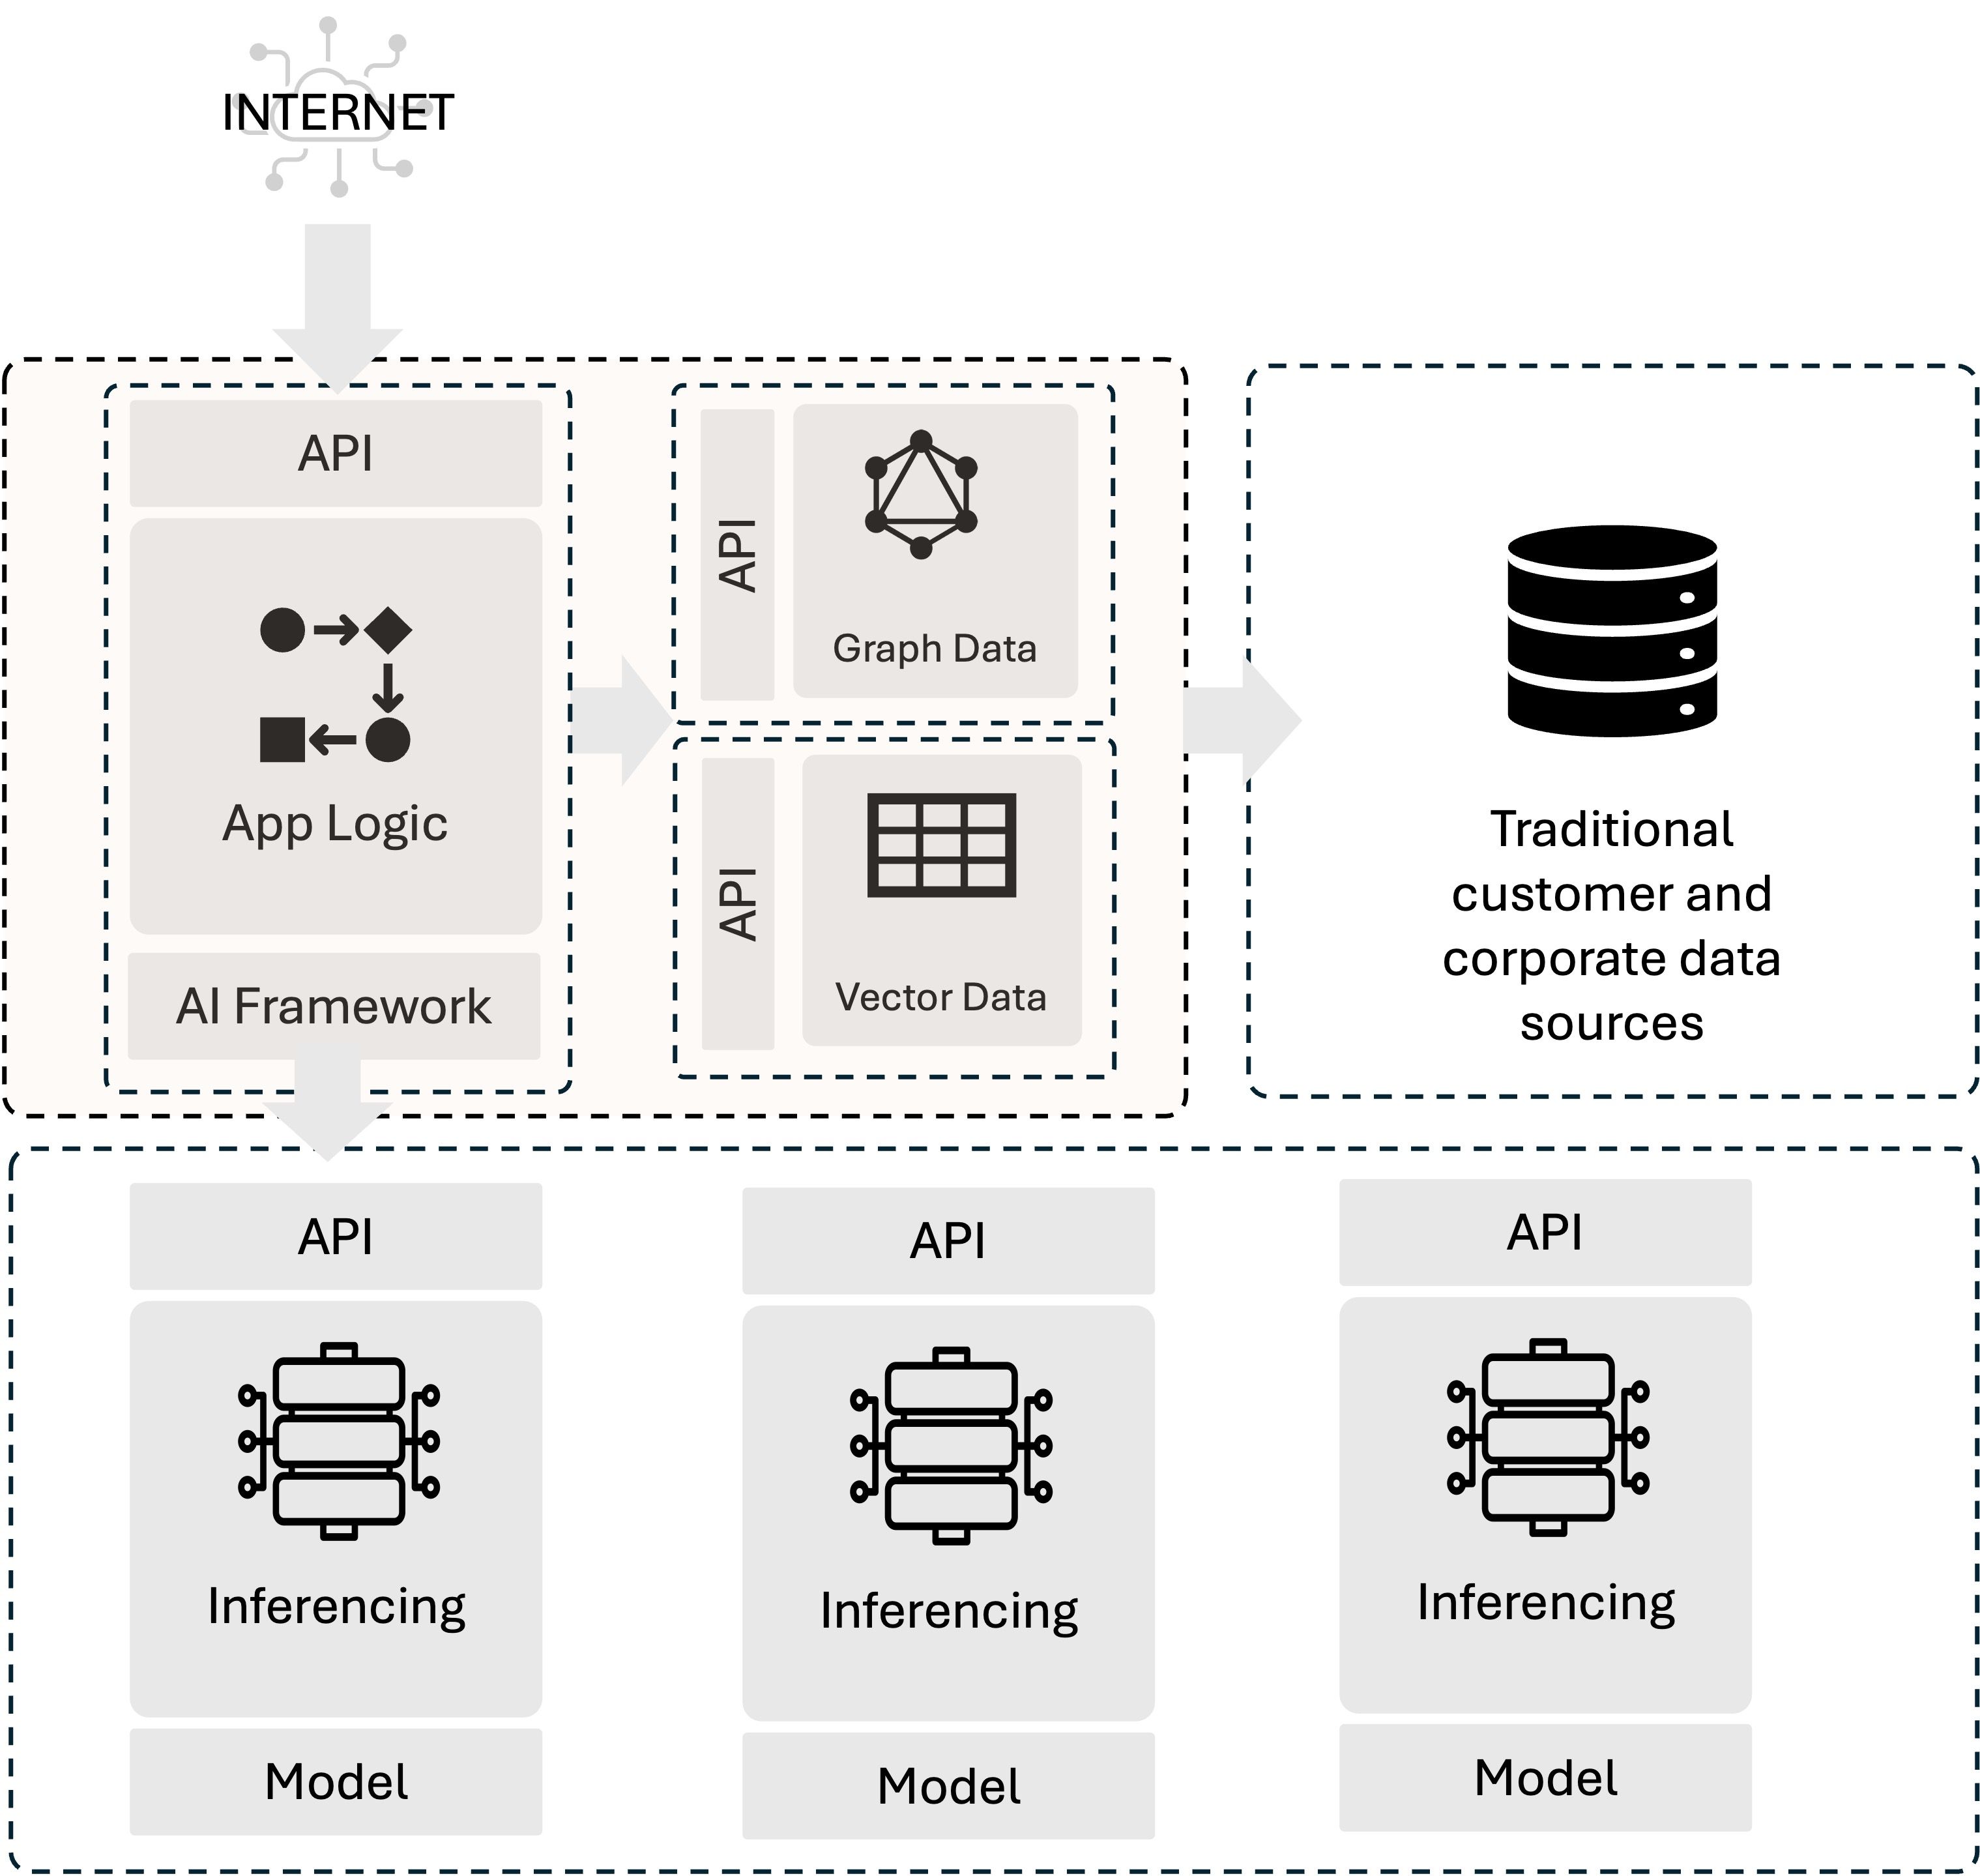
また、通常はNeo4Jのようなコンテナ化されたグラフデータベースを実行して、ナレッジグラフを立ち上げることもあります。グラフデータベースは、ソーシャルネットワーク、レコメンデーションエンジンのデータ、不正検知など、グラフ構造と親和性の高いデータを扱う場合に特に有用です。また、年初に明らかになったように、ポリシー生成に関連するハルシネーションの軽減にも役立ちます。グラフデータベースを導入すると、「新たにセキュリティ対策が必要となるもの」のリストに、GraphQLという新しいプロトコルが加わる可能性があります。
次に、使用する推論サービスを決めます。選択肢はいくつかあります。クラウドプロバイダーのサービスやAI as a Service(ChatGPTなど)を利用することも、ローカルサービスを実行することもできます。たとえば、最近の試行では、MacBook上でOllamaとphi3を使用しました。この場合、推論サーバーは1つのインスタンスだけを実行しています。複数実行すると、手元にある以上のリソースが必要になるためです。もちろん、本番環境では、需要に対応できるように複数のインスタンスを用意することになるでしょう。
phi3を使用するため、推論サービスにアクセスするためのフレームワークとして「phidata」を選びます。一般的な選択肢であるAI as a Serviceを利用する際には、「langchain」も使用したことがあります。運用面で好都合なのは、フレームワークがAIアプリケーション本体の外部で動作するものではない点です。
AIアプリケーションが運用に与える影響
まだコードを1行も書いていない段階で、すでに複数のコンポーネントが稼働しています。各コンポーネントにはAPI経由でアクセスし、それぞれ独自のコンテナで実行されています。だからこそ、AIアプリケーションはモダンアプリケーションであり、デリバリ、セキュリティ、運用に関する従来と同様の課題をすべて伴う、という前提から考える必要があります。また、AIモデルのデプロイによって、デリバリとセキュリティを必要とするAPIの数が飛躍的に増加すると考える理由もここにあります。
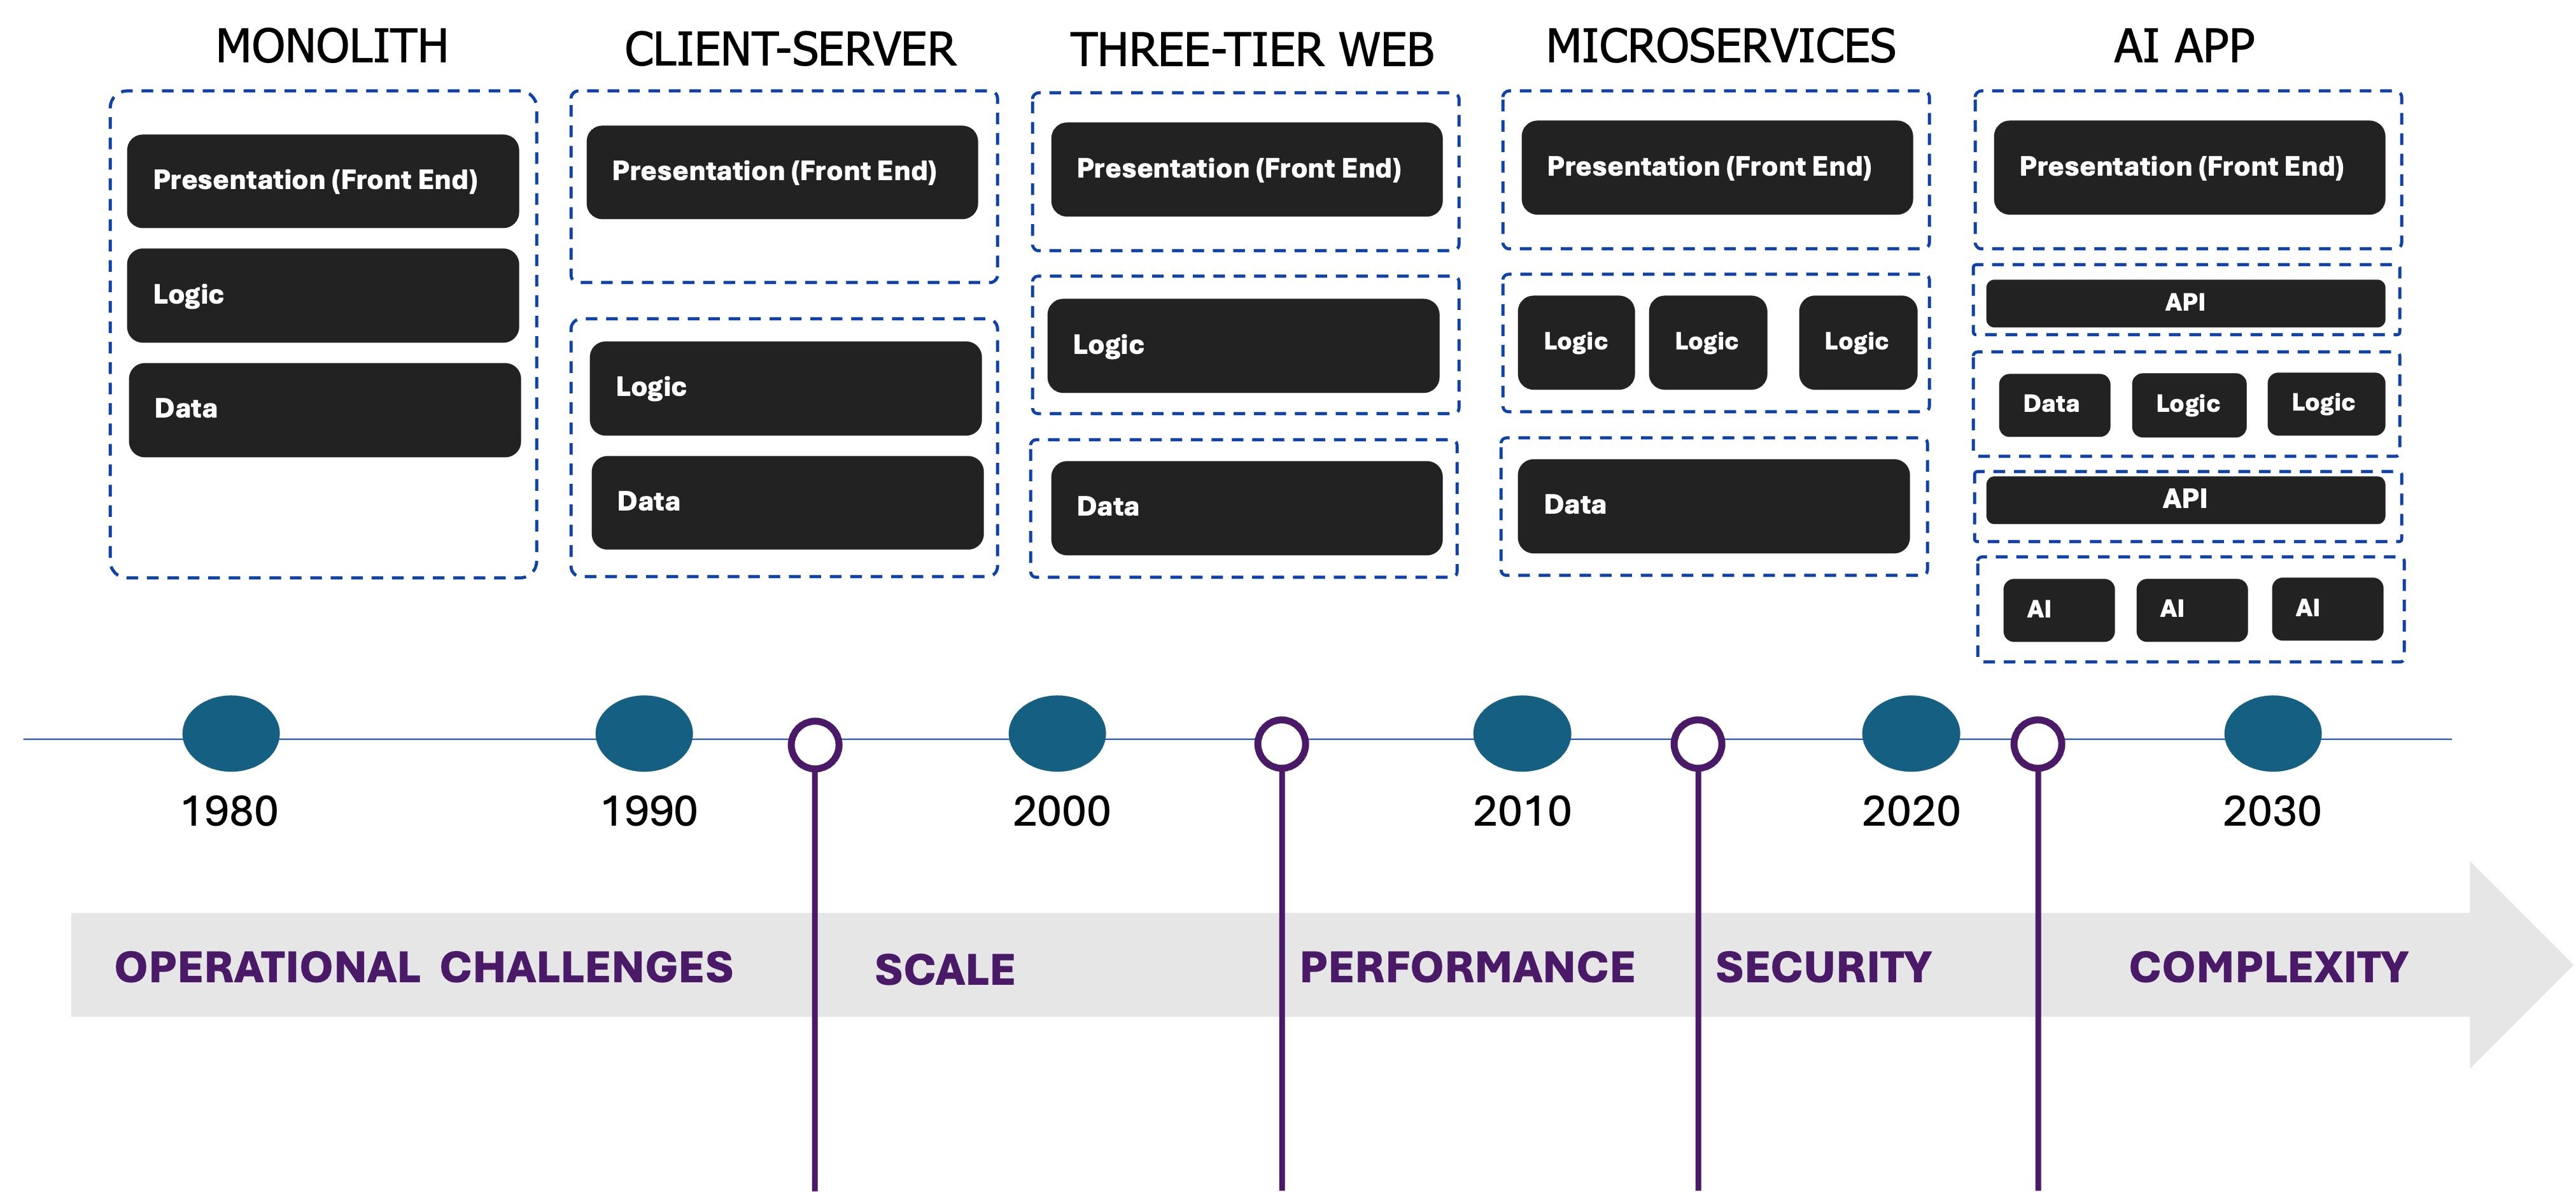
AIアプリケーションは、すでに複雑な環境に新たな階層を追加するため、当然ながら複雑さが増します。つまり、AIアプリケーションアーキテクチャによって、セキュリティ、SRE、ネットワークに至るまで、あらゆる運用機能の負荷が増大します。また、各コンポーネントには固有のスケーリング特性があります。すなわち、一部のコンポーネントは他よりも迅速にスケールする必要があり、その多くが異なるAPIを使用し、場合によっては異なるプロトコルも使用するため、リクエストの分散方法も異なります。
さらに、AIアプリケーションのアーキテクチャは、内部構成がアプリケーションごとに大きく異なると考えられます。つまり、私が構築するAIアプリケーションと皆さまが構築するAIアプリケーションでは、内部トラフィックの特性や要件が異なる可能性があります。また、異質性が高まれば、当然ながら複雑さも増します。異質性は、均質化を促す標準化とは対極にあるためです。
標準化は数十年にわたり、企業が新たな機能を市場へ迅速に提供し、運用効率を高めると同時に、AIアプリケーションアーキテクチャの多様性に対応するために必要な人材を確保する手段となってきました。
このため、一部の共有サービス、特にアプリとAPIのセキュリティが、Security as a Serviceのようにエッジへ移行しつつあります。このような共有サービス群は、あらゆる環境(コア、クラウド、エッジ)のワークロードをより適切に保護できるだけでなく、AIアプリケーション全体の標準となり得る共通サービスも提供できます。
AIアプリケーションの構造を理解することは、必要なアプリケーションデリバリおよびセキュリティサービスの種類だけでなく、それらが必要な「場所」を判断するうえでも役立ちます。
著者について

Lori MacVittieは、F5のOffice of the CTOに所属するDistinguished Engineer兼Chief Evangelistであり、アプリケーションデリバリ、自動化戦略、インフラストラクチャに関する深い専門知識を有しています。AIエージェントのガードレール策定、脆弱なマルチクラウドアーキテクチャの分析、スケーラブルなシステムの限界の検証など、複雑な事柄を明快にすることで知られています。アプリケーション開発、ITアーキテクチャ、ネットワークおよびシステム運用の分野で、30年以上にわたる業界経験を有しています。F5入社前は、受賞歴のあるテクノロジー編集者として活躍していました。 MacVittieはコンピューターサイエンスの修士号を取得しており、セキュリティ、クラウド、エンタープライズアーキテクチャにわたる分野で多数の著作を発表しています。また、テーブルトークゲームとビデオゲームをこよなく愛し、チーズについては遠慮なく強いこだわりを語ります。
Lori Mac Vittieのその他のブログ記事関連するブログ記事

SOAS 2025:足並みの乱れが凡庸さを招く
AI導入における方針の不一致は、非効率を招きます。セキュリティ、自動化、導入の各戦略を整合させ、AIの可能性を最大限に引き出す方法をご紹介します。

WebAssemblyが重要な理由
WebAssembly(Wasm)は、あらゆるプラットフォームで高性能なアプリケーションを実現する、ポータブルで高速かつセキュアなバイナリ命令セットです。

インフラストラクチャは依然として格好の攻撃経路
クラウドコンピューティングでは、APIやドラッグ&ドロップ式の設定ツールを活用し、ネットワークやインフラストラクチャを敬遠する人がそれらを直接扱わずに済むようにすることで、インフラストラクチャへの対応を不要にすることが長年追求されてきました。しかし、インフラストラクチャを無視することも、攻撃の主要な標的であるという事実を見過ごすこともできません。
堅牢なデータアーキテクチャがもたらす戦略的メリット
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開にもつながり、これらすべてをより俊敏に実行できるようになります。
デジタルワークフローにおける不正検知には、データだけでは不十分
2019年には、業界全体でクレジットカード詐欺の試みが約25万件確認されました。これは約2分に1件の割合です。今日、不正を検知するには、デジタルワークフロー上のできるだけ多くのポイントから収集したデータを相互に関連付け、手作業によるデータ処理をはるかに上回る速度で分析する能力が求められます。