
AIと機械学習の機能が、あらゆる規模の企業でイノベーションと効率化を推進するうえで不可欠と見なされるようになる中、組織はアプリケーション開発者がこれらの機能を利用できる最適な方法を検討する必要があります。多くの場合、AI推論サービスが使用されます。これは「与えられた入力に基づいてAIモデルを呼び出し、出力を生成するサービス」(分類の予測やテキストの生成など)であり、通常は他のアプリケーションコードからのAPI呼び出しに応答して実行されます。
こうした推論サービスは、単一の組織内であっても、さまざまな方法で構築、利用できます。すべて社内で開発することも、SaaSとして利用することも可能です。また、オープンソースプロジェクトを活用し、オープンモデルや商用モデルを使用する場合もあります。より広範なデータサイエンスやモデル作成の取り組みを支援する、完全な機能を備えた「機械学習プラットフォーム」の一部として提供されることもあれば、モデルを呼び出すためのAPIエンドポイントのみが提供されることもあります。実行環境としては、プライベートデータセンター、パブリッククラウド、コロケーション施設、またはこれらを組み合わせた環境が考えられます。大規模な組織では、AI推論に複数の選択肢を利用する可能性が高く、特にこの分野における組織の成熟度が低い段階では、その傾向が顕著です。すべての組織に適した画一的なアプローチはありませんが、いくつかの共通パターンが現れつつあります。
パターンの概要
AI推論の利用形態を大きく3つに分け、それぞれの長所と短所を見ていきます。
- SaaSとしてのAI推論 – アプリケーションは、外部のAI推論専用サービスプロバイダーに接続します。
- クラウドマネージドAI推論 – アプリケーションは、パブリッククラウドで稼働するフルマネージドAI推論サービスに接続します。
- 自己管理型AI推論 – アプリケーションは、組織自体が管理するAI推論を、集中管理型サービスの一部として、またはアプリケーションレベルで直接利用します。
主な意思決定ポイント
以下の運用パターン間のトレードオフを評価する際は、いくつかの重要な要素を考慮する必要があります。
運用上の考慮事項
スケーラビリティ – 長期的なキャパシティ要件の変化に応じたスケールアップとスケールダウンは誰が担い、各選択肢はどの程度柔軟に対応できますか?スケーリングやキャパシティに上限はありますか?コスト – フルマネージドサービスは一見すると割高に思える場合がありますが、専用ハードウェアや人員配置などを含む総所有コストを考慮すると、どの選択肢が適切かは一概には判断できません。キャパシティの増減に伴い、運用コストはどのように変動しますか?最低コストは設定されていますか?メンテナンスとサポート – 推論サービスの保守は誰が担いますか?この分野の専門知識を持つ従業員を採用したり、コンサルタントに費用を支払ったりする必要がありますか?それとも、マネージドサービスを利用する方が合理的でしょうか?
開発時の考慮事項
ワークロード統合の容易さ – AIサービスを利用するワークロードに、どの程度迅速に統合できますか?このサービスは、想定される利用パターン(オフライン推論やバッチ推論など)と運用環境に対応していますか?アジリティ – ビジネス要件の変化に合わせて、アプリケーション全体をどの程度迅速に適応させられますか?アーキテクチャのどの部分が固定的で、変更が困難ですか?
パフォーマンスに関する考慮事項
パフォーマンス – サービス利用者との位置関係を含むサービスの物理的な配置場所や、推論処理のレイテンシーは、ユースケースに影響しますか?ハードウェアの可用性 – サービスに特別なハードウェア要件はありますか?ある場合、想定される需要に対応できるキャパシティがありますか(オンプレミス環境とクラウド環境の両方が対象)?
データに関する考慮事項
データ漏洩 – 機密データが推論サービスに送信されたり、推論結果に含まれたりする懸念はありますか。その場合、トラフィックを検査し、ガードレールを適用できますか。データガバナンス – どこへアプリケーションデータは地理的にどこへ(どのように)送信されますか。組織が直接制御し続けるのか、それとも第三者に送信されるのかを確認します。データの取り扱いに適用される特別な規制またはコンプライアンスポリシーはありますか。
SaaSパターン
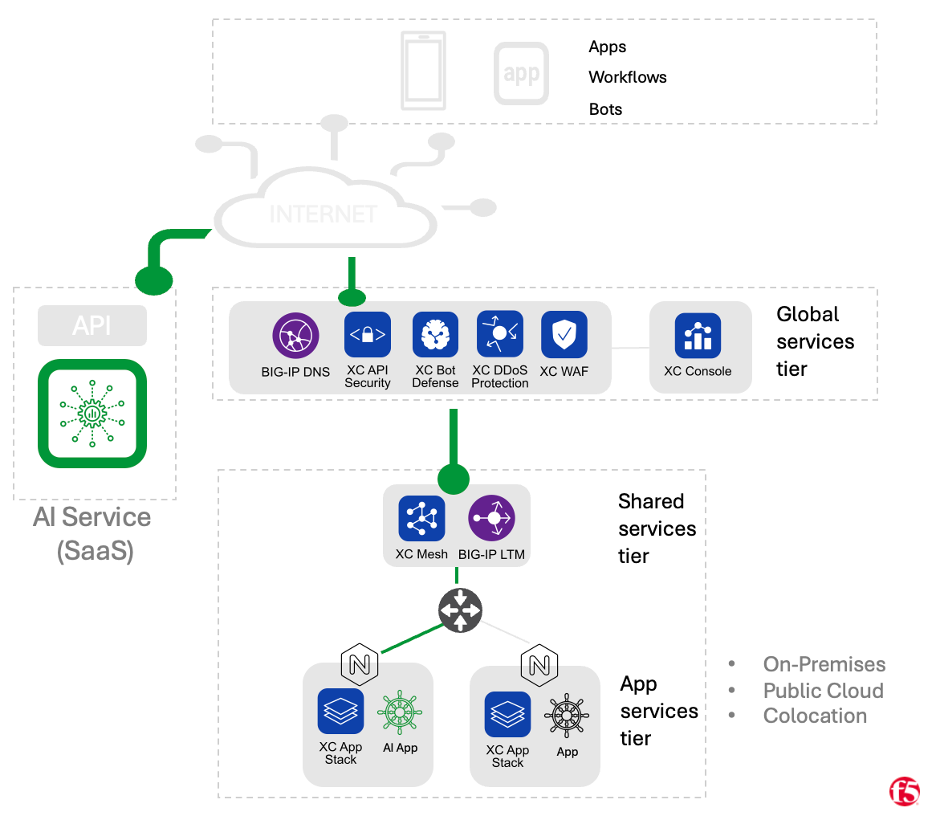
組織は、OpenAIやCohereなど、推論用AIモデルのホスティングに特化したSaaSプロバイダーのサービスを利用することもできます。この場合、組織のインフラストラクチャ(プライベートデータセンター、コロケーション、パブリッククラウドのいずれか)で実行されるワークロードは、SaaSプロバイダーが公開するAPIを利用します。このパターンでは、モデルのホスティングに必要なインフラストラクチャの運用負担をSaaSプロバイダーが全面的に担うため、非常に短期間で運用を開始できます。ただし、こうしたメリットと引き換えに制御性が低下し、ここで取り上げるパターンの中では最も「柔軟性」に欠けます。同様に、機密データに対する制御性も通常、このモデルが最も低くなります。サービスへの接続には一般にパブリックインターネットが使用されるうえ、外部のSaaSベンダーでは、厳格な規制コンプライアンス上の懸念に対応できる可能性が低いためです。
適している用途
- 市場投入までの期間:迅速なプロトタイピング、MVPのリリース。
- 社内にAI推論に関する十分な専門知識や経験がない組織。
- 高度または厳格なデータセキュリティやガバナンスを必要としないアプリケーション。
強み
- 市場投入までの期間を短縮:シンプルな運用モデルにより、統合に要する期間を短縮できる可能性があります。
- 特定分野に特化したサービスプロバイダーは、推論のスケーリングに伴う課題に対応するための十分な体制を備えています。
- 専用のハードウェアや人員への投資は不要です。
課題
- アプリのワークロードと同じ場所に配置されたサービスと比較した場合の、レイテンシと接続性に関する懸念。
- データプライバシー、ガバナンス、セキュリティに関する懸念への対応が外部のSaaSプロバイダーに依存する(または、外部のSaaSプロバイダーと両立しない可能性がある)。
- 大規模な環境では、運用コストがセルフホスティング型モデルより高くなる可能性があります。
- カスタムモデルのホスティングおよびモデルのカスタマイズサービスは、サポートされていない場合があります。
クラウド管理型パターン
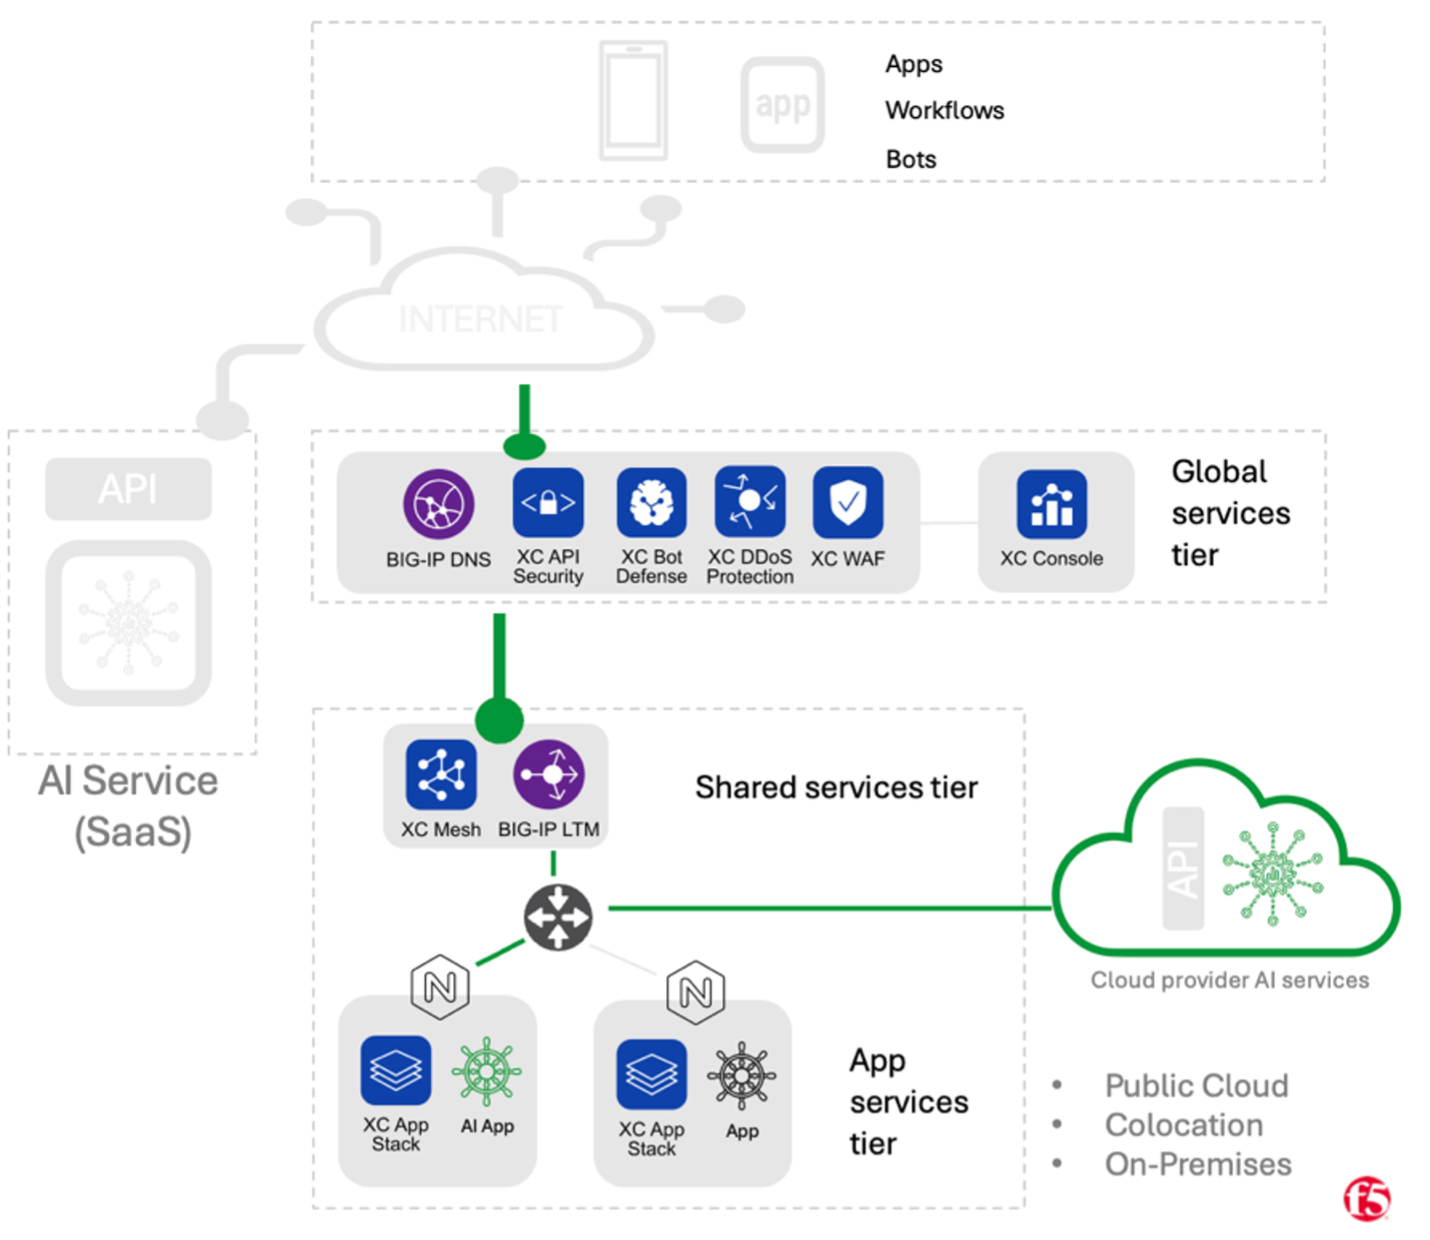
このパターンでは、組織はパブリッククラウドプロバイダーが提供するマネージドサービス(Azure OpenAI、Google Vertex、AWS Bedrockなど)を利用します。最初のパターンと同様に、AIモデルのデプロイ、スケーリング、保守に伴う運用負荷は、利用組織ではなくクラウドプロバイダーが担います。このパターンと前述のSaaSパターンとの主な違いは、通常、推論APIエンドポイントにプライベートネットワーク経由でアクセスでき、AIを利用するワークロードをAIモデルサービスと同じ場所(同一のゾーンやリージョンなど)に配置できる点です。そのため、通常、データはパブリックインターネットを経由せず、レイテンシーも低くなる可能性があります。また、これらのサービスへの接続には、他のクラウドプロバイダーのマネージドサービスと同様の仕組み(サービスアカウント、アクセスポリシー、ネットワークACLなど)を使用します。マルチクラウドネットワーキングを利用する組織では、ワークロードとAI推論サービスが異なるクラウドでホストされている場合でも、同様のメリットの一部を得られる可能性があります。
適した用途
- すでにパブリッククラウドに投資している組織
- 他のクラウドマネージドサービス上で実行されている、またはそれらに接続するアプリケーション。
強み
- 多くの組織はすでに、ワークロードを他のクラウドプロバイダーのマネージドサービス(データベースやオブジェクトストレージなど)に接続する方法を熟知しています。
- モデルの実行とスケーリングに伴う運用およびインフラストラクチャの負担は、主にクラウドプロバイダーが担います。
- レイテンシーに関する懸念や、一部のデータプライバシーに関する懸念に対処しやすくなる可能性があります。
課題
- マルチクラウド/ハイブリッドクラウドのアプリケーションでは、接続とセキュリティ確保に追加の作業が必要です。
- クラウドのマネージドサービスやAPI間で統一性が欠如していると、ベンダーロックインにつながる可能性があります。
- パブリッククラウドを大規模に利用していない組織は、困難に直面する可能性があります。
- 大規模環境では、運用コストがセルフホスティングモデルより高くなる可能性があります。
- カスタムモデルのホスティングおよびモデルのカスタマイズサービスは、サポートされていない場合があります。
セルフマネージド型
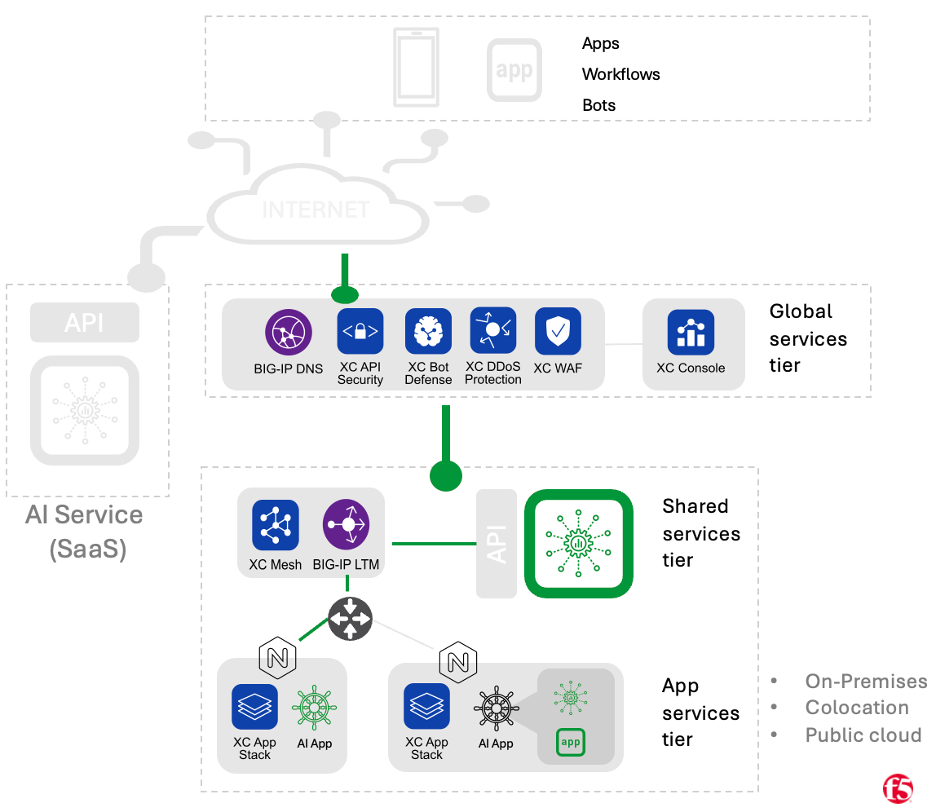
セルフマネージドモデルについては、まずAIモデル推論を一元化された「共有サービス」として運用するケースを取り上げ、次に一元化されたサービスが存在せず、運用上の課題への対応を個々のアプリケーションチームに委ねるケースを検討します。
セルフマネージド型の共有サービス
セルフマネージド型パターンの「共有サービス」バリエーションでは、推論インフラストラクチャ、その上で稼働するモデル、接続に使用するAPI、および推論サービスのライフサイクルに関する運用全般の保守を担当する専任チームを組織内に設ける場合があります。他のパターンと同様に、AIアプリケーションのワークロードはAPI呼び出しを通じて推論サービスを利用します。モデルサービングインフラストラクチャは、プライベートデータセンター、パブリッククラウド、またはコロケーション施設で稼働する場合があります。推論サービスの運用を担当するチームは、セルフホスト型の機械学習プラットフォーム(Anyscale RayやMLFlowなど)を活用できます。あるいは、Hugging FaceのText Generation Inference serverのように推論サービングに特化したツールや、社内で開発したソフトウェアを利用する場合もあります。セルフマネージド型の推論では、組織が利用できるのは、自らトレーニングしたモデルか、ローカル環境で実行可能なモデルに限られます(そのため、SaaS指向のサービスが提供するプロプライエタリモデルは選択肢にならない場合があります)。
適している用途
- インフラ管理に関する豊富な経験を持つ成熟した組織
- セルフマネージドサービスのTCOに見合う、大規模な推論処理を必要とする組織。
- データプライバシーとコンプライアンスに関して最も厳格な要件が求められるアプリケーション。
強み
- 組織は、推論サービスのあらゆる側面を完全に制御できます。
- データプライバシーに関する課題は、通常、セルフホスト型モデルを使用することで最も容易に対処できます。
- 大規模環境では、クラウド管理型またはSaaSベースの推論サービスよりもコスト効率が高くなる可能性があります。
課題
- 組織は推論サービスのあらゆる側面を完全に管理できます(大規模なインフラ投資と人員投資が必要になる可能性が高く、継続的な保守や開発、スケーラビリティに関する課題にも対処する必要があります)。
- 推論のニーズが少なく、データプライバシーに関する懸念も小さい組織にとっては、一般的に費用対効果が高くありません。
- SaaSまたはクラウドマネージドサービスとして提供される可能性があるクローズドモデルやプロプライエタリモデルにはアクセスできません。
自己管理型であり、共有サービスではない
アプリケーションが利用するAI推論サービスの運用を担う中央チームがない組織では、セルフマネージド型のもう1つのパターンが考えられます。この形態では、各アプリケーションチームが、アプリケーションのワークロード用に割り当てられたものと同じインフラストラクチャ上でモデルを実行する場合があります。モデルにはAPI経由でアクセスすることも、「オフライン」方式で直接利用することもできます。このパターンにより、開発者は「共有サービス」型のセルフマネージドモデルと同様のメリットの一部を、より小規模な環境で得られる可能性があります。
適している用途
- バッチ処理とオフライン推論を必要とするアプリケーション。
- 推論の利用量はごく少ないものの、データプライバシーとコンプライアンスに関する厳格な要件がある組織。
強み
- アプリケーション開発者にとって最も柔軟性が高く、ワークロードとの統合に幅広く対応できます。
- 小規模環境で、データプライバシーとレイテンシーの目標を達成できます。
- 場合によっては、ここで取り上げた他のモデルよりもコスト効率が高くなる可能性があります(利用量が非常に多い単一チームの場合など)。
課題
- モデルのライフサイクルに伴う運用負荷は、個々のアプリケーションチームが担います。
- 組織におけるAI推論の利用が拡大しても、規模の経済を活かせない(一貫性の欠如、非効率なリソース利用など)
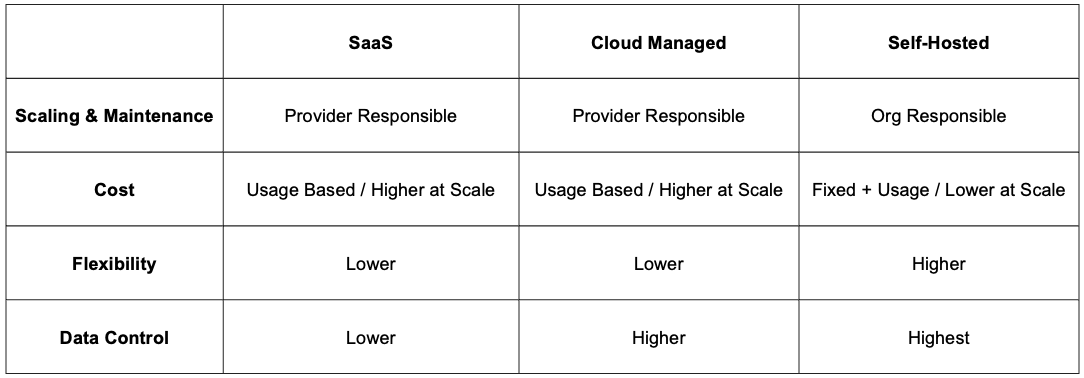
パターンごとのトレードオフのまとめ
AIアプリとモデル推論サービスのセキュリティ確保
AIアプリケーションは、その本質において他のモダンアプリとよく似ています。ユーザー向けコンポーネントとバックエンドコンポーネントを組み合わせて構築され、多くの場合、外部データストアに依存し、API呼び出しを多用します。こうしたアプリケーションには、すべてのモダンアプリに共通するセキュリティ上の課題がそのまま引き継がれるため、同様の方法で同じ保護対策(AuthNZ、DDoS対策、WAF、セキュアな開発プラクティスなど)を適用する必要があります。一方、AIアプリ、特に生成AIを活用するアプリには、他のアプリケーションには当てはまらない固有の懸念事項も数多くあります(例:OWASP Top 10 For LLMsを参照)。これらのモデルは一般に予測が難しいため、特にモデルに大きな自律性を持たせるユースケースでは、これまでにない問題が生じる可能性があります。
幸い、前述のパターンではAIモデルの推論にAPI経由のやり取りを多用するため、多くの組織は、こうした新たなセキュリティ対策を導入しやすい状況にあります。たとえば、従来のレート制限、認証、認可、トラフィック管理の機能を提供しているAPIゲートウェイを拡張し、コスト管理に役立つトークンベースのレート制限に対応できる可能性があります(アプリケーションレベルからSaaSまたはプロバイダー管理サービスへのアウトバウンド通信、あるいは自己管理型推論サービスの前段を保護するインバウンドRBAC認可のいずれにも適用できます)。同様に、SQLインジェクションやXSSのチェックなど、従来のWeb Application Firewall(WAF)サービスを現在提供しているインフラストラクチャは、プロンプトインジェクションや類似の攻撃に対する保護を追加するのに適している可能性があります。最新のオブザーバビリティ手法の多くは、API駆動型AI推論に固有のユースケースにもそのまま適用できるため、チームはこの領域で既存のツールや手法を有効に活用できるはずです。
まとめ
AI搭載アプリケーションや推論サービスが注目を集めるようになったのは確かに最近のことですが、その導入とセキュリティ確保を支える基本原則は以前から存在します。組織は、他のテクノロジーを利用する場合と同様に、固有のユースケース、利用可能なリソース、長期的な目標に基づいて、AI機能を最大限に活用する方法を判断する際にトレードオフを検討する必要があります。同様に、AI(特に生成AI)のユースケースには新たなセキュリティ課題もありますが、他の最新アプリケーションと共通する要件があり、APIを介したモデルとのやり取りに大きく依存しているため、既存のパターン、プラクティス、ツールを活用し、拡張できる絶好の機会となります。セルフホスト型かマネージドサービスかを問わず、AIへの投資価値と効果を最大化するには、固有のビジネス要件を満たす、安全でスケーラブルかつ高性能なソリューションを開発者が利用できるようにすることが不可欠です。
関連するブログ記事

SOAS 2025:足並みの乱れが凡庸さを招く
AI導入における方針の不一致は、非効率を招きます。セキュリティ、自動化、導入の各戦略を整合させ、AIの可能性を最大限に引き出す方法をご紹介します。

WebAssemblyが重要な理由
WebAssembly(Wasm)は、あらゆるプラットフォームで高性能なアプリケーションを実現する、ポータブルで高速かつセキュアなバイナリ命令セットです。

インフラストラクチャは依然として格好の攻撃経路
クラウドコンピューティングでは、APIやドラッグ&ドロップ式の設定ツールを活用し、ネットワークやインフラストラクチャを敬遠する人がそれらを直接扱わずに済むようにすることで、インフラストラクチャへの対応を不要にすることが長年追求されてきました。しかし、インフラストラクチャを無視することも、攻撃の主要な標的であるという事実を見過ごすこともできません。
堅牢なデータアーキテクチャがもたらす戦略的メリット
適切に構築されたデータアーキテクチャがもたらす効果は、業務プロセスの改善にとどまりません。戦略的な業務効率の向上、より深いビジネスインサイトの獲得、隣接するビジネス機会への展開にもつながり、これらすべてをより俊敏に実行できるようになります。
デジタルワークフローにおける不正検知には、データだけでは不十分
2019年には、業界全体でクレジットカード詐欺の試みが約25万件確認されました。これは約2分に1件の割合です。今日、不正を検知するには、デジタルワークフロー上のできるだけ多くのポイントから収集したデータを相互に関連付け、手作業によるデータ処理をはるかに上回る速度で分析する能力が求められます。