Es gibt einen alten Geschäftsgrundsatz, den wir alle kennen: Der Kunde hat immer recht.
In dieser digitalen Wirtschaft muss dieser Grundsatz offenbar wie folgt geändert werden: Die Daten des Kunden haben immer recht.
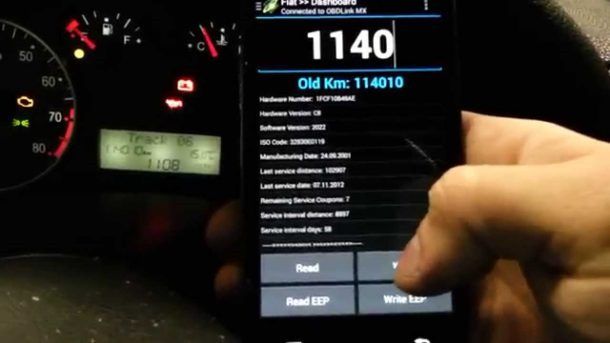
Lassen Sie mich das anhand einer kleinen Geschichte veranschaulichen.
Vor Kurzem beschloss ich, ein neues Auto zu kaufen und mein altes in Zahlung zu geben. Das alte hatte ich etwa sechs Jahre lang, und ich fuhr damit ungefähr dreitausend Meilen im Jahr. Ich weiß, das klingt verrückt, aber es stimmt. Nur ein einziges Mal fuhr ich damit über die Staatsgrenze nach Ohio, um meine Familie zu besuchen. Das war’s. Ansonsten bewegte es sich nie weiter als dreißig Meilen von meinem Zuhause weg. Ich scherze gern, dass ich diese kleine alte Dame bin, die nur sonntags mit ihrem Auto zur Kirche fährt.
Stellen Sie sich also meine Überraschung vor, als mir der Autohändler mitteilte, dass mein Kilometerstand nicht stimme – und zwar um mehr als 30.000 Kilometer –, und das aufgrund einer einzigen Datenzeile in dem vom Händler abgerufenen Fahrzeughistorienbericht. Dieser Eintrag behauptete außerdem, mein Auto sei zwei Jahre zuvor in North Dakota gewartet worden.
Diese Diskrepanz ist nicht auf die leichte Schulter zu nehmen. Der Kilometerstand wirkt sich auf den Inzahlungnahmewert aus, und Manipulationen daran sind illegal (es drohen Geld- und Freiheitsstrafen). Da der tatsächliche Kilometerzähler einen deutlich niedrigeren Stand anzeigte als im Bericht angegeben, können Sie sich vorstellen, dass der Händler etwas verunsichert war. Er stand vor der unangenehmen Entscheidung, entweder mir zu glauben – obwohl ich darauf bestand, mit dem Auto nie in North Dakota gewesen zu sein – oder den Daten, die das Gegenteil behaupteten.
Die Frage lief schnell darauf hinaus: „Hat der Kunde immer recht“ oder „Haben die Daten des Kunden immer recht“?
Wie sich herausstellt, ist dies nicht das erste Mal, dass jemand aufgrund fehlerhafter Daten in einem Fahrzeughistorienbericht Probleme bekommen hat. Die meisten Daten werden nach wie vor manuell eingegeben, sodass Fehler passieren können. Um diese Fehler zu korrigieren, muss die Person, die die Daten eingegeben hat, jedoch eingestehen, einen Fehler gemacht zu haben. Das bedeutet, dass sie sich daran erinnern muss, vor fünf, zehn oder sogar fünfzehn Jahren einen Fehler gemacht zu haben – vorausgesetzt, der Techniker, der die Daten eingegeben hat, ist überhaupt noch da, um den Fehler einzugestehen.
Am Ende fuhr ich mit meinem neuen Auto davon, während der Händler sich um die Korrektur des Berichts kümmern musste. Ich wette, viele von Ihnen haben eine ähnliche Geschichte erlebt. In einer digitalen Wirtschaft kommt so etwas nur allzu häufig vor.
Der Faktor Mensch (und seine Fehler)
Da wir uns bei der Lösung von Problemen, der Auswertung von Daten und dem Treffen von Entscheidungen zunehmend auf Maschinen verlassen, müssen wir uns bewusst sein, dass die uns vorliegenden Daten möglicherweise nicht korrekt sind. An irgendeinem Punkt in der Verwahrungskette dieser Daten war ein Mensch beteiligt. Und eine unumstößliche Wahrheit des Menschseins ist, dass wir Fehler machen. Ein einziger falscher Tastendruck eines Servicetechnikers in North Dakota vor sechs Jahren – und plötzlich sitzen Sie im grellen Verhörlicht und müssen sich zu jeder Autofahrt äußern, die Sie je unternommen haben.
Wir müssen vorsichtig damit sein, wie viel Vertrauen wir in die Daten setzen, auf deren Grundlage wir Entscheidungen treffen. Dabei müssen wir uns nicht nur vor versehentlichen Fehlern in Acht nehmen, sondern auch vor absichtlichen. Ihre Daten sind, das garantiere ich Ihnen, fehlerhaft.
Das Design von DNS ist ziemlich beeindruckend, insbesondere was die Unterscheidung zwischen autoritativen und nicht autoritativen Quellen angeht. Denn bei Unstimmigkeiten kann man auf die eine, maßgebliche Quelle zurückgreifen und die Wahrheit herausfinden. Bei Kundendaten gibt es so etwas nicht. Das ist ein potenzielles Warnsignal, denn die Systeme, die wir heute nutzen – und in naher Zukunft nutzen werden –, können nicht unbedingt erkennen, was korrekt ist und was nicht. Schließlich gibt es keine Stelle, bei der sich der Wahrheitsgehalt überprüfen ließe. Keine Zertifizierungsstelle, keine festgelegten autoritativen Quellen wie bei DNS. Und in vielen Fällen gibt es keine Möglichkeit, die Daten anzufechten.
Während wir weiterhin aus einzelnen Datenfragmenten digitale Abbilder unserer Kunden erstellen, müssen wir uns bewusst machen, welche weitreichenden Auswirkungen diese Daten haben können – sowohl auf uns als geschäftliche Entscheidungsträger als auch auf unsere Kunden als Menschen, die mit den Folgen der Schlussfolgerungen leben müssen, die auf Grundlage dieser Daten gezogen werden.
Als Anbieter von Anwendungssicherheitslösungen weisen wir häufig mit Nachdruck darauf hin, wie wichtig es ist, Daten und Identitäten vor Exfiltration und Diebstahl zu schützen. Doch nur selten betrachten wir die andere Seite und sprechen über die sehr reale Möglichkeit einer Datenmanipulation, sei es versehentlich oder aus Rache.
Das sollten wir tun – bevor es auf Twitter zum Trendthema wird.
Wir haben erlebt, wie digitale Vergeltungsangriffe auf Menschen in vielerlei Form zugenommen haben. Da die Notrufzentralen unter 911 über Mobiltelefone keine genauen Standorte und Adressen ermitteln können, kam es für Betroffene bereits zu tödlichen Swatting-Vorfällen. Rachepornografie ist Realität, und in sozialen Medien geben sich ständig Menschen als unsere Freunde und Familienangehörigen aus. Außerdem ist es bereits mehr als drei Jahre her, dass Kustodian-CEO Chris Rock demonstrierte, wie Betrüger aufgrund von Schwachstellen in den Sterberegistrierungsverfahren der meisten Länder jemanden aus Profitgier oder als Streich künstlich für „tot“ erklären können auf der DEF CON (CS Monitor). Wer genau aufgepasst hat, weiß, dass dies einer der Hacks aus dem Film Hackers von 1995 war – neben der Sperrung der Kreditkarte einer Person und der Veröffentlichung gefälschter Kontaktanzeigen als Vergeltung für eine vermeintliche oder tatsächliche Kränkung.
Es ist nur eine Frage der Zeit, bis sich solch rachsüchtiges Verhalten auch auf die Verfälschung anderer Daten ausweitet.
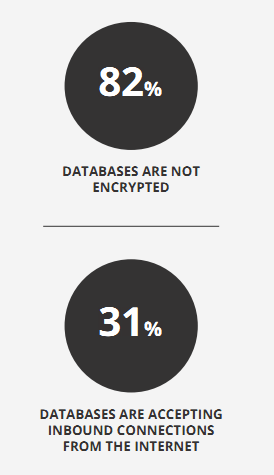
Wenn Sie glauben, ich würde unter Verfolgungswahn leiden, denken Sie an den RedLock-CSI-Bericht aus dem Jahr 2017 zurück, laut dem bei 31 % der Datenbanken ein Port zum Internet offenstand. Für jeden. Erinnern Sie sich an das MongoDB-Debakel, bei dem mehr als 27.000 Datenbanken öffentlich zugänglich waren. Wenn die falsche Person auf die richtige offen zugängliche Datenbank stößt, kann sie verheerenden Schaden an Ihren Daten anrichten.
Das ist ein Problem, denn wir haben einen Wendepunkt erreicht, an dem Daten oft als unumstößliche und unfehlbare Wahrheit betrachtet werden. Aufgrund eines Dateneingabefehlers hätte mich diese „Wahrheit“ ins Gefängnis bringen können.
Sorgfalt im Umgang mit digitalen Daten
Da immer größere Teile unserer Unternehmen – und unseres Lebens – digital gespeichert werden, sollten wir kurz innehalten und uns bewusst machen, dass die Bits und Bytes in unseren Data-Warehouses Aspekte realer Menschen abbilden. Die Sorgfalt, mit der wir diese Daten behandeln, spiegelt unsere Haltung gegenüber dem realen Menschen wider, der unser Kunde ist. Das gilt insbesondere, weil wir nicht wissen können, wie eine kleine Information, die wir heute erfassen, später möglicherweise zum Nachteil des Kunden ausgelegt wird. Schließlich sollte der Eintrag in meiner Fahrzeughistorie lediglich einen Ölwechsel in North Dakota dokumentieren. Dahinter steckte keine böse Absicht, doch für mich hätte das Ergebnis verheerend sein können.
Ob es darum geht, Sicherheitsrichtlinien mit Blick auf die Vermeidung von Datenverfälschungen zu entwickeln, den Zugriff auf Anwendungen und Datenbanken zu kontrollieren oder bei der manuellen Dateneingabe größere Sorgfalt walten zu lassen: Wir müssen bedenken, dass Daten zwar nicht lügen – sie geben genau das wieder, was eingegeben wurde –, die Person, die sie eingegeben hat, aber möglicherweise schon.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...