Bittet man einen Telekommunikationsarchitekten, einen KI-Cluster zu zeichnen, bekommt man Racks, GPUs, das Netzwerk, den Speicher – einfach alles. Bittet man ihn jedoch zu zeichnen, wie eine Anfrage zu diesem Cluster gelangt, hält der Stift inne. Der Datenverkehr kommt einfach an. Er landet vor der Tür, und ab da übernimmt der Cluster.
Dieser blinde Fleck könnte schon bald teuer werden. Bei verteilter Inferenz kann diese Lücke dazu führen, dass die GPUs an einem Standort ungenutzt bleiben, während die Warteschlangen an einem anderen überlastet sind. Ein Serviceprovider mit 50 Standorten im ganzen Land verfügt über etwas, das ein Hyperscaler mit nur zwei Standorten nicht kaufen kann: die Nähe zu den Nutzern, eine diversifizierte Stromversorgung, eine souveräne Infrastrukturpräsenz und bereits verlegte Glasfaserkabel.
Das ist das stärkste Argument für verteilte Inferenz: Modelle werden über ein Netzwerk von Standorten bereitgestellt statt nur von einem einzigen. Doch 50 Standorte werden erst dann zu einem einheitlichen Inferenzdienst, wenn für jede Anfrage entschieden wird, welcher der 50 Standorte sie beantworten soll. Heute gibt es dafür keine Lösung. Genau diese Lücke schließt F5 gemeinsam mit NVIDIA, AMD und anderen Anbietern von KI-Infrastruktur. So basiert die Entscheidung auf Telemetriedaten der Beschleuniger und Inferenz-Stacks, die Serviceprovider tatsächlich einsetzen.
Datenverkehr entsteht nicht wie von Zauberhand
So läuft es tatsächlich ab: Eine DNS-Abfrage wählt einen Standort aus. Ein globaler Server-Load-Balancer bewertet Nähe, Verfügbarkeit und Kapazität und gibt eine Adresse zurück. Innerhalb des Standorts beendet ein Proxy die Verbindung, prüft, wer die Anfrage stellt, wendet Richtlinien an, und ein Load-Balancer wählt einen Server aus. Diese Kette wird als anwendungsorientiertes Routing bezeichnet. Seit zwei Jahrzehnten bildet sie unbemerkt die Grundlage für sämtliche Web- und Mobilfunkdienste – und F5 hat einen Großteil davon entwickelt.
Die Kette funktioniert auch für KI. Sie trifft ihre Entscheidungen nur aus den falschen Gründen. Der Global Server Load Balancer (GSLB) weiß, welcher Standort am nächsten liegt und welcher verfügbar ist. Er weiß jedoch nicht, an welchem Standort das Modell geladen ist, ob die GPUs dort ausgelastet sind oder ob es sich bei dieser Anfrage um eine Sprachinteraktion handelt, die nicht quer durchs Land geleitet werden kann, oder um einen langwierigen agentenbasierten Auftrag, der überall dort ausgeführt werden kann, wo Kapazität günstig verfügbar ist. Daher wählt er den nächstgelegenen verfügbaren Standort – möglicherweise genau den, der bereits unter Volllast läuft, während ein identischer Cluster 200 Kilometer entfernt nur zur Hälfte ausgelastet ist.
Vom anwendungsbewussten zum KI-bewussten Routing
Der entscheidende Schritt ist: Aus anwendungsbewusstem Routing muss KI-anwendungsbewusstes Routing werden. Dieselbe Kette, dasselbe DNS, dieselben Proxys. Zwei neue Eingangsgrößen.
Der erste Faktor sind Telemetriedaten aus der KI-Infrastruktur. Jeder Cluster weiß, welche Modelle er bereitstellt, wie lang seine Warteschlangen sind, wie viel KV-Cache belegt ist, wie viele Anfragen gerade verarbeitet werden und wie lange eine neue Anfrage auf ihr erstes Token warten muss. F5 BIG-IP Next for Kubernetes befindet sich bereits am Eingang dieser Cluster und erfasst all diese Daten bis hin zur Token-Anzahl pro Anfrage. Werden diese Daten an die übergeordnete Ebene weitergeleitet, verwalten F5 DNS-Lösungen nicht mehr nur eine Übersicht darüber, wo sich Standorte befinden, sondern ein aktuelles Bild davon, was jeder Standort im jeweiligen Moment leisten kann.
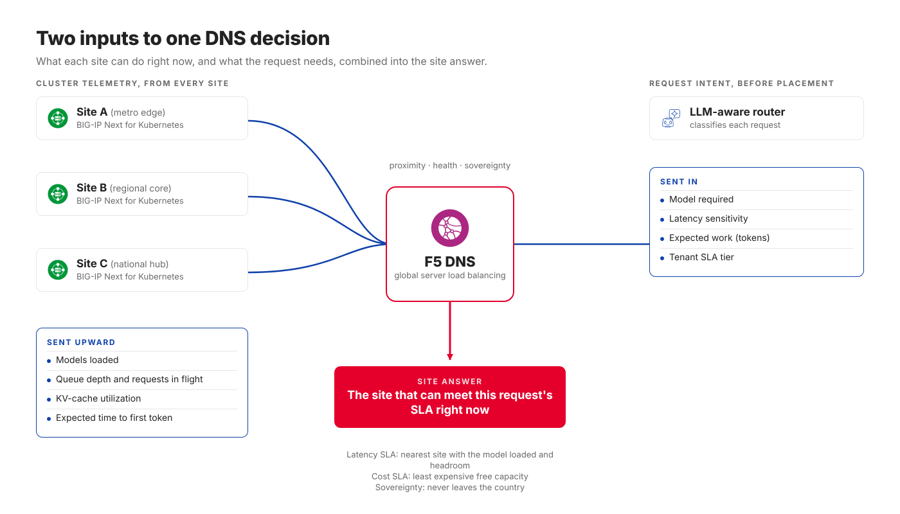
Der zweite Faktor ist die Absicht hinter der Anfrage. Ein LLM-fähiger Router kann eine Anfrage klassifizieren, bevor sie weitergeleitet wird: welches Modell sie benötigt, wie empfindlich sie auf Latenz reagiert, wie hoch der damit verbundene Aufwand ungefähr ist und für welche SLA-Stufe der Mandant bezahlt. Diese Absicht fließt dann in die DNS-Antwort ein, anstatt erst erkannt zu werden, nachdem die Anfrage am falschen Ort gelandet ist.
Kombiniert man beides, ist ein Service-Level-Agreement (SLA) nicht länger nur ein Absatz in einem Vertrag, sondern wird zu einer Routing-Regel. Ein Latenz-SLA leitet Anfragen an den nächstgelegenen Standort weiter, an dem das Modell geladen ist und ausreichend Kapazitätsreserven vorhanden sind. Ein Kosten-SLA leitet sie an die günstigste verfügbare Kapazität weiter. Bei einer Anforderung an die Datensouveränität verlassen die Daten niemals das Land. Das GSLB trifft die Entscheidung, die es schon immer treffen konnte – nun jedoch mit den Informationen, die ihm bislang fehlten.
Drei Entscheidungsebenen, eine Antwort
Die Platzierung ist nicht eine einzige Entscheidung, sondern besteht aus drei ineinander verschachtelten Entscheidungen.
- Global wählen F5 DNS-Lösungen den Standort oder die KI-Fabrik aus – nun auf Grundlage von Echtzeit-Telemetriedaten zur Inferenz und der Anfrageabsicht sowie von Nähe, Systemzustand und Datensouveränität.
- Auf regionaler Ebene wird die Anfrage an einen Cluster mit dem passenden Modell und verfügbaren Kapazitäten weitergeleitet. Dabei durchläuft sie eine mandantenspezifische Sicherheitsgrenze, die die Isolation gewährleistet, bevor auf eine GPU zugegriffen wird.
- Lokal innerhalb des Clusters wendet BIG-IP Next for Kubernetes Richtlinien für Identität, Zugriff und Datenverkehr an, und Endpoint Picker wählt den Worker aus.
Auf dieser letzten Ebene ist das Routing nicht mehr nur der Weg zur GPU, sondern wird zu einem Faktor für die Inferenzleistung. Wenn eine Engine einen Prompt verarbeitet, füllt die Prefill-Phase den KV-Cache der GPU. Wenn die nächste Anfrage dasselbe Präfix verwendet und bei einem Worker eingeht, der es noch im Cache hält, kann die bereits geleistete Arbeit wiederverwendet werden. Geht sie bei einem anderen Worker ein, muss die GPU sie erneut ausführen. Bei geringer Last fällt das nicht auf. Unter den Parallelitätsanforderungen einer Produktionsumgebung wird der Arbeitssatz jedoch größer als der Cache, und die Platzierung entscheidet zunehmend darüber, ob Arbeit wiederverwendet oder erneut ausgeführt wird.
Mit BIG-IP Next for Kubernetes 2.4 berücksichtigt Endpoint Picker bei der Auswahl eines Workers das Cache-Präfix, die Warteschlangentiefe, laufende Anfragen, die KV-Cache-Auslastung und die erwartete Zeit bis zum ersten Token. Die Lösung unterstützt die Trennung von Prefill und Decode sowie offene Inferenztechnologien wie llm-d und die Kubernetes Gateway API Inference Extension. Entscheidend ist, dass die drei Ebenen denselben Kontext nutzen. Ein aufgrund seiner Kapazität ausgewählter Standort leitet die Anfrage nicht an einen ausgelasteten Cluster weiter. Ein für ein Modell ausgewählter Cluster sendet die Anfrage nicht an einen Worker, der den Kontext von Grund auf neu aufbauen muss.
Das Netzwerk, das weiß, was die GPUs wissen
All dies erfordert keine neue Plattform neben der KI-Infrastruktur. Die globale Steuerungsebene ist bereits vorhanden. Die Intelligenz auf Clusterebene existiert ebenfalls und wird heute bereits produktiv bei F5-Kunden eingesetzt. Derzeit wird daran gearbeitet, Cluster-Telemetriedaten und die Absicht hinter einer Anfrage so zusammenzuführen, dass daraus eine einzige DNS-Entscheidung entsteht.
Kehren wir also zurück zu dem Architekten mit dem Stift. Fünfzig Rechenzentren sind für die KI-Inferenz tatsächlich besser als zwei – aber nur, wenn das Netzwerk zwischen ihnen weiß, was die GPUs wissen. Dann sind 50 Standorte nicht länger 50 isolierte Kapazitätsinseln, sondern verhalten sich wie ein einziger Inferenzdienst, der ein SLA einhalten, Grenzen respektieren und jede bereits bezahlte GPU nutzen kann.
Betrachten Sie dies als den Trailer. Der vollständige Beitrag darüber, wie das Ganze aufgebaut ist, welche Tools zum Einsatz kommen und welche Messergebnisse erzielt wurden, folgt in Kürze.
Erfahren Sie mehr darüber, wie F5 Unternehmen dabei unterstützt, verteilte Inferenz, das Management von KI-Datenverkehr und die GPU-Auslastung in modernen KI-Infrastrukturen zu verbessern.
Über den Autor
.jpg)
Ähnliche Blogbeiträge
Kubernetes-native WAF für das Gateway-Zeitalter: F5 WAF for NGINX lässt sich jetzt in F5 NGINX Gateway Fabric integrieren
F5 erweitert WAFs, um mit F5 NGINX Gateway Fabric und F5 NGINX Ingress Controller einen konsistenten, skalierbaren Schutz über Cluster und Umgebungen hinweg bereitzustellen.

Von Regeln zu Risiken: Die Entwicklung von WAFs und der Aufstieg KI-gestützter Ergebnisse
WAF-Programme geraten oft an einem bekannten Punkt ins Stocken: Der Blockierungsmodus wird verzögert aktiviert, weil die Feinabstimmung aufwendig ist.

Erklärbarkeit: Licht ins Dunkel der KI-Blackbox bringen
Einblicke von James White, CTO bei CalypsoAI: Dank GenAI verstehen wir inzwischen gut, wie Antworten generiert und an uns zurückgegeben werden. Vereinfacht gesagt basiert KI auf einer Transformer-Architektur – sie wählt die beste Vorhersage für das nächste Wort und den nächsten Satz aus und liefert anhand der ihr vorliegenden Informationen die wahrscheinlichste Antwort […]
Die neue KI-Risikolandschaft: unsichtbar, autonom und bereits im Unternehmen
James White, VP Engineering, F5 Zur Jahresmitte 2025 ist es an der Zeit, eine Momentaufnahme der KI-Nutzung in Unternehmen und des aktuellen Stands der KI-Sicherheit zu erstellen. Der Einsatz generativer KI ist in Unternehmen mittlerweile Standard Unternehmen verfügen inzwischen durchweg zumindest über ein grundlegendes Verständnis von generativer KI. Sie wissen, was sie ist und wo sie […]
Die KI-Grenzen sichern: Strategien zur Bekämpfung von Datenexfiltration
Da Unternehmen zunehmend Modelle der generativen KI (GenAI) und große Sprachmodelle (LLMs) in ihre digitalen Systeme integrieren, sind sie mit neuen und erhöhten Risiken konfrontiert. Wenig überraschend stehen dabei Risiken im Zusammenhang mit Datenexfiltration – der unbefugten Übertragung von Daten aus einem Unternehmen an ein externes Ziel – meist ganz oben auf der Prioritätenliste der Sicherheitsteams. Ein Verständnis […]
Everest Group-Bericht: Aktuelle Trends und Zukunftsaussichten bei der Einführung von GenAI in der Industrie
Wir freuen uns, einen wesentlichen Beitrag zu einem wegweisenden neuen Bericht der Everest Group, einem weltweit führenden Forschungsunternehmen, geleistet zu haben. Der Bericht mit dem Titel „Generative AI Adoption – Examining Real-world Use in Horizontal Functions and Future Outlook“ bietet eine eingehende Analyse der Einführung generativer KI (GenAI) in verschiedenen Branchen. Dem Bericht zufolge ist die IT […]