Hin und wieder erreicht eine spannende Technologie einen Wendepunkt, an dem konkrete geschäftliche Anforderungen auf ihre Stärken treffen. Dadurch wird die Technologie nicht nur denkbar, sondern auch praktisch einsetzbar. Berkeley Packet Filter (BPF) hat diesen Punkt unter Linux-Entwicklern vor Kurzem erreicht. BPF ist ein äußerst effizienter Abfang- und Verarbeitungspunkt auf einem Linux-Host, der voraussichtlich eher früher als später auch auf Windows-Server ausgeweitet wird. Die Bandbreite der verfügbaren Daten ist enorm und trägt unmittelbar zur vollständigen Transparenz über den gesamten Stack bei Betriebsaufgaben des Site Reliability Engineering (SRE) bei. Zudem eignet sich BPF von Natur aus zur Bewältigung von Herausforderungen im Zusammenhang mit Sicherheit und Datenverkehrsmanagement. Ebenso groß ist die Bandbreite der Hooks, die eine attraktive Auswahl nützlicher Auslösepunkte für BPF-Anwendungen bieten und damit Fachleute aus den Bereichen Observability, Sicherheit und Netzwerke ansprechen. BPF ist die richtige Technologie, um Observability kosteneffizient zu ermöglichen. Und alles beginnt mit Observability.
Das grundlegende Design von BPF macht es zu einer nahezu maximal effizienten Methode für Rechenaufgaben (Dollar pro Watt). Noch besser: Die Toolchains erzeugen den Bytecode für Sie, sodass Sie sich auf das gewünschte Ergebnis konzentrieren können, statt sich mit hardwarenaher Programmierung auf Assemblersprachen-Niveau zu befassen. Wie das gelingt? Dank dieser beiden Designmerkmale kann BPF seine Stärken voll ausspielen:
Befehlssatzdesign
Das Softwaredesign von BPF wurde bewusst an das Design der aufkommenden modernen CPU-Architekturen angelehnt. Tatsächlich wird Prozessorterminologie verwendet, da sie die Elemente und die Verwendung von BPF präzise beschreibt. BPF verfügt über Register und Befehle. Sie sind für die direkte Verarbeitung durch CPUs ausgelegt. BPF basiert auf dem Design des BSD Packet Filter (1992) und ist eine neu konzipierte Filtermaschine zur Paketerfassung, die sich besser für heutige registerbasierte CPU-Architekturen eignet. Dieses Design erhielt 2014 einen natürlichen Schub, als der „Enhanced Berkeley Packet Filter“, kurz eBPF, mit v3.18 des Linux-Kernels veröffentlicht wurde. In den ersten Jahren nach seiner Veröffentlichung war die Unterscheidung zwischen eBPF und dem Classic Berkeley Packet Filter (cBPF) wichtig. Heute ist sie weniger entscheidend, da alle unterstützten Kernel-Versionen die Erweiterungen von 2014 enthalten. Diese sind dennoch erwähnenswert: breitere Register (der Wechsel von 32 Bit auf 64 Bit bedeutet, dass pro Cache-Zeile bzw. Taktzyklus mehr Arbeit erledigt wird), mehr Register (der Wechsel von 2 auf 10 ermöglicht eine direktere 1:1-Zuordnung zwischen modernen CPU-Registern und Kernel-ABIs) sowie einige zusätzliche Erweiterungen des Befehlssatzes, die BPF-Programme sicherer und nützlicher machen.
Sicherungsschicht
BPF besteht aus einem Netzwerk-Tap und einem Paketfilter. Der Tap arbeitet auf der Sicherungsschicht, wenn Pakete über die Leitung an einer bestimmten Netzwerkschnittstelle eintreffen. Er kopiert die Pakete, damit der Filter sie untersuchen kann. Durch diesen Einspeisepunkt hat BPF vollständige Sicht auf den Netzwerkpfad des Linux-Hosts. Bei eingehendem Datenverkehr geschieht dies, bevor der Hostprozessor mit der Verarbeitung beginnt, und bei ausgehendem Datenverkehr unmittelbar bevor die Pakete über die Leitung den Host verlassen. Dieses Diagramm zeigt, wie BPF den Pfad eingehender Pakete auf der Sicherungsschicht kreuzt.
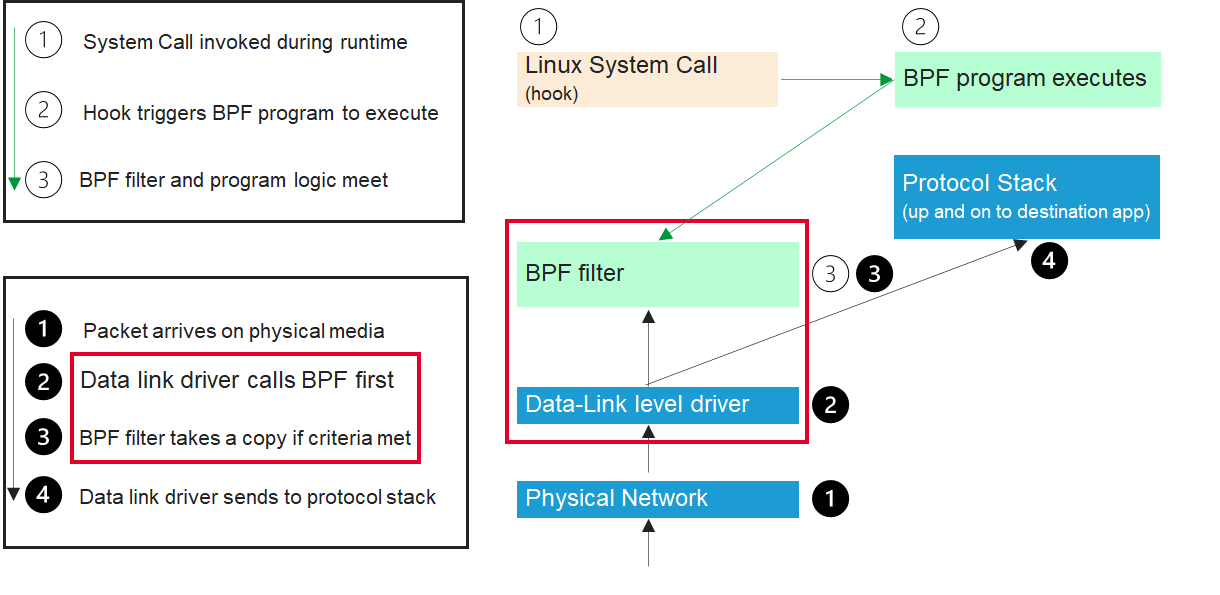
Die Bandbreite der verfügbaren Daten ist enorm und trägt unmittelbar zur vollständigen Transparenz über den gesamten Stack bei SRE-Betriebsaufgaben bei. In diesem Beispiel konzentrieren wir uns auf einige der am häufigsten verwendeten Felder aus dem IPv4-Header.
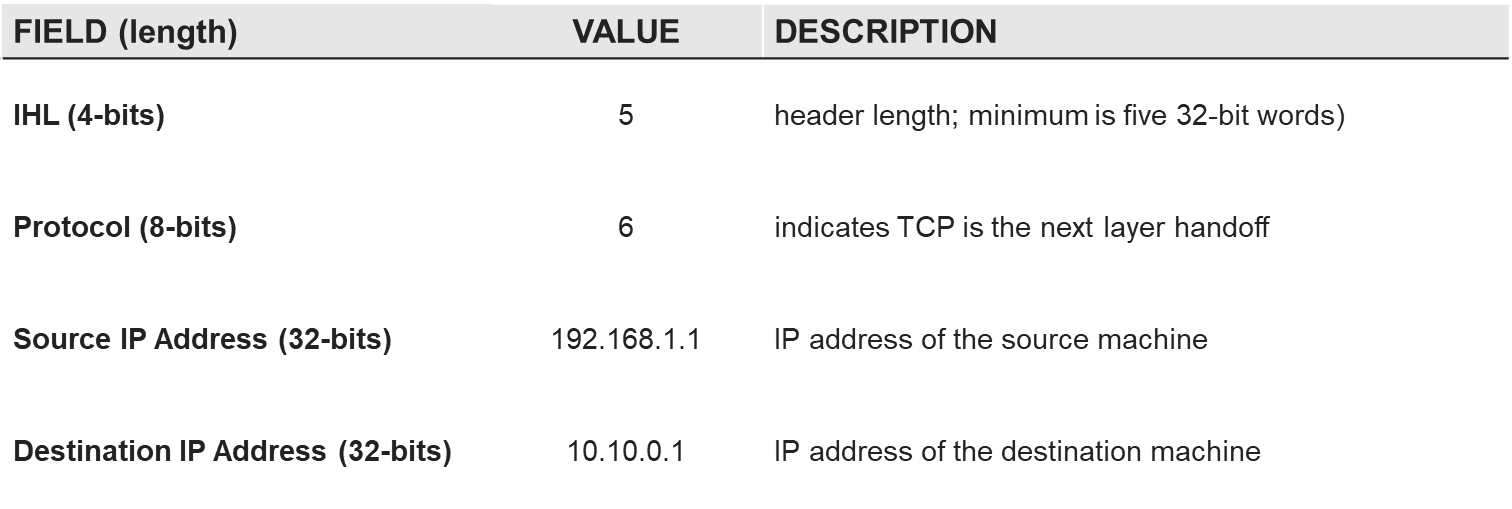
Mithilfe dieser Daten können Richtlinien definiert werden, um die Paketfilterung anzupassen. Die folgende Richtlinie filtert TCP-Pakete, die für eine bestimmte Ziel-IP-Adresse bestimmt sind.
Der Einsatz von eBPF für die Observability bietet einen BOGO-Vorteil („Eins kaufen, eins gratis“): Die erfassten Daten können über die Beobachtung hinaus auch für andere Zwecke genutzt werden, beispielsweise für die Datenverkehrssteuerung oder die Sicherheit.
Wenn wir noch einmal auf den zuvor vorgestellten Datensatz zurückkommen, sind Teile dieses Datensatzes, die zur Beobachtung des Pfads eingehenden Datenverkehrs auf einem Linux-Host verwendet werden, auch für andere Zwecke nützlich. Beispielsweise sind Quell-IP-Adresse, Ziel-IP-Adresse, Zielhost und Port sowohl für das Routing eingehenden Datenverkehrs als auch für die Zugriffsbeschränkung relevant.
Unabhängig vom Verwendungszweck beginnt alles damit, dass der BPF-Tap eine Kopie des Pakets erstellt. Sobald die Kopie erstellt wurde, können die Daten im Speicher abgelegt werden (weitere Informationen finden Sie unter BPF-Maps) und anschließend als Telemetriedatenstrom exportiert sowie gleichzeitig von anderen BPF-Programmen genutzt werden, die Richtlinien und Filteraktionen festlegen. An dieser Stelle verzweigen sich die Anwendungsbereiche von der Beobachtbarkeit hin zu Datenverkehrsmanagement und Sicherheit. Um die außerordentliche Effizienz von BPF optimal zu nutzen, muss zunächst klar sein, welche Daten benötigt und wie sie verwendet werden. Im nächsten Beitrag dieser Reihe wird mein Kollege Muhammad Waseem Sarwar die Möglichkeiten der BPF-Programmierung an verschiedenen Stellen im Linux-Netzwerk-Stack untersuchen.
Über den Autor

Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.