Während GPU-Cluster und KI-Fabriken die Schlagzeilen beherrschen, hängt das Kerngeschäft von weniger sichtbaren Objektspeicher-Pipelines ab. Die Archivierung und Sicherung von Datenbanken muss zuverlässig funktionieren. Geraten diese Pipelines ins Stocken, verlieren Anwendungen den Zugriff auf geschäftskritische Daten und Geschäftsprozesse kommen unmittelbar zum Erliegen. Für CIOs sind Speicherengpässe keine bloßen Infrastrukturdetails, sondern eine Bedrohung für die Geschäftskontinuität. Diese Pipelines unterstützen die Einhaltung von Compliance-Vorgaben und die Wiederherstellung im Katastrophenfall.
Die Bereitstellung von Daten für KI erhöht diesen operativen Druck zusätzlich. Große Sprachmodelle und Systeme für Retrieval-Augmented Generation (RAG) erfordern einen schnellen und zuverlässigen Datenzugriff. Die zentrale Herausforderung liegt daher nicht mehr darin, wie viele Daten Sie speichern können, sondern wie schnell und sicher Sie diese zwischen Plattformen und Modellen übertragen können.
Die Objektspeicher-Pipelines, an die niemand denkt – bis sie ausfallen
Objektspeicher in Unternehmen werden für unterschiedliche Workloads eingesetzt. Während einige öffentlichkeitswirksame KI-Projekte unterstützen, halten andere den täglichen Betrieb am Laufen. Diese operativen Pipelines erhalten selten die Aufmerksamkeit der Führungsebene. Dennoch entscheiden sie darüber, ob Sie sich von einem Ausfall erholen und Ihre Service-Level-Ziele erreichen können.
Diese Pipelines decken vier zentrale operative Verantwortungsbereiche ab. Fällt eine dieser Pipelines aus, kommt der Geschäftsbetrieb zum Stillstand:
- Geschäftskontinuität: Write-Ahead-Logs (WAL) von Datenbanken und Backups. Traditionell wurden WALs auf lokale Solid-State-Laufwerke (SSDs) geschrieben. Heute können moderne Cloud-Datenbanken WALs in S3-kompatiblen Speicher schreiben. Zusammen ermöglichen diese Workflows Teams, zentrale Systeme unmittelbar nach Ausfällen wiederherzustellen.
- Sicherheitsbetrieb: SIEM-Protokolle und forensische Beweismittel. Teams für die Reaktion auf Sicherheitsvorfälle und die Bedrohungserkennung nutzen diese Daten, um laufende Angriffe zu untersuchen.
- Compliance und Governance: Regulatorische Archive und unveränderbare Datentresore. Für diese Workloads ist die Datenverfügbarkeit eine strikte gesetzliche Vorgabe und keine bloße betriebliche Präferenz.
- Unternehmensdatenplattformen: Data Lakes und RAG-Wissensdatenbanken. Diese Pipelines versorgen die Anwendungen und Machine-Learning-Systeme, die Ihre Produkte antreiben.
Keine dieser Backend-Workloads ist besonders glamourös. Doch genau diese Datenpipelines entscheiden darüber, ob Ihr Unternehmen in einer Krise die Compliance-Anforderungen erfüllt und gut vorbereitet ist.
Die verborgenen Risiken liegen im Datenpfad
Obwohl Objektspeicher traditionell als Backend-Infrastruktur verwaltet werden, sind sie heute tatsächlich aktive Netzwerkdienste. Unabhängig davon, ob Sie Amazon S3 oder private Objektspeichersysteme nutzen, greifen Anwendungen über HTTP/S mithilfe von REST-APIs auf den Speicher zu. Aufgrund dieser Architektur sind Objektspeicher-Pipelines genau denselben Leistungs- und Sicherheitsrisiken ausgesetzt, die auch moderne Webanwendungen und Webdienste bedrohen.
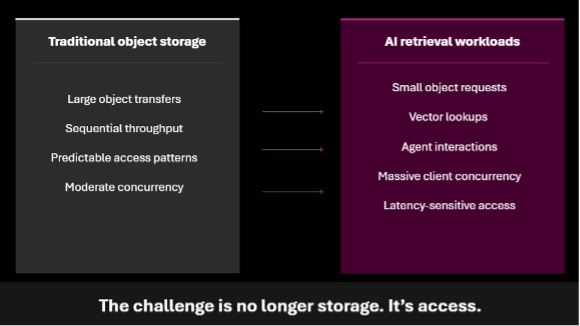
Verfügbarkeitsrisiken entstehen, wenn Lastspitzen die Netzwerkschnittstellen überlasten oder Speichercontroller ausfallen. Leistungsengpässe sind ebenso störend. Latenzspitzen und Netzwerküberlastungen beeinträchtigen kritische Backend-Abläufe, selbst wenn die zugrunde liegenden Speicherlaufwerke einwandfrei funktionieren. Beispielsweise kann eine Verzögerung im Archivierungsdatenstrom einer Datenbank die Write-Ahead-Protokollierung zum Stillstand bringen, wodurch die Datenbank ausgebremst wird und plötzlich ausfällt. Das eigentliche Risiko liegt nicht im ersten Fehler, sondern darin, wie weit er sich ausbreitet. Ohne Isolation im Datenpfad wird ein Problem in einer einzelnen Pipeline zu einem systemweiten Ausfall.
Die Nutzung von Web-APIs für den Speicherzugriff vergrößert die Angriffsfläche Ihres Unternehmens. Diese Endpunkte sind anfällig für DDoS-Angriffe. Da Sicherheitsteams und Entwickler auf Objektspeicher angewiesen sind, um Echtzeitanalysen und KI-Modelle mit Daten zu versorgen, hat eine Kompromittierung auf der Ebene der Speicher-APIs schwerwiegende betriebliche Folgen.
Die Verwaltung der reinen Speicherkapazität ist nicht mehr die größte Hürde. Die entscheidende technische Herausforderung besteht darin, die Kontrolle über die Datenbewegungen zwischen Anwendungen und Repositories zu behalten. Die Absicherung und Optimierung dieses Übertragungswegs ist inzwischen ebenso wichtig wie die Wartung der zugrunde liegenden Speicherplattform.
Engineering-Prinzipien für Datenpipelines im Objektspeicher
Wenn Sie Ihre Dateninfrastruktur für Analysen und KI modernisieren, können Sie Objektspeicher nicht länger als passives Repository betrachten. Sie müssen den Datenpfad selbst verwalten. So wie Sie einen Application Delivery Controller (ADC) einsetzen, um benutzerseitige Webanwendungen abzusichern, benötigen Sie entsprechende Kontrollpunkte für die Backend-Speicherpipelines, die Ihre KI-Datenbereitstellung ermöglichen. Indem Sie F5 BIG-IP vor Ihre Speicher-Buckets schalten, verwandeln Sie einen passiven, angreifbaren API-Endpunkt in eine hochverfügbare, sichere und beschleunigte Pipeline zur Datenbereitstellung.
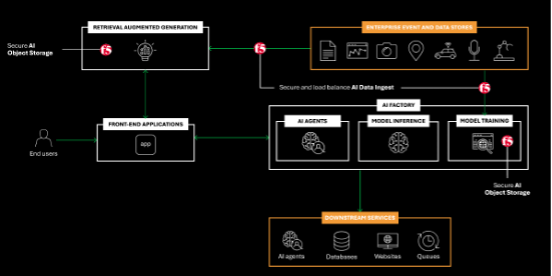
Da auf moderne Objektspeicher über das Netzwerk mittels HTTP/S-APIs zugegriffen wird, verhalten sie sich genau wie Webanwendungen. Daher ist ein ADC wie F5 BIG-IP das ideale Werkzeug für ihre Verwaltung. Als Steuerungsebene zwischen Anwendungen und Datenspeichern sichert und stabilisiert BIG-IP den Datenverkehr.
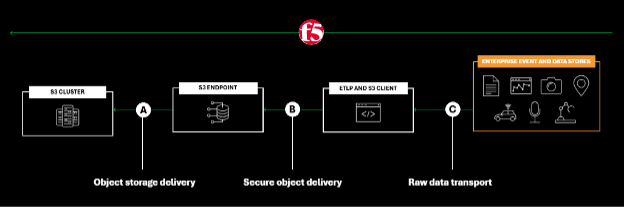
Diese Architektur bietet enorme betriebliche Vorteile, ohne dass Sie Anwendungen refaktorisieren oder Speicherplattformen neu konzipieren müssen:
- Keine Umstrukturierung des Speichers erforderlich: Die Erweiterung des Speichers um Sicherheits- und Routing-Funktionen ist ein kostspieliges, mehrjähriges Projekt. Durch die Vorschaltung von BIG-IP stehen sofort Routing und Protokollierung auf Enterprise-Niveau zur Verfügung – ohne Änderungen am zugrunde liegenden Speicher oder am Anwendungscode.
- Höhere Leistung durch Netzwerk-Offloading: Speichersysteme sind darauf ausgelegt, Daten zu lesen und zu schreiben – nicht darauf, den zusätzlichen Verarbeitungsaufwand für Netzwerkaufgaben zu bewältigen. BIG-IP übernimmt rechenintensive Aufgaben wie die SSL/TLS-Entschlüsselung. Durch die Auslagerung dieser netzwerkintensiven Aufgaben aus dem Speicher-Array kann sich Ihre Speicher-CPU auf E/A-Vorgänge konzentrieren und die Antwortzeiten bei KI-Abfragen verkürzen.
- Aktiver Sicherheitsschutz: Herkömmliche Speichersicherheit ist passiv und stützt sich auf Zugriffsschlüssel, die bösartige Abfragen nicht erkennen können. BIG-IP fungiert als aktiver Schutzschild und prüft den eingehenden Datenverkehr zur Speicher-API mit einer Web Application Firewall (WAF), um SQL-Injection- und DDoS-Angriffe abzuwehren, bevor diese Bedrohungen die Speicherebene erreichen.
Um eine hohe Verfügbarkeit sicherzustellen, überwacht BIG-IP den Zustand der Endpunkte und leitet den Datenverkehr an offline geschalteten Knoten vorbei. Zudem verteilt BIG-IP Abfragen dynamisch auf verschiedene Rechenzentren. Dadurch werden die Auswirkungen von Komponentenausfällen begrenzt, und Ihre Servicelevels bleiben auch bei wachsenden Datenmengen und steigenden Anforderungen durch KI-Modelle planbar.
Zuverlässige Datenübertragung ist heute eine geschäftliche Notwendigkeit
Indem Sie eine ADC-gesteuerte Steuerungsebene zwischen Anwendungen und Speicher platzieren, schaffen Sie einen ausfallsicheren und kontrollierbaren Datenpfad. Mit dieser Architekturentscheidung wenden Sie dieselben strengen technischen Maßstäbe auf Objektspeicher-Pipelines an, die Sie bereits für Ihre zentralen kundenorientierten Anwendungen und APIs nutzen.
Die geschäftskritischsten Datenpipelines im Unternehmen sind oft am wenigsten sichtbar. Ob Sie die Notfallwiederherstellung sicherstellen oder Compliance-Vorgaben einhalten – die Betriebsstabilität hängt vollständig davon ab, wie zuverlässig Daten durch Ihr Netzwerk fließen.
Angesichts steigender Leistungsanforderungen lässt sich Objektspeicher nicht mehr allein anhand von Kapazität und Skalierbarkeit bewerten. Für Unternehmensverantwortliche geht es nicht nur darum, mehr Daten zu speichern, sondern auch sicherzustellen, dass die Daten, auf denen ihre geschäftskritischen Abläufe und KI-Initiativen basieren, jederzeit verfügbar und sicher bleiben. Daten zu speichern ist nur der erste Schritt; auch der Datenpfad selbst muss gezielt auf Ausfallsicherheit, Kontrolle und die Begrenzung potenzieller Auswirkungen ausgelegt werden.
Der KI-Fokus von F5 geht noch weiter – erfahren Sie, wie F5 KI-Anwendungen überall schützt und bereitstellt.
Über den Autor
Ähnliche Blogbeiträge
Kubernetes-native WAF für das Gateway-Zeitalter: F5 WAF for NGINX lässt sich jetzt in F5 NGINX Gateway Fabric integrieren
F5 erweitert WAFs, um mit F5 NGINX Gateway Fabric und F5 NGINX Ingress Controller einen konsistenten, skalierbaren Schutz über Cluster und Umgebungen hinweg bereitzustellen.

Von Regeln zu Risiken: Die Entwicklung von WAFs und der Aufstieg KI-gestützter Ergebnisse
WAF-Programme geraten oft an einem bekannten Punkt ins Stocken: Der Blockierungsmodus wird verzögert aktiviert, weil die Feinabstimmung aufwendig ist.

Erklärbarkeit: Licht ins Dunkel der KI-Blackbox bringen
Einblicke von James White, CTO bei CalypsoAI: Dank GenAI verstehen wir inzwischen gut, wie Antworten generiert und an uns zurückgegeben werden. Vereinfacht gesagt basiert KI auf einer Transformer-Architektur – sie wählt die beste Vorhersage für das nächste Wort und den nächsten Satz aus und liefert anhand der ihr vorliegenden Informationen die wahrscheinlichste Antwort […]
Die neue KI-Risikolandschaft: unsichtbar, autonom und bereits im Unternehmen
James White, VP Engineering, F5 Zur Jahresmitte 2025 ist es an der Zeit, eine Momentaufnahme der KI-Nutzung in Unternehmen und des aktuellen Stands der KI-Sicherheit zu erstellen. Der Einsatz generativer KI ist in Unternehmen mittlerweile Standard Unternehmen verfügen inzwischen durchweg zumindest über ein grundlegendes Verständnis von generativer KI. Sie wissen, was sie ist und wo sie […]
Die KI-Grenzen sichern: Strategien zur Bekämpfung von Datenexfiltration
Da Unternehmen zunehmend Modelle der generativen KI (GenAI) und große Sprachmodelle (LLMs) in ihre digitalen Systeme integrieren, sind sie mit neuen und erhöhten Risiken konfrontiert. Wenig überraschend stehen dabei Risiken im Zusammenhang mit Datenexfiltration – der unbefugten Übertragung von Daten aus einem Unternehmen an ein externes Ziel – meist ganz oben auf der Prioritätenliste der Sicherheitsteams. Ein Verständnis […]
Everest Group-Bericht: Aktuelle Trends und Zukunftsaussichten bei der Einführung von GenAI in der Industrie
Wir freuen uns, einen wesentlichen Beitrag zu einem wegweisenden neuen Bericht der Everest Group, einem weltweit führenden Forschungsunternehmen, geleistet zu haben. Der Bericht mit dem Titel „Generative AI Adoption – Examining Real-world Use in Horizontal Functions and Future Outlook“ bietet eine eingehende Analyse der Einführung generativer KI (GenAI) in verschiedenen Branchen. Dem Bericht zufolge ist die IT […]