Site Reliability Engineer (SRE) ist eine relativ neue Rolle – üblicherweise im Engineering oder IT-Betrieb –, deren Schwerpunkt wenig überraschend auf der Gewährleistung der Zuverlässigkeit von Websites liegt. Damit ist in der Regel die Verfügbarkeit von Anwendungen gemeint, aber auch deren Performance. Das ist nachvollziehbar, denn Anwendungen, die nicht reagieren, gelten für die meisten Endnutzer heutzutage als nicht verfügbar.
Beim Lesen des SRE-Berichts 2018 von Catchpoint fielen mir die Diagramme auf, in denen Service-Level-Indikatoren und SRE-Metriken verglichen wurden. Wenn „Verfügbarkeit“ als übergeordneter Service-Level-Indikator aufgeführt wird, findet man normalerweise auch „Betriebszeit“ oder „Ausfallzeit“ als Metrik. Bei den SREs in dieser Umfrage war das jedoch nicht der Fall.
Auf die Frage, welche Service-Level-Indikatoren für ihre Dienste am wichtigsten seien, nannten überwältigende 84 % die „Verfügbarkeit für Endnutzer“ an erster Stelle. Die Latenz belegte mit 61 % den zweiten Platz, dicht gefolgt von der Fehlerrate mit 60 %. Die Performance – im Bericht als Antwortzeit für Endnutzer beschrieben – kam auf beeindruckende 58 % der Antworten.
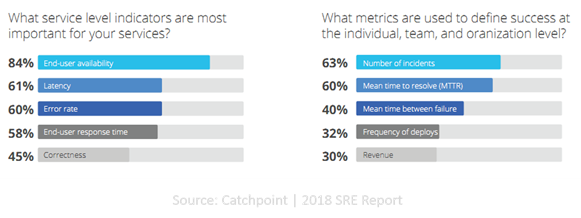
Beachten Sie nun die Kennzahlen, anhand derer Erfolg definiert wird. Im Bereich Infrastruktur und Betrieb sind wir eher an Kennzahlen wie „Verfügbarkeit“ und einprägsame Formulierungen wie „fünf Neunen“ gewöhnt.
SREs messen Erfolg dagegen eher an der Häufigkeit von Vorfällen und der MTTR. Da derselbe Bericht feststellte, dass 41 % der SREs vor ihrer Tätigkeit als SRE in der Rolle eines „DevOps Engineer“ gearbeitet hatten, dürfte dies nicht überraschen. Bei DevOps steht die MTTR stärker im Fokus als die Berechnung der Verfügbarkeit, da davon ausgegangen wird, dass es zu Ausfallzeiten kommen wird. Entscheidend ist, diese durch eine schnelle Behebung zu minimieren, statt Zeit mit dem Versuch zu verschwenden, sie gänzlich zu vermeiden.
Aufmerksame Leser werden jedoch feststellen, dass sich durch die Minimierung der MTTR auch die Ausfallzeit minimieren lässt. Je schneller die Störung behoben wird, desto kürzer ist die Ausfallzeit.
Der feine Unterschied zwischen den beiden besteht darin, dass Menschen dazu neigen, genau das zu optimieren, woran sie gemessen werden. Wenn man Sie an der Anzahl der Codezeilen misst, werden Sie sehr viele Codezeilen schreiben – unabhängig davon, ob sie benötigt werden oder nicht. Wenn man Sie an Sicherheitsvorfällen misst, werden Sie alles abriegeln und bei jeder Änderung, die eine Sicherheitsverletzung begünstigen könnte, laut NEIN rufen. Wenn man die Mitarbeitenden an der Verfügbarkeit misst, wird sich der IT-Betrieb darauf konzentrieren, die Systeme am Laufen und verfügbar zu halten – nicht jedoch darauf, Systeme und Anwendungen so zu konzipieren und zu instrumentieren, dass die MTTR sinkt.
Dies ist einer jener „kulturellen“ Aspekte von DevOps – eine veränderte Herangehensweise an den IT-Betrieb –, die auch in NetOps Einzug halten müssen. Wenn wir weiterhin auf Betriebszeit optimieren, verpassen wir die Chance, Warnmeldungs- und Observability-Funktionen (wie Monitoring und eine robuste Protokollierung) einzurichten, die die mittlere Lösungszeit verkürzen und uns dabei helfen, unser Ziel einer möglichst geringen Ausfallzeit zu erreichen.
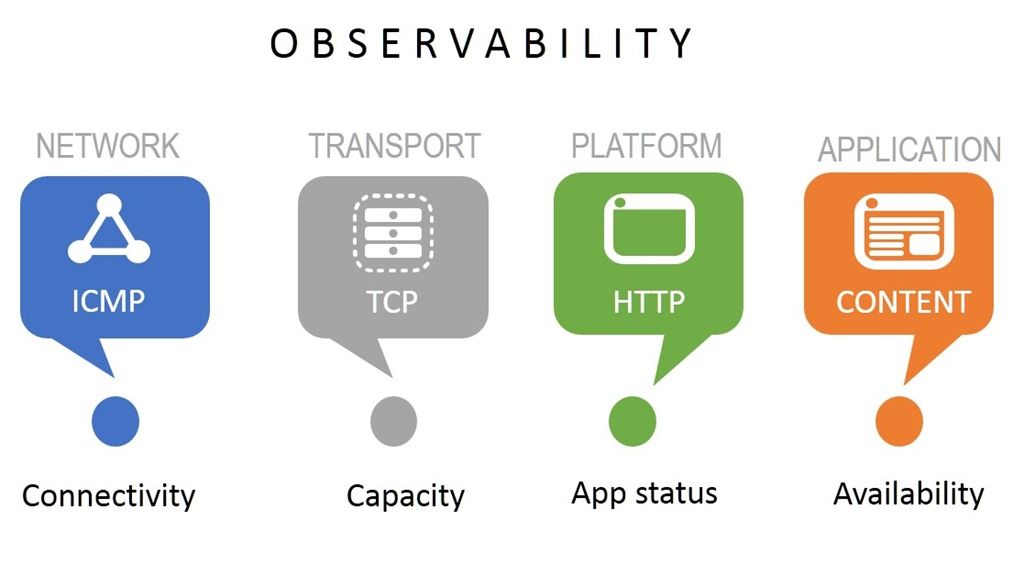
Das Durchforsten von Protokollen – selbst zentralisierten – ist kein effizientes Mittel, um einem Problem auf den Grund zu gehen und es zu beheben. Die Echtzeitüberwachung wichtiger, die Verfügbarkeit beeinflussender Variablen wie Kapazität, Konnektivität und Leistung sowie entsprechende Warnmeldungen über den gesamten Datenpfad hinweg (Netzwerk, Infrastruktur, Anwendung) verkürzen unweigerlich die zur Problembehebung benötigte Zeit, wenn Sie wissen, welche Systeme oder Dienste sich verschlechtern oder plötzlich ausgefallen sind.
NetOps muss diesen Ansatz im Hinblick auf die Zuverlässigkeit der Produktionspipeline übernehmen, da er insgesamt besser für den Umgang mit unvermeidbaren Ausfällen geeignet ist und mit dem Ansatz der DevOps-Kollegen übereinstimmt. Schließlich gibt es einen Grund, warum wir nur fünf Neunen angestrebt haben, oder? Weil wir erkannt haben, dass Ausfälle unvermeidlich sind – ganz gleich, wie sehr wir uns bemühen – und Perfektion unmöglich ist.
Der Wechsel von Verfügbarkeit/Ausfallzeit zu MTTR als Erfolgskennzahl fördert die teamübergreifende Zusammenarbeit und den Einsatz von Observability-Tools entlang der gesamten Produktionspipeline. Nicht ohne Grund standen Monitoring- und Alarmierungstools in der Umfrage ganz oben auf der Liste der „unverzichtbaren Tools“ für SREs. Observability (mit dem Ziel, bei Fehlern/Vorfällen Alarm auszulösen) in Kombination mit Zusammenarbeit ist die bessere Formel, um sicherzustellen, dass alle – NetOps, DevOps und auch die Anwendungsentwicklung – ihr Ziel erreichen können, Anwendungen schnell und verfügbar zu halten.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...