Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Service Discovery in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices (dieser Artikel)
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Microservices-Referenzarchitektur und besuchen Sie die Seite Microservices-Lösungen.
Dies ist der sechste Artikel einer Reihe über die Entwicklung von Anwendungen mit Microservices. Der erste Artikel stellt das Architekturmuster der Microservices vor und erläutert die Vor- und Nachteile des Einsatzes von Microservices. Die folgenden Artikel behandeln verschiedene Aspekte der Microservices-Architektur: Verwendung eines API-Gateways, Interprozesskommunikation, Serviceerkennung und ereignisgesteuerte Datenverwaltung. In diesem Artikel befassen wir uns mit Strategien für die Bereitstellung von Microservices.
Motivation
Das Bereitstellen einer monolithischen Anwendung bedeutet, mehrere identische Kopien einer einzigen, in der Regel großen Anwendung auszuführen. Üblicherweise stellen Sie N Server (physisch oder virtuell) bereit und führen auf jedem davon M Instanzen der Anwendung aus. Die Bereitstellung einer monolithischen Anwendung ist nicht immer ganz unkompliziert, aber wesentlich einfacher als die Bereitstellung einer Microservices-Anwendung.
Eine Microservices-Anwendung besteht aus Dutzenden oder sogar Hunderten von Diensten. Die Dienste werden in verschiedenen Sprachen und Frameworks entwickelt. Jeder einzelne ist eine Mini-Anwendung mit eigenen spezifischen Anforderungen an Bereitstellung, Ressourcen, Skalierung und Überwachung. Beispielsweise muss je nach Nachfrage nach dem jeweiligen Dienst eine bestimmte Anzahl von Instanzen ausgeführt werden. Außerdem müssen jeder Dienstinstanz die entsprechenden CPU-, Arbeitsspeicher- und E/A-Ressourcen zur Verfügung gestellt werden. Eine zusätzliche Herausforderung besteht darin, dass die Bereitstellung der Dienste trotz dieser Komplexität schnell, zuverlässig und kosteneffizient erfolgen muss.
Es gibt verschiedene Bereitstellungsmuster für Microservices. Sehen wir uns zunächst das Muster „Mehrere Serviceinstanzen pro Host“ an.
Muster „Mehrere Serviceinstanzen pro Host“
Eine Möglichkeit zur Bereitstellung Ihrer Microservices ist die Verwendung des Musters „Mehrere Serviceinstanzen pro Host“. Bei diesem Muster stellen Sie einen oder mehrere physische oder virtuelle Hosts bereit und führen auf jedem davon mehrere Serviceinstanzen aus. In vielerlei Hinsicht entspricht dies dem traditionellen Ansatz für die Anwendungsbereitstellung. Jede Serviceinstanz wird über einen fest definierten Port auf einem oder mehreren Hosts ausgeführt. Die Hostsysteme werden üblicherweise wie Haustiere behandelt.
Das folgende Diagramm zeigt die Struktur dieses Musters.
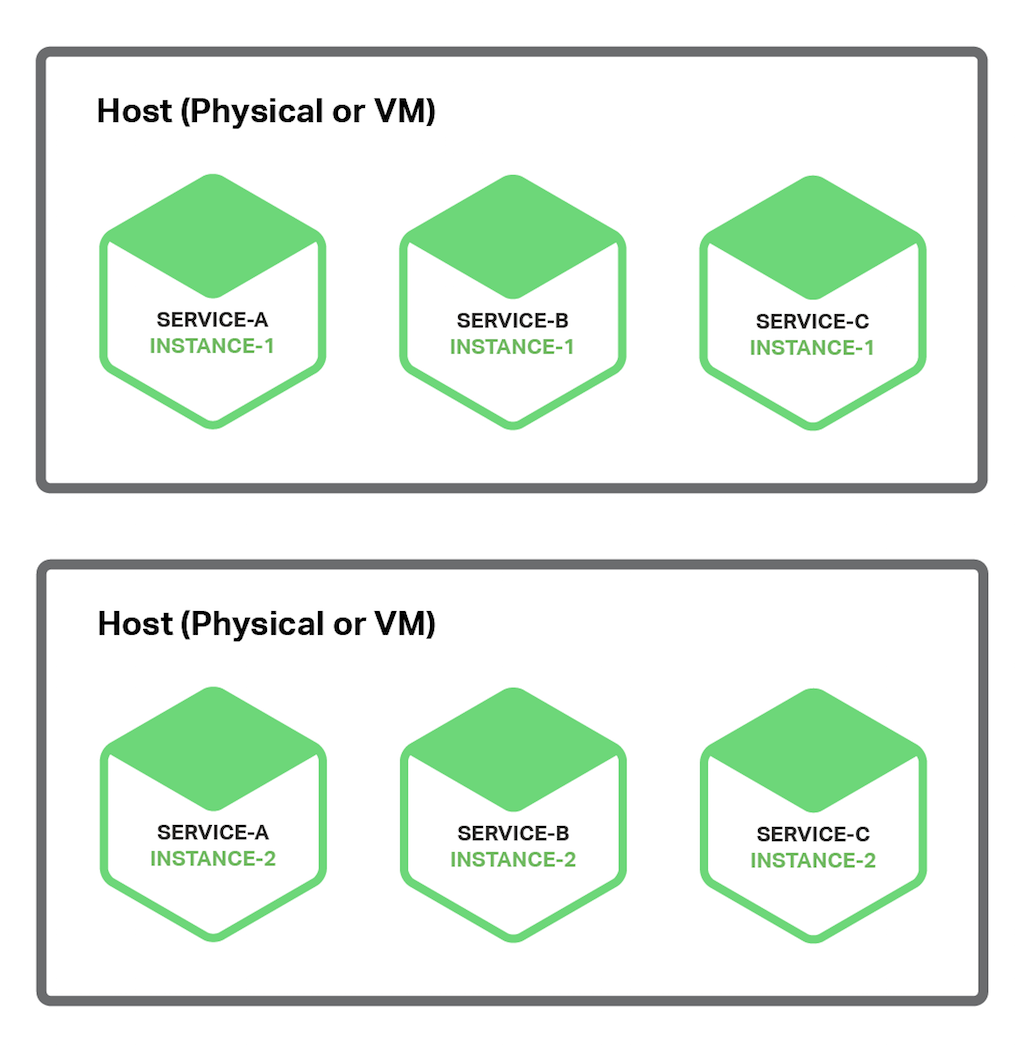
Dieses Muster gibt es in mehreren Varianten. Bei einer Variante wird jede Serviceinstanz als Prozess oder Prozessgruppe ausgeführt. Beispielsweise könnten Sie eine Java-Serviceinstanz als Webanwendung auf einem Apache Tomcat-Server bereitstellen. Eine Node.js-Serviceinstanz könnte aus einem übergeordneten Prozess und einem oder mehreren untergeordneten Prozessen bestehen.
Die andere Variante dieses Musters besteht darin, mehrere Serviceinstanzen im selben Prozess oder in derselben Prozessgruppe auszuführen. Beispielsweise könnten Sie mehrere Java-Webanwendungen auf demselben Apache-Tomcat-Server bereitstellen oder mehrere OSGI-Bundles im selben OSGI-Container ausführen.
Das Muster „Mehrere Dienstinstanzen pro Host“ hat sowohl Vor- als auch Nachteile. Ein wesentlicher Vorteil ist die relativ effiziente Ressourcennutzung. Mehrere Dienstinstanzen teilen sich den Server und dessen Betriebssystem. Noch effizienter ist es, wenn mehrere Dienstinstanzen in einem Prozess oder einer Prozessgruppe ausgeführt werden, beispielsweise mehrere Webanwendungen, die denselben Apache-Tomcat-Server und dieselbe JVM nutzen.
Ein weiterer Vorteil dieses Musters besteht darin, dass sich eine Serviceinstanz relativ schnell bereitstellen lässt. Sie kopieren den Service einfach auf einen Host und starten ihn. Wenn der Service in Java geschrieben ist, kopieren Sie eine JAR- oder WAR-Datei. Bei anderen Sprachen wie Node.js oder Ruby kopieren Sie den Quellcode. In beiden Fällen ist die Anzahl der über das Netzwerk kopierten Bytes relativ gering.
Da kein zusätzlicher Overhead anfällt, lässt sich ein Service in der Regel auch sehr schnell starten. Wenn der Service als eigener Prozess ausgeführt wird, starten Sie ihn einfach. Ist der Service hingegen eine von mehreren Instanzen, die im selben Containerprozess oder in derselben Prozessgruppe ausgeführt werden, stellen Sie ihn entweder dynamisch im Container bereit oder starten den Container neu.
Trotz seiner Vorzüge hat das Muster „Mehrere Dienstinstanzen pro Host“ einige erhebliche Nachteile. Ein wesentlicher Nachteil besteht darin, dass die Dienstinstanzen kaum oder gar nicht voneinander isoliert sind, es sei denn, jede Dienstinstanz wird als separater Prozess ausgeführt. Zwar lässt sich die Ressourcennutzung jeder Dienstinstanz genau überwachen, doch die von den einzelnen Instanzen genutzten Ressourcen können nicht begrenzt werden. Eine fehlerhaft arbeitende Dienstinstanz kann daher unter Umständen den gesamten Arbeitsspeicher oder die gesamte CPU-Leistung des Hosts beanspruchen.
Wenn mehrere Serviceinstanzen im selben Prozess ausgeführt werden, sind sie überhaupt nicht voneinander isoliert. Beispielsweise könnten sich alle Instanzen denselben JVM-Heap teilen. Eine fehlerhafte Serviceinstanz könnte die anderen im selben Prozess ausgeführten Services leicht beeinträchtigen. Darüber hinaus gibt es keine Möglichkeit, die von den einzelnen Serviceinstanzen genutzten Ressourcen zu überwachen.
Ein weiteres erhebliches Problem bei diesem Ansatz besteht darin, dass das Betriebsteam, das einen Service bereitstellt, die konkreten Einzelheiten der Bereitstellung kennen muss. Services können in verschiedenen Sprachen und Frameworks entwickelt werden, sodass das Entwicklungsteam zahlreiche Details an das Betriebsteam weitergeben muss. Diese Komplexität erhöht das Fehlerrisiko bei der Bereitstellung.
Wie Sie sehen, weist das Muster „Mehrere Serviceinstanzen pro Host“ trotz seiner Vertrautheit einige erhebliche Nachteile auf. Sehen wir uns nun andere Möglichkeiten zur Bereitstellung von Microservices an, mit denen sich diese Probleme vermeiden lassen.
Muster „Dienstinstanz pro Host“
Eine weitere Möglichkeit zur Bereitstellung Ihrer Microservices ist das Muster „Serviceinstanz pro Host“. Bei diesem Muster wird jede Serviceinstanz isoliert auf einem eigenen Host ausgeführt. Es gibt zwei verschiedene Spezialisierungen dieses Musters: Serviceinstanz pro virtueller Maschine und Serviceinstanz pro Container.
Muster „Dienstinstanz pro virtueller Maschine“
Wenn Sie das Muster „Serviceinstanz pro virtueller Maschine“ verwenden, verpacken Sie jeden Service als Image einer virtuellen Maschine (VM), beispielsweise als ein Amazon EC2 AMI. Jede Serviceinstanz ist eine VM (z. B. eine EC2-Instanz), die mithilfe dieses VM-Images gestartet wird. Das folgende Diagramm zeigt die Struktur dieses Musters:
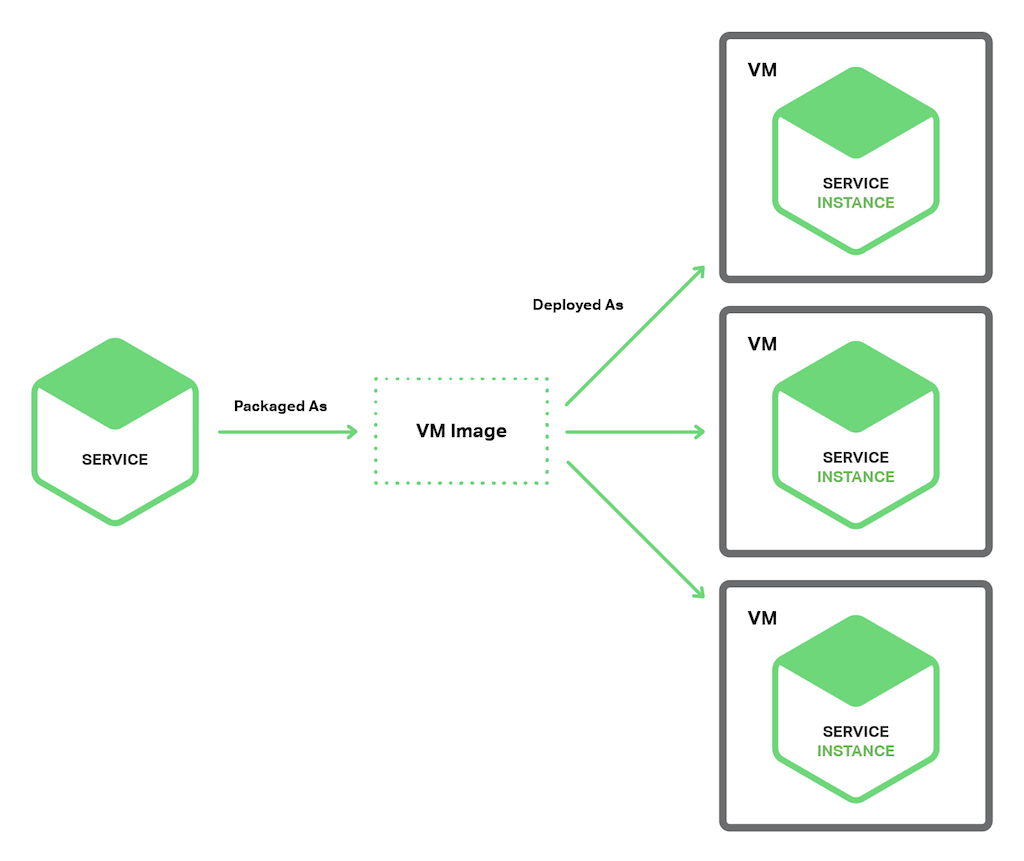
Dies ist der primäre Ansatz, den Netflix zur Bereitstellung seines Video-Streaming-Dienstes verwendet. Netflix verpackt jeden seiner Dienste mithilfe von Aminator als EC2 AMI. Jede ausgeführte Dienstinstanz ist eine EC2-Instanz.
Es gibt eine Vielzahl von Tools, mit denen Sie Ihre eigenen VMs erstellen können. Sie können Ihren Continuous-Integration-Server (CI-Server) (zum Beispiel Jenkins) so konfigurieren, dass er Aminator aufruft, um Ihre Dienste als EC2 AMI zu paketieren. Packer.io ist eine weitere Option für die automatisierte Erstellung von VM-Images. Im Gegensatz zu Aminator unterstützt es eine Vielzahl von Virtualisierungstechnologien, darunter EC2, DigitalOcean, VirtualBox und VMware.
Das Unternehmen Boxfuse bietet eine überzeugende Methode zur Erstellung von VM-Images, mit der die im Folgenden beschriebenen Nachteile von VMs überwunden werden. Boxfuse verpackt Ihre Java-Anwendung als minimales VM-Image. Diese Images lassen sich schnell erstellen, starten schnell und sind sicherer, da sie nur eine begrenzte Angriffsfläche bieten.
Das Unternehmen CloudNative bietet mit Bakery eine SaaS-Lösung zur Erstellung von EC2 AMIs an. Sie können Ihren CI-Server so konfigurieren, dass er Bakery aufruft, nachdem die Tests für Ihren Microservice erfolgreich abgeschlossen wurden. Bakery verpackt Ihren Service anschließend als AMI. Durch die Nutzung einer SaaS-Lösung wie Bakery müssen Sie keine wertvolle Zeit mit dem Einrichten der Infrastruktur zur AMI-Erstellung verschwenden.
Das Muster „Dienstinstanz pro virtueller Maschine“ bietet eine Reihe von Vorteilen. Ein wesentlicher Vorteil von VMs besteht darin, dass jede Dienstinstanz vollständig isoliert ausgeführt wird. Ihr steht eine festgelegte Menge an CPU- und Arbeitsspeicherressourcen zur Verfügung, und sie kann anderen Diensten keine Ressourcen entziehen.
Ein weiterer Vorteil der Bereitstellung Ihrer Microservices als VMs besteht darin, dass Sie eine ausgereifte Cloud-Infrastruktur nutzen können. Cloud-Anbieter wie AWS bieten nützliche Funktionen wie Lastverteilung und automatische Skalierung.
Ein weiterer großer Vorteil der Bereitstellung Ihres Dienstes als VM besteht darin, dass die für die Implementierung des Dienstes verwendete Technologie gekapselt wird. Sobald ein Dienst als VM paketiert wurde, wird er zu einer Blackbox. Die Verwaltungs-API der VM wird zur API für die Bereitstellung des Dienstes. Dadurch wird die Bereitstellung wesentlich einfacher und zuverlässiger.
Das Muster „Dienstinstanz pro virtueller Maschine“ hat jedoch auch einige Nachteile. Ein Nachteil ist die weniger effiziente Ressourcennutzung. Jede Dienstinstanz verursacht den Overhead einer vollständigen VM einschließlich des Betriebssystems. Darüber hinaus sind VMs in einer typischen öffentlichen IaaS-Umgebung nur in festen Größen verfügbar, sodass die VM möglicherweise nicht vollständig ausgelastet wird.
Darüber hinaus fallen bei einer öffentlichen IaaS in der Regel Kosten für VMs an, unabhängig davon, ob sie ausgelastet sind oder sich im Leerlauf befinden. Eine IaaS wie AWS bietet zwar automatische Skalierung, doch es ist schwierig, schnell auf Nachfrageänderungen zu reagieren. Daher müssen häufig mehr VMs als nötig bereitgestellt werden, was die Bereitstellungskosten erhöht.
Ein weiterer Nachteil dieses Ansatzes besteht darin, dass die Bereitstellung einer neuen Version eines Dienstes in der Regel langsam ist. Aufgrund ihrer Größe dauert die Erstellung von VM-Images üblicherweise lange. Auch das Instanziieren von VMs nimmt in der Regel viel Zeit in Anspruch, ebenfalls aufgrund ihrer Größe. Zudem benötigt ein Betriebssystem normalerweise eine gewisse Zeit zum Hochfahren. Dies gilt jedoch nicht ausnahmslos, da es auch leichtgewichtige VMs gibt, wie sie beispielsweise mit Boxfuse erstellt werden.
Ein weiterer Nachteil des Musters „Serviceinstanz pro virtueller Maschine“ besteht darin, dass Sie (oder eine andere Person in Ihrem Unternehmen) in der Regel für einen Großteil der undifferenzierten Routinearbeit verantwortlich sind. Sofern Sie kein Tool wie Boxfuse verwenden, das den Aufwand für die Erstellung und Verwaltung der VMs übernimmt, liegt diese Aufgabe bei Ihnen. Diese notwendige, aber zeitaufwendige Tätigkeit lenkt von Ihrem Kerngeschäft ab.
Sehen wir uns nun eine alternative Möglichkeit zur Bereitstellung von Microservices an, die schlanker ist und dennoch viele der Vorteile virtueller Maschinen bietet.
Muster „Dienstinstanz pro Container“
Wenn Sie das Muster „Serviceinstanz pro Container“ verwenden, wird jede Serviceinstanz in einem eigenen Container ausgeführt. Container sind ein Virtualisierungsmechanismus auf Betriebssystemebene. Ein Container besteht aus einem oder mehreren Prozessen, die in einer Sandbox ausgeführt werden. Aus Sicht der Prozesse verfügen sie über einen eigenen Port-Namensraum und ein eigenes Root-Dateisystem. Sie können die Arbeitsspeicher- und CPU-Ressourcen eines Containers begrenzen. Einige Containerimplementierungen ermöglichen zudem eine Begrenzung der E/A-Rate. Beispiele für Containertechnologien sind Docker und Solaris Zones.
Das folgende Diagramm zeigt die Struktur dieses Musters:
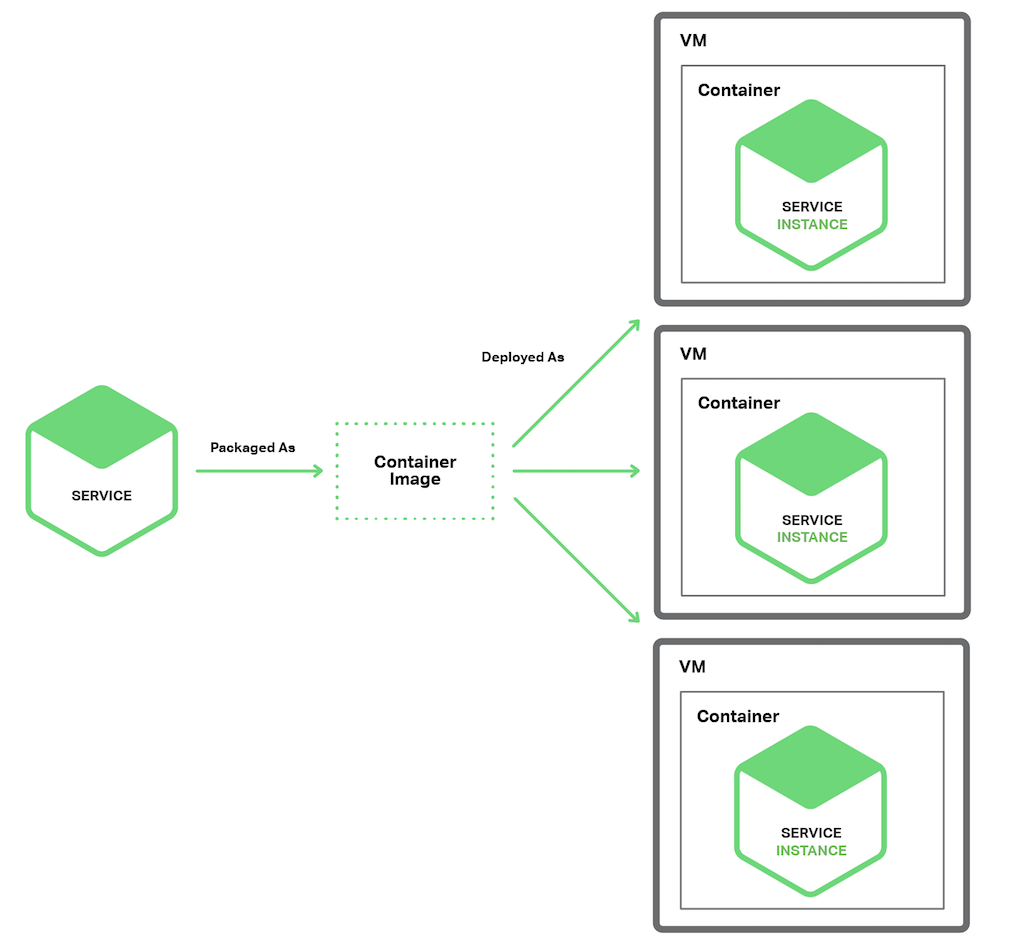
Um dieses Muster zu verwenden, verpacken Sie Ihren Service als Container-Image. Ein Container-Image ist ein Dateisystemabbild, das die zum Ausführen des Service erforderlichen Anwendungen und Bibliotheken enthält. Einige Container-Images umfassen ein vollständiges Linux-Root-Dateisystem. Andere sind schlanker. Um beispielsweise einen Java-Service bereitzustellen, erstellen Sie ein Container-Image, das die Java-Laufzeitumgebung, gegebenenfalls einen Apache-Tomcat-Server, und Ihre kompilierte Java-Anwendung enthält.
Nachdem Sie Ihren Dienst als Container-Image paketiert haben, starten Sie einen oder mehrere Container. In der Regel führen Sie auf jedem physischen oder virtuellen Host mehrere Container aus. Zur Verwaltung Ihrer Container können Sie einen Cluster-Manager wie Kubernetes oder Marathon verwenden. Ein Cluster-Manager behandelt die Hosts als Ressourcenpool. Er entscheidet anhand der vom Container benötigten Ressourcen und der auf den einzelnen Hosts verfügbaren Ressourcen, wo jeder Container platziert wird.
Das Muster „Serviceinstanz pro Container“ hat sowohl Vor- als auch Nachteile. Die Vorteile von Containern ähneln denen virtueller Maschinen. Sie isolieren Ihre Serviceinstanzen voneinander. Sie können die von jedem Container verbrauchten Ressourcen problemlos überwachen. Ebenso wie virtuelle Maschinen kapseln Container außerdem die Technologie, mit der Ihre Services implementiert werden. Die Containerverwaltungs-API dient zugleich als API für die Verwaltung Ihrer Services.
Im Gegensatz zu VMs sind Container jedoch eine leichtgewichtige Technologie. Container-Images lassen sich in der Regel sehr schnell erstellen. Auf meinem Laptop dauert es beispielsweise nur 5 Sekunden, eine Spring Boot-Anwendung als Docker-Container zu paketieren. Container starten ebenfalls sehr schnell, da kein langwieriger Betriebssystem-Startvorgang erforderlich ist. Beim Start eines Containers wird direkt der Dienst ausgeführt.
Die Verwendung von Containern hat einige Nachteile. Obwohl die Container-Infrastruktur schnell ausgereifter wird, ist sie noch nicht so ausgereift wie die Infrastruktur für VMs. Außerdem sind Container nicht so sicher wie VMs, da sie sich den Kernel des Hostbetriebssystems teilen.
Ein weiterer Nachteil von Containern besteht darin, dass Sie den allgemeinen Verwaltungsaufwand für die Container-Images selbst übernehmen müssen. Sofern Sie keine gehostete Container-Lösung wie Google Container Engine oder Amazon EC2 Container Service (ECS) verwenden, müssen Sie außerdem die Container-Infrastruktur und möglicherweise auch die VM-Infrastruktur verwalten, auf der sie ausgeführt wird.
Außerdem werden Container häufig auf einer Infrastruktur bereitgestellt, deren Preise pro VM berechnet werden. Daher entstehen Ihnen, wie bereits beschrieben, wahrscheinlich zusätzliche Kosten, weil Sie VMs überdimensionieren müssen, um Lastspitzen bewältigen zu können.
Interessanterweise dürfte die Unterscheidung zwischen Containern und VMs zunehmend verschwimmen. Wie bereits erwähnt, lassen sich Boxfuse VMs schnell erstellen und starten. Das Projekt Clear Containers zielt darauf ab, schlanke VMs zu entwickeln. [Redaktion – Wie im Dezember 2017 angekündigt, wird die Entwicklung von Clear Containers nun im Open-Source-Projekt Kata Containers fortgeführt.] Auch das Interesse an Unikernels nimmt zu. Docker, Inc. hat kürzlich Unikernel Systems übernommen.
Darüber hinaus gibt es das neuere und zunehmend beliebte Konzept der serverlosen Bereitstellung. Bei diesem Ansatz entfällt die Entscheidung, ob Dienste in Containern oder virtuellen Maschinen bereitgestellt werden sollen. Sehen wir uns das als Nächstes an.
Serverless-Bereitstellung
AWS Lambda ist ein Beispiel für eine Technologie zur serverlosen Bereitstellung. Sie unterstützt Dienste in Java, Node.js und Python. Um einen Microservice bereitzustellen, verpacken Sie ihn als ZIP-Datei und laden ihn in AWS Lambda hoch. Außerdem stellen Sie Metadaten bereit, die unter anderem den Namen der Funktion angeben, die zur Verarbeitung einer Anfrage (auch als Ereignis bezeichnet) aufgerufen wird. AWS Lambda führt automatisch genügend Instanzen Ihres Microservices aus, um die Anfragen zu verarbeiten. Ihnen wird lediglich jede Anfrage auf Grundlage der benötigten Zeit und des verbrauchten Arbeitsspeichers in Rechnung gestellt. Natürlich steckt der Teufel im Detail, und Sie werden gleich sehen, dass AWS Lambda Einschränkungen hat. Doch die Vorstellung, dass weder Sie als Entwickler noch andere Personen in Ihrem Unternehmen sich um irgendeinen Aspekt von Servern, virtuellen Maschinen oder Containern kümmern müssen, ist äußerst reizvoll.
Eine Lambda-Funktion ist ein zustandsloser Dienst. Sie verarbeitet Anfragen in der Regel durch den Aufruf von AWS-Diensten. Beispielsweise könnte eine Lambda-Funktion, die beim Hochladen eines Bildes in einen S3-Bucket aufgerufen wird, einen Eintrag in eine DynamoDB-Bildertabelle einfügen und eine Nachricht in einem Kinesis-Stream veröffentlichen, um die Bildverarbeitung auszulösen. Eine Lambda-Funktion kann auch Webdienste von Drittanbietern aufrufen.
Es gibt vier Möglichkeiten, eine Lambda-Funktion aufzurufen:
- Direkt über eine Webservice-Anfrage
- Automatisch als Reaktion auf ein Ereignis, das von einem AWS-Service wie S3, DynamoDB, Kinesis oder Simple Email Service generiert wurde
- Automatisch über ein AWS API Gateway, um HTTP-Anfragen von Clients der Anwendung zu verarbeiten
- Regelmäßig nach einem
cron-ähnlichen Zeitplan
Wie Sie sehen, bietet AWS Lambda eine komfortable Möglichkeit zur Bereitstellung von Microservices. Dank der anfragebasierten Preisgestaltung zahlen Sie nur für die Arbeit, die Ihre Services tatsächlich ausführen. Da Sie außerdem nicht für die IT-Infrastruktur verantwortlich sind, können Sie sich ganz auf die Entwicklung Ihrer Anwendung konzentrieren.
Es gibt jedoch einige erhebliche Einschränkungen. AWS Lambda ist nicht für die Bereitstellung lang laufender Services vorgesehen, beispielsweise eines Services, der Nachrichten von einem Message Broker eines Drittanbieters verarbeitet. Anfragen müssen innerhalb von 300 Sekunden abgeschlossen sein. Services müssen zustandslos sein, da AWS Lambda theoretisch für jede Anfrage eine separate Instanz ausführen könnte. Sie müssen in einer der unterstützten Sprachen geschrieben sein. Außerdem müssen Services schnell starten, da es andernfalls zu einer Zeitüberschreitung und ihrer Beendigung kommen kann.
Zusammenfassung
Die Bereitstellung einer Microservices-Anwendung ist eine Herausforderung. Sie besteht aus Dutzenden oder sogar Hunderten von Services, die in unterschiedlichen Sprachen und Frameworks entwickelt wurden. Jeder einzelne ist eine Mini-Anwendung mit eigenen spezifischen Anforderungen an Bereitstellung, Ressourcen, Skalierung und Überwachung. Für die Bereitstellung von Microservices gibt es verschiedene Muster, darunter eine Serviceinstanz pro virtueller Maschine und eine Serviceinstanz pro Container. Eine weitere interessante Option für die Bereitstellung von Microservices ist AWS Lambda, ein serverloser Ansatz. Im nächsten und letzten Teil dieser Reihe sehen wir uns an, wie eine monolithische Anwendung auf eine Microservices-Architektur migriert werden kann.
Redaktion – Diese siebenteilige Artikelserie ist nun abgeschlossen:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices (dieser Artikel)
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Microservices-Referenzarchitektur und besuchen Sie die Seite zu Microservices-Lösungen.
Gastautor Chris Richardson ist der Gründer des ursprünglichen Angebots CloudFoundry.com, einer frühen Java-PaaS-Lösung (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Blogbeiträge über Microservices unter https://microservices.io.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.