Redaktion – Diese siebenteilige Artikelserie ist nun abgeschlossen:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices (dieser Artikel)
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Microservices-Referenzarchitektur und besuchen Sie die Seite zu Microservices-Lösungen.
Dies ist der siebte und letzte Artikel meiner Reihe über die Entwicklung von Anwendungen mit Microservices. Der erste Artikel stellt das Microservices-Architekturmuster vor und erläutert die Vor- und Nachteile des Einsatzes von Microservices. Die folgenden Artikel behandeln verschiedene Aspekte der Microservices-Architektur: die Verwendung eines API-Gateways<.htmla>, Interprozesskommunikation, Service Discovery, ereignisgesteuertes Datenmanagement und die Bereitstellung von Microservices. In diesem Artikel befassen wir uns mit Strategien für die Migration einer monolithischen Anwendung zu Microservices.
Ich hoffe, dass Ihnen diese Artikelreihe ein gutes Verständnis der Microservices-Architektur, ihrer Vor- und Nachteile sowie der Frage vermittelt hat, wann sie eingesetzt werden sollte. Vielleicht ist die Microservices-Architektur eine gute Wahl für Ihr Unternehmen.
Es ist jedoch recht wahrscheinlich, dass Sie an einer großen, komplexen monolithischen Anwendung arbeiten. Die tägliche Entwicklung und Bereitstellung Ihrer Anwendung ist langsam und mühsam. Microservices scheinen wie ein ferner Sehnsuchtsort. Glücklicherweise gibt es Strategien, mit denen Sie der monolithischen Hölle entkommen können. In diesem Artikel beschreibe ich, wie sich eine monolithische Anwendung schrittweise in eine Reihe von Microservices umstrukturieren lässt.
Überblick über die Umstrukturierung hin zu Microservices
Die Umwandlung einer monolithischen Anwendung in Microservices ist eine Form der Anwendungsmodernisierung. Damit beschäftigen sich Entwickler bereits seit Jahrzehnten. Daher gibt es einige Ansätze, die wir bei der Umstrukturierung einer Anwendung in Microservices wiederverwenden können.
Eine Strategie, die Sie nicht anwenden sollten, ist die „Big-Bang“-Neuentwicklung. Dabei konzentrieren Sie Ihre gesamten Entwicklungsanstrengungen darauf, eine neue, auf Microservices basierende Anwendung von Grund auf zu entwickeln. Das klingt zwar verlockend, ist aber äußerst riskant und wird wahrscheinlich scheitern. Wie Martin Fowler gesagt haben soll: „Das Einzige, was eine Big-Bang-Neuentwicklung garantiert, ist ein großer Knall!“
Anstelle einer Big-Bang-Neuentwicklung sollten Sie Ihre monolithische Anwendung schrittweise refaktorieren. Dabei entwickeln Sie nach und nach eine neue, aus Microservices bestehende Anwendung und betreiben sie parallel zu Ihrer monolithischen Anwendung. Im Laufe der Zeit nimmt der Funktionsumfang der monolithischen Anwendung immer weiter ab, bis sie entweder vollständig verschwindet oder nur noch ein weiterer Microservice ist. Diese Strategie ist vergleichbar damit, Ihr Auto während einer Autobahnfahrt mit 110 km/h zu warten – eine Herausforderung, aber weitaus weniger riskant als der Versuch einer Big-Bang-Neuentwicklung.
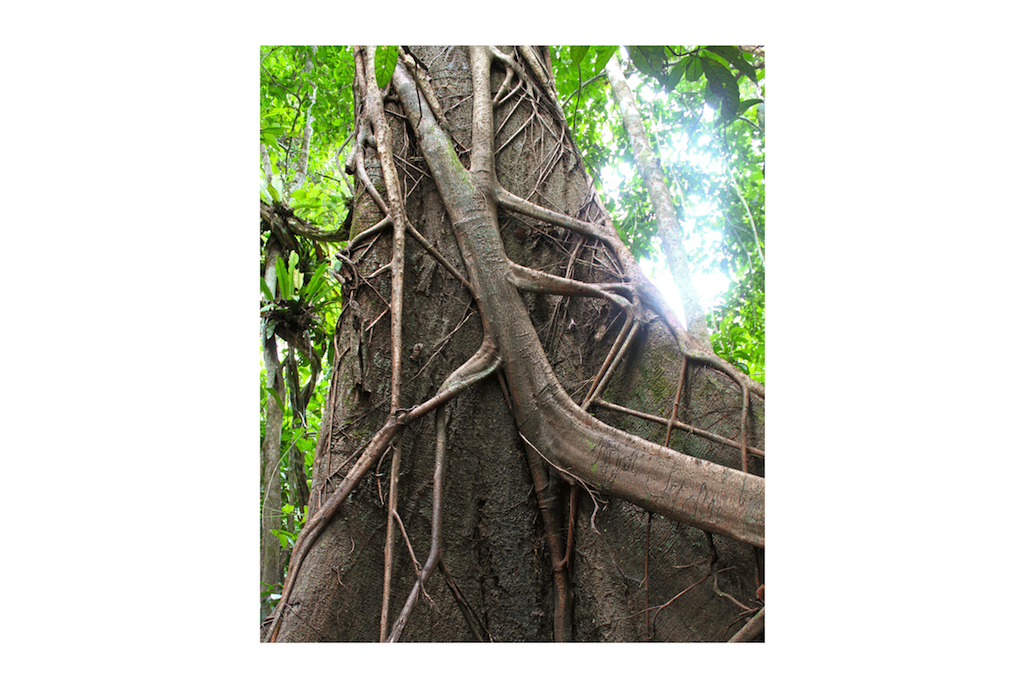
Martin Fowler bezeichnet diese Strategie zur Anwendungsmodernisierung als „Strangler Application“. Der Name leitet sich von der Würgefeige ab, die in Regenwäldern vorkommt. Eine Würgefeige wächst um einen Baum herum, um das Sonnenlicht über dem Blätterdach zu erreichen. Manchmal stirbt der Baum ab und hinterlässt eine baumförmige Würgefeige. Die Anwendungsmodernisierung folgt demselben Muster. Wir bauen rund um die Altanwendung eine neue, aus Microservices bestehende Anwendung auf, die die Altanwendung schließlich vollständig ablösen wird.
Sehen wir uns verschiedene Strategien dafür an.
Strategie 1 – Hören Sie auf zu graben
Das Gesetz der Löcher besagt: Wenn man in einem Loch steckt, sollte man aufhören zu graben. Dies ist ein hervorragender Rat, wenn Ihre monolithische Anwendung nicht mehr zu bewältigen ist. Mit anderen Worten: Sie sollten den Monolithen nicht weiter vergrößern. Das bedeutet, dass Sie bei der Implementierung neuer Funktionen keinen weiteren Code zum Monolithen hinzufügen sollten. Der Kerngedanke dieser Strategie besteht vielmehr darin, den neuen Code in einem eigenständigen Microservice unterzubringen. Das folgende Diagramm zeigt die Systemarchitektur nach Anwendung dieses Ansatzes.
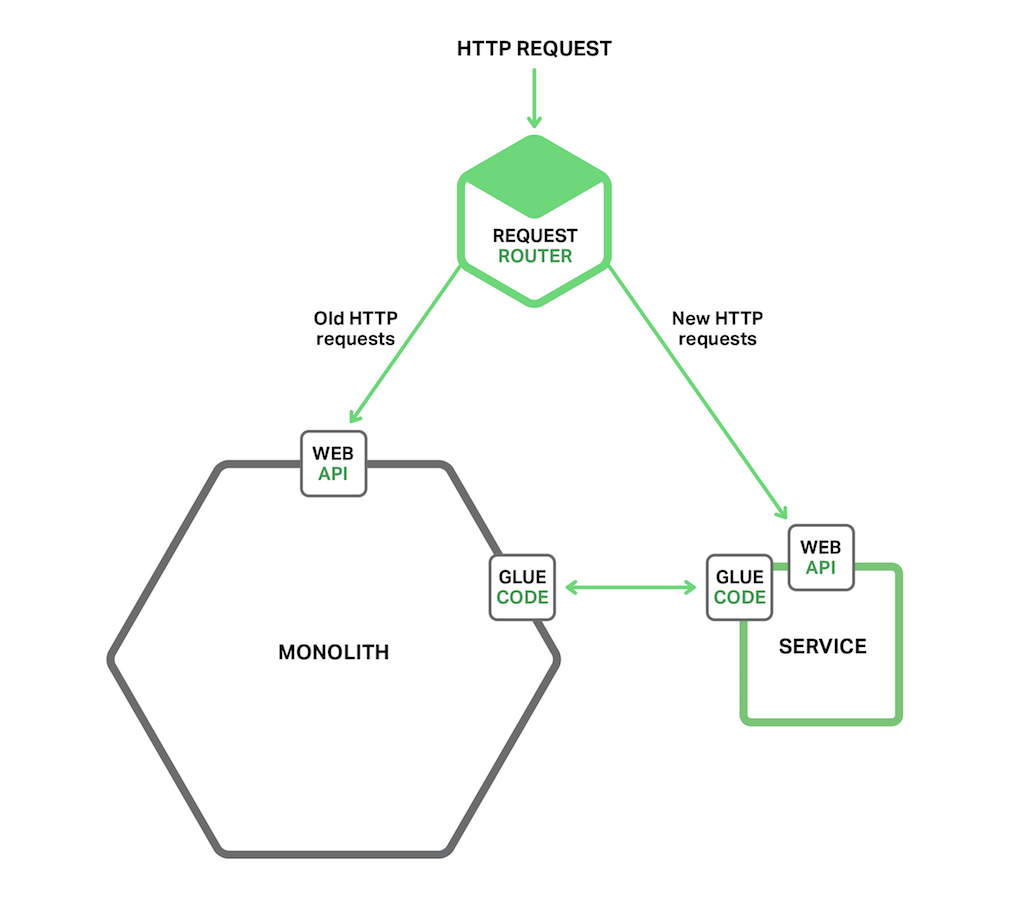
Neben dem neuen Dienst und dem bisherigen Monolithen gibt es zwei weitere Komponenten. Die erste ist ein Request-Router, der eingehende (HTTP-)Anfragen verarbeitet. Er ähnelt dem API-Gateway, das in einem früheren Artikel<.htmla> beschrieben wurde. Der Router leitet Anfragen für neue Funktionen an den neuen Dienst weiter. Anfragen für bestehende Funktionen leitet er an den Monolithen weiter.
Die andere Komponente ist der Glue Code, der den Service in den Monolithen integriert. Ein Service existiert selten isoliert und muss häufig auf Daten zugreifen, die dem Monolithen zugeordnet sind. Der Glue Code, der sich entweder im Monolithen, im Service oder in beiden befindet, ist für die Datenintegration verantwortlich. Der Service verwendet den Glue Code, um die dem Monolithen zugeordneten Daten zu lesen und zu schreiben.
Es gibt drei Strategien, mit denen ein Service auf die Daten des Monolithen zugreifen kann:
- Eine vom Monolithen bereitgestellte Remote-API aufrufen
- Direkt auf die Datenbank des Monolithen zugreifen
- Eine eigene Kopie der Daten vorhalten, die mit der Datenbank des Monolithen synchronisiert wird
Der Glue Code wird manchmal als Anti-Corruption Layer bezeichnet. Der Grund dafür ist, dass der Glue Code verhindert, dass der Service, der über ein eigenes, unverfälschtes Domänenmodell verfügt, durch Konzepte aus dem Domänenmodell des Legacy-Monolithen verunreinigt wird. Der Glue Code übersetzt zwischen den beiden unterschiedlichen Modellen. Der Begriff Anti-Corruption Layer tauchte erstmals in Eric Evans’ Pflichtlektüre Domain Driven Design auf und wurde später in einem Whitepaper weiter ausgearbeitet. Die Entwicklung einer Anti-Corruption Layer kann ein durchaus anspruchsvolles Unterfangen sein. Sie ist jedoch unerlässlich, wenn Sie der monolithischen Hölle schrittweise entkommen wollen.
Die Implementierung neuer Funktionen als schlanker Service bietet mehrere Vorteile. Sie verhindert, dass der Monolith noch unübersichtlicher wird. Der Service kann unabhängig vom Monolithen entwickelt, bereitgestellt und skaliert werden. Mit jedem neuen Service, den Sie erstellen, profitieren Sie von den Vorteilen der Microservices-Architektur.
Dieser Ansatz trägt jedoch nicht dazu bei, die Probleme des Monolithen zu lösen. Um diese Probleme zu beheben, müssen Sie den Monolithen aufteilen. Sehen wir uns einige Strategien dafür an.
Strategie 2 – Frontend und Backend trennen
Eine Strategie zur Verkleinerung der monolithischen Anwendung besteht darin, die Präsentationsschicht von der Geschäftslogik und den Datenzugriffsschichten zu trennen. Eine typische Unternehmensanwendung besteht aus mindestens drei verschiedenen Arten von Komponenten:
- Präsentationsschicht – Komponenten, die HTTP-Anfragen verarbeiten und entweder eine (REST-)API oder eine HTML-basierte Web-Benutzeroberfläche implementieren. In einer Anwendung mit einer anspruchsvollen Benutzeroberfläche macht die Präsentationsschicht häufig einen erheblichen Teil des Codes aus.
- Geschäftslogikschicht – Komponenten, die den Kern der Anwendung bilden und die Geschäftsregeln implementieren.
- Datenzugriffsschicht – Komponenten, die auf Infrastrukturkomponenten wie Datenbanken und Message Broker zugreifen.
In der Regel besteht eine klare Trennung zwischen der Präsentationslogik auf der einen Seite und der Geschäfts- und Datenzugriffslogik auf der anderen. Die Geschäftsschicht verfügt über eine grobgranulare API, die aus einer oder mehreren Fassaden besteht, welche die Komponenten der Geschäftslogik kapseln. Diese API bildet eine natürliche Trennlinie, entlang derer Sie den Monolithen in zwei kleinere Anwendungen aufteilen können. Eine Anwendung enthält die Präsentationsschicht. Die andere Anwendung enthält die Geschäfts- und Datenzugriffslogik. Nach der Aufteilung führt die Anwendung mit der Präsentationslogik Remote-Aufrufe an die Anwendung mit der Geschäftslogik aus. Das folgende Diagramm zeigt die Architektur vor und nach dem Refactoring.
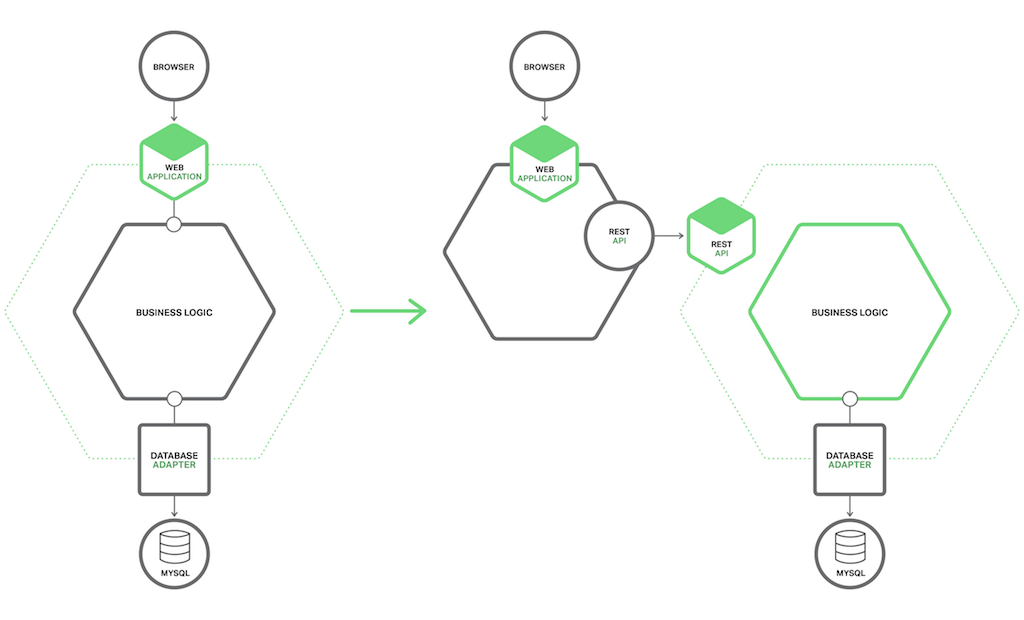
Die Aufteilung eines Monolithen auf diese Weise bietet zwei wesentliche Vorteile. Sie ermöglicht es Ihnen, die beiden Anwendungen unabhängig voneinander zu entwickeln, bereitzustellen und zu skalieren. Insbesondere können die Entwickler der Präsentationsschicht dadurch die Benutzeroberfläche schnell weiterentwickeln und beispielsweise problemlos A/B-Tests durchführen. Ein weiterer Vorteil dieses Ansatzes besteht darin, dass er eine Remote-API bereitstellt, die von den von Ihnen entwickelten Microservices aufgerufen werden kann.
Diese Strategie ist jedoch nur eine Teillösung. Sehr wahrscheinlich wird eine oder werden beide Anwendungen ein nicht mehr beherrschbarer Monolith sein. Sie müssen die dritte Strategie anwenden, um den verbleibenden Monolithen beziehungsweise die verbleibenden Monolithen zu beseitigen.
Strategie 3 – Services extrahieren
Die dritte Refactoring-Strategie besteht darin, vorhandene Module innerhalb des Monolithen in eigenständige Microservices umzuwandeln. Jedes Mal, wenn Sie ein Modul herauslösen und in einen Service umwandeln, wird der Monolith kleiner. Sobald Sie genügend Module umgewandelt haben, stellt der Monolith kein Problem mehr dar. Entweder verschwindet er vollständig oder er wird so klein, dass er nur noch ein weiterer Service ist.
Priorisierung der in Services umzuwandelnden Module
Eine große, komplexe monolithische Anwendung besteht aus Dutzenden oder Hunderten von Modulen, die alle für eine Auslagerung infrage kommen. Die Entscheidung, welche Module zuerst umgewandelt werden sollen, ist oft schwierig. Ein guter Ansatz besteht darin, mit einigen wenigen Modulen zu beginnen, die sich leicht auslagern lassen. So sammeln Sie Erfahrungen mit Microservices im Allgemeinen und insbesondere mit dem Auslagerungsprozess. Anschließend sollten Sie die Module auslagern, die Ihnen den größten Nutzen bringen.
Die Umwandlung eines Moduls in einen Service ist in der Regel zeitaufwendig. Daher sollten Sie die Module nach dem zu erwartenden Nutzen priorisieren. Meist ist es sinnvoll, häufig geänderte Module auszulagern. Sobald Sie ein Modul in einen Service umgewandelt haben, können Sie es unabhängig vom Monolithen entwickeln und bereitstellen, was die Entwicklung beschleunigt.
Es ist außerdem von Vorteil, Module auszulagern, deren Ressourcenanforderungen sich deutlich von denen des übrigen Monolithen unterscheiden. So kann es beispielsweise sinnvoll sein, ein Modul mit einer In-Memory-Datenbank in einen Service umzuwandeln, der anschließend auf Hosts mit viel Arbeitsspeicher bereitgestellt werden kann. Ebenso kann es sich lohnen, Module auszulagern, die rechenintensive Algorithmen implementieren, da der Service dann auf Hosts mit vielen CPUs bereitgestellt werden kann. Indem Sie Module mit besonderen Ressourcenanforderungen in Services umwandeln, können Sie die Skalierung Ihrer Anwendung erheblich vereinfachen.
Bei der Entscheidung, welche Module herausgelöst werden sollen, ist es sinnvoll, nach vorhandenen grobgranularen Grenzen (auch als Nahtstellen bezeichnet) zu suchen. Sie erleichtern und verbilligen die Umwandlung von Modulen in Services. Ein Beispiel für eine solche Grenze ist ein Modul, das ausschließlich über asynchrone Nachrichten mit dem Rest der Anwendung kommuniziert. Ein solches Modul lässt sich relativ kostengünstig und einfach in einen Microservice umwandeln.
So extrahieren Sie ein Modul
Der erste Schritt beim Herauslösen eines Moduls besteht darin, eine grobgranulare Schnittstelle zwischen dem Modul und dem Monolithen zu definieren. Dabei handelt es sich höchstwahrscheinlich um eine bidirektionale API, da der Monolith Daten benötigt, die dem Service gehören, und umgekehrt. Die Implementierung einer solchen API ist aufgrund der komplexen Abhängigkeiten und feingranularen Interaktionsmuster zwischen dem Modul und dem Rest der Anwendung oft schwierig. Geschäftslogik, die mithilfe des Domain-Model-Musters implementiert wurde, lässt sich aufgrund der zahlreichen Beziehungen zwischen den Domain-Model-Klassen besonders schwer refaktorieren. Häufig sind erhebliche Codeänderungen erforderlich, um diese Abhängigkeiten aufzulösen. Das folgende Diagramm veranschaulicht die Refaktorierung.
Nachdem Sie die grobgranulare Schnittstelle implementiert haben, wandeln Sie das Modul in einen eigenständigen Service um. Dazu müssen Sie Code schreiben, der es dem Monolithen und dem Service ermöglicht, über eine API zu kommunizieren, die einen Mechanismus zur Interprozesskommunikation (IPC) verwendet. Das folgende Diagramm zeigt die Architektur vor, während und nach dem Refactoring.
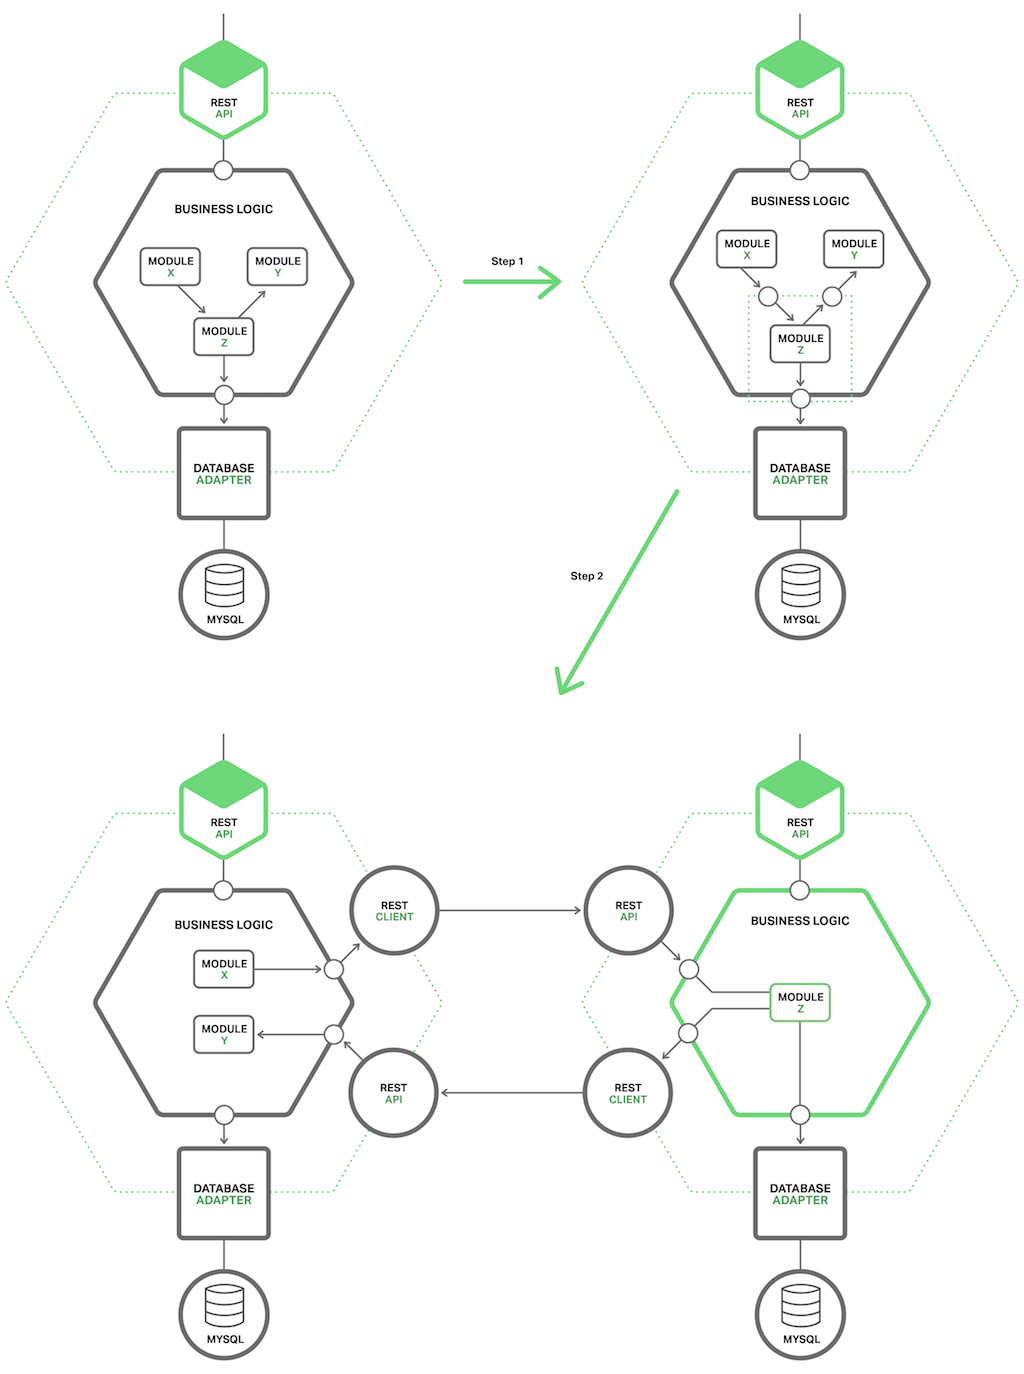
In diesem Beispiel ist Modul Z der Kandidat für die Extraktion. Seine Komponenten werden von Modul X verwendet, während es selbst Modul Y verwendet. Der erste Refactoring-Schritt besteht darin, zwei grobgranulare APIs zu definieren. Die erste Schnittstelle ist eine eingehende Schnittstelle, über die Modul X Modul Z aufruft. Die zweite ist eine ausgehende Schnittstelle, über die Modul Z Modul Y aufruft.
Im zweiten Refactoring-Schritt wird das Modul in einen eigenständigen Service umgewandelt. Die eingehenden und ausgehenden Schnittstellen werden durch Code implementiert, der einen IPC-Mechanismus verwendet. Höchstwahrscheinlich müssen Sie den Service erstellen, indem Sie Modul Z mit einem Microservice-Chassis-Framework kombinieren, das Querschnittsbelange wie die Serviceerkennung übernimmt.
Nachdem Sie ein Modul extrahiert haben, verfügen Sie über einen weiteren Service, der unabhängig vom Monolithen und allen anderen Services entwickelt, bereitgestellt und skaliert werden kann. Sie können den Service sogar von Grund auf neu schreiben. In diesem Fall wird der API-Code, der den Service in den Monolithen integriert, zu einer Anti-Corruption-Schicht, die zwischen den beiden Domänenmodellen übersetzt. Mit jedem extrahierten Service kommen Sie der Microservices-Architektur einen weiteren Schritt näher. Im Laufe der Zeit wird der Monolith schrumpfen, während die Anzahl der Microservices zunimmt.
Zusammenfassung
Die Migration einer bestehenden Anwendung zu Microservices ist eine Form der Anwendungsmodernisierung. Sie sollten nicht zu Microservices wechseln, indem Sie Ihre Anwendung von Grund auf neu schreiben. Stattdessen sollten Sie Ihre Anwendung schrittweise in eine Reihe von Microservices umstrukturieren. Dafür stehen Ihnen drei Strategien zur Verfügung: Implementieren Sie neue Funktionen als Microservices, trennen Sie die Präsentationskomponenten von den Geschäfts- und Datenzugriffskomponenten und wandeln Sie bestehende Module des Monolithen in Services um. Mit der Zeit wird die Anzahl der Microservices zunehmen, und Ihr Entwicklungsteam wird agiler und schneller arbeiten können.
Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices (dieser Artikel)
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Referenzarchitektur für Microservices und besuchen Sie die Seite zu Microservices-Lösungen.
Gastautor Chris Richardson ist der Gründer des ursprünglichen Unternehmens CloudFoundry.com, einer frühen Java-PaaS-Lösung (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Blogbeiträge über Microservices unter https://microservices.io
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.