Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices (dieser Artikel)
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Microservices-Referenzarchitektur und besuchen Sie die Seite Microservices-Lösungen.
Dies ist der fünfte Artikel einer Reihe über die Entwicklung von Anwendungen mit Microservices. Der erste Artikel stellt das Architekturmuster der Microservices vor und erläutert die Vor- und Nachteile des Einsatzes von Microservices. Der zweite<.htmla> und der dritte Artikel der Reihe beschreiben verschiedene Aspekte der Kommunikation innerhalb einer Microservices-Architektur. Der vierte Artikel befasst sich mit dem eng damit verbundenen Problem der Serviceerkennung. In diesem Artikel wechseln wir das Thema und betrachten die Probleme der verteilten Datenverwaltung, die in einer Microservices-Architektur auftreten.
Microservices und das Problem der verteilten Datenverwaltung
Eine monolithische Anwendung verfügt in der Regel über eine einzige relationale Datenbank. Ein wesentlicher Vorteil einer relationalen Datenbank besteht darin, dass Ihre Anwendung ACID-Transaktionen verwenden kann, die einige wichtige Garantien bieten:
- Atomarität – Änderungen werden atomar vorgenommen
- Konsistenz – Der Zustand der Datenbank ist stets konsistent
- Isolation – Obwohl Transaktionen gleichzeitig ausgeführt werden, scheint es, als würden sie nacheinander ausgeführt.
- Dauerhaftigkeit – Sobald eine Transaktion bestätigt wurde, wird sie nicht mehr rückgängig gemacht
Daher kann Ihre Anwendung einfach eine Transaktion starten, mehrere Zeilen ändern (einfügen, aktualisieren und löschen) und die Transaktion anschließend festschreiben.
Ein weiterer großer Vorteil einer relationalen Datenbank besteht darin, dass sie SQL bereitstellt – eine leistungsfähige, deklarative und standardisierte Abfragesprache. Damit können Sie problemlos eine Abfrage schreiben, die Daten aus mehreren Tabellen zusammenführt. Der Abfrageplaner des RDBMS ermittelt anschließend die optimale Ausführungsmethode. Um technische Details auf niedriger Ebene, etwa den Zugriff auf die Datenbank, müssen Sie sich nicht kümmern. Und da sich sämtliche Daten Ihrer Anwendung in einer einzigen Datenbank befinden, lassen sie sich einfach abfragen.
Leider wird der Datenzugriff wesentlich komplexer, wenn wir zu einer Microservices-Architektur übergehen. Das liegt daran, dass die Daten, die dem jeweiligen Microservice gehören, nur diesem Microservice zugänglich sind und ausschließlich über dessen API abgerufen werden können. Die Kapselung der Daten stellt sicher, dass die Microservices lose gekoppelt sind und sich unabhängig voneinander weiterentwickeln können. Wenn mehrere Services auf dieselben Daten zugreifen, erfordern Schemaänderungen zeitaufwendige, koordinierte Aktualisierungen aller Services.
Erschwerend kommt hinzu, dass verschiedene Microservices häufig unterschiedliche Arten von Datenbanken verwenden. Moderne Anwendungen speichern und verarbeiten vielfältige Datentypen, und eine relationale Datenbank ist nicht immer die beste Wahl. Für manche Anwendungsfälle bietet eine bestimmte NoSQL-Datenbank möglicherweise ein geeigneteres Datenmodell sowie eine deutlich bessere Leistung und Skalierbarkeit. So ist es beispielsweise sinnvoll, dass ein Dienst, der Texte speichert und durchsucht, eine Textsuchmaschine wie Elasticsearch verwendet. Ebenso sollte ein Dienst, der Daten sozialer Graphen speichert, wahrscheinlich eine Graphdatenbank wie Neo4j verwenden. Daher nutzen Microservices-basierte Anwendungen häufig eine Kombination aus SQL- und NoSQL-Datenbanken – den sogenannten Polyglot-Persistence-Ansatz.
Eine partitionierte Architektur mit polyglotter Persistenz für die Datenspeicherung bietet viele Vorteile, darunter lose gekoppelte Services sowie eine bessere Performance und Skalierbarkeit. Sie bringt jedoch auch einige Herausforderungen bei der verteilten Datenverwaltung mit sich.
Die erste Herausforderung besteht darin, Geschäftstransaktionen so zu implementieren, dass die Konsistenz über mehrere Services hinweg gewahrt bleibt. Um zu verstehen, warum dies problematisch ist, betrachten wir als Beispiel einen B2B-Onlineshop. Der Kundenservice verwaltet Informationen über die Kunden, einschließlich ihrer Kreditrahmen. Der Bestellservice verwaltet Bestellungen und muss sicherstellen, dass eine neue Bestellung das Kreditlimit des Kunden nicht überschreitet. In der monolithischen Version dieser Anwendung kann der Bestellservice einfach eine ACID-Transaktion verwenden, um den verfügbaren Kreditrahmen zu prüfen und die Bestellung anzulegen.
Im Gegensatz dazu sind in einer Microservices-Architektur die Tabellen ORDER und CUSTOMER jeweils nur für den zugehörigen Service zugänglich, wie das folgende Diagramm zeigt.
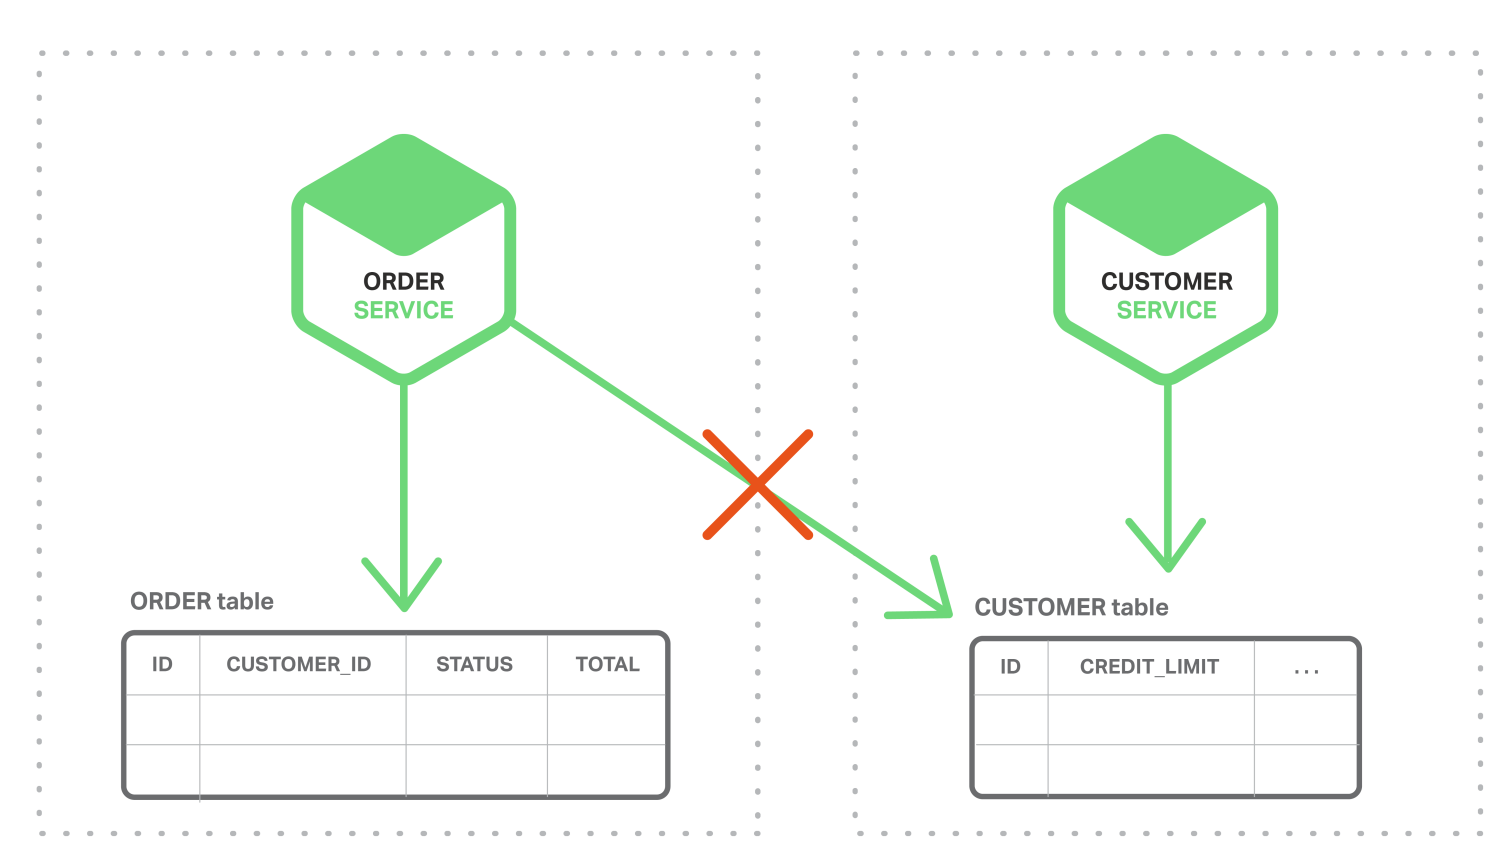
Der Order Service kann nicht direkt auf die Tabelle CUSTOMER zugreifen. Er kann nur die vom Customer Service bereitgestellte API verwenden. Der Order Service könnte möglicherweise verteilte Transaktionen, auch bekannt als Zwei-Phasen-Commit (2PC), verwenden. Allerdings ist 2PC für moderne Anwendungen in der Regel keine praktikable Option. Das CAP-Theorem zwingt zu einer Entscheidung zwischen Verfügbarkeit und ACID-konformer Konsistenz, wobei Verfügbarkeit in der Regel die bessere Wahl ist. Darüber hinaus unterstützen viele moderne Technologien, darunter die meisten NoSQL-Datenbanken, kein 2PC. Die Datenkonsistenz über mehrere Services und Datenbanken hinweg muss unbedingt gewährleistet werden. Daher benötigen wir eine andere Lösung.
Die zweite Herausforderung besteht darin, Abfragen zu implementieren, die Daten aus mehreren Services abrufen. Stellen wir uns beispielsweise vor, dass die Anwendung einen Kunden und seine letzten Bestellungen anzeigen muss. Wenn der Order Service eine API zum Abrufen der Bestellungen eines Kunden bereitstellt, können Sie diese Daten mithilfe eines anwendungsseitigen Joins abrufen. Die Anwendung ruft den Kunden vom Customer Service und die Bestellungen des Kunden vom Order Service ab. Angenommen jedoch, der Order Service unterstützt nur die Suche nach Bestellungen anhand ihres Primärschlüssels (vielleicht verwendet er eine NoSQL-Datenbank, die nur Abfragen anhand des Primärschlüssels unterstützt). In diesem Fall gibt es keine naheliegende Möglichkeit, die benötigten Daten abzurufen.
Ereignisgesteuerte Architektur
Für viele Anwendungen besteht die Lösung darin, eine ereignisgesteuerte Architektur zu verwenden. In dieser Architektur veröffentlicht ein Microservice ein Ereignis, wenn etwas Bemerkenswertes geschieht, beispielsweise wenn er eine Geschäftsentität aktualisiert. Andere Microservices abonnieren diese Ereignisse. Wenn ein Microservice ein Ereignis empfängt, kann er seine eigenen Geschäftsentitäten aktualisieren, was dazu führen kann, dass weitere Ereignisse veröffentlicht werden.
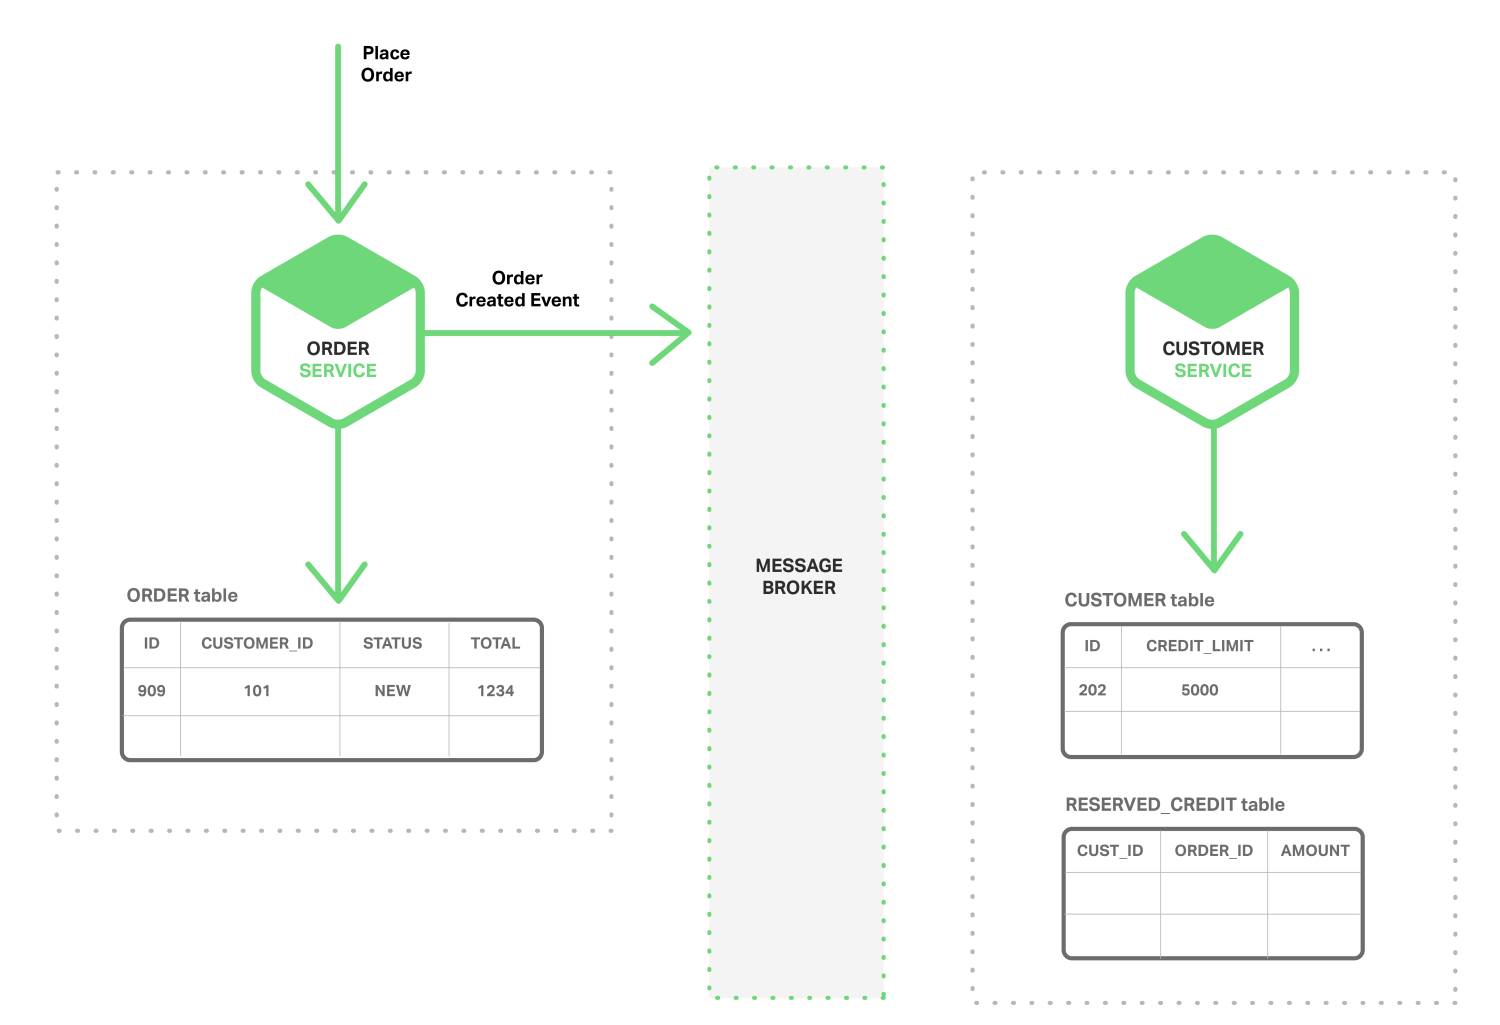
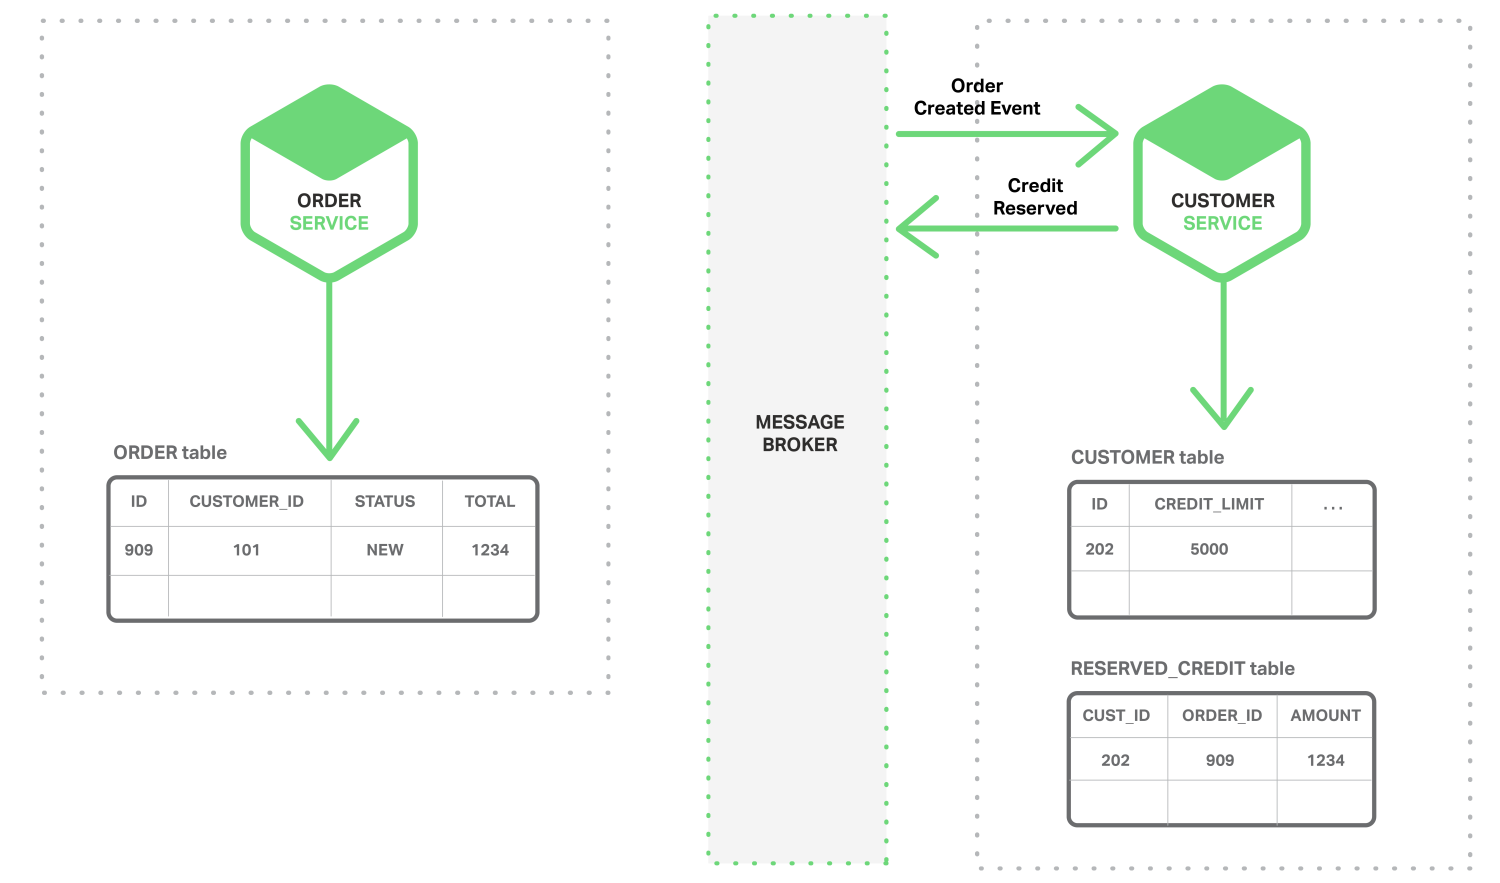
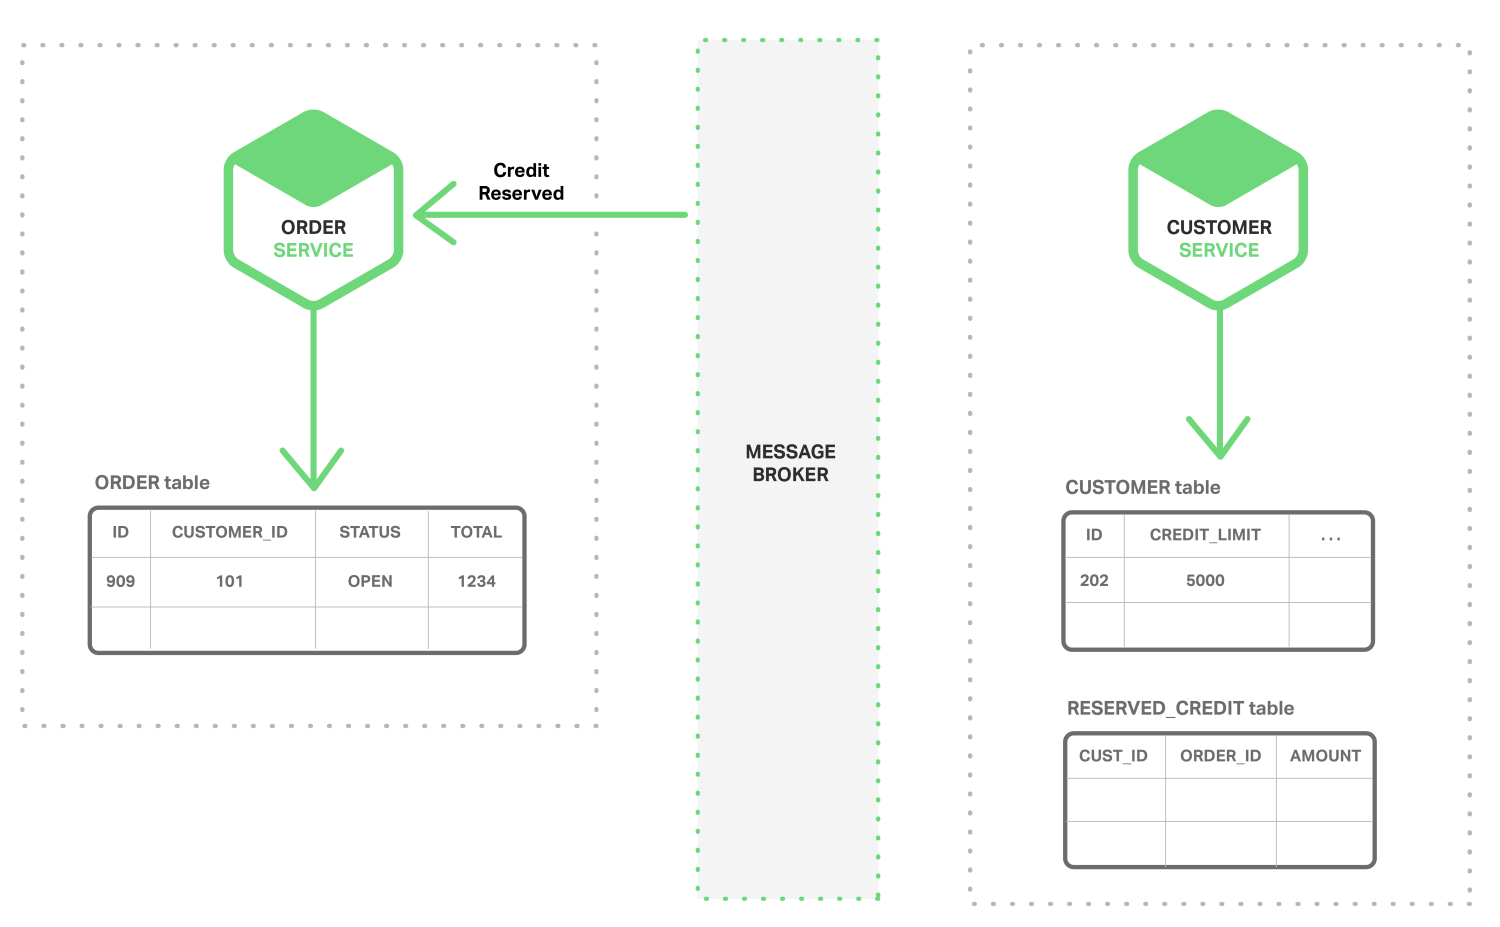
Mithilfe von Ereignissen können Sie Geschäftstransaktionen implementieren, die sich über mehrere Services erstrecken. Eine Transaktion besteht aus einer Reihe von Schritten. In jedem Schritt aktualisiert ein Microservice eine Geschäftsentität und veröffentlicht ein Ereignis, das den nächsten Schritt auslöst. Die folgende Abfolge von Diagrammen zeigt, wie Sie bei der Erstellung einer Bestellung mithilfe eines ereignisgesteuerten Ansatzes die Kreditverfügbarkeit prüfen können. Die Microservices tauschen Ereignisse über einen Message Broker aus.
- Der Order Service erstellt eine Bestellung mit dem Status NEW und veröffentlicht ein Order-Created-Ereignis.
- Der Customer Service verarbeitet das Ereignis „Order Created“, reserviert den Kreditrahmen für die Bestellung und veröffentlicht ein Ereignis vom Typ „Credit Reserved“.
- Der Bestellservice verarbeitet das Ereignis „Credit Reserved“ und ändert den Status der Bestellung in OPEN.
Ein komplexeres Szenario könnte zusätzliche Schritte umfassen, beispielsweise die Reservierung des Lagerbestands, während gleichzeitig die Bonität des Kunden geprüft wird.
Vorausgesetzt, dass (a) jeder Service die Datenbank atomar aktualisiert und ein Ereignis veröffentlicht – dazu später mehr – und (b) der Message Broker garantiert, dass Ereignisse mindestens einmal zugestellt werden, können Sie Geschäftstransaktionen implementieren, die sich über mehrere Services erstrecken. Dabei ist zu beachten, dass es sich nicht um ACID-Transaktionen handelt. Sie bieten wesentlich schwächere Garantien wie etwa Eventual Consistency. Dieses Transaktionsmodell wird als BASE-Modell bezeichnet.
Sie können Ereignisse auch verwenden, um materialisierte Sichten zu pflegen, in denen Daten aus mehreren Microservices vorab verknüpft werden. Der Dienst, der die Sicht pflegt, abonniert die relevanten Ereignisse und aktualisiert die Sicht. Beispielsweise abonniert der Customer Order View Updater Service, der eine Customer-Orders-Sicht pflegt, die vom Customer Service und Order Service veröffentlichten Ereignisse.
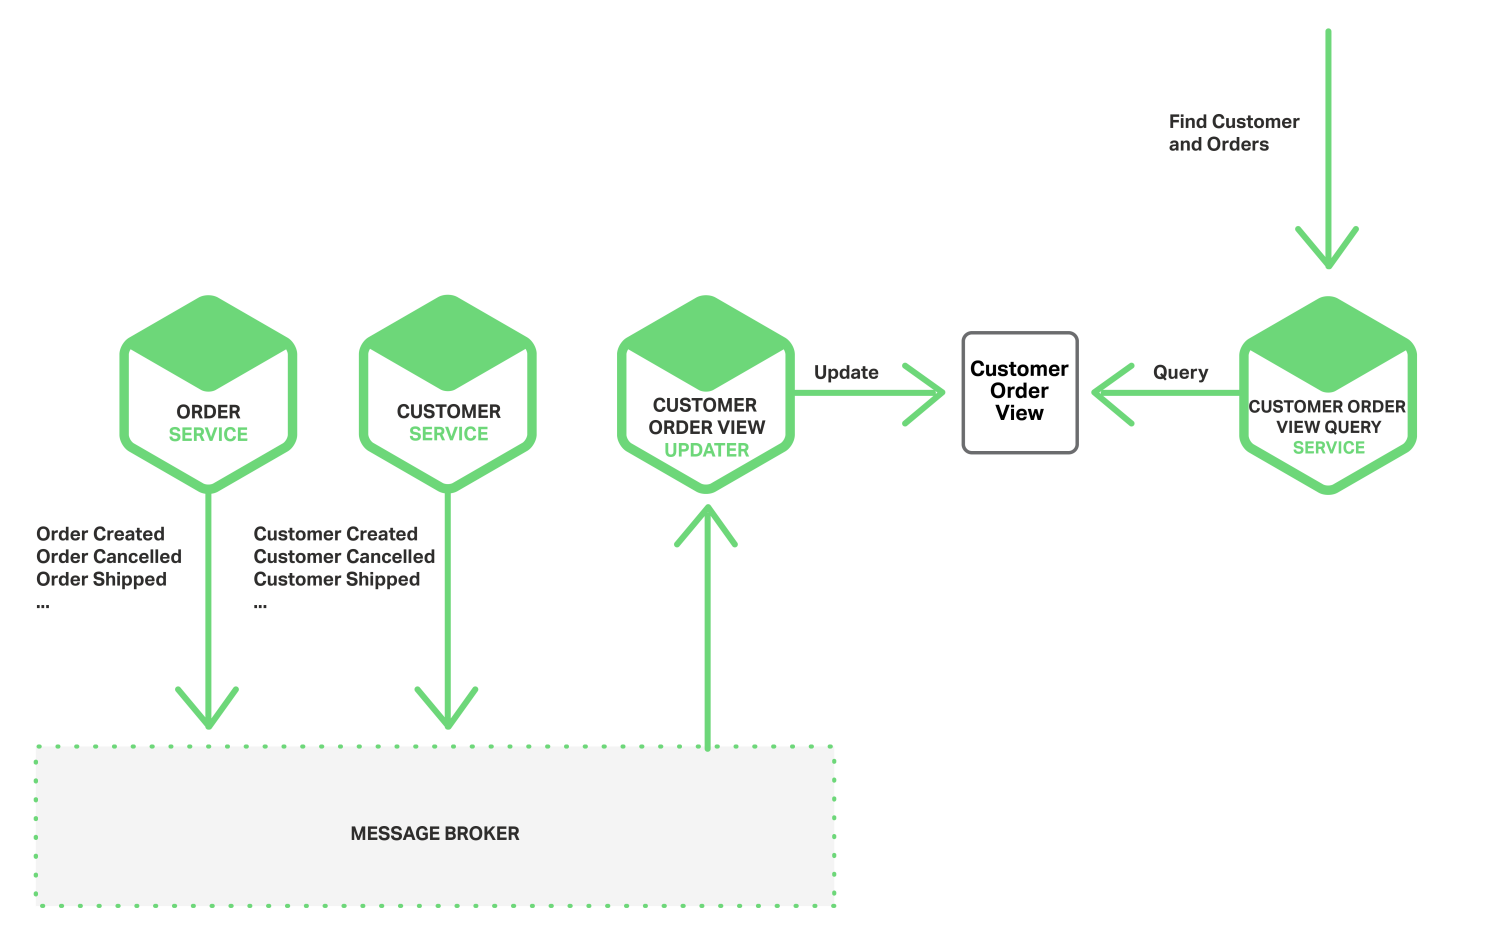
Wenn der Customer Order View Updater Service ein Customer- oder Order-Ereignis empfängt, aktualisiert er den Customer Order View-Datenspeicher. Sie könnten die Customer Order View mithilfe einer Dokumentendatenbank wie MongoDB implementieren und für jeden Kunden ein Dokument speichern. Der Customer Order View Query Service verarbeitet Anfragen nach einem Kunden und dessen letzten Bestellungen, indem er den Customer Order View-Datenspeicher abfragt.
Eine ereignisgesteuerte Architektur hat mehrere Vor- und Nachteile. Sie ermöglicht die Implementierung von Transaktionen, die sich über mehrere Services erstrecken und letztendliche Konsistenz gewährleisten. Ein weiterer Vorteil besteht darin, dass eine Anwendung damit auch materialisierte Sichten verwalten kann. Ein Nachteil ist, dass das Programmiermodell komplexer ist als bei der Verwendung von ACID-Transaktionen. Häufig müssen Sie kompensierende Transaktionen implementieren, um Fehler auf Anwendungsebene zu beheben. Beispielsweise müssen Sie eine Bestellung stornieren, wenn die Bonitätsprüfung fehlschlägt. Außerdem müssen Anwendungen mit inkonsistenten Daten umgehen. Der Grund dafür ist, dass Änderungen durch noch laufende Transaktionen sichtbar sind. Die Anwendung kann auch Inkonsistenzen feststellen, wenn sie aus einer materialisierten Sicht liest, die noch nicht aktualisiert wurde. Ein weiterer Nachteil besteht darin, dass Abonnenten doppelte Ereignisse erkennen und ignorieren müssen.
Atomarität erreichen
In einer ereignisgesteuerten Architektur besteht außerdem das Problem, die Datenbank atomar zu aktualisieren und gleichzeitig ein Ereignis zu veröffentlichen. Beispielsweise muss der Order Service eine Zeile in die Tabelle ORDER einfügen und ein Order-Created-Ereignis veröffentlichen. Es ist unerlässlich, dass diese beiden Vorgänge atomar ausgeführt werden. Wenn der Service nach der Aktualisierung der Datenbank, aber vor der Veröffentlichung des Ereignisses abstürzt, wird das System inkonsistent. Üblicherweise wird die Atomarität durch eine verteilte Transaktion gewährleistet, an der die Datenbank und der Message Broker beteiligt sind. Aus den oben genannten Gründen, etwa aufgrund des CAP-Theorems, ist dies jedoch genau das, was wir vermeiden möchten.
Veröffentlichen von Ereignissen mithilfe lokaler Transaktionen
Eine Möglichkeit, Atomarität zu erreichen, besteht darin, dass die Anwendung Ereignisse mithilfe eines mehrstufigen Prozesses, an dem ausschließlich lokale Transaktionen beteiligt sind veröffentlicht. Der entscheidende Punkt ist eine EVENT-Tabelle, die als Nachrichtenwarteschlange in der Datenbank fungiert, in der der Zustand der Geschäftsobjekte gespeichert ist. Die Anwendung startet eine (lokale) Datenbanktransaktion, aktualisiert den Zustand der Geschäftsobjekte, fügt ein Ereignis in die EVENT-Tabelle ein und schreibt die Transaktion fest. Ein separater Anwendungsthread oder -prozess fragt die EVENT-Tabelle ab, veröffentlicht die Ereignisse im Message Broker und markiert sie anschließend mithilfe einer lokalen Transaktion als veröffentlicht. Das folgende Diagramm veranschaulicht den Aufbau.
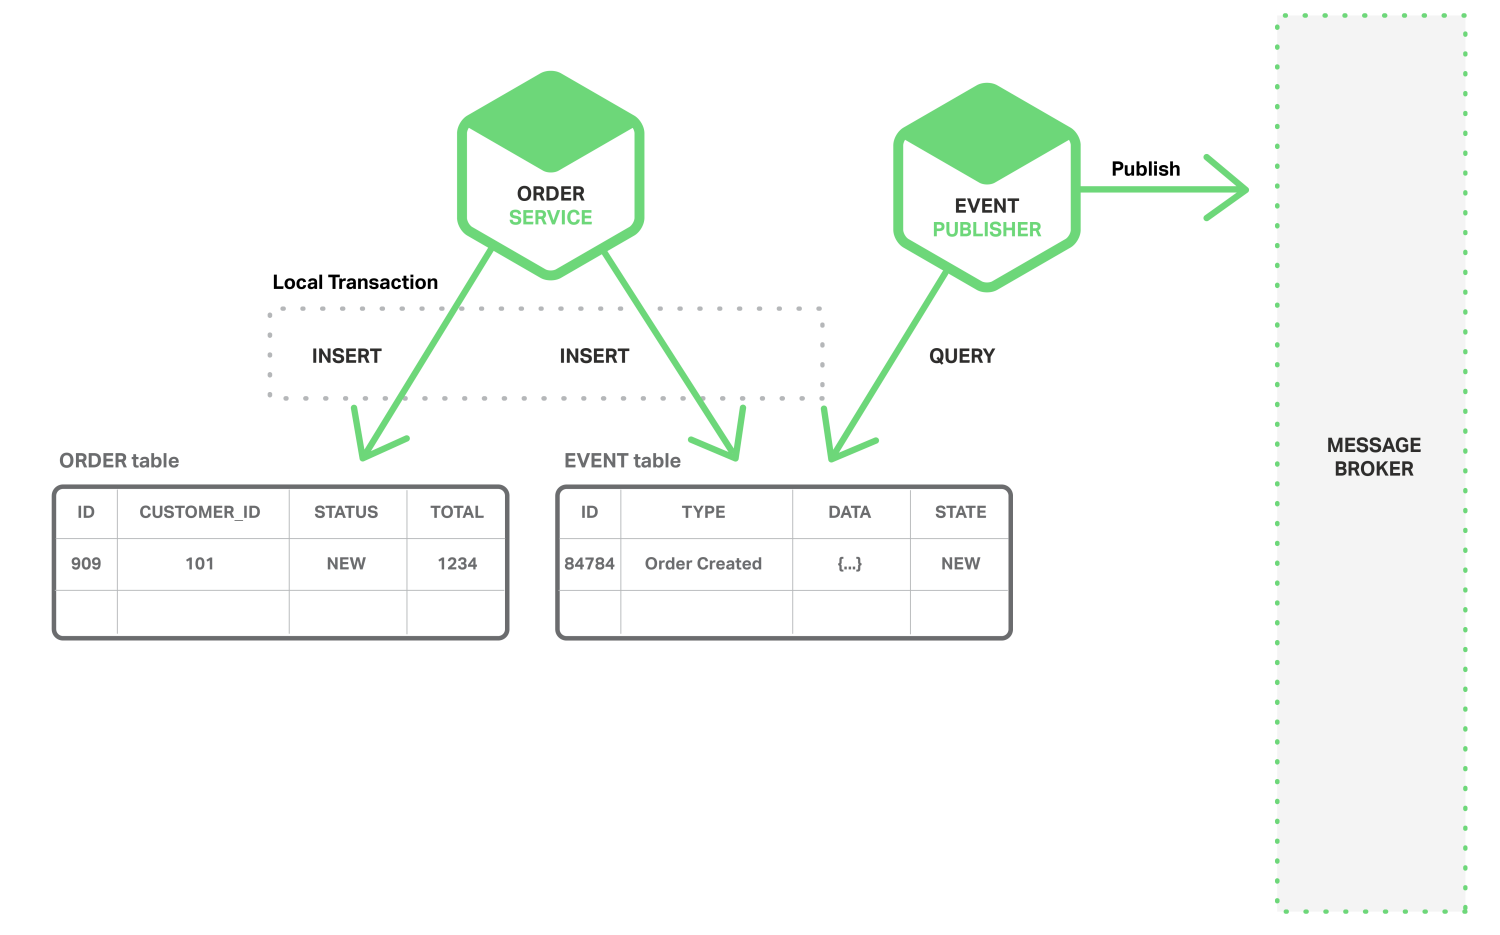
Der Order Service fügt eine Zeile in die Tabelle ORDER und ein Ereignis vom Typ „Order Created“ in die Tabelle EVENT ein. Der Event-Publisher-Thread bzw. -Prozess fragt die Tabelle EVENT nach unveröffentlichten Ereignissen ab, veröffentlicht diese und aktualisiert anschließend die Tabelle EVENT, um die Ereignisse als veröffentlicht zu kennzeichnen.
Dieser Ansatz hat mehrere Vor- und Nachteile. Ein Vorteil besteht darin, dass er gewährleistet, dass bei jeder Aktualisierung ein Ereignis veröffentlicht wird, ohne auf 2PC angewiesen zu sein. Außerdem veröffentlicht die Anwendung Ereignisse auf Geschäftsebene, sodass diese nicht abgeleitet werden müssen. Ein Nachteil dieses Ansatzes besteht darin, dass er potenziell fehleranfällig ist, da der Entwickler daran denken muss, Ereignisse zu veröffentlichen. Eine Einschränkung dieses Ansatzes besteht darin, dass er bei einigen NoSQL-Datenbanken aufgrund ihrer begrenzten Transaktions- und Abfragemöglichkeiten nur schwer umzusetzen ist.
Dieser Ansatz macht 2PC überflüssig, indem die Anwendung lokale Transaktionen verwendet, um den Zustand zu aktualisieren und Ereignisse zu veröffentlichen. Sehen wir uns nun einen Ansatz an, der Atomarität erreicht, indem die Anwendung lediglich den Zustand aktualisiert.
Auswertung eines Datenbank-Transaktionsprotokolls
Eine weitere Möglichkeit, Atomarität ohne 2PC zu erreichen, besteht darin, die Ereignisse von einem Thread oder Prozess veröffentlichen zu lassen, der das Transaktions- oder Commit-Protokoll der Datenbank auswertet. Die Anwendung aktualisiert die Datenbank, wodurch die Änderungen im Transaktionsprotokoll der Datenbank aufgezeichnet werden. Der Transaction-Log-Miner-Thread bzw. -Prozess liest das Transaktionsprotokoll und veröffentlicht Ereignisse im Message Broker. Das folgende Diagramm veranschaulicht diesen Aufbau.
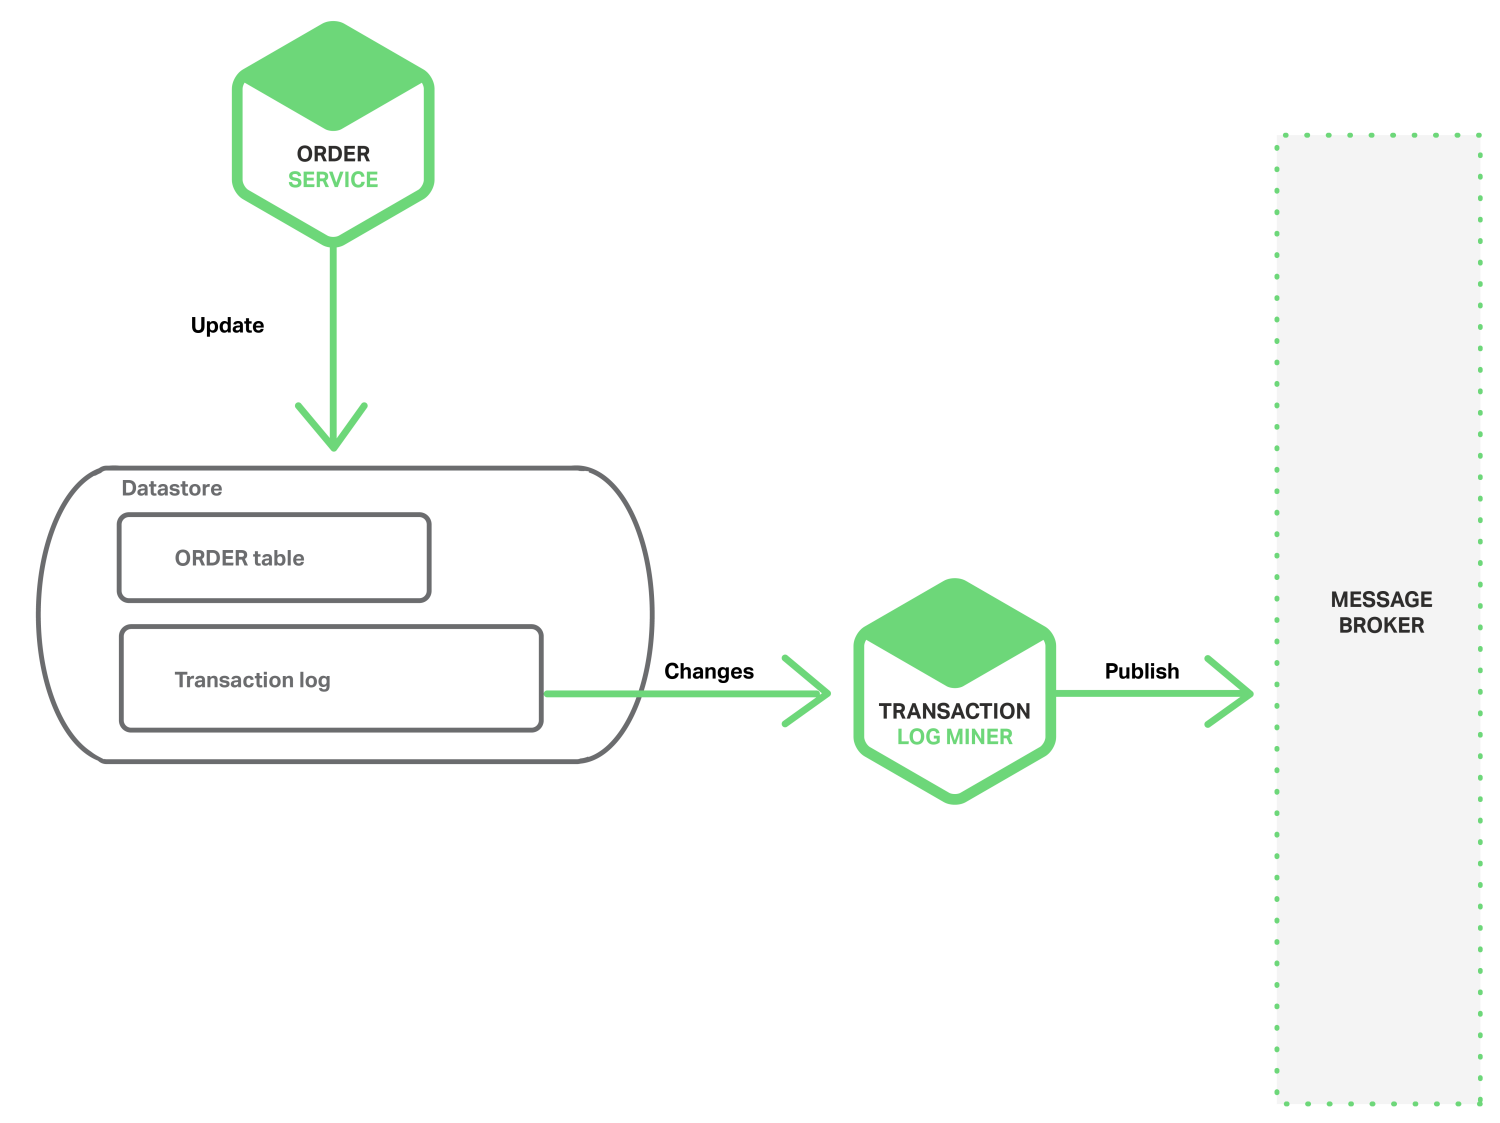
Ein Beispiel für diesen Ansatz ist das Open-Source-Projekt „LinkedIn Databus“. Databus wertet das Oracle-Transaktionsprotokoll aus und veröffentlicht Ereignisse, die den Änderungen entsprechen. LinkedIn verwendet Databus, um verschiedene abgeleitete Datenspeicher mit dem führenden System konsistent zu halten.
Ein weiteres Beispiel ist der Streams-Mechanismus in AWS DynamoDB, einer verwalteten NoSQL-Datenbank. Ein DynamoDB-Stream enthält die chronologisch geordnete Abfolge der Änderungen (Erstellungs-, Aktualisierungs- und Löschvorgänge), die in den letzten 24 Stunden an den Elementen einer DynamoDB-Tabelle vorgenommen wurden. Eine Anwendung kann diese Änderungen aus dem Stream auslesen und sie beispielsweise als Ereignisse veröffentlichen.
Das Auswerten von Transaktionsprotokollen hat verschiedene Vor- und Nachteile. Ein Vorteil besteht darin, dass dadurch garantiert wird, dass für jede Aktualisierung ein Ereignis veröffentlicht wird, ohne dass 2PC zum Einsatz kommt. Zudem kann das Auswerten von Transaktionsprotokollen die Anwendung vereinfachen, indem die Veröffentlichung von Ereignissen von der Geschäftslogik der Anwendung getrennt wird. Ein wesentlicher Nachteil besteht darin, dass das Format des Transaktionsprotokolls für jede Datenbank proprietär ist und sich sogar zwischen verschiedenen Datenbankversionen ändern kann. Außerdem kann es schwierig sein, aus den im Transaktionsprotokoll aufgezeichneten technischen Aktualisierungen die übergeordneten Geschäftsereignisse zu rekonstruieren.
Durch das Auslesen des Transaktionsprotokolls entfällt die Notwendigkeit für 2PC, da die Anwendung nur eine Aufgabe übernimmt: die Datenbank zu aktualisieren. Sehen wir uns nun einen anderen Ansatz an, der ohne Aktualisierungen auskommt und ausschließlich auf Ereignissen basiert.
Event Sourcing verwenden
Event Sourcing erreicht Atomarität ohne 2PC durch einen grundlegend anderen, ereigniszentrierten Ansatz zur Persistierung von Geschäftsobjekten. Anstatt den aktuellen Zustand eines Objekts zu speichern, speichert die Anwendung eine Abfolge zustandsändernder Ereignisse. Den aktuellen Zustand eines Objekts rekonstruiert die Anwendung, indem sie die Ereignisse erneut abspielt. Bei jeder Änderung des Zustands eines Geschäftsobjekts wird der Ereignisliste ein neues Ereignis hinzugefügt. Da das Speichern eines Ereignisses ein einzelner Vorgang ist, ist es von Natur aus atomar.
Um zu verstehen, wie Event Sourcing funktioniert, betrachten wir beispielhaft die Entität „Order“. Bei einem herkömmlichen Ansatz wird jede Bestellung einer Zeile in einer ORDER-Tabelle sowie beispielsweise mehreren Zeilen in einer ORDER_LINE_ITEM-Tabelle zugeordnet. Beim Event Sourcing hingegen speichert der Order Service eine Bestellung in Form ihrer zustandsändernden Ereignisse: Created, Approved, Shipped, Cancelled. Jedes Ereignis enthält genügend Daten, um den Zustand der Bestellung zu rekonstruieren.
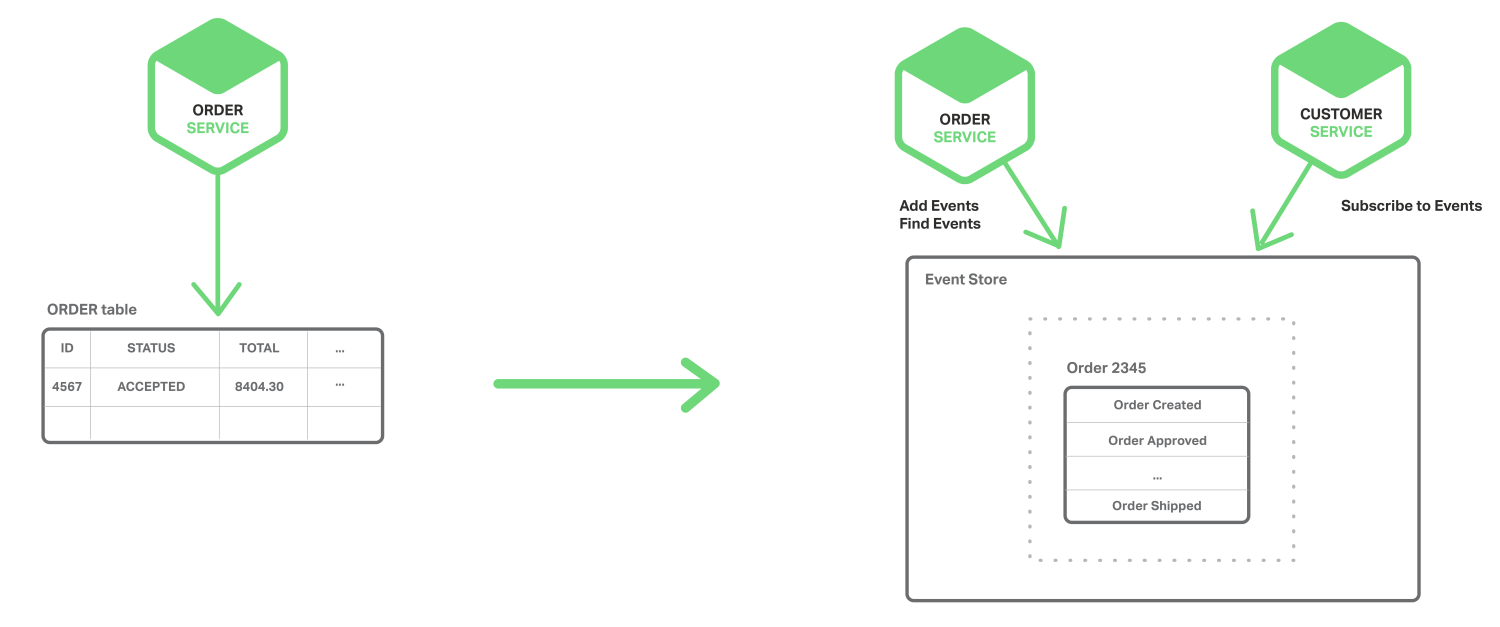
Ereignisse werden dauerhaft in einem Event Store gespeichert, einer Datenbank für Ereignisse. Der Store verfügt über eine API zum Hinzufügen und Abrufen der Ereignisse einer Entität. Der Event Store fungiert außerdem wie der Message Broker in den zuvor beschriebenen Architekturen. Er stellt eine API bereit, über die Services Ereignisse abonnieren können. Der Event Store übermittelt alle Ereignisse an alle interessierten Abonnenten. Er bildet das Rückgrat einer ereignisgesteuerten Microservices-Architektur.
Event Sourcing bietet mehrere Vorteile. Es löst eines der zentralen Probleme bei der Implementierung einer ereignisgesteuerten Architektur und ermöglicht es, bei jeder Zustandsänderung zuverlässig Ereignisse zu veröffentlichen. Dadurch werden Probleme mit der Datenkonsistenz in einer Microservices-Architektur gelöst. Da außerdem Ereignisse statt Domänenobjekten persistiert werden, wird das Problem der objektrelationalen Impedanzfehlanpassung weitgehend vermieden. Event Sourcing stellt zudem ein zu 100 % zuverlässiges Audit-Protokoll der an einer Geschäftsentität vorgenommenen Änderungen bereit und ermöglicht die Implementierung temporaler Abfragen, mit denen sich der Zustand einer Entität zu jedem beliebigen Zeitpunkt ermitteln lässt. Ein weiterer großer Vorteil von Event Sourcing besteht darin, dass die Geschäftslogik aus lose gekoppelten Geschäftsentitäten besteht, die Ereignisse austauschen. Dies erleichtert die Migration von einer monolithischen Anwendung zu einer Microservices-Architektur erheblich.
Event Sourcing hat auch einige Nachteile. Es handelt sich um einen anderen, ungewohnten Programmierstil, der eine gewisse Einarbeitung erfordert. Der Event Store unterstützt nur die direkte Suche nach Geschäftsobjekten anhand ihres Primärschlüssels. Für die Implementierung von Abfragen muss Command Query Responsibility Segregation (CQRS) verwendet werden. Daher müssen Anwendungen mit letztlich konsistenten Daten umgehen können.
Zusammenfassung
In einer Microservices-Architektur verfügt jeder Microservice über einen eigenen privaten Datenspeicher. Verschiedene Microservices können unterschiedliche SQL- und NoSQL-Datenbanken verwenden. Diese Datenbankarchitektur bietet zwar erhebliche Vorteile, bringt jedoch auch einige Herausforderungen bei der verteilten Datenverwaltung mit sich. Die erste Herausforderung besteht darin, Geschäftstransaktionen so zu implementieren, dass die Konsistenz über mehrere Services hinweg gewahrt bleibt. Die zweite Herausforderung besteht darin, Abfragen zu implementieren, die Daten aus mehreren Services abrufen.
Für viele Anwendungen besteht die Lösung darin, eine ereignisgesteuerte Architektur zu verwenden. Eine Herausforderung bei der Implementierung einer ereignisgesteuerten Architektur besteht darin, den Zustand atomar zu aktualisieren und Ereignisse zu veröffentlichen. Dafür gibt es mehrere Möglichkeiten, darunter die Verwendung der Datenbank als Nachrichtenwarteschlange, die Auswertung des Transaktionsprotokolls und Event Sourcing.
In zukünftigen Blogbeiträgen werden wir uns weiterhin eingehend mit weiteren Aspekten von Microservices befassen.
Redaktion – Diese siebenteilige Artikelserie ist nun abgeschlossen:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices (dieser Artikel)
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“. Lesen Sie auch unsere Artikelreihe zur Microservices-Referenzarchitektur und besuchen Sie die Seite Microservices-Lösungen.
Gastautor Chris Richardson ist der Gründer des ursprünglichen Angebots CloudFoundry.com, einer frühen Java-PaaS-Lösung (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Beiträge über Microservices auf http://microservices.io.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.