Die Anmeldung für Microservices March 2023 ist jetzt möglich. Hier finden Sie die Agenda und können sich anmelden.
Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices (dieser Artikel)
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Diensterkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“.
Sehen Sie sich auch unsere Lösungsseite zu Microservices an.
Microservices erhalten derzeit viel Aufmerksamkeit: in Artikeln, Blogs, Diskussionen in sozialen Medien und Konferenzvorträgen. Sie nähern sich rasch dem Gipfel der überzogenen Erwartungen im Gartner Hype Cycle. Gleichzeitig gibt es in der Software-Community Skeptiker, die Microservices als nichts Neues abtun. Kritiker behaupten, die Idee sei lediglich eine Umbenennung von SOA. Doch trotz des Hypes und der Skepsis bietet das Microservices-Architekturmuster erhebliche Vorteile – insbesondere, wenn es darum geht, die agile Entwicklung und Bereitstellung komplexer Unternehmensanwendungen zu ermöglichen.
Dieser Blogbeitrag ist der erste Teil einer siebenteiligen Reihe über den Entwurf, die Entwicklung und die Bereitstellung von Microservices. Sie erfahren mehr über diesen Ansatz und darüber, wie er sich im Vergleich zum traditionelleren monolithischen Architekturmuster darstellt. In dieser Reihe werden die verschiedenen Elemente einer Microservices-Architektur beschrieben. Sie erfahren, welche Vor- und Nachteile das Microservices-Architekturmuster bietet, ob es für Ihr Projekt sinnvoll ist und wie Sie es anwenden.
Sehen wir uns zunächst an, warum Sie den Einsatz von Microservices in Betracht ziehen sollten.
Monolithische Anwendungen entwickeln
Stellen wir uns vor, Sie würden mit der Entwicklung einer völlig neuen Taxi-App beginnen, die mit Uber und Hailo konkurrieren soll. Nach einigen ersten Besprechungen und der Erfassung der Anforderungen würden Sie entweder manuell oder mithilfe eines in Rails, Spring Boot, Play oder Maven enthaltenen Generators ein neues Projekt erstellen. Diese neue Anwendung hätte eine modulare hexagonale Architektur, wie in der folgenden Abbildung dargestellt:
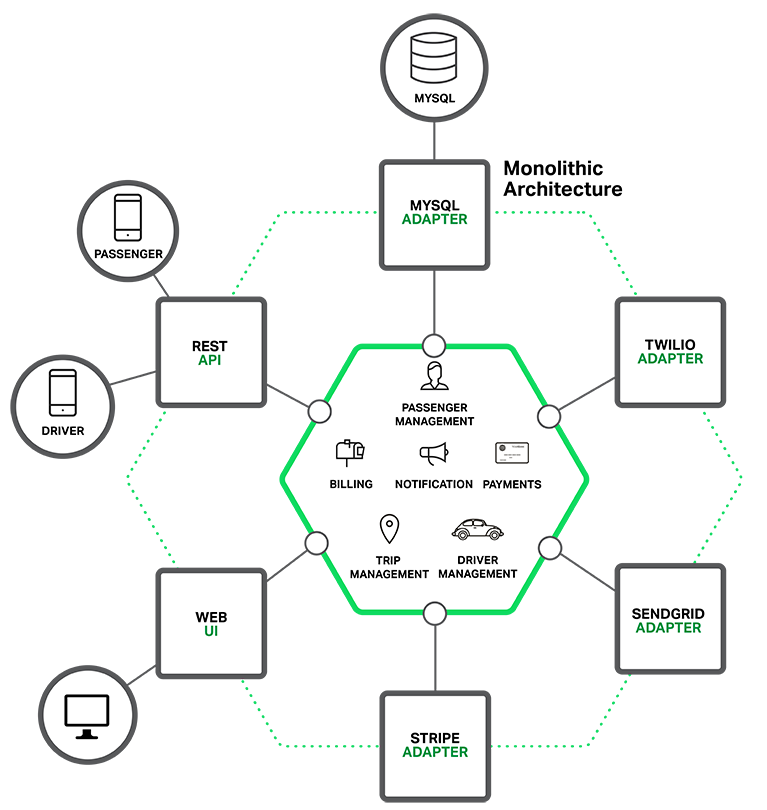
Im Kern der Anwendung befindet sich die Geschäftslogik, die durch Module implementiert wird, in denen Services, Domänenobjekte und Ereignisse definiert sind. Um diesen Kern herum befinden sich Adapter, die als Schnittstellen zur Außenwelt dienen. Beispiele hierfür sind Datenbankzugriffskomponenten, Messaging-Komponenten zum Erzeugen und Verarbeiten von Nachrichten sowie Webkomponenten, die entweder APIs bereitstellen oder eine Benutzeroberfläche implementieren.
Obwohl die Anwendung über eine logisch modulare Architektur verfügt, wird sie als Monolith paketiert und bereitgestellt. Das konkrete Format hängt von der Programmiersprache und dem Framework der Anwendung ab. Beispielsweise werden viele Java-Anwendungen als WAR-Dateien paketiert und auf Anwendungsservern wie Tomcat oder Jetty bereitgestellt. Andere Java-Anwendungen werden als eigenständige ausführbare JAR-Dateien paketiert. Rails- und Node.js-Anwendungen werden entsprechend als Verzeichnishierarchie paketiert.
Anwendungen, die nach diesem Muster entwickelt werden, sind äußerst verbreitet. Sie sind einfach zu entwickeln, da unsere IDEs und andere Tools auf die Erstellung einer einzelnen Anwendung ausgerichtet sind. Solche Anwendungen lassen sich auch einfach testen. End-to-End-Tests können durchgeführt werden, indem die Anwendung gestartet und die Benutzeroberfläche mit Selenium getestet wird. Monolithische Anwendungen lassen sich außerdem einfach bereitstellen. Dazu muss lediglich die paketierte Anwendung auf einen Server kopiert werden. Die Anwendung kann auch skaliert werden, indem mehrere Instanzen hinter einem Load Balancer ausgeführt werden. In der Anfangsphase des Projekts funktioniert dieser Ansatz gut.
Auf dem Weg in die monolithische Hölle
Leider hat dieser einfache Ansatz eine gravierende Einschränkung. Erfolgreiche Anwendungen neigen dazu, mit der Zeit zu wachsen und schließlich riesig zu werden. In jedem Sprint setzt Ihr Entwicklungsteam einige weitere User Storys um, was natürlich bedeutet, dass viele Codezeilen hinzukommen. Nach einigen Jahren wird sich Ihre kleine, einfache Anwendung zu einem monströsen Monolithen entwickelt haben. Ein extremes Beispiel: Kürzlich sprach ich mit einem Entwickler, der ein Tool zur Analyse der Abhängigkeiten zwischen den Tausenden von JARs in einer Anwendung mit mehreren Millionen Codezeilen (LOC) entwickelte. Ich bin sicher, dass es über viele Jahre hinweg der gemeinsamen Anstrengungen zahlreicher Entwickler bedurfte, um ein solches Ungetüm zu erschaffen.
Sobald Ihre Anwendung zu einem großen, komplexen Monolithen geworden ist, befindet sich Ihre Entwicklungsorganisation wahrscheinlich in einer äußerst schwierigen Lage. Sämtliche Versuche einer agilen Entwicklung und Bereitstellung werden scheitern. Ein wesentliches Problem besteht darin, dass die Anwendung eine überwältigende Komplexität aufweist. Sie ist schlicht zu groß, als dass ein einzelner Entwickler sie vollständig verstehen könnte. Dadurch wird es schwierig und zeitaufwendig, Fehler zu beheben und neue Funktionen korrekt zu implementieren. Hinzu kommt, dass dies meist eine Abwärtsspirale in Gang setzt. Wenn die Codebasis schwer verständlich ist, werden Änderungen nicht korrekt vorgenommen. Am Ende entsteht ein monströser, undurchdringlicher Big Ball of Mud.
Allein die schiere Größe der Anwendung verlangsamt auch die Entwicklung. Je größer die Anwendung ist, desto länger dauert der Start. In einer kürzlich durchgeführten Umfrage berichteten einige Entwickler beispielsweise von Startzeiten von bis zu 12 Minuten. Ich habe auch von Fällen gehört, in denen Anwendungen bis zu 40 Minuten zum Starten benötigten. Wenn Entwickler den Anwendungsserver regelmäßig neu starten müssen, verbringen sie einen großen Teil ihres Arbeitstages mit Warten, und ihre Produktivität leidet darunter.
Ein weiteres Problem einer großen, komplexen monolithischen Anwendung besteht darin, dass sie Continuous Deployment behindert. Bei SaaS-Anwendungen gilt es heute als Stand der Technik, Änderungen mehrmals täglich in die Produktionsumgebung zu überführen. Bei einem komplexen Monolithen ist dies äußerst schwierig, da die gesamte Anwendung erneut bereitgestellt werden muss, um auch nur einen Teil davon zu aktualisieren. Die bereits erwähnten langen Startzeiten sind dabei ebenfalls nicht hilfreich. Da die Auswirkungen einer Änderung in der Regel nur unzureichend bekannt sind, sind zudem wahrscheinlich umfangreiche manuelle Tests erforderlich. Continuous Deployment ist daher nahezu unmöglich.
Monolithische Anwendungen lassen sich unter Umständen auch nur schwer skalieren, wenn verschiedene Module widersprüchliche Ressourcenanforderungen haben. Beispielsweise könnte ein Modul eine CPU-intensive Bildverarbeitungslogik implementieren und idealerweise auf Amazon EC2 Compute Optimized-Instanzen bereitgestellt werden. Ein anderes Modul könnte eine In-Memory-Datenbank sein und sich am besten für EC2 Memory Optimized-Instanzen eignen. Da diese Module jedoch gemeinsam bereitgestellt werden, müssen Sie bei der Wahl der Hardware Kompromisse eingehen.
Ein weiteres Problem monolithischer Anwendungen ist ihre Zuverlässigkeit. Da alle Module innerhalb desselben Prozesses ausgeführt werden, kann ein Fehler in einem beliebigen Modul, beispielsweise ein Speicherleck, potenziell den gesamten Prozess zum Absturz bringen. Da zudem alle Instanzen der Anwendung identisch sind, beeinträchtigt dieser Fehler die Verfügbarkeit der gesamten Anwendung.
Nicht zuletzt erschweren monolithische Anwendungen die Einführung neuer Frameworks und Programmiersprachen erheblich. Stellen Sie sich beispielsweise vor, Sie hätten zwei Millionen Codezeilen, die mit dem XYZ-Framework geschrieben wurden. Es wäre sowohl zeitlich als auch finanziell äußerst aufwendig, die gesamte Anwendung neu zu schreiben, um das neuere ABC-Framework zu verwenden – selbst wenn dieses Framework deutlich besser wäre. Dadurch entsteht eine hohe Hürde für die Einführung neuer Technologien. Sie sind an die Technologieentscheidungen gebunden, die Sie zu Beginn des Projekts getroffen haben.
Zusammenfassend lässt sich sagen: Sie haben eine erfolgreiche, geschäftskritische Anwendung, die zu einem monströsen Monolithen herangewachsen ist, den nur sehr wenige Entwickler – wenn überhaupt – verstehen. Sie basiert auf veralteter, unproduktiver Technologie, was die Einstellung talentierter Entwickler erschwert. Die Anwendung lässt sich nur schwer skalieren und ist unzuverlässig. Daher sind eine agile Entwicklung und Bereitstellung von Anwendungen unmöglich.
Was können Sie also dagegen tun?
Microservices – Komplexität bewältigen
Viele Unternehmen wie Amazon, eBay und Netflix haben dieses Problem gelöst, indem sie das heute als Microservices-Architekturmuster bekannte Konzept übernommen haben. Statt eine einzige riesige, monolithische Anwendung zu entwickeln, besteht die Idee darin, die Anwendung in mehrere kleinere, miteinander verbundene Dienste aufzuteilen.
Ein Service implementiert in der Regel eine Reihe klar abgegrenzter Funktionen, beispielsweise die Auftrags- oder Kundenverwaltung. Jeder Microservice ist eine Mini-Anwendung mit einer eigenen hexagonalen Architektur, die aus Geschäftslogik und verschiedenen Adaptern besteht. Einige Microservices stellen eine API bereit, die von anderen Microservices oder den Clients der Anwendung genutzt wird. Andere Microservices implementieren möglicherweise eine Weboberfläche. Zur Laufzeit wird jede Instanz häufig als Cloud-VM oder Docker-Container ausgeführt.
Das folgende Diagramm zeigt beispielsweise eine mögliche Zerlegung des zuvor beschriebenen Systems:
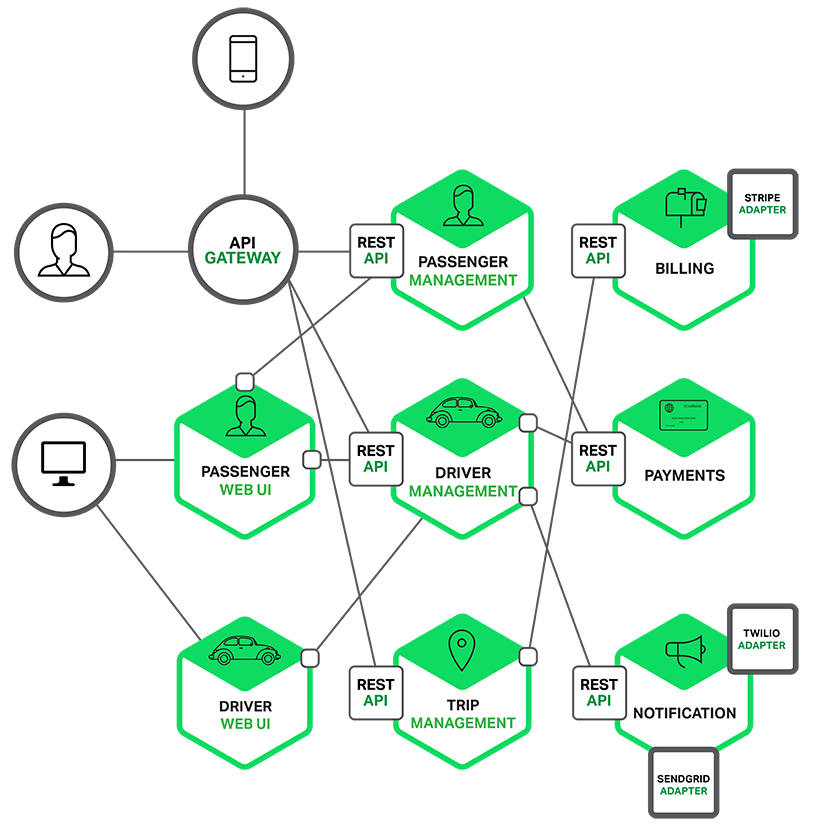
Jeder Funktionsbereich der Anwendung wird nun durch einen eigenen Microservice implementiert. Darüber hinaus ist die Webanwendung in mehrere einfachere Webanwendungen unterteilt (in unserem Beispiel einer Taxi-App etwa eine für Fahrgäste und eine für Fahrer). Dadurch lassen sich leichter maßgeschneiderte Benutzererlebnisse für bestimmte Benutzer, Geräte oder spezielle Anwendungsfälle bereitstellen.
Jeder Backend-Dienst stellt eine REST-API bereit, und die meisten Dienste nutzen APIs, die von anderen Diensten bereitgestellt werden. Beispielsweise verwendet die Fahrerverwaltung den Benachrichtigungsserver, um einen verfügbaren Fahrer über eine mögliche Fahrt zu informieren. Die UI-Dienste rufen die anderen Dienste auf, um Webseiten darzustellen. Dienste können auch asynchron und nachrichtenbasiert miteinander kommunizieren. Die Kommunikation zwischen Diensten wird später in dieser Reihe ausführlicher behandelt.
Einige REST-APIs werden auch für die von Fahrern und Fahrgästen verwendeten mobilen Apps bereitgestellt. Die Apps haben jedoch keinen direkten Zugriff auf die Backend-Dienste. Stattdessen erfolgt die Kommunikation über eine zwischengeschaltete Komponente, die als API-Gateway bezeichnet wird. Das API-Gateway übernimmt Aufgaben wie Lastverteilung, Caching, Zugriffskontrolle, API-Nutzungsmessung und Überwachung und lässt sich effizient mit NGINX implementieren. In späteren Artikeln dieser Reihe wird das API-Gateway näher behandelt.
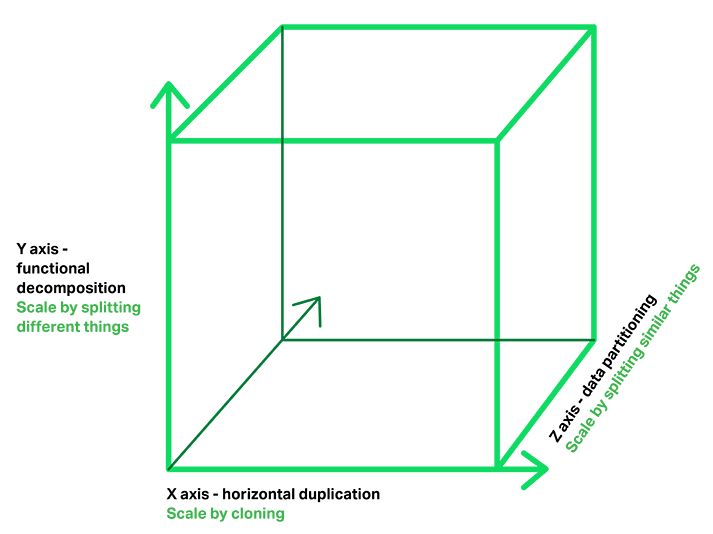
Das Architekturmuster „Microservices“ entspricht der Skalierung entlang der Y-Achse des Scale Cube, eines 3D-Modells für Skalierbarkeit aus dem hervorragenden Buch The Art of Scalability. Die beiden anderen Skalierungsachsen sind die Skalierung entlang der X-Achse, bei der mehrere identische Instanzen der Anwendung hinter einem Load Balancer ausgeführt werden, und die Skalierung entlang der Z-Achse (auch Datenpartitionierung genannt), bei der ein Attribut der Anfrage (zum Beispiel der Primärschlüssel einer Zeile oder die Identität eines Kunden) verwendet wird, um die Anfrage an einen bestimmten Server weiterzuleiten.
Anwendungen nutzen in der Regel alle drei Skalierungsarten gemeinsam. Bei der Skalierung entlang der Y-Achse wird die Anwendung in Microservices zerlegt, wie oben in der ersten Abbildung dieses Abschnitts dargestellt. Zur Laufzeit werden bei der Skalierung entlang der X-Achse mehrere Instanzen jedes Dienstes hinter einem Load Balancer ausgeführt, um Durchsatz und Verfügbarkeit zu gewährleisten. Einige Anwendungen nutzen möglicherweise zusätzlich die Skalierung entlang der Z-Achse, um die Dienste zu partitionieren. Das folgende Diagramm zeigt, wie der Trip-Management-Dienst mit Docker auf Amazon EC2 bereitgestellt werden könnte.
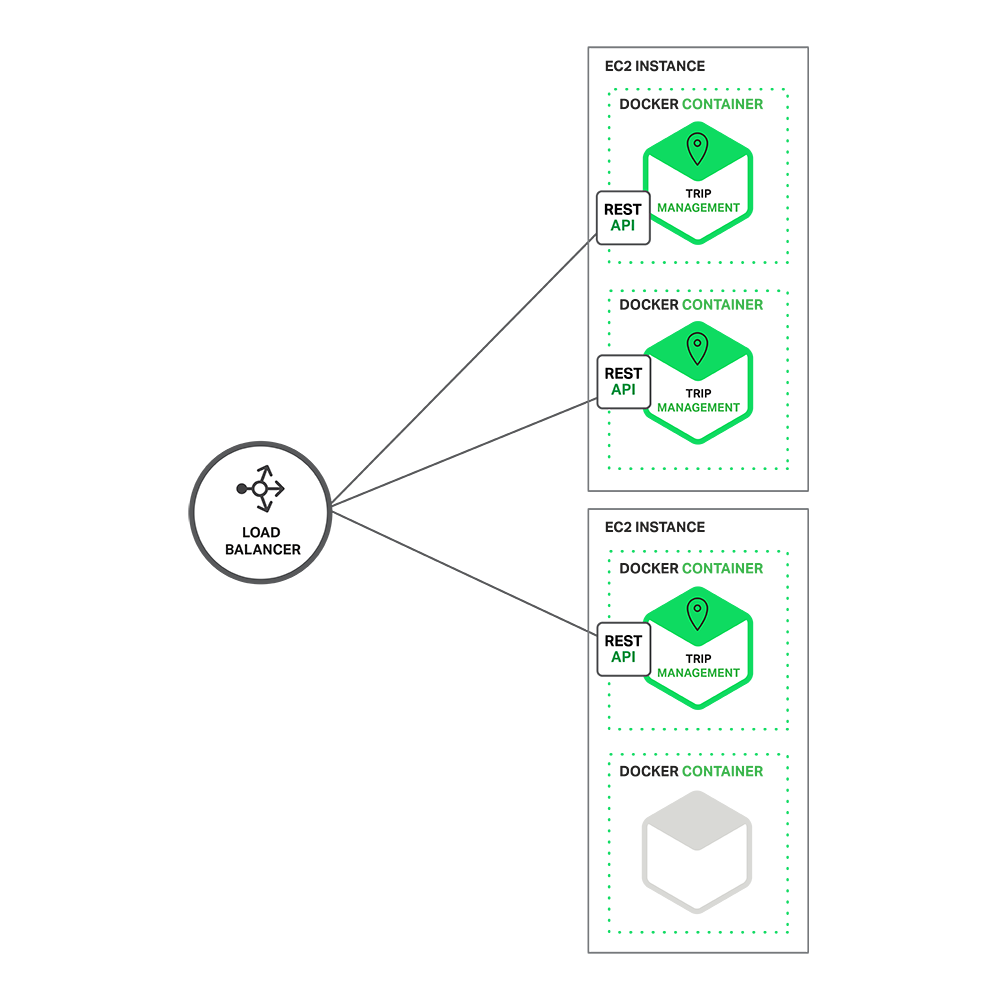
Zur Laufzeit besteht der Trip-Management-Dienst aus mehreren Dienstinstanzen. Jede Dienstinstanz ist ein Docker-Container. Um eine hohe Verfügbarkeit zu gewährleisten, werden die Container auf mehreren Cloud-VMs ausgeführt. Den Dienstinstanzen ist ein Load-Balancer wie NGINX vorgeschaltet, der die Anfragen auf die Instanzen verteilt. Der Load-Balancer kann auch weitere Aufgaben übernehmen, beispielsweise Caching, Zugriffskontrolle, API-Nutzungsmessung, und Monitoring.
Das Architekturmuster der Microservices hat erhebliche Auswirkungen auf die Beziehung zwischen Anwendung und Datenbank. Anstatt ein gemeinsames Datenbankschema mit anderen Services zu nutzen, verfügt jeder Service über ein eigenes Datenbankschema. Einerseits steht dieser Ansatz im Widerspruch zur Idee eines unternehmensweiten Datenmodells. Zudem führt er häufig dazu, dass bestimmte Daten mehrfach vorgehalten werden. Ein eigenes Datenbankschema pro Service ist jedoch unerlässlich, wenn Sie die Vorteile von Microservices nutzen möchten, da es eine lose Kopplung gewährleistet. Das folgende Diagramm zeigt die Datenbankarchitektur der Beispielanwendung.
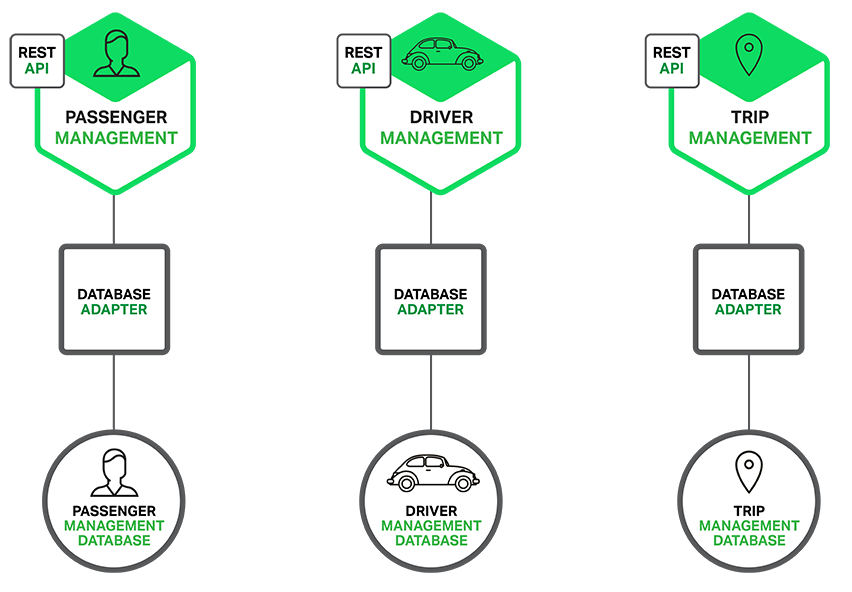
Jeder der Dienste verfügt über eine eigene Datenbank. Darüber hinaus kann ein Dienst den Datenbanktyp verwenden, der für seine Anforderungen am besten geeignet ist – die sogenannte polyglotte Persistenzarchitektur. Beispielsweise muss die Fahrerverwaltung, die Fahrer in der Nähe eines potenziellen Fahrgasts ermittelt, eine Datenbank verwenden, die effiziente geografische Abfragen unterstützt.
Oberflächlich betrachtet ähnelt das Microservices-Architekturmuster der SOA. Bei beiden Ansätzen besteht die Architektur aus einer Reihe von Services. Das Microservices-Architekturmuster lässt sich jedoch auch als SOA ohne die Kommerzialisierung und den vermeintlichen Ballast von Webservice-Spezifikationen (WS‑*) und einem Enterprise Service Bus (ESB) verstehen. Auf Microservices basierende Anwendungen bevorzugen einfachere, leichtgewichtige Protokolle wie REST gegenüber WS‑*. Außerdem vermeiden sie weitgehend den Einsatz von ESBs und implementieren ESB-ähnliche Funktionen stattdessen direkt in den Microservices. Das Microservices-Architekturmuster lehnt auch andere Bestandteile der SOA ab, etwa das Konzept eines kanonischen Schemas.
Die Vorteile von Microservices
Das Microservices-Architekturmuster bietet eine Reihe wichtiger Vorteile. Erstens löst es das Problem der Komplexität. Es zerlegt eine ansonsten riesige monolithische Anwendung in mehrere Dienste. Der Gesamtumfang der Funktionalität bleibt dabei unverändert, doch die Anwendung wird in überschaubare Einheiten beziehungsweise Dienste aufgeteilt. Jeder Dienst verfügt über eine klar definierte Schnittstelle in Form einer RPC- oder nachrichtenbasierten API. Das Microservices-Architekturmuster sorgt für einen Grad an Modularität, der mit einer monolithischen Codebasis in der Praxis nur äußerst schwer zu erreichen ist. Dadurch lassen sich einzelne Dienste wesentlich schneller entwickeln und sind deutlich leichter zu verstehen und zu warten.
Zweitens ermöglicht diese Architektur, dass jeder Dienst unabhängig von einem Team entwickelt wird, das sich auf diesen Dienst konzentriert. Die Entwickler können frei entscheiden, welche Technologien sinnvoll sind, sofern der Dienst den API-Vertrag einhält. Natürlich möchten die meisten Unternehmen völlige Anarchie vermeiden und die Technologieauswahl einschränken. Diese Freiheit bedeutet jedoch, dass die Entwickler nicht länger verpflichtet sind, die möglicherweise veralteten Technologien zu verwenden, die zu Beginn eines neuen Projekts vorhanden waren. Bei der Entwicklung eines neuen Dienstes können sie aktuelle Technologien einsetzen. Da Dienste zudem relativ klein sind, ist es durchaus praktikabel, einen alten Dienst mithilfe aktueller Technologien neu zu schreiben.
Drittens ermöglicht das Architekturmuster der Microservices, jeden Microservice unabhängig bereitzustellen. Entwickler müssen die Bereitstellung von Änderungen, die nur ihren eigenen Service betreffen, nicht koordinieren. Solche Änderungen können bereitgestellt werden, sobald sie getestet wurden. Das UI-Team kann beispielsweise A/B-Tests durchführen und UI-Änderungen schnell iterativ weiterentwickeln. Das Architekturmuster der Microservices ermöglicht Continuous Deployment.
Schließlich ermöglicht das Microservices-Architekturmuster, jeden Service unabhängig zu skalieren. Sie können für jeden Service genau so viele Instanzen bereitstellen, wie zur Erfüllung seiner Kapazitäts- und Verfügbarkeitsanforderungen erforderlich sind. Darüber hinaus können Sie die Hardware verwenden, die den Ressourcenanforderungen eines Service am besten entspricht. Beispielsweise können Sie einen CPU-intensiven Bildverarbeitungsservice auf EC2 Compute Optimized-Instanzen und einen In-Memory-Datenbankservice auf EC2 Memory Optimized-Instanzen bereitstellen.
Die Nachteile von Microservices
Wie Fred Brooks vor fast 30 Jahren schrieb, gibt es keine Patentlösungen. Wie jede andere Technologie hat auch die Microservices-Architektur Nachteile. Ein Nachteil ist bereits die Bezeichnung selbst. Der Begriff Microservice legt übermäßig viel Gewicht auf die Größe eines Dienstes. Tatsächlich plädieren einige Entwickler dafür, extrem feingranulare Dienste mit 10–100 Codezeilen zu entwickeln. Kleine Dienste sind zwar vorzuziehen, doch sollte man nicht vergessen, dass sie nur Mittel zum Zweck und nicht das eigentliche Ziel sind. Das Ziel von Microservices besteht darin, die Anwendung so weit zu zerlegen, dass eine agile Anwendungsentwicklung und -bereitstellung ermöglicht wird.
Ein weiterer großer Nachteil von Microservices ist die Komplexität, die sich daraus ergibt, dass eine Microservices-Anwendung ein verteiltes System ist. Entwickler müssen einen Mechanismus für die Interprozesskommunikation auswählen und implementieren, der entweder auf Messaging oder RPC basiert. Darüber hinaus müssen sie Code zur Behandlung von Teilausfällen schreiben, da das Ziel einer Anfrage möglicherweise langsam oder nicht verfügbar ist. All das ist zwar keine Raketenwissenschaft, aber wesentlich komplexer als bei einer monolithischen Anwendung, in der Module einander über Methoden- bzw. Prozeduraufrufe auf Sprachebene aufrufen.
Eine weitere Herausforderung bei Microservices ist die partitionierte Datenbankarchitektur. Geschäftstransaktionen, die mehrere Geschäftsobjekte aktualisieren, sind durchaus üblich. In einer monolithischen Anwendung lassen sich solche Transaktionen problemlos implementieren, da es nur eine einzige Datenbank gibt. In einer auf Microservices basierenden Anwendung müssen hingegen mehrere Datenbanken aktualisiert werden, die zu unterschiedlichen Services gehören. Der Einsatz verteilter Transaktionen kommt in der Regel nicht infrage, und das nicht nur aufgrund des CAP-Theorems. Viele der heutigen hochskalierbaren NoSQL-Datenbanken und Message Broker unterstützen sie schlichtweg nicht. Daher muss letztlich ein auf Eventual Consistency basierender Ansatz verwendet werden, der für Entwickler anspruchsvoller ist.
Auch das Testen einer Microservices-Anwendung ist wesentlich komplexer. Mit einem modernen Framework wie Spring Boot lässt sich beispielsweise problemlos eine Testklasse schreiben, die eine monolithische Webanwendung startet und deren REST-API testet. Eine vergleichbare Testklasse für einen Service müsste hingegen diesen Service sowie alle Services starten, von denen er abhängig ist (oder zumindest Stubs für diese Services konfigurieren). Auch das ist kein Hexenwerk, doch der damit verbundene Aufwand sollte nicht unterschätzt werden.
Eine weitere große Herausforderung beim Microservices-Architekturmuster besteht darin, Änderungen umzusetzen, die mehrere Services betreffen. Stellen wir uns beispielsweise vor, Sie implementieren eine User Story, die Änderungen an den Services A, B und C erfordert, wobei A von B und B von C abhängt. In einer monolithischen Anwendung könnten Sie einfach die entsprechenden Module ändern, die Änderungen integrieren und alles in einem Schritt bereitstellen. Bei einem Microservices-Architekturmuster hingegen müssen Sie die Einführung der Änderungen an den einzelnen Services sorgfältig planen und koordinieren. Beispielsweise müssten Sie zunächst Service C, anschließend Service B und schließlich Service A aktualisieren. Glücklicherweise betreffen die meisten Änderungen in der Regel nur einen Service, und Änderungen an mehreren Services, die eine Koordination erfordern, sind relativ selten.
Auch die Bereitstellung einer auf Microservices basierenden Anwendung ist wesentlich komplexer. Eine monolithische Anwendung wird einfach auf einer Reihe identischer Server hinter einem herkömmlichen Load Balancer bereitgestellt. Jede Anwendungsinstanz wird mit den Adressen (Hosts und Ports) von Infrastrukturdiensten wie der Datenbank und einem Message Broker konfiguriert. Im Gegensatz dazu besteht eine Microservices-Anwendung in der Regel aus einer großen Anzahl von Diensten. Hailo verfügt beispielsweise über 160 verschiedene Dienste und Netflix laut Adrian Cockcroft über [Anmerkung der Redaktion – Hailo wurde von MyTaxi übernommen.]600. Jeder Dienst verfügt über mehrere Laufzeitinstanzen. Dadurch gibt es wesentlich mehr bewegliche Teile, die konfiguriert, bereitgestellt, skaliert und überwacht werden müssen. Darüber hinaus muss ein Mechanismus zur Diensterkennung implementiert werden (der in einem späteren Beitrag behandelt wird), mit dem ein Dienst die Adressen (Hosts und Ports) aller anderen Dienste ermitteln kann, mit denen er kommunizieren muss. Herkömmliche, auf Supporttickets basierende und manuelle Betriebsansätze lassen sich nicht auf dieses Maß an Komplexität skalieren. Die erfolgreiche Bereitstellung einer Microservices-Anwendung erfordert daher eine stärkere Kontrolle der Bereitstellungsmethoden durch die Entwickler sowie einen hohen Automatisierungsgrad.
Ein Ansatz zur Automatisierung besteht darin, eine gebrauchsfertige PaaS wie Cloud Foundry zu verwenden. Eine PaaS bietet Entwicklern eine einfache Möglichkeit, ihre Microservices bereitzustellen und zu verwalten. Sie nimmt ihnen Aufgaben wie die Beschaffung und Konfiguration von IT-Ressourcen ab. Gleichzeitig können die System- und Netzwerkspezialisten, die die PaaS konfigurieren, die Einhaltung von Best Practices und Unternehmensrichtlinien sicherstellen. Eine weitere Möglichkeit, die Bereitstellung von Microservices zu automatisieren, besteht darin, im Wesentlichen eine eigene PaaS zu entwickeln. Ein typischer Ausgangspunkt ist die Verwendung einer Cluster-Lösung wie Kubernetes in Verbindung mit einer Technologie wie Docker. Im weiteren Verlauf dieser Reihe werden wir untersuchen, wie softwarebasierte Anwendungsbereitstellung mit Lösungen wie NGINX Plus, das Caching, Zugriffskontrolle, API-Nutzungsmessung und Überwachung auf Microservice-Ebene problemlos übernimmt, zur Lösung dieses Problems beitragen kann.
Zusammenfassung
Die Entwicklung komplexer Anwendungen ist von Natur aus schwierig. Eine monolithische Architektur ist nur für einfache, schlanke Anwendungen sinnvoll. Wenn Sie sie für komplexe Anwendungen einsetzen, werden Sie mit erheblichen Problemen konfrontiert. Trotz ihrer Nachteile und der Herausforderungen bei der Implementierung ist eine Microservices-Architektur die bessere Wahl für komplexe Anwendungen, die kontinuierlich weiterentwickelt werden.
In späteren Blogbeiträgen werde ich verschiedene Aspekte des Microservices-Architekturmusters näher beleuchten und Themen wie Service Discovery, Optionen für die Bereitstellung von Services sowie Strategien zur Umstrukturierung einer monolithischen Anwendung in einzelne Services behandeln.
Bleiben Sie dran …
Redaktion – Diese siebenteilige Artikelserie ist nun abgeschlossen:
- Einführung in Microservices (dieser Artikel)
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen zu Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“.
Gastautor Chris Richardson ist der Gründer des ursprünglichen CloudFoundry.com, einer frühen Java-PaaS (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.