Dieser Blogbeitrag beschreibt, wie Volterra Benutzer dabei unterstützt, ihre Anwendungen und Infrastruktur wie eine Flotte zu betreiben. Wir erläutern, wie unser auf der Steuerungsebene basierender Ansatz den Betrieb einer großen Flotte von Anwendungsclustern vereinfacht, und vergleichen ihn mit anderen Ansätzen für die Verwaltung mehrerer Cluster, etwa Google Anthos, Azure Arc, Rancher usw.
Inzwischen fragen Sie sich vielleicht, ob wir hier lediglich einen Marketingbegriff verwenden und unser Multi-Cluster-Management als Flottenbetrieb bezeichnen! Multi-Cluster-Management und Flottenbetrieb sind auf unterschiedliche Anwendungsfälle ausgerichtet und unterscheiden sich grundlegend in ihrer Architektur. Ein Multi-Cluster-Ansatz ist für Szenarien konzipiert, in denen es relativ wenige Cluster gibt und der Benutzer diese Infrastruktur-Cluster anhand eines einheitlichen Betriebsmodells verwalten möchte. Der Flottenansatz hingegen ist für Szenarien mit einer großen Anzahl von Clustern ausgelegt (z. B. K8s-Cluster in Robotern, Fahrzeugen und industriellen Gateways oder in Dutzenden von Public-Cloud-Regionen), in denen der Benutzer dieselbe Anwendung sowie dieselben Netzwerk- und Sicherheitskonfigurationen auf all diesen Clustern bereitstellen möchte. In den nächsten beiden Abschnitten werden der Multi-Cluster-Ansatz und der Flottenbetrieb ausführlicher beschrieben und miteinander verglichen.
Multi-Cluster-Ansatz
Ein Multi-Cluster-Management-Ansatz ist für Anwendungsfälle konzipiert, bei denen eine relativ geringe Anzahl von Clustern von einem einzigen Team betrieben wird. Beispiele für solche Szenarien sind einige Dutzend Cluster, die über wenige Verfügbarkeitszonen verteilt sind, um den Auswirkungsradius zu begrenzen. Ebenso können sich Benutzer für mehrere Cluster in verschiedenen Regionen entscheiden, um regulatorische Anforderungen zu erfüllen.
Die folgenden beiden Beispiele veranschaulichen auf übergeordneter Ebene, wie Multi-Cluster-Lösungen funktionieren:
Konfiguration
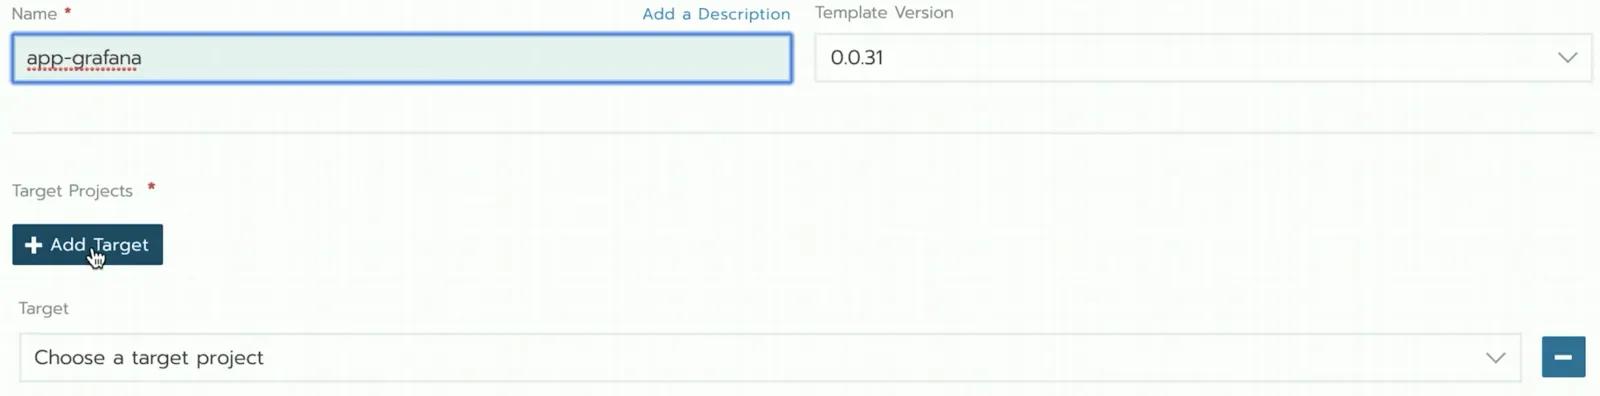
Betrachten wir als Beispiel eine Anwendungsbereitstellung mit einem Multi-Cluster-Ansatz von Rancher, wie in Abbildung 1 dargestellt. Bei einem Multi-Cluster-Ansatz wählt der Kunde die Zielstandorte für die Anwendungsbereitstellung einzeln aus. Dieses Vorgehen eignet sich, wenn nur wenige Cluster vorhanden sind. Für beispielsweise tausend Cluster ist es jedoch nicht ausgelegt.
Beobachtbarkeit
Abbildung 2 zeigt am Beispiel von Rancher, wie Observability in einem Multi-Cluster-Ansatz funktioniert. Bei einem Multi-Cluster-Ansatz muss der Kunde nacheinander auf jeden einzelnen Cluster doppelklicken, um den Status der bereitgestellten Pods sowie die Auslastung der CPU- und Arbeitsspeicherressourcen anzuzeigen. Dieser Ansatz, bei dem die Zielstandorte einzeln überwacht werden, eignet sich für eine geringe Anzahl von Clustern, nicht jedoch für die Verwaltung einer großen Anzahl von Clustern.
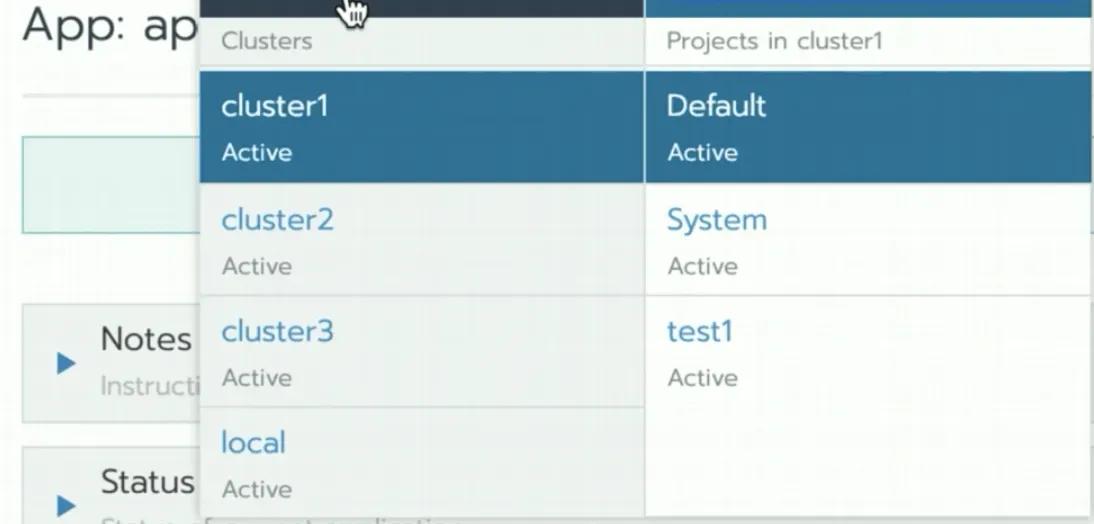
Cluster 1:
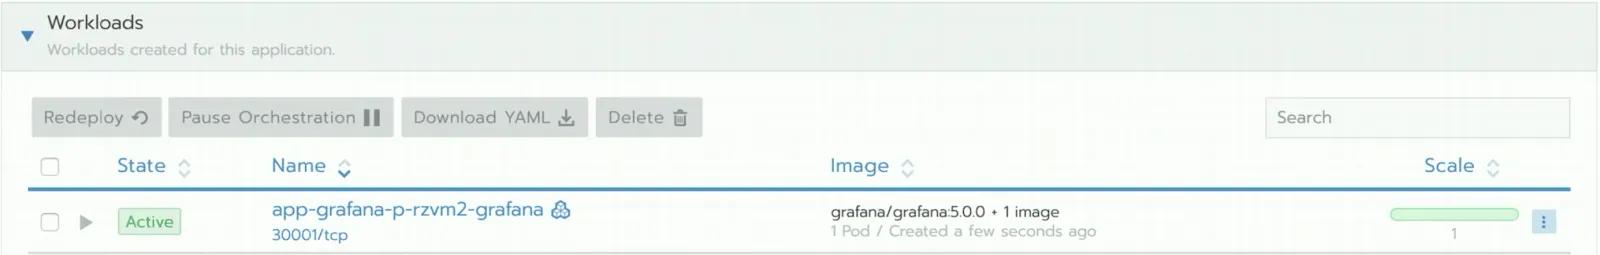
Cluster 2:

Ein naheliegender Ansatz zur Lösung des im ersten Beispiel beschriebenen Problems wäre, eine Automatisierung zu entwickeln, die die Aufgaben für jeden Cluster wiederholt. Wenn beispielsweise ein neuer Cluster hinzugefügt wird, könnte das Skript den folgenden Vorgang ausführen, um eine neue Anwendung bereitzustellen (zum Beispiel checkoutservice):
export KUBECONFIG=~/Documents/kubeconfig/ce01-ashburn-aws-staging
kubectl apply -f checkoutservice.yaml
Allerdings muss für jeden Vorgang – Bereitstellung, Upgrade, Richtlinien, Ressourcenreservierung usw. – eine Automatisierung entwickelt werden. Diese Automatisierung muss nicht nur den jeweiligen Vorgang über viele Cluster hinweg ausführen, sondern auch Fehlerfälle behandeln. Bei komplexen Szenarien – z. B. Betatests auf einer Teilmenge der Cluster oder schrittweise Upgrades über alle Cluster hinweg – wird die Automatisierung zudem immer komplexer. Wir haben dies frühzeitig erkannt und eine verteilte Steuerungsebene entwickelt, die all diese Funktionen mithilfe des im Folgenden beschriebenen Ansatzes für den Flottenbetrieb bereitstellt.
Volterras Ansatz für den Flottenbetrieb
Fleet Operations bedeutet, dass der Kunde seine Vorgaben einmal deklarativ für die gesamte Flotte definiert und das System anschließend dafür sorgt, dass die betroffenen Standorte diesen Vorgaben entsprechen. Beispiele für solche Vorgaben sind die Version der Anwendungssoftware, die Version der Infrastruktursoftware (z. B. die Betriebssystemversion), Netzwerkrichtlinien, Sicherheitsrichtlinien und Ressourcenreservierungen.
Sobald die Vorgaben wirksam werden, können Benutzer den Status und Zustand der Flotte im System einsehen. Das bedeutet, dass sie eine aggregierte Übersicht über den Zustand der Infrastruktur und Anwendungen an allen Standorten der Flotte in einer zentralen Ansicht erhalten. Dadurch verringert sich die betriebliche Komplexität für das Betriebsteam des Kunden. Benutzer müssen nicht jeden Standort oder Cluster einzeln aufrufen, um dessen Zustand zu ermitteln, und auch keine Automatisierungstools zur Zusammenführung der Informationen entwickeln.
Der Ansatz von Volterra für den Flottenbetrieb besteht aus drei Hauptkomponenten – Segmentierung, Konfiguration und Beobachtbarkeit –, die wir in den folgenden Abschnitten erläutern werden.
Flottensegmentierung
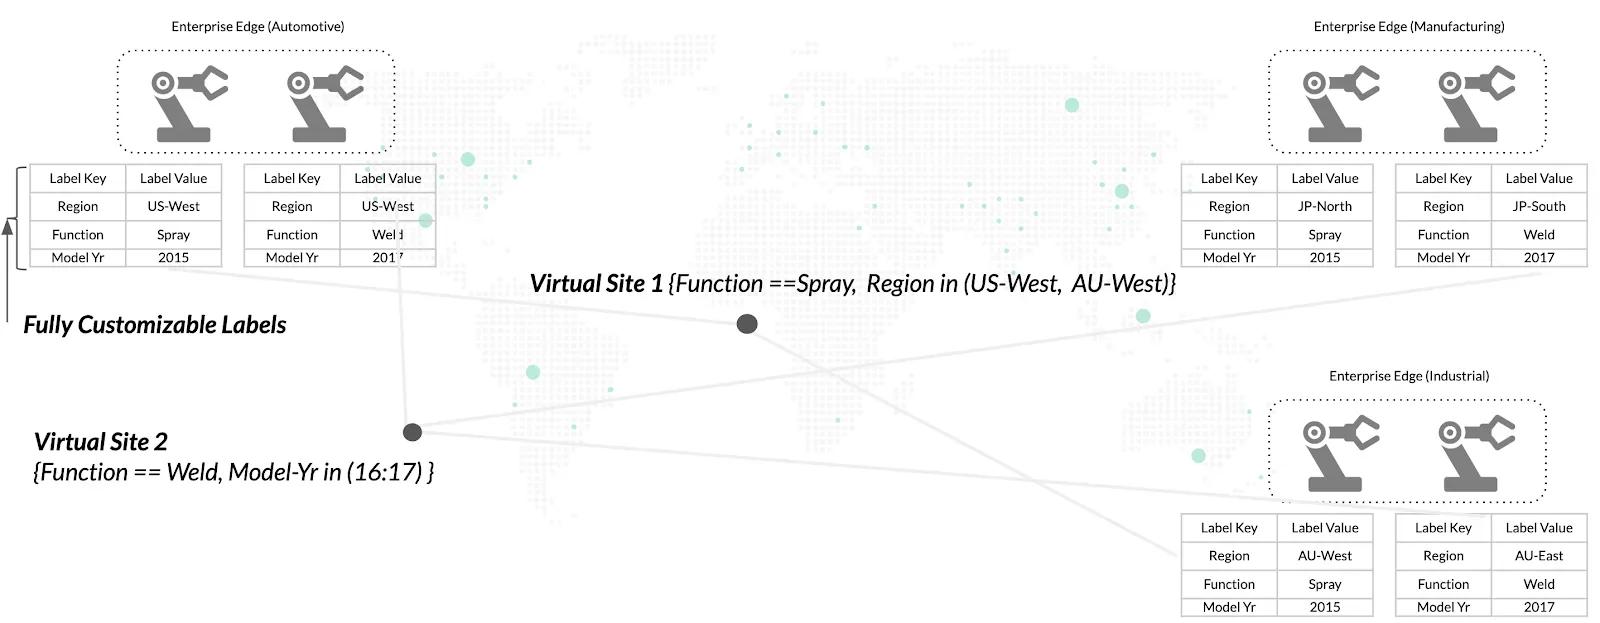
Benutzer haben in ihrer Flotte häufig eine Mischung aus Entwicklungs-, Test- und Produktions-Computing-Standorten. Aufgrund von Unternehmensrichtlinien müssen unterschiedliche Workloads in einem bestimmten Segment von Standorten bereitgestellt werden. So dürfen beispielsweise Entwicklungs-Workloads nur an Entwicklungsstandorten ausgeführt werden. Benutzer können Standorte flexibel mit einem Label kennzeichnen, das aus zwei Teilen besteht: Schlüssel und Wert. Beispiele hierfür sind:
- Label-Schlüssel=region. Label-Wert = US-West, JP-North, JP-south
- Modelljahr=(2015, 2016, 2017, 2018)
- function=(sprühen, schweißen)
Sobald die Standorte mit Tags versehen sind, können Benutzer mithilfe von Bedingungen für Label-Schlüssel-Wert-Paare einen „virtuellen Standort“ definieren. In einem Multi-Cloud-Szenario können Benutzer ihre Standorte beispielsweise als „dev“, „pre-prod“ oder „prod“ kennzeichnen. Die folgende Abbildung 3 zeigt ein Beispiel für einen Robotik-Anwendungsfall, bei dem die zuvor beschriebenen Label-Schlüsselwerte verwendet werden.
Hier ist ein Konfigurationsausschnitt für Volterra, in dem der Benutzer mithilfe der blend/go-sdk-Syntax einen virtuellen Standort erstellen kann. In diesem konkreten Beispiel wurden die einzelnen Standorte mit dem Label-Schlüssel key=ves.io/country und dem Label-Wert ves-io-jpn versehen.
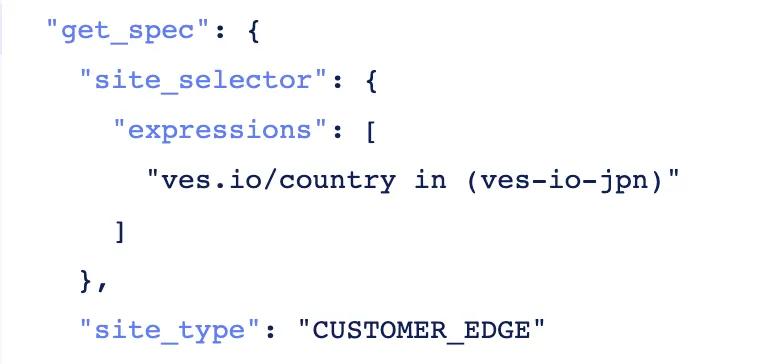
Benutzer sind mit einem Betriebsmodell vertraut, bei dem sie Segmente ihrer Flotte im Voraus definieren und ihre Standorte bei der Bereitstellung mit Tags versehen, damit sie in die Flotte aufgenommen werden. Virtuelle Standorte fügen sich nahtlos in das bestehende Betriebsmodell der Benutzer ein. Wird ein neuer Standort mit dem entsprechenden Tag bereitgestellt, wird er automatisch in den zuvor definierten virtuellen Standort aufgenommen, ohne dass zusätzliche manuelle Schritte erforderlich sind. Darüber hinaus erkennt Volterra bereits bereitgestellte Informationen wie den Hardwarehersteller oder den Typ der Public Cloud, um System-Tags vorab auszufüllen. Benutzer können diese automatisch erkannten Tags optional zur Definition ihrer virtuellen Standorte verwenden.
Flottenkonfiguration
Die Möglichkeiten der Flottenkonfiguration lassen sich am besten anhand der folgenden drei Beispiele beschreiben:
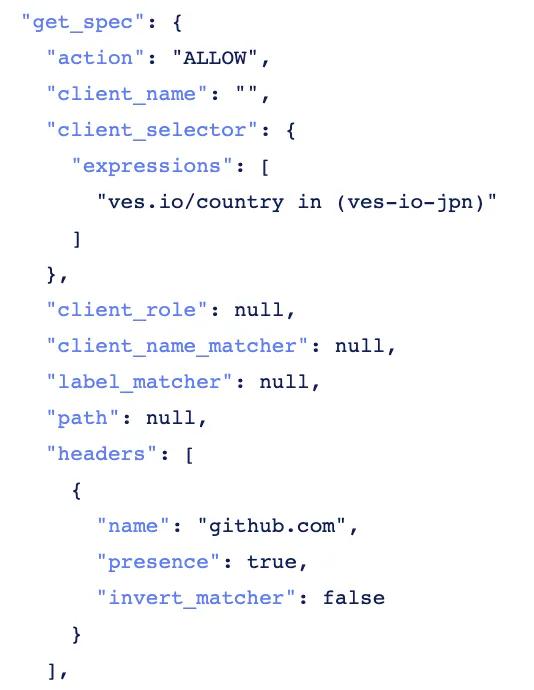
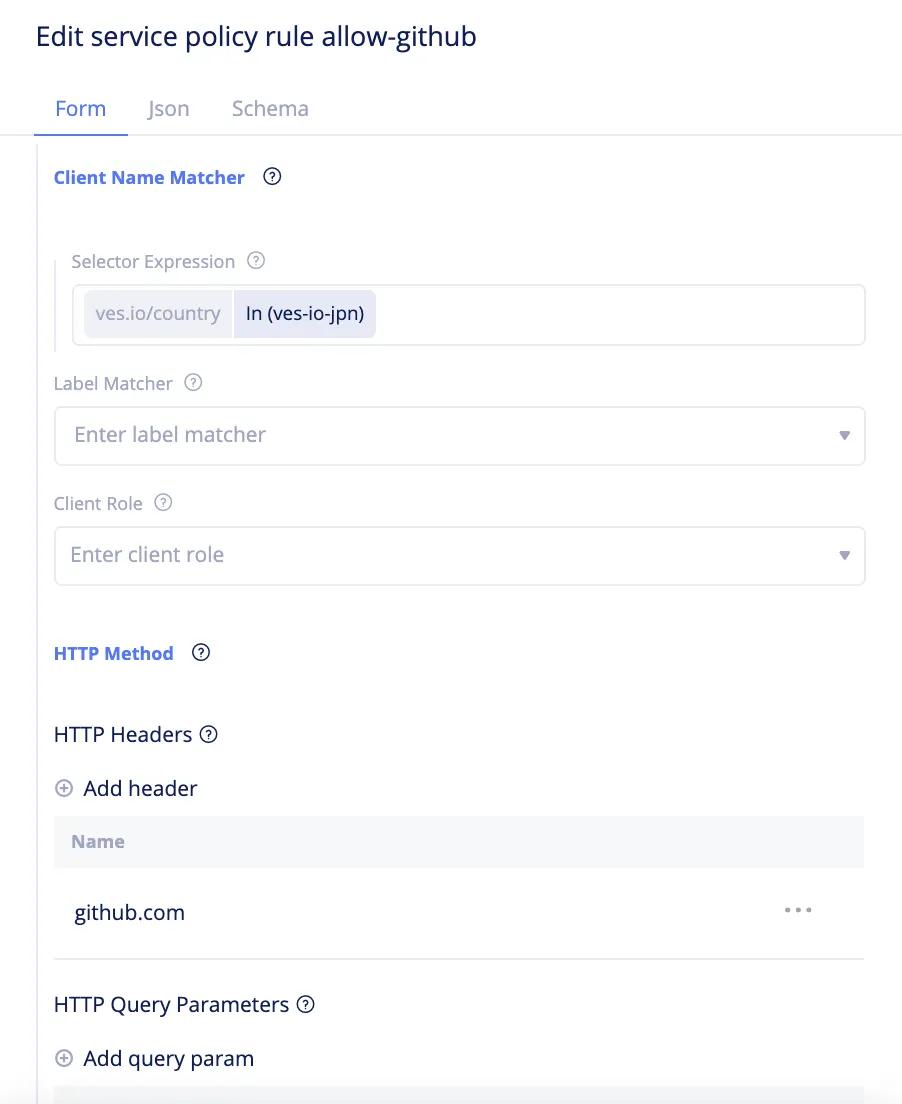
- Konfiguration einer Netzwerk-/Sicherheitsrichtlinie – Nehmen wir als Beispiel einen Kunden, der einen neuen Dienst einführt, für den jeder Cluster mit einer bestimmten URL kommunizieren können muss, z. B. github.com. In der Regel verwenden Benutzer Positivlisten, sodass Cluster nur bestimmte Ziele erreichen dürfen. Für die Einführung dieses neuen Dienstes müssten die Benutzer daher jeden Cluster einzeln aufrufen und die Netzwerkrichtlinie ändern, um github.com zur Positivliste hinzuzufügen. Darüber hinaus möchte der Kunde den Dienst zunächst an einigen Teststandorten erproben, bevor er ihn an allen Standorten einführt. Um dies mit Volterra umzusetzen, definiert der Kunde zunächst in der Volterra-SaaS-Konsole einen virtuellen „Test“-Standort, der einen Teil der Flotte auswählt. Anschließend definiert der Benutzer eine Netzwerkrichtlinie, beispielsweise eine Positivliste zulässiger URLs (in diesem Beispiel github.com), und wendet sie auf den virtuellen „Test“-Standort an. Die verteilte Steuerungsebene von Volterra sendet die Netzwerkrichtlinie an die lokale Steuerungsebene jedes Standorts, der durch den virtuellen Standort ausgewählt wurde (wie oben definiert). Die lokale Steuerungsebene jedes Standorts wendet die Netzwerkrichtlinie an und erfasst Statistiken darüber, welche Regeln pro Standort ausgelöst wurden. Sobald der Kunde sich davon überzeugt hat, dass der Dienst wie erwartet funktioniert, kann er die Netzwerkrichtlinie auf den virtuellen „Prod“-Standort anwenden, der die übrigen Standorte der Flotte auswählt. Nachfolgend sehen Sie einen Konfigurationsausschnitt im JSON-Format sowie die entsprechende Konfiguration über die Benutzeroberfläche des Volterra-Systems.
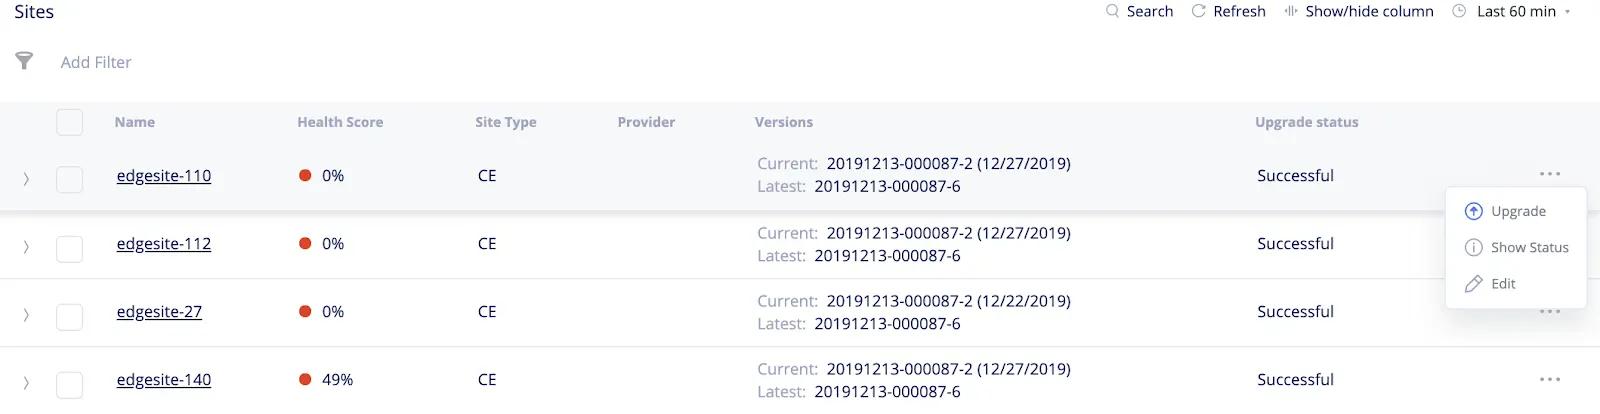
- Upgrade der Infrastruktursoftware – Mit der Flottenkonfiguration können Benutzer die Infrastruktursoftware, z. B. die Betriebssystemversion, in der gesamten Flotte (oder einem Teil davon) aktualisieren. Zunächst legt der Benutzer fest, dass das Betriebssystem von Version 1 auf Version 2 aktualisiert werden soll. Anschließend definiert er eine Bereitstellungsstrategie für die Flotte, beispielsweise ein Rolling Update oder eine Blue-Green-Bereitstellung. Bei einem Rolling Update wird das Betriebssystem jedes Standorts in der Flotte (oder einem Teil davon) nacheinander aktualisiert. Bei einer Blue-Green-Bereitstellungsstrategie möchte der Benutzer das Upgrade an einer Gruppe „blauer“ Standorte (z. B. Entwicklungsstandorten) testen und deren Systemzustand mit dem der nicht aktualisierten „grünen“ Standorte (z. B. Produktionsstandorten) vergleichen. In beiden Fällen sendet die verteilte Steuerungsebene von Volterra die Software der Version 2 an die lokale Steuerungsebene jedes Standorts, der über den virtuellen Standort und gemäß der Bereitstellungsstrategie ausgewählt wurde. Die lokale Steuerungsebene jedes Standorts aktualisiert das Betriebssystem nach dem A/B-Prinzip: Sie erstellt eine neue Partition, stellt Version 2 darin bereit und ermöglicht dem Kunden, den Systemzustand zu überprüfen. Wenn die Installation von Version 2 fehlschlägt, setzt das System automatisch auf Version 1 in der ursprünglichen Partition zurück. Die folgenden Screenshots zeigen, wie Benutzer die Infrastruktursoftware über das Volterra-SaaS-Portal aktualisieren können. Wie in der nächsten Abbildung dargestellt, können Benutzer für alle Standorte die aktuelle Version der Infrastruktursoftware sowie die neueste verfügbare Softwareversion einsehen. Je nach Betriebsmodell können sie problemlos bestimmte oder alle Standorte aktualisieren.
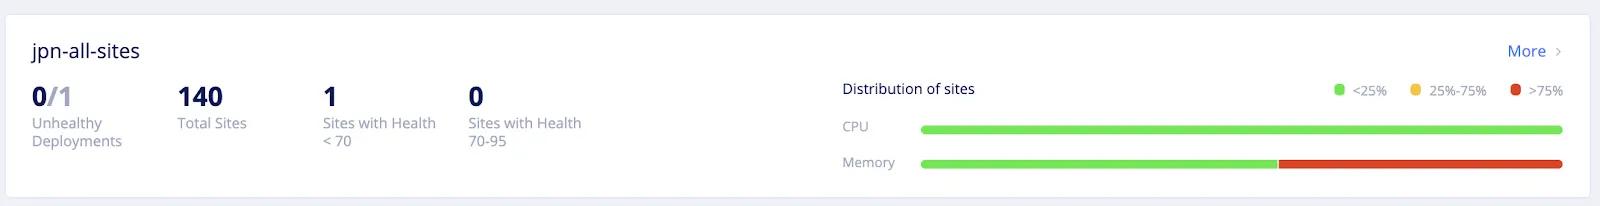
- Flottenweite Bereitstellung von Anwendungen – Volterra stellt ein Objekt namens Virtual Kubernetes (vK8s) bereit, mit dem Benutzer Anwendungen mithilfe von Kubernetes-APIs in ihrer gesamten Flotte verwalten können. Der Benutzer stellt seine Anwendungen mit Standardmethoden von Kubernetes (d. h. Kubeconfig-Datei und Kubernetes-APIs) sowie einer Bereitstellungsmanifestdatei bereit und gibt das Segment der Standorte (oder die gesamte Flotte) an, in dem die Anwendung bereitgestellt werden soll. Volterras Virtual Kubernetes (vK8s) übernimmt anschließend die Bereitstellung der Anwendung an jedem Standort der Flotte (oder eines Segments davon). Treten während der Anwendungsbereitstellung Fehler auf, etwa Verbindungs- oder Infrastrukturfehler, versucht Volterra Virtual Kubernetes die Bereitstellung gemäß dem Kubernetes-Paradigma eines letztlich konsistenten Modells immer wieder. Der nächste Screenshot zeigt ein Beispiel, in dem der Benutzer eine Anwendung namens „kuard“ (siehe Kubernetes-up-and-running-demo-app) auf einem virtuellen Standort namens „jpn-all-sites“ bereitstellt, der 140 Standorte der Flotte umfasst. Um eine neue Bereitstellung hinzuzufügen, muss der Benutzer lediglich auf „Bereitstellung hinzufügen“ klicken und den virtuellen Standort als Bereitstellungsort angeben.
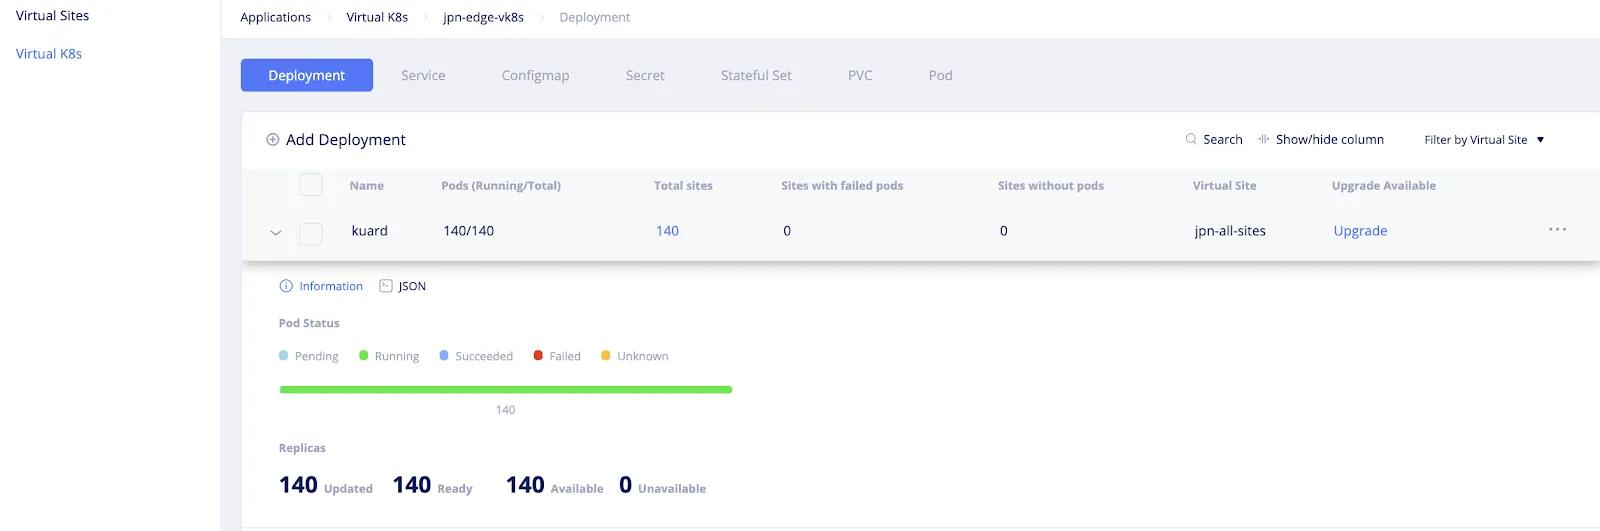
Wenn der Flotte ein neuer Standort mit dem entsprechenden Label hinzugefügt wird, wird er automatisch dem virtuellen Standort (in diesem Beispiel jpn-all-sites) hinzugefügt. Außerdem wird die Flottenkonfiguration (in diesem Beispiel das Kuard-Deployment) automatisch auf den neu hinzugefügten Standort angewendet. Dadurch werden die Betriebsteams entlastet und menschliche Fehler vermieden.
Flottenüberwachung
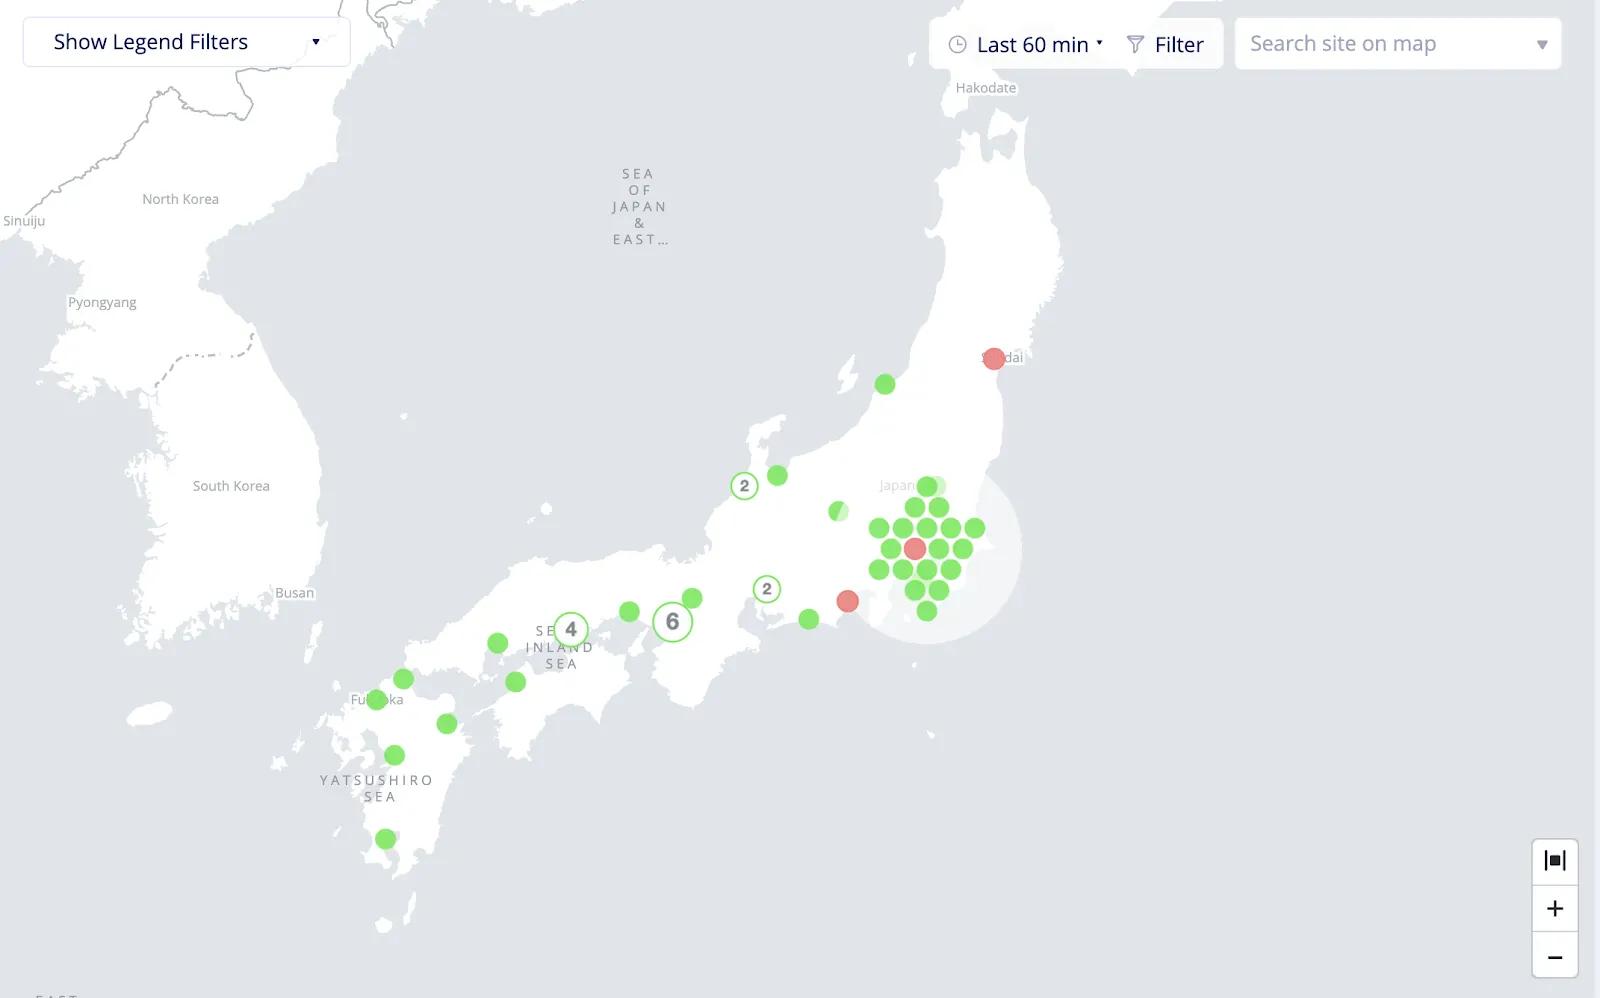
Virtuelle Sites und Virtual Kubernetes (vK8s) dienen nicht nur der Konfiguration, sondern auch dazu, den Integritätsstatus verteilter Sites innerhalb der Flotte zusammenzuführen. Im Vergleich zu anderen Lösungen ist dies ein äußerst leistungsfähiges Werkzeug, da Benutzer andernfalls eigene Tools entwickeln müssten, um den Status jeder einzelnen Site abzurufen und die Informationen zusammenzuführen. Das System führt den Integritätsstatus aller Sites automatisch in einer zentralen Übersicht zusammen und reduziert so die betriebliche Komplexität für das Betriebsteam des Kunden. Der erfasste Integritätsstatus umfasst zahlreiche Aspekte, darunter den Status der Anwendungsbereitstellung, die Integrität der Sites und die Integrität der Anwendungen.
Benutzer können sich auf einer Karte schnell einen Überblick über den Zustand all ihrer Standorte verschaffen, wie im nächsten Screenshot dargestellt. Die Farbe zeigt an, ob der Zustandswert über 75 (grün), zwischen 40 und 75 (orange) oder unter 40 (rot) liegt. Der Zustandswert ist ein aggregierter Wert, der sich aus Konnektivität, Zuverlässigkeit, Sicherheit und Leistung (d. h. Ressourcenverbrauch) zusammensetzt.
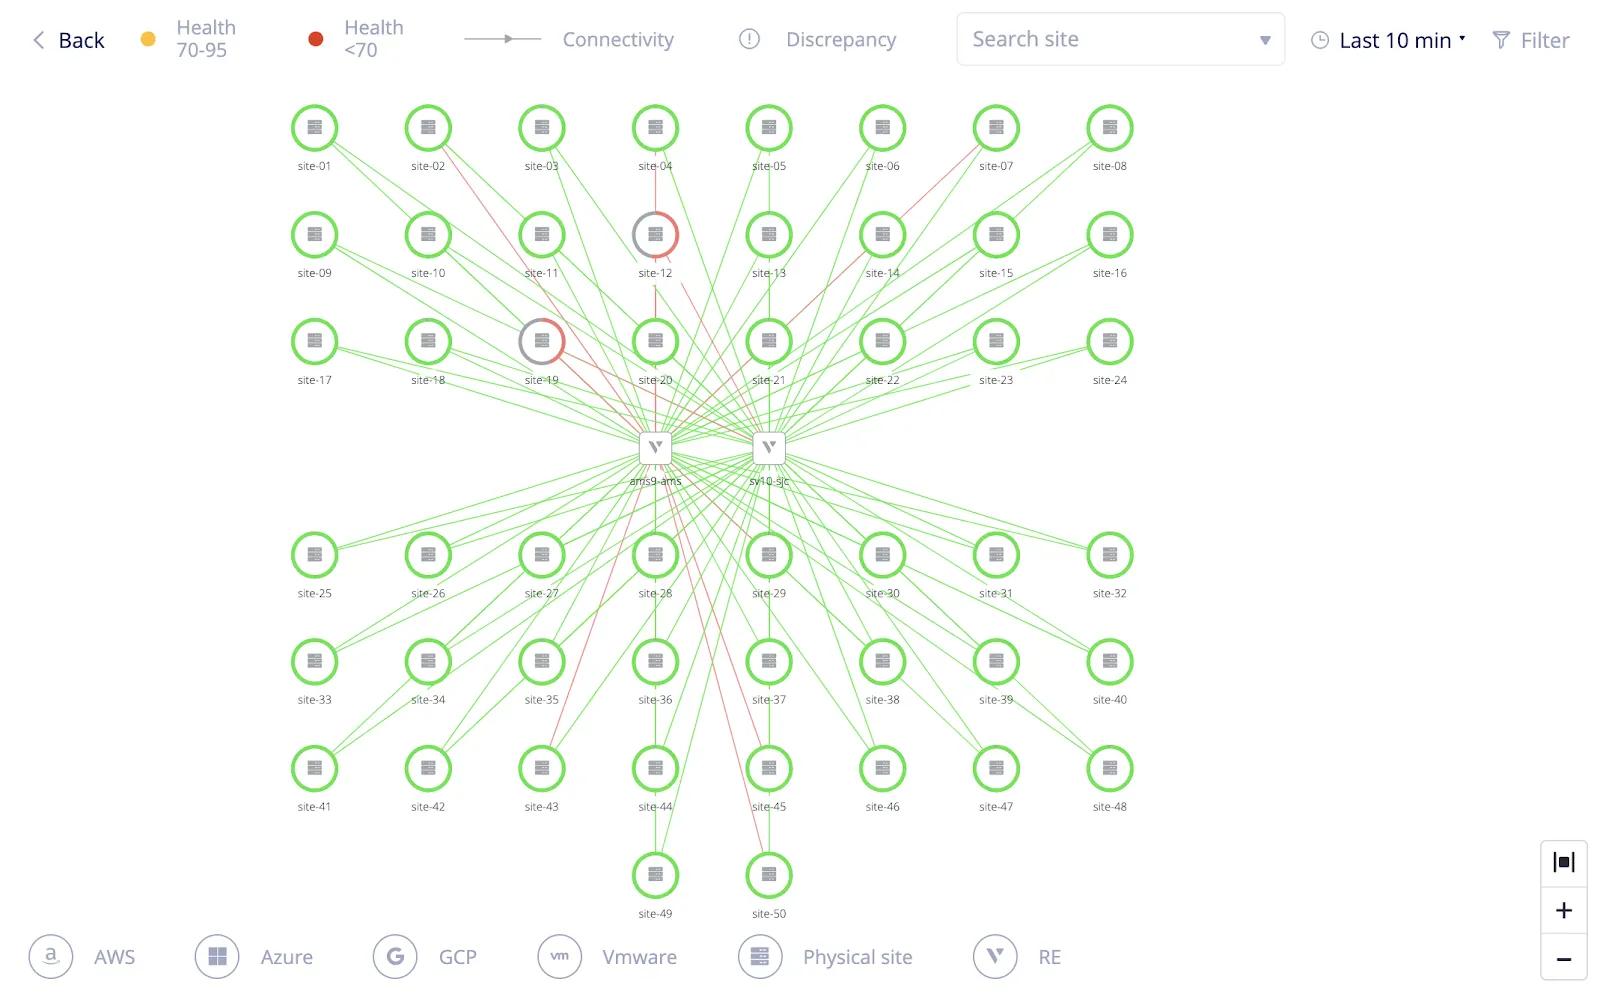
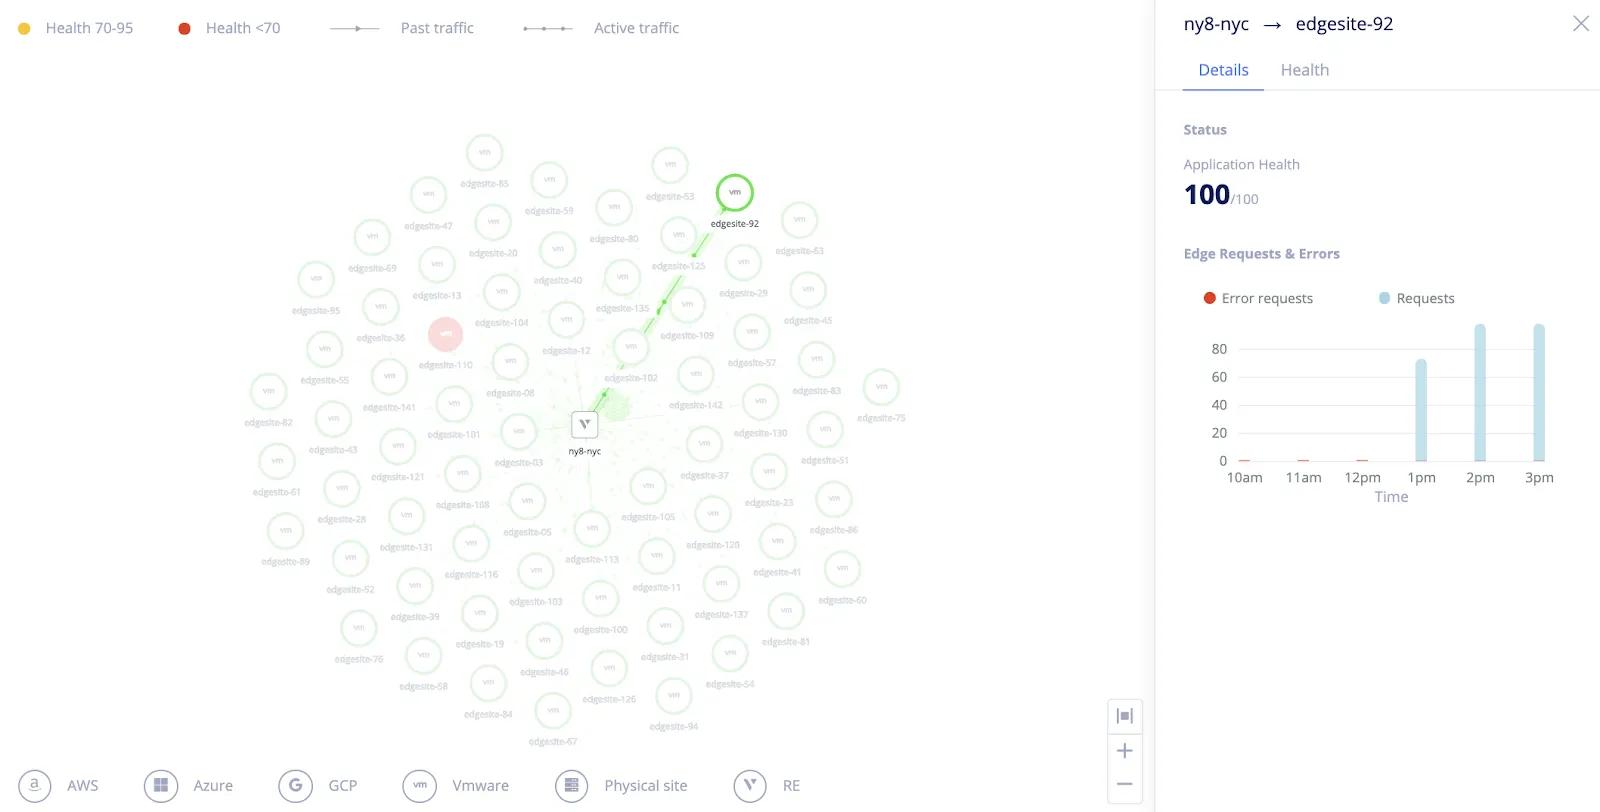
Benutzer können außerdem eine aggregierte Ansicht der Konnektivität all ihrer Standorte sowie deren Zustand einsehen. Der Verbindungszustand jeder Verbindung zwischen den Standorten und dem Volterra-Backbone wird ebenfalls angezeigt, wie in Abbildung 10 dargestellt. Benutzer können anhand des Zustands auf Verbindungen mit unzureichender Leistung klicken, um detaillierte Statistiken zu Anfragen und Fehlern aufzurufen und etwaige Verbindungsprobleme zu beheben, wie in Abbildung 11 dargestellt.
Anschließend können Benutzer anhand der Verteilung der CPU- und Arbeitsspeicherauslastung standortübergreifend aggregierte Informationen zu allen Standorten anzeigen. Diese Informationen helfen IT- oder Standortadministratoren dabei, stark ausgelastete Standorte zu erkennen, bei denen die Gefahr besteht, dass die Ressourcen knapp werden. Standortadministratoren können Warnmeldungen einrichten, um benachrichtigt zu werden, wenn der Ressourcenverbrauch bestimmte Schwellenwerte überschreitet. In diesem Screenshot ist zu sehen, dass die Hälfte der Standorte mehr als 75 % des verfügbaren Arbeitsspeichers beansprucht. Benutzer müssen weder die einzelnen Standorte aufrufen noch zusätzliche Tools entwickeln, um diese Informationen zu erhalten.
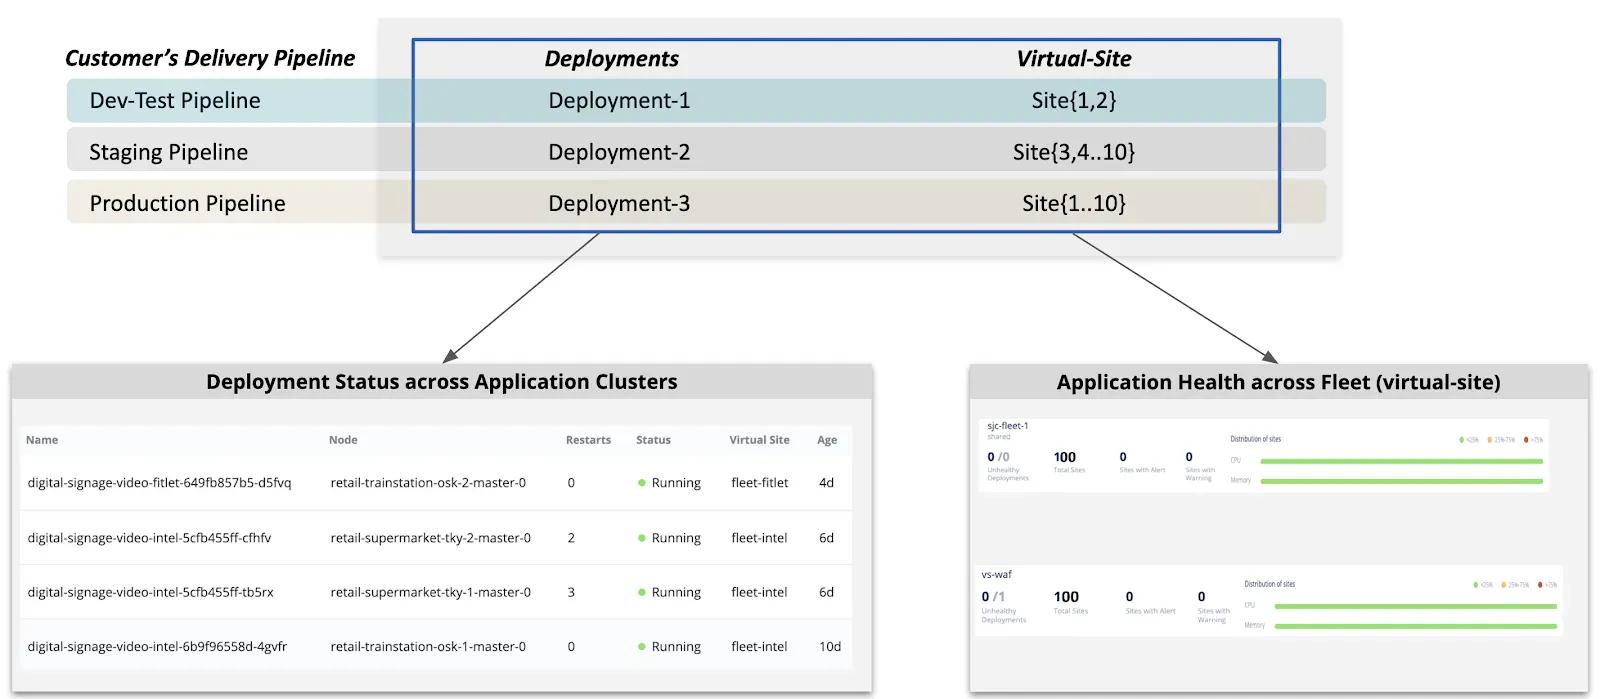
Funktionen zur kontinuierlichen Verifizierung im Fleet-Objekt zeigen den Status der POD-Bereitstellungen an – wie viele PODs bereitgestellt wurden, sich noch in der Bereitstellung befinden oder fehlgeschlagen sind. Nach der Bereitstellung können Benutzer außerdem den Integritätsstatus der Pods einsehen – etwa ob sie ausgeführt werden, auf ein Image warten, nicht genügend Arbeitsspeicher haben usw.
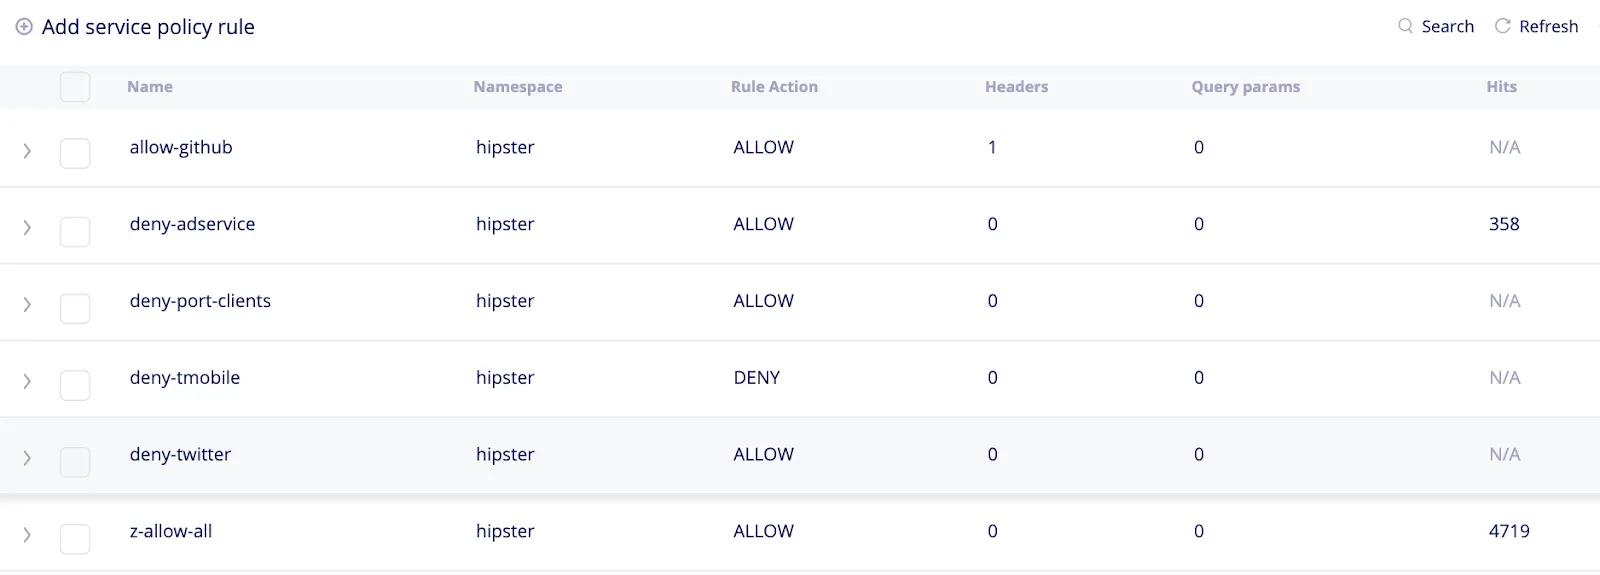
Darüber hinaus können Benutzer eine aggregierte Übersicht über die Wirksamkeit der Sicherheitsrichtlinie und die Treffer auf all ihren Websites anzeigen, wie im nächsten Screenshot zu sehen ist.
Zusammenfassung
Wenn Sie mehr darüber erfahren möchten, wie Volterras Ansatz für den Flottenbetrieb zur Verwaltung einer Flotte von 3.000 Clustern eingesetzt wurde, können Sie sich Volterras Vortrag ansehen auf einer Kubernetes-Konferenz und diesen Blogbeitrag von Jakub Pavlik lesen
Im nächsten Blogbeitrag mit dem Titel „Time to Effect“ werde ich erläutern, wie Volterras verteilte Steuerungsebene und sein Backbone dazu beitragen, Konfigurationen innerhalb kürzester Zeit an weltweit verteilte Standorte zu übertragen und deren Konsistenz sicherzustellen. Bleiben Sie dran!
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...