
Das Lösungsteam von Volterra entwickelt und pflegt zahlreiche potenzielle Anwendungsfälle für die Volterra-Plattform, um deren möglichen Nutzen zu veranschaulichen. Diese Anwendungsfälle werden häufig in Anleitungen überführt, mit denen Kunden erste praktische Erfahrungen mit Volterra sammeln können.
Das Lösungsteam benötigte eine schnellere, automatisierte Methode, um unsere Anwendungsfälle intern bei Bedarf und mit möglichst wenig manuellen Eingriffen bereitzustellen. Unsere Bereitstellungen umfassten eine hybride Multi-Cloud-Umgebung, die sowohl IaaS-Plattformen (AWS, Azure und GCP) als auch private Rechenzentrumsumgebungen (VMware vSphere und Vagrant KVM) nutzte. Wir wollten die Verwaltung dieser Umgebungen vereinfachen, indem wir ein zentrales Tool bereitstellten, das Bereitstellungen in jeder beliebigen Umgebung erstellen konnte, ohne dass einzelne Benutzer zusätzliche Zugangskonten anlegen oder weitere Anmeldedaten für jede Virtualisierungsplattform bzw. jeden IaaS-Anbieter verwalten mussten. Dieses Tool musste außerdem skalierbar sein, um mehrere gleichzeitige Benutzer und Bereitstellungen zu unterstützen.
Zusammenfassend bestand das zentrale Problem, das wir lösen wollten, darin, ein automatisiertes Tool für die Bereitstellung von Lösungsanwendungsfällen zu entwickeln, das skalierbar ist und parallele Bereitstellungen in hybriden Multi-Cloud-Umgebungen mit möglichst wenigen Benutzereingaben bewältigen kann.
Das Altered-Carbon-Projekt (AC)
Zu diesem Zweck haben wir ein Projekt namens Altered-Carbon ins Leben gerufen, das häufig mit AC abgekürzt wird. Das AC-Projekt ist eine dynamische GitLab-Pipeline, mit der sich über 20 verschiedene Anwendungsfälle für Volterra-Lösungen erstellen lassen. Durch die Automatisierung der Pipeline haben wir „Push-Button-Bereitstellungen“ mit nur einem Befehl ermöglicht, sodass Benutzer bei Bedarf oder über täglich geplante Cronjobs problemlos mehrere Cluster für verschiedene Anwendungsfälle bereitstellen können.
Zur Erläuterung: In AC bezeichnen wir jede Bereitstellung als STACK und jeden individuellen Anwendungsfall als SLEEVE.
Projektentwicklung
Wir begannen die Entwicklung des AC-Projekts, indem wir den Anwendungsfall hello-cloud automatisierten und in den ersten SLEEVE überführten. Der Anwendungsfall hello-cloud erstellt jeweils einen Volterra-Standort in AWS und Azure, führt diese Standorte anschließend zu einem Volterra-VK8s-Cluster (virtuelles Kubernetes) zusammen und stellt mithilfe von VK8s eine Anwendung mit zehn Pods standortübergreifend bereit. Zunächst erstellten wir zusätzliche Terraform-Vorlagen und Shell-Skripte, die die Volterra-API nutzen, um einen vollständig automatisierten GitLab-Workflow zu schaffen, der sich über CI/CD-Pipelines verwalten lässt. Anschließend machten wir uns daran, diese Bereitstellungsmethode wiederverwendbar und skalierbar zu gestalten.
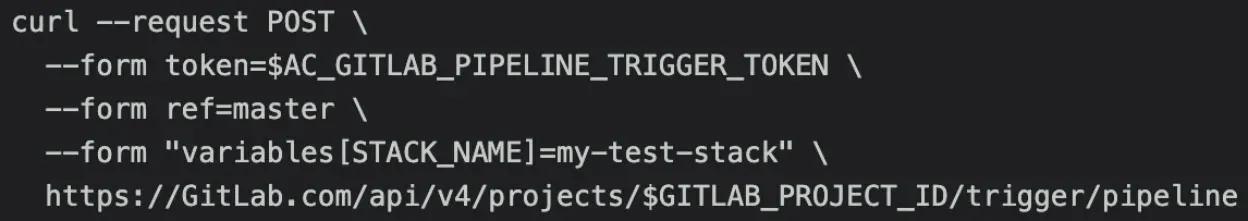
Als Nächstes befassten wir uns in unserem Design mit der Einführung eindeutiger Namenskonventionen. Um mehrere Bereitstellungen des Anwendungsfalls in einer einzigen Volterra-Mandantenumgebung zu ermöglichen, mussten wir sicherstellen, dass die in jedem STACK erstellten Ressourcen eindeutige Namen erhielten und nicht versuchten, Ressourcen mit Namen zu erstellen, die bereits von anderen STACKs in derselben Volterra-Mandantenumgebung verwendet wurden. Um mögliche Konflikte bei den Namenskonventionen zu vermeiden, begannen wir, eindeutige, vom Benutzer bereitgestellte Umgebungsvariablen in Pipeline-Trigger zu integrieren, die zu einem zentralen Bestandteil des Projekts werden sollten. Die Umgebungsvariable STACK_NAME wurde eingeführt und von Terraform verwendet, um eine benutzerdefinierte Zeichenfolge in die Namen aller Ressourcen aufzunehmen, die einem bestimmten STACK zugeordnet waren. Anstatt bei einem Commit ausgelöst zu werden, wurden die Triggerbedingungen der AC-Pipeline-Jobs so festgelegt, dass sie nur durch den API-Aufruf eines GitLab-Benutzers unter Verwendung eines GitLab Project CI Trigger Token gestartet wurden. Dadurch ließ sich die Pipeline durch Benutzereingaben oder externe API-Aufrufe steuern. Mithilfe von API-Aufrufen wie im folgenden Beispiel konnten Benutzer unser Ziel erreichen, mit einem einzigen Befehl mehrere Bereitstellungen ohne Ressourcenkonflikte zu erstellen.
Anschließend versuchten wir, auf Grundlage dieses Modells weitere Bereitstellungsoptionen zu entwickeln. Die AWS- und Azure-Site-Bereitstellungen von hello-cloud waren ebenfalls eigenständige Anwendungsfälle, die wir unabhängig voneinander mit AC bereitstellen wollten. Dabei stießen wir auf unser erstes größeres Problem mit GitLab. In GitLab-CI/CD-Pipelines sind alle Jobs innerhalb der Pipeline eines Projekts miteinander verknüpft. Das war nicht intuitiv, da viele der für unsere hello-cloud-Bereitstellung erforderlichen Jobs für unsere AWS- oder Azure-Site-Bereitstellungen nicht benötigt wurden. Im Grunde wollten wir, dass eine einzige CI-Pipeline eines GitLab-Projekts mehrere unabhängige Pipelines enthält, die bei Bedarf mit jeweils eigenen CI-Jobs ausgelöst werden können.
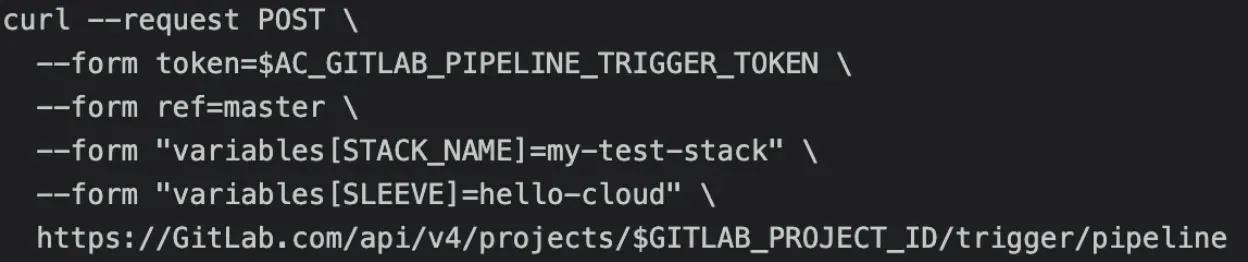
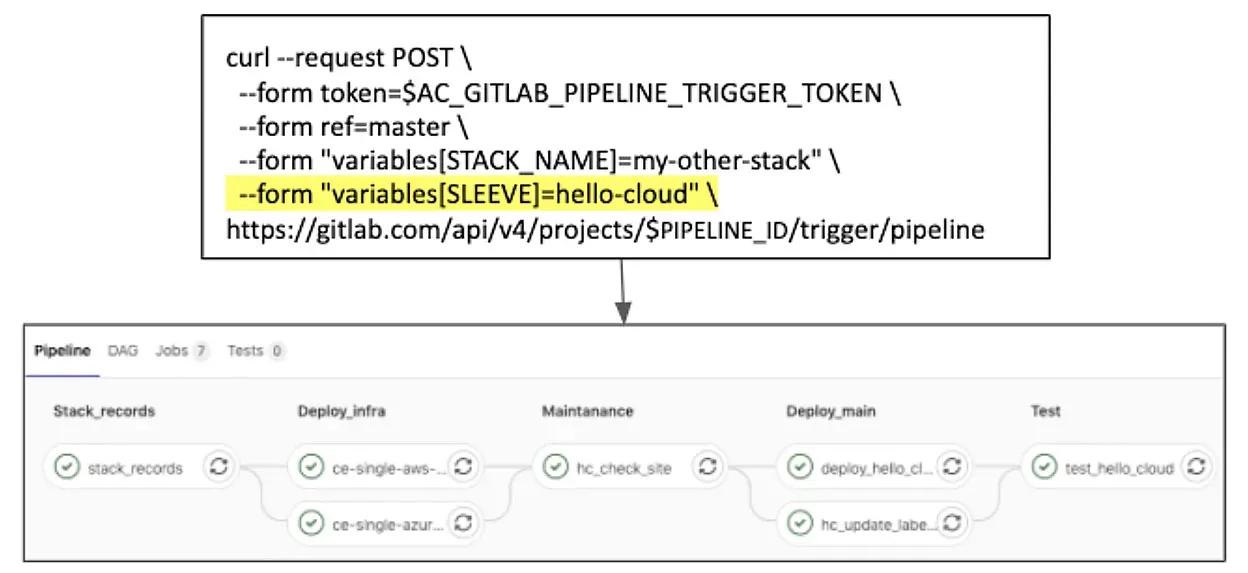
Um dieses Problem zu lösen, führten wir die Umgebungsvariable SLEEVE in die Pipeline-Struktur ein, die die GitLab-CI/CD-Optionen only/except nutzte. Dadurch konnten die in einer beliebigen Pipeline ausgelösten CI-Jobs anhand des Werts von SLEEVE eingeschränkt werden, der beim Auslösen der Pipeline angegeben wurde. Schließlich hatten wir unsere ersten drei SLEEVE-Optionen: simple-aws, simple-azure und hello-cloud. Jeder SLEEVE legte fest, welchen Anwendungsfall ein Benutzer bereitstellen wollte (und steuerte damit die CI-Jobs in einer ausgelösten Pipeline), sowie einen STACK_NAME zur Benennung der von der ausgelösten Pipeline erstellten Ressourcen. Die folgende Befehlsstruktur, die beide Umgebungsvariablen einbezog, diente als grundlegendster AC-Befehl und wird noch heute verwendet:
Die folgende Abbildung veranschaulicht, wie sich durch eine Änderung der Umgebungsvariable SLEEVE die bei jedem Durchlauf der AC-Pipeline ausgelösten Jobs ändern.
SLEEVE-Pipeline „simple-aws“:
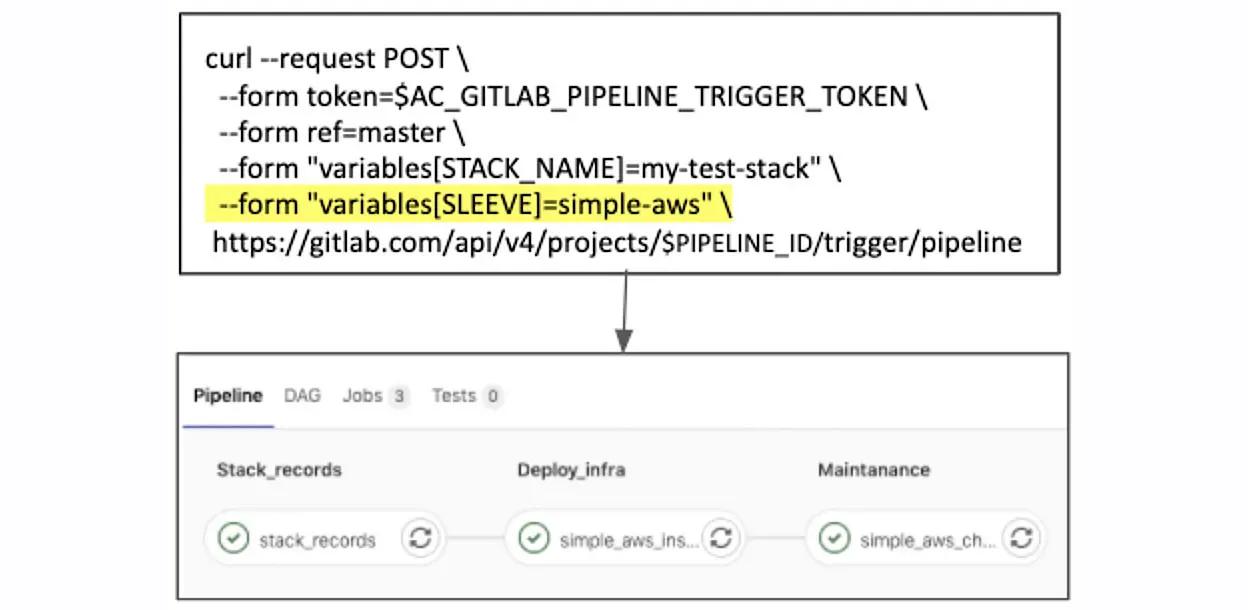
SLEEVE-„hello-cloud“-Pipeline:
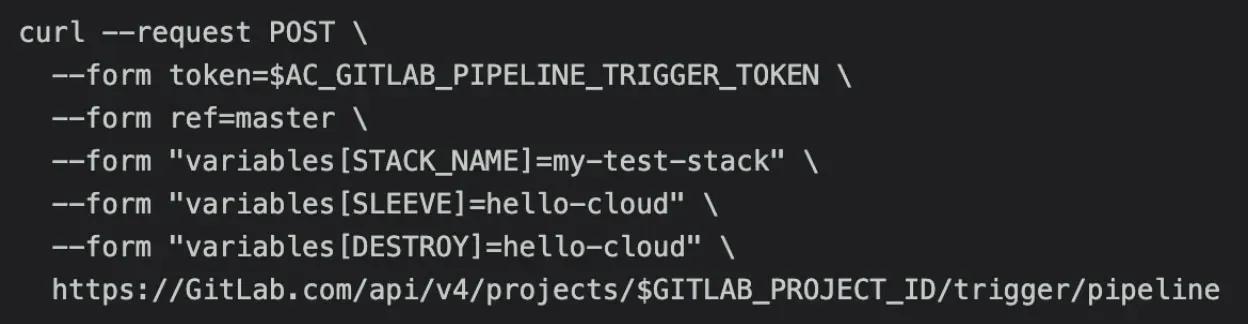
Wir haben außerdem zusätzliche Jobs eingeführt, die ausgelöst werden, wenn die Umgebungsvariable DESTROY bei einem Pipeline-Trigger angegeben wird. Damit steht eine umgekehrte Option zur Verfügung, um die von AC erstellten Ressourcen zu entfernen. Das folgende Beispiel zeigt, wie die Ressourcen eines vorhandenen STACK entfernt werden:
Weitere Umgebungsvariablen wurden in GitLab mit Standardwerten gespeichert, die durch das Hinzufügen von Werten zum Trigger-Befehl überschrieben werden konnten. Beispielsweise wurde die API-URL unserer Volterra-Mandantenumgebungen in der Umgebungsvariablen VOLTERRATENANT gespeichert. Wenn ein Benutzer die Umgebungsvariable VOLTERRATENANT zu seinem API-Befehl hinzufügte, wurde dadurch der Standardwert überschrieben und die Bereitstellung an den gewünschten Zielort umgeleitet. Dies erwies sich als äußerst wichtig für unsere internen Testmöglichkeiten, da das Lösungsteam Dutzende von Volterra-Mandantenumgebungen verwaltet und je nach anstehender Aufgabe zwischen ihnen wechseln können muss:
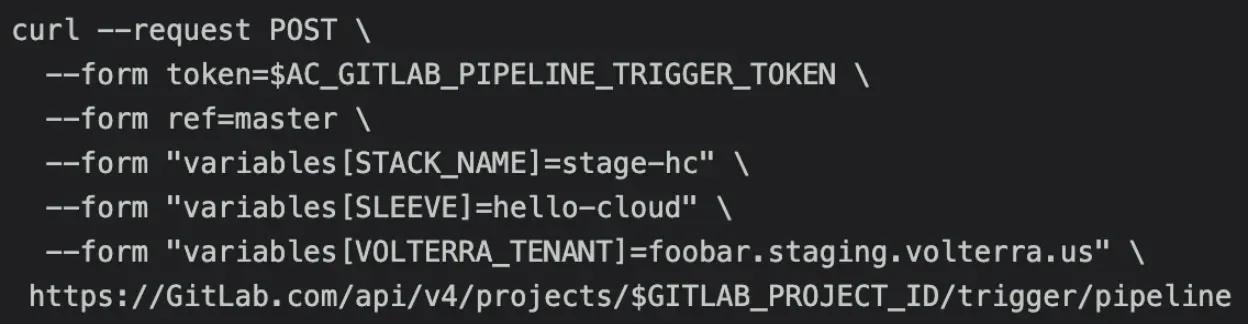
Diese optionalen Umgebungsvariablen konnten bei Bedarf verwendet werden, um eine bessere Kontrolle über Bereitstellungen zu ermöglichen. Gleichzeitig boten sie Nutzern, die diesen zusätzlichen Aufwand nicht verwalten wollten, eine einfachere Standardoption für die Bereitstellung. Außerdem konnten wir so problemlos zwischen Bereitstellungen in Staging- und Produktionsumgebungen wechseln, was sich für unseren größten AC-Nutzer als unverzichtbar erweisen sollte.
Anwendungsfall für Solutions: Nächtliche Regressionstests
Wie bereits erwähnt, stellte jeder SLEEVE in AC einen Volterra-Anwendungsfall dar, über den Kunden häufig erstmals mit dem Produkt in Berührung kamen. Um einen überzeugenden ersten Eindruck vom Produkt zu vermitteln, musste sichergestellt werden, dass diese Anwendungsfälle funktionsfähig und fehlerfrei waren. Vor der Entwicklung von AC war es zeitaufwendig, die Anwendungsfälle daraufhin zu testen, ob sie funktionsfähig und mit den neuesten Versionen der Volterra-Software und -API kompatibel waren. Die für jeden Anwendungsfall erforderlichen manuellen Schritte schränkten die Regressionstests ein, sodass diese nicht häufig genug durchgeführt wurden und zudem anfällig für menschliche Fehler waren.
Dank der AC-Automatisierung konnten jedoch täglich geplante Jobs verwendet werden, um die Bereitstellung eines beliebigen Anwendungsfalls mit einem SLEEVE auszulösen und anschließend die erstellten Ressourcen wieder zu entfernen – unabhängig davon, ob die Bereitstellung erfolgreich abgeschlossen oder fehlgeschlagen war. Dies wurde sowohl in Staging- als auch in Produktionsumgebungen eingesetzt, um zu prüfen, ob kürzlich vorgenommene Änderungen die Bereitstellung des Anwendungsfalls beeinträchtigt oder Fehler in der Volterra-Software verursacht hatten. So konnten wir in unseren Anleitungen zu den Anwendungsfällen dokumentierte Fehler aktualisieren oder Fehler in der Volterra-Software schnell erkennen und entsprechende Tickets zur Behebung einreichen.
Wir erstellten ein separates Repository und eine separate Pipeline mit geplanten Jobs, die mithilfe der Trigger-Befehle der GitLab API gleichzeitig mehrere Stacks mit unterschiedlichen SLEEVEs erzeugten. Jeder Smoke-Test-Job löste zunächst die Erstellung eines Stacks über eine eigenständige AC-Pipeline aus. Anschließend rief der Smoke-Test-Job die Pipeline-ID aus der Standardausgabe des Pipeline-Trigger-Aufrufs ab und überwachte über die GitLab API den Status der ausgelösten Pipeline. Nach Abschluss der Pipeline – unabhängig davon, ob sie erfolgreich war oder fehlschlug – führte der Job die Destroy-Pipeline für denselben erstellten STACK aus, um die Ressourcen nach dem Test zu entfernen.
Die folgende Abbildung veranschaulicht diesen Prozess und zeigt die Jobs, die durch die Befehle zum Erstellen und Löschen in AC ausgelöst werden:
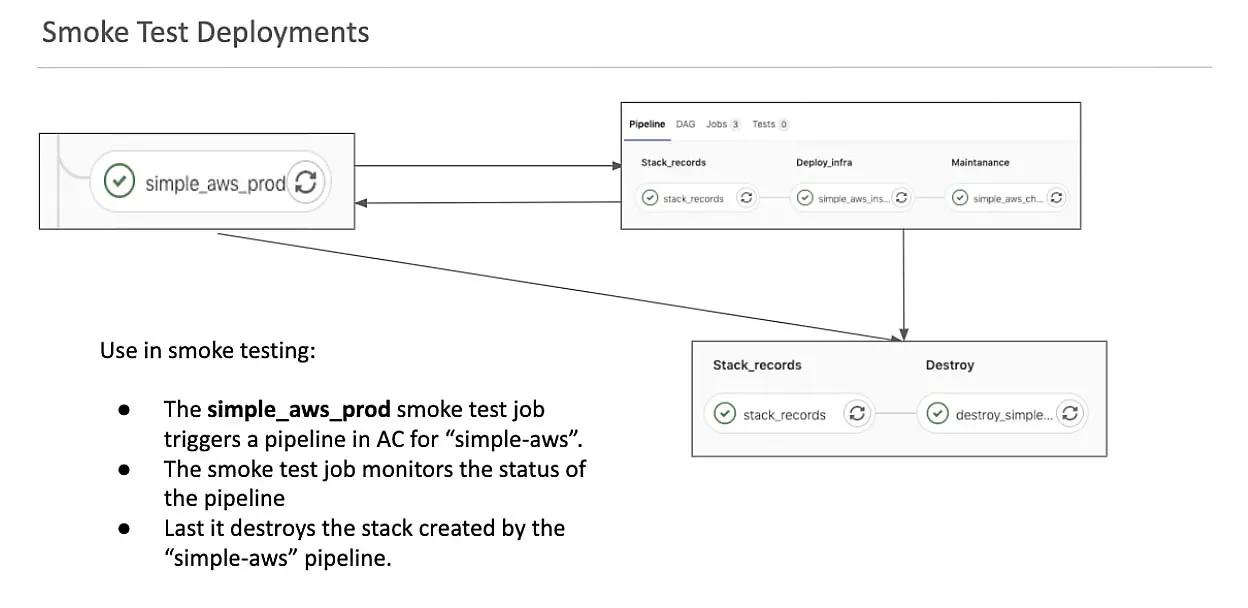
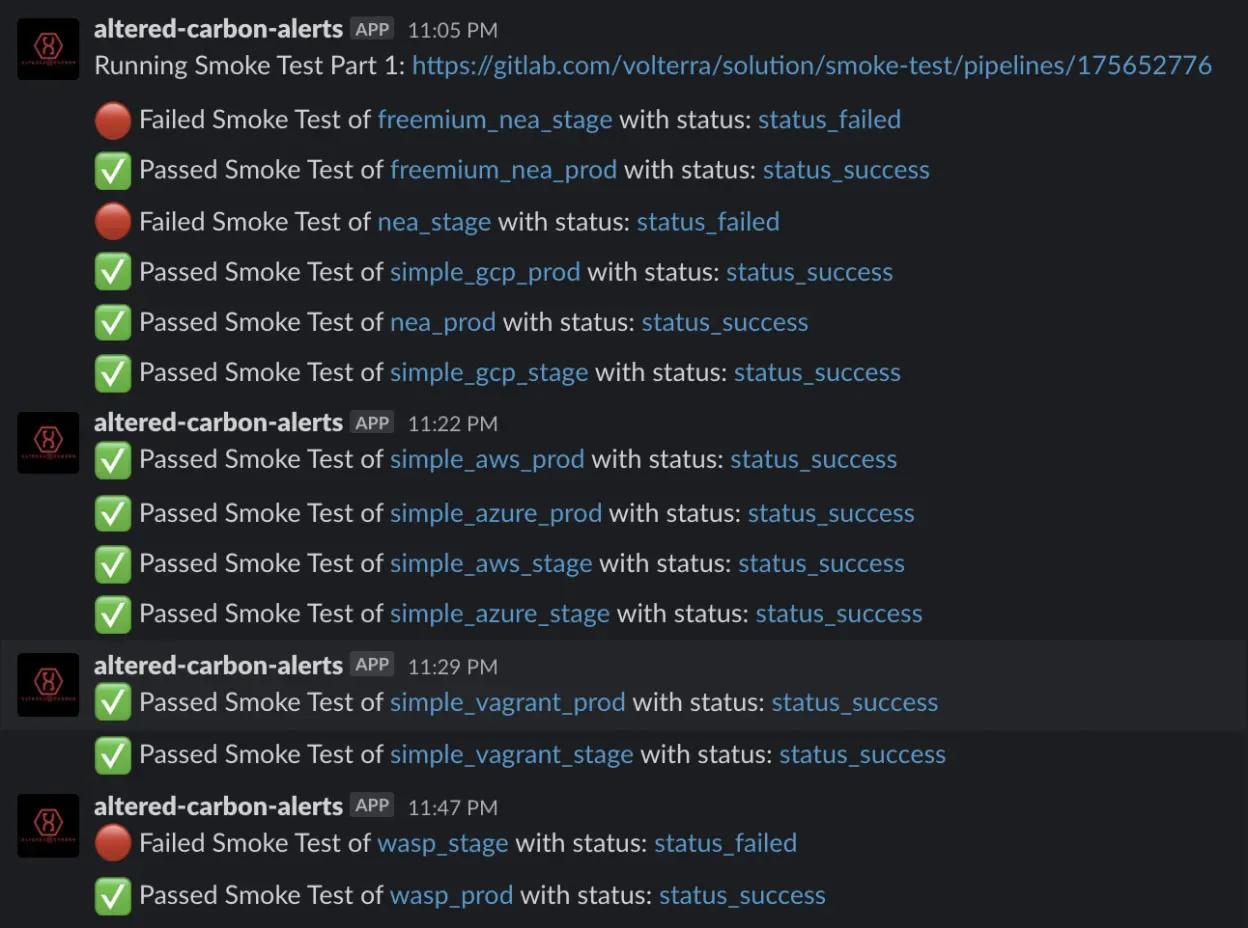
Wenn eine Smoke-Test-Pipeline fehlschlug, konnten wir die Umgebungsvariablen bereitstellen, die in einem AC-Trigger verwendet werden konnten, um das Problem zu reproduzieren. Diese konnten wir in unseren technischen Tickets angeben, sodass unsere Entwickler die fehlgeschlagenen Deployments problemlos nachstellen konnten. Als dann weitere SLEEVES fertiggestellt wurden, fügten wir den CI-Pipelines immer mehr Jobs hinzu und erhöhten so die Testabdeckung. Um die Sichtbarkeit dieser Tests weiter zu verbessern, integrierten wir Slack und ließen die Smoke-Test-Jobs nach jedem Pipeline-Durchlauf eine Erfolgs- oder Fehlermeldung mit Links und Details zu den entsprechenden CI-Webseiten sowohl im Altered-Carbon- als auch im Smoke-Test-Projekt senden.
Stack-Protokollierung und Navigation über die Pipeline-Web-URL
Die Komplexität des Projekts nahm mit der Weiterentwicklung von AC zu, da weitere Benutzer aus dem Lösungsteam hinzukamen und immer mehr Stacks erstellt wurden. Dadurch entstanden grundlegende Probleme bei der Navigation in der Weboberfläche von GitLab Pipelines. Wir nutzten GitLab Pipelines auf eine sehr unkonventionelle Weise, weshalb es in der Weboberfläche schwierig war, einzelne Pipeline-Durchläufe nachzuverfolgen, die mit den von uns erstellten STACKs zusammenhingen.
GitLab-Pipelines, die Deployments über GitOps-Workflows verwalten, scheinen sich am besten für eine statisch definierte Gruppe von Clustern zu eignen. In diesem Fall würde jeder Durchlauf einer GitLab-Pipeline stets dieselben Cluster und Ressourcen betreffen. Der in der GitLab-Weboberfläche dargestellte Pipeline-Verlauf entspricht dann dem Deployment-Verlauf dieser Cluster. AC ist jedoch dynamisch und verwaltet eine sich ständig ändernde Gruppe von Ressourcen. Dabei kann jeder Pipeline-Durchlauf eine völlig andere Zusammenstellung von Jobs verwenden und unterschiedliche Ressourcen-STACKs bei verschiedenen Virtualisierungsanbietern verwalten. Aufgrund dieser durch die SLEEVE- und STACK-Konventionen bedingten Unterschiede lässt sich nur sehr schwer feststellen, welche Pipeline welchem Stack entspricht. Sehen wir uns beispielsweise die Weboberfläche der GitLab-CI/CD-Pipeline für AC an:
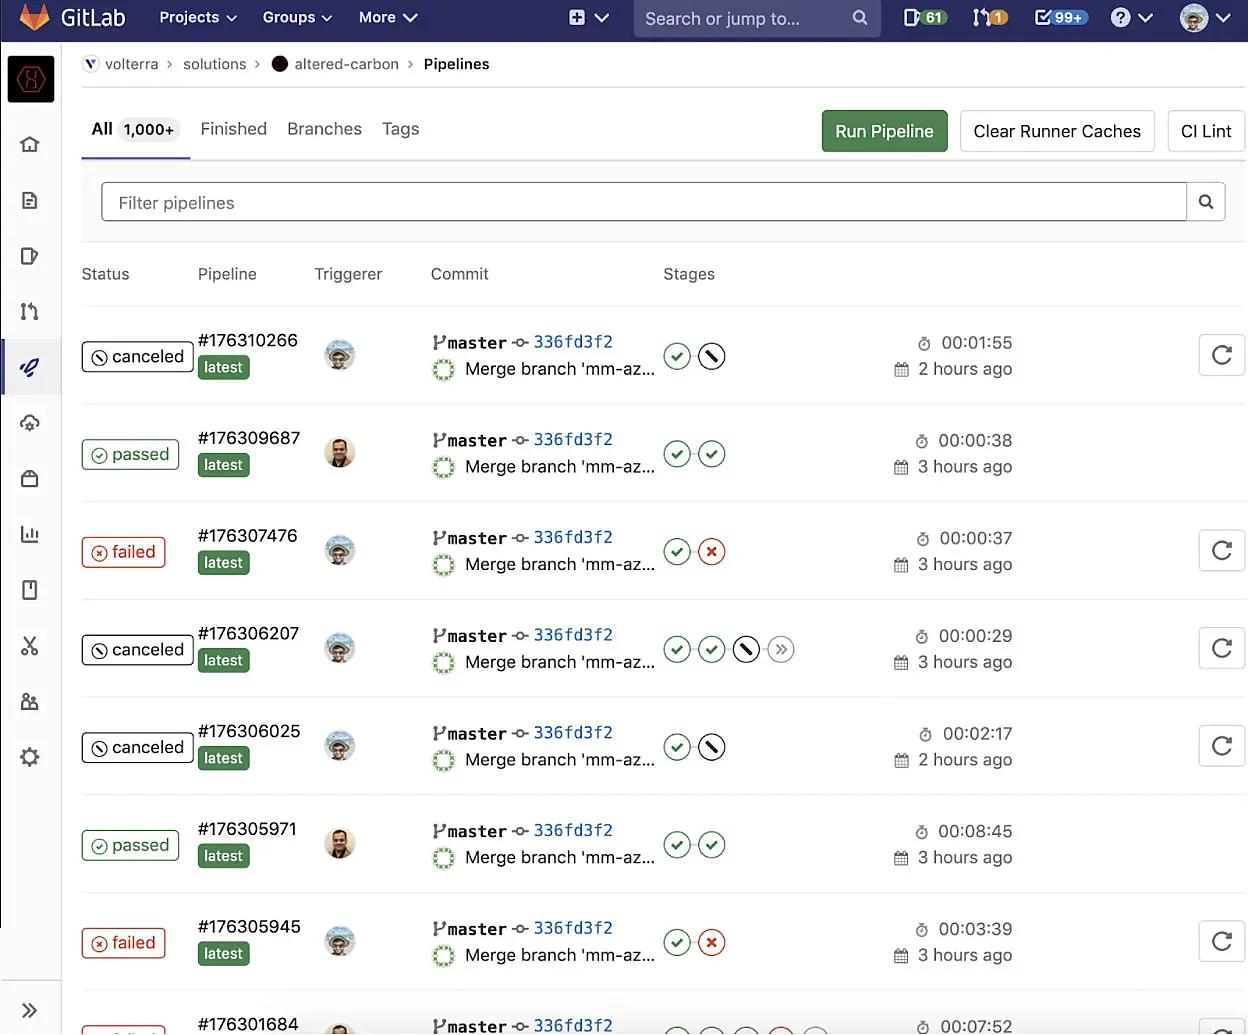
In dieser Ansicht können wir nicht erkennen, welchen STACK oder SLEEVE eine einzelne Pipeline ändert, ohne jede Pipeline einzeln aufzurufen. Wenn täglich Hunderte von Pipelines ausgeführt werden, kann es mühsam sein, den konkreten Pipeline-Lauf zu finden, der einen bestimmten STACK erstellt oder gelöscht hat, oder bestimmte Details zu diesem STACK ausfindig zu machen. Um dieses Problem bereits in einer frühen Phase der AC-Entwicklung zu lösen, haben wir ein einfaches Protokollierungssystem hinzugefügt. Vor jeder Pipeline wurde ein Job namens stack-records ausgeführt. Dieser Job erfasste bei der Erstellung Details zum Stack und erzeugte eine JSON-Datei, die in unseren S3-Speicher-Bucket hochgeladen wurde, in dem auch unsere tfstate-Sicherungen gespeichert werden. Nachfolgend sehen wir ein Beispiel für einen Stack-Datensatz:
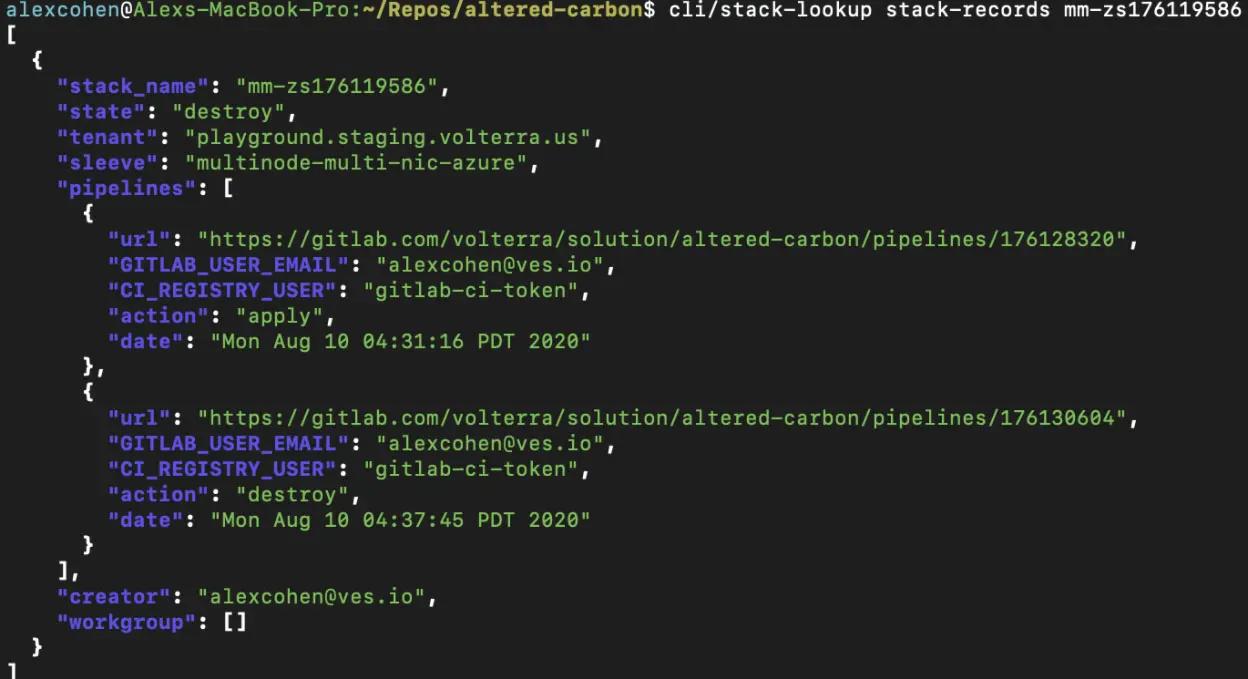
Die stack-record.json-Dateien enthalten Details zu jedem Stack, darunter:
- Welche Volterra-Mandantenumgebung verwendet wurde.
- Welche SLEEVE wurde verwendet?
- Ob der STACK derzeit im Status „apply“ ausgeführt wurde oder ob seine Ressourcen im Status „destroy“ entfernt wurden.
- Welcher GitLab-Benutzer den Stack erstellt hat.
- Eine Arbeitsgruppe, in der weitere Benutzer aufgeführt sind, die berechtigt sind, einen STACK zu ändern.
- Und am wichtigsten: ein Pipelines-Array, das die Web-URL jedes Pipeline-Laufs enthält, der für den Stack ausgeführt wurde, sowie Angaben dazu, wer die Pipeline ausgelöst hat, ob sie einen Stack bereitgestellt oder entfernt hat und wann sie ausgelöst wurde.
Damit stand ein protokollierter Verlauf aller Pipeline-URLs zur Verfügung, die einem bestimmten Stack zugeordnet waren. Um den Prozess weiter zu vereinfachen, wurde außerdem ein einfaches CLI-Skript erstellt, das über S3-API-Aufrufe auf diese Dateien zugreifen konnte. Unsere AC-Nutzer konnten anhand dieser Dokumente den Verlauf der Stacks nachverfolgen und in den Stack-Datensätzen einsehen, wann die Stacks geändert wurden.
Mithilfe von Stack-Datensätzen konnten wir außerdem bestimmte Stufen der Benutzerkontrolle und Fehlererkennung für die von uns bereitgestellten Pipelines implementieren. Beispielsweise zwang uns eine nach der Entwicklung von AC vorgenommene Änderung an der Volterra-Software dazu, die Namen von Site-Clustern (ein vom Wert STACKNAME abgeleiteter Wert), die bei der Erstellung von Volterra-Sites verwendet werden, auf 17 Zeichen zu begrenzen. Daher ergänzten wir den Job für Stack-Datensätze um eine Prüfung, durch die Pipelines noch vor der Ausführung jeglicher Bereitstellungsschritte fehlschlagen, wenn STACKNAME die Zeichenbegrenzung überschreitet. Darüber hinaus wurden weitere benutzerdefinierte Kontrollen hinzugefügt, darunter Benutzerberechtigungsstufen in AC, die festlegen, welche Benutzer bestimmte von AC verwaltete Stacks ändern dürfen.
- Berechtigungen auf Admin-Ebene, mit denen die beiden leitenden Entwickler von AC zu Debugging-Zwecken jeden Stack erstellen oder löschen können. – Die Ebene „Owner“ bzw. „Creator“ ist für einen GitLab-Benutzer vorgesehen, der ursprünglich einen STACK erstellt. Seine GitLab-E-Mail-Adresse wird in den Stack-Datensätzen als Ersteller hinterlegt, und er kann einen Stack erstellen oder löschen.
- Dann gibt es Berechtigungen auf Arbeitsgruppenebene. Die E-Mail-Adresse des GitLab-Benutzers kann dem Arbeitsgruppen-Array des Stack-Datensatzes hinzugefügt werden, sodass auch andere Benutzer als der Ersteller einen STACK anwenden oder löschen können.
- Ein Benutzer ohne eine dieser Berechtigungsstufen kann einen Stack nicht ändern. Versucht ein solcher Benutzer, einen Stack zu ändern, für den er keine Berechtigung besitzt, schlägt der stack-records-Job fehl, bevor Ressourcen bereitgestellt werden.
Interne Nutzung und aktuelle Testabdeckung
Heute ist AC zu einem zentralen Bestandteil des Solutions-Teams geworden und übernimmt den Großteil unserer Regressionstests und Automatisierungsaufgaben. Es wird hauptsächlich für Smoke-Tests im Rahmen von Regressionstests, Skalierungstests, Tests der Produktabrechnung sowie für vereinfachte Bereitstellungen bei Produktdemos eingesetzt.
Die automatisierten Bereitstellungen kommen vor allem bei unseren nächtlichen Regressionstests zum Einsatz. Jede Nacht testen wir jeden unserer SLEEVES in einer Produktions- und einer Staging-Umgebung, indem wir eine Bereitstellung auslösen und anschließend die erstellten Ressourcen wieder entfernen. Wenn Änderungen auftreten, können wir sie schnell erkennen und Fehlerberichte einreichen, um unsere Anleitungen zu aktualisieren. Unsere aktuelle Testabdeckung umfasst:
- Sicheres Kubernetes-Gateway.
- Webanwendungssicherheit.
- Network-Edge-Anwendungen, die unsere standardmäßige „hipster-co“-Anwendung mit 10 Pods sowie eine schlankere Anwendung mit nur einem Pod bereitstellen.
- Hallo Cloud.
- CE-Volterra-Standorte mit einem einzelnen Knoten und einer einzelnen Netzwerkschnittstelle in AWS, GCP, Azure, VSphere und KVM/Vagrant.
- CE-Volterra-Standorte mit einem einzelnen Knoten und zwei Netzwerkschnittstellen in AWS, GCP, Azure, VSphere und KVM/Vagrant.
- Skalierte Bereitstellungen von Volterra-Standorten mit einem einzelnen CE-Knoten und einer einzelnen Netzwerkschnittstelle (unter Verwendung von GCP, VSphere und KVM), wobei mehrere CE-Standorte mit einem einzelnen Knoten und einer einzelnen Netzwerkkarte erstellt wurden, um die Skalierbarkeit von Volterra zu testen.
- CE-Volterra-Standorte mit einem einzelnen Knoten und mehreren Netzwerkschnittstellen in AWS, GCP, Azure, VSphere und KVM/Vagrant.
- CE-Volterra-Standorte mit mehreren Knoten und einer einzelnen Netzwerkschnittstelle in AWS, GCP, Azure, VSphere und KVM/Vagrant.
- CE-Volterra-Standorte mit mehreren Knoten und mehreren Netzwerkschnittstellen in AWS, GCP, Azure, VSphere und KVM/Vagrant.
Darüber hinaus verfügen wir über spezielle Skalierungstest-Suites, die die gleichzeitige Bereitstellung von bis zu 400 Sites automatisieren, um die Skalierbarkeit der Volterra-Software zu testen. Diese Suites wurden mit GCP, vSphere und KVM getestet.
Die schnelle automatisierte Bereitstellung von Anwendungsfällen ermöglicht es den Mitgliedern des Lösungsteams, sich auf andere Aufgaben zu konzentrieren, und steigert so die interne Effizienz. Das Lösungsteam nutzt AC häufig, um Dutzende von KVM-, GCP- und vSphere-Standorten für die Aufzeichnung von Videodemos bereitzustellen. Dadurch sparen wir Zeit bei der Erstellung von Volterra-Standorten, die als Grundlage für komplexere Infrastrukturen dienen, und bauen auf der bereits vorhandenen Automatisierung auf. Dies wird auch für tägliche Cronjobs verwendet, die die Abrechnungsfunktionen der Volterra-Plattform testen, indem sie die Bereitstellung von Anwendungsfällen für AWS, Webanwendungssicherheit, sichere Kubernetes-Gateways und Network-Edge-Anwendungen auf einem speziellen Volterra-Mandanten automatisieren, der Abrechnungsinformationen erfasst.
Zukünftige Pläne und Roadmap
Unser Einsatz von AC führt bereits zu sehr guten Ergebnissen, und in naher Zukunft sollen dem Projekt noch viele weitere Funktionen und Verbesserungen hinzugefügt werden.
Die größte Erweiterung des Projekts besteht darin, fortlaufend neue SLEEVE-Optionen hinzuzufügen, um weitere Bereitstellungsszenarien abzudecken. Für jede neu hinzugefügte SLEEVE ergänzen wir unsere nächtlichen Smoke-Regressionstests um einen neuen Job und erhöhen so die Testabdeckung für Projekte zur Lösungsbereitstellung. Die meisten bisherigen SLEEVEs konzentrierten sich auf Anwendungsfälle mit einem einzelnen Knoten und einer einzelnen Netzwerkschnittstelle. Kürzlich haben wir unsere SLEEVE-Abdeckung jedoch auf Volterra-Standortcluster mit mehreren Knoten sowie auf Anwendungsfälle mit mehreren Netzwerkschnittstellen auf den Plattformen AWS, Azure, GCP, VMWare und KVM/Vagrant ausgeweitet.
Wir möchten außerdem unser System für Stack-Datensätze verbessern. Dazu werden wir den Detaillierungsgrad unserer AC-Datensätze erhöhen und durch die Einbindung von RDS-Datenbankspeichern für unsere Datensätze erweiterte Suchfunktionen hinzufügen. Unser Ziel ist es, schnellere Suchvorgänge in unserer AC-Umgebung sowie gezieltere Suchmöglichkeiten zu ermöglichen, etwa die Suche nach Stacks anhand ihres Status, ihrer Ersteller usw. Ebenfalls auf unserer Roadmap steht die Entwicklung einer benutzerdefinierten Benutzeroberfläche auf Basis dieser Datensätze, um mit AC erstellte Deployments effizienter zu visualisieren.
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...