Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways (dieser Artikel)
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“. Werfen Sie auch einen Blick auf die neue Lösungsseite für Microservices.
Der erste Artikel dieser siebenteiligen Reihe über das Entwerfen, Erstellen und Bereitstellen von Microservices stellte das Architekturmuster für Microservices vor. Er erläuterte die Vor- und Nachteile des Einsatzes von Microservices und zeigte auf, warum sie trotz ihrer Komplexität in der Regel die ideale Wahl für komplexe Anwendungen sind. Dies ist der zweite Artikel der Reihe. Er befasst sich mit der Erstellung von Microservices mithilfe eines API-Gateways.
Wenn Sie sich dafür entscheiden, Ihre Anwendung als eine Reihe von Microservices zu entwickeln, müssen Sie festlegen, wie die Clients Ihrer Anwendung mit den Microservices interagieren sollen. Bei einer monolithischen Anwendung gibt es nur eine Gruppe von Endpunkten, die in der Regel repliziert sind und deren Last verteilt wird. In einer Microservices-Architektur stellt hingegen jeder Microservice eine Reihe von üblicherweise feingranularen Endpunkten bereit. In diesem Artikel untersuchen wir, wie sich dies auf die Kommunikation zwischen Client und Anwendung auswirkt, und stellen einen Ansatz vor, der ein API-Gateway verwendet.
Einleitung
Stellen wir uns vor, Sie entwickeln einen nativen mobilen Client für eine Shopping-App. Wahrscheinlich müssen Sie eine Produktdetailseite implementieren, auf der Informationen zu einem bestimmten Produkt angezeigt werden.
Das folgende Diagramm zeigt beispielsweise, was Sie sehen, wenn Sie in der Android-App von Amazon durch die Produktdetails scrollen.
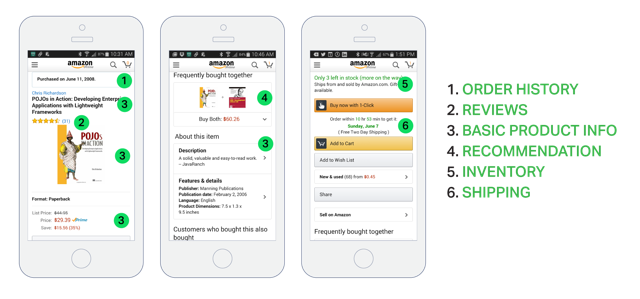
Obwohl es sich um eine Smartphone-App handelt, werden auf der Produktdetailseite zahlreiche Informationen angezeigt. Neben grundlegenden Produktinformationen (wie Name, Beschreibung und Preis) enthält diese Seite beispielsweise auch:
- Anzahl der Artikel im Warenkorb
- Bestellverlauf
- Kundenbewertungen
- Warnung bei niedrigem Lagerbestand
- Versandoptionen
- Verschiedene Empfehlungen, darunter andere Produkte, die häufig zusammen mit diesem Produkt gekauft werden, andere Produkte, die von Kunden gekauft wurden, die dieses Produkt gekauft haben, sowie andere Produkte, die von Kunden angesehen wurden, die dieses Produkt gekauft haben
- Alternative Kaufoptionen
Bei Verwendung einer monolithischen Anwendungsarchitektur würde ein mobiler Client diese Daten mit einem einzigen REST-Aufruf (GET api.company.com/productdetails/productId) an die Anwendung abrufen. Ein Load Balancer leitet die Anfrage an eine von N identischen Anwendungsinstanzen weiter. Die Anwendung würde anschließend verschiedene Datenbanktabellen abfragen und die Antwort an den Client zurückgeben.
Im Gegensatz dazu gehören die auf der Produktdetailseite angezeigten Daten bei einer Microservices-Architektur mehreren Microservices. Im Folgenden sind einige der möglichen Microservices aufgeführt, denen die auf der beispielhaften Produktdetailseite angezeigten Daten gehören:
- Warenkorbservice – Anzahl der Artikel im Warenkorb
- Bestellservice – Bestellverlauf
- Katalogdienst – Grundlegende Produktinformationen wie Name, Bild und Preis
- Bewertungsservice – Kundenbewertungen
- Bestandsservice – Warnung bei niedrigem Lagerbestand
- Versandservice – Versandoptionen, Lieferfristen und Kosten, die separat über die API des Versanddienstleisters abgerufen werden
- Empfehlungsdienst(e) – Vorgeschlagene Artikel
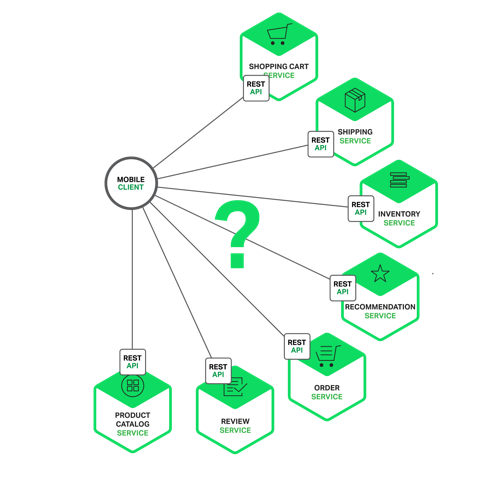
Wir müssen entscheiden, wie der mobile Client auf diese Dienste zugreift. Sehen wir uns die Optionen an.
Direkte Kommunikation zwischen Client und Microservice
Theoretisch könnte ein Client Anfragen direkt an jeden einzelnen Microservice senden. Jeder Microservice hätte einen öffentlichen Endpunkt (https://serviceName.api.company.name). Diese URL würde auf den Load Balancer des Microservices verweisen, der die Anfragen auf die verfügbaren Instanzen verteilt. Um die Produktdetails abzurufen, würde der mobile Client Anfragen an jeden der oben aufgeführten Services senden.
Leider bringt diese Option einige Herausforderungen und Einschränkungen mit sich. Ein Problem besteht darin, dass die Anforderungen des Clients nicht zu den feingranularen APIs passen, die von den einzelnen Microservices bereitgestellt werden. Der Client muss in diesem Beispiel sieben separate Anfragen stellen. Bei komplexeren Anwendungen könnten es noch wesentlich mehr sein. Amazon beschreibt beispielsweise, dass Hunderte von Services am Aufbau seiner Produktseite beteiligt sind. Während ein Client eine solche Anzahl von Anfragen über ein LAN stellen könnte, wäre dies über das öffentliche Internet wahrscheinlich zu ineffizient und über ein Mobilfunknetz definitiv nicht praktikabel. Dieser Ansatz macht außerdem den Clientcode deutlich komplexer.
Ein weiteres Problem beim direkten Aufruf der Microservices durch den Client besteht darin, dass einige möglicherweise Protokolle verwenden, die nicht für das Web geeignet sind. Ein Dienst könnte binäre RPC-Aufrufe über Thrift verwenden, während ein anderer Dienst das Messaging-Protokoll AMQP nutzt. Keines der beiden Protokolle ist besonders browser- oder firewallfreundlich; sie eignen sich daher am besten für den internen Einsatz. Außerhalb der Firewall sollte eine Anwendung Protokolle wie HTTP und WebSocket verwenden.
Ein weiterer Nachteil dieses Ansatzes besteht darin, dass er die Umstrukturierung der Microservices erschwert. Im Laufe der Zeit möchten wir möglicherweise ändern, wie das System in Services aufgeteilt ist. Beispielsweise könnten wir zwei Services zusammenführen oder einen Service in zwei oder mehr Services aufteilen. Wenn Clients jedoch direkt mit den Services kommunizieren, kann eine solche Umstrukturierung äußerst schwierig sein.
Aufgrund solcher Probleme ist es nur selten sinnvoll, dass Clients direkt mit Microservices kommunizieren.
Verwendung eines API-Gateways
In der Regel ist es wesentlich besser, ein sogenanntes API-Gateway zu verwenden. Ein API-Gateway ist ein Server, der als zentraler Einstiegspunkt in das System dient. Es ähnelt dem Fassaden-Entwurfsmuster aus der objektorientierten Softwareentwicklung. Das API-Gateway kapselt die interne Systemarchitektur und stellt eine auf den jeweiligen Client zugeschnittene API bereit. Es kann außerdem weitere Aufgaben übernehmen, etwa Authentifizierung, Überwachung, Lastverteilung, Caching, Aufbereitung und Verwaltung von Anfragen sowie die Verarbeitung statischer Antworten.
Das folgende Diagramm zeigt, wie ein API Gateway typischerweise in die Architektur eingebunden ist:
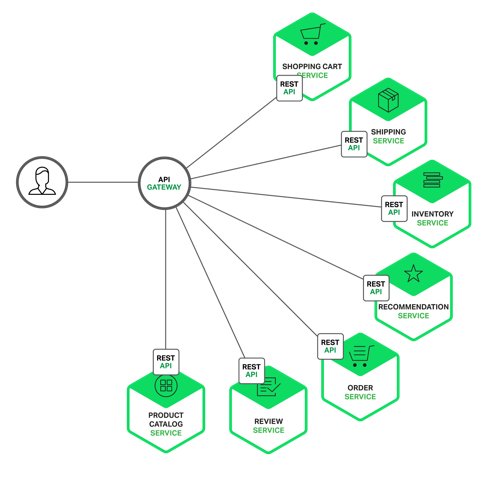
Das API-Gateway ist für die Weiterleitung und Zusammenführung von Anfragen sowie für die Protokollübersetzung zuständig. Alle Anfragen von Clients durchlaufen zunächst das API-Gateway. Anschließend leitet es die Anfragen an den entsprechenden Microservice weiter. Häufig verarbeitet das API-Gateway eine Anfrage, indem es mehrere Microservices aufruft und deren Ergebnisse zusammenführt. Es kann zwischen Webprotokollen wie HTTP und WebSocket und intern verwendeten, nicht webkompatiblen Protokollen übersetzen.
Das API Gateway kann außerdem jedem Client eine individuelle API bereitstellen. In der Regel stellt es mobilen Clients eine grobgranulare API zur Verfügung. Betrachten wir beispielsweise das Szenario mit den Produktdetails. Das API Gateway kann einen Endpunkt (/productdetails?productid=xxx) bereitstellen, über den ein mobiler Client sämtliche Produktdetails mit einer einzigen Anfrage abrufen kann. Das API Gateway verarbeitet die Anfrage, indem es die verschiedenen Dienste – Produktinformationen, Empfehlungen, Rezensionen usw. – aufruft und die Ergebnisse zusammenführt.
Ein hervorragendes Beispiel für ein API-Gateway ist das Netflix API-Gateway. Der Streamingdienst von Netflix ist auf Hunderten verschiedener Gerätetypen verfügbar, darunter Fernseher, Set-Top-Boxen, Smartphones, Spielkonsolen, Tablets usw. Anfangs versuchte Netflix, eine Universallösung als API für seinen Streamingdienst anzubieten. Aufgrund der großen Gerätevielfalt und der jeweils unterschiedlichen Anforderungen stellte sich jedoch heraus, dass dieser Ansatz nicht gut funktionierte. Heute verwendet Netflix ein API-Gateway, das durch die Ausführung gerätespezifischen Adaptercodes eine auf das jeweilige Gerät zugeschnittene API bereitstellt. Ein Adapter verarbeitet eine Anfrage in der Regel, indem er durchschnittlich sechs bis sieben Backend-Dienste aufruft. Das Netflix API-Gateway verarbeitet täglich Milliarden von Anfragen.
Vor- und Nachteile eines API-Gateways
Wie zu erwarten, hat die Verwendung eines API-Gateways sowohl Vor- als auch Nachteile. Ein wesentlicher Vorteil eines API-Gateways besteht darin, dass es die interne Struktur der Anwendung kapselt. Anstatt bestimmte Dienste aufrufen zu müssen, kommunizieren Clients einfach mit dem Gateway. Das API-Gateway stellt für jeden Clienttyp eine spezifische API bereit. Dadurch verringert sich die Anzahl der Anfragen und Antworten zwischen Client und Anwendung. Außerdem wird der Clientcode vereinfacht.
Das API Gateway hat jedoch auch einige Nachteile. Es ist eine weitere hochverfügbare Komponente, die entwickelt, bereitgestellt und verwaltet werden muss. Zudem besteht die Gefahr, dass das API Gateway zu einem Engpass im Entwicklungsprozess wird. Entwickler müssen das API Gateway aktualisieren, um die Endpunkte der einzelnen Microservices bereitzustellen. Daher ist es wichtig, den Aktualisierungsprozess für das API Gateway so schlank wie möglich zu gestalten. Andernfalls müssen Entwickler warten, bis sie mit der Aktualisierung des Gateways an der Reihe sind. Trotz dieser Nachteile ist der Einsatz eines API Gateways für die meisten realen Anwendungen sinnvoll.
Implementierung eines API-Gateways
Nachdem wir uns nun mit den Beweggründen und den Vor- und Nachteilen der Verwendung eines API Gateways befasst haben, betrachten wir verschiedene Designaspekte, die Sie berücksichtigen sollten.
Leistung und Skalierbarkeit
Nur eine Handvoll Unternehmen arbeitet in einer Größenordnung wie Netflix und muss Milliarden von Anfragen pro Tag verarbeiten. Für die meisten Anwendungen sind die Leistung und Skalierbarkeit des API Gateways jedoch in der Regel sehr wichtig. Daher ist es sinnvoll, das API Gateway auf einer Plattform aufzubauen, die asynchrone, nicht blockierende E/A unterstützt. Für die Implementierung eines skalierbaren API Gateways stehen verschiedene Technologien zur Verfügung. Auf der JVM können Sie eines der NIO-basierten Frameworks wie Netty, Vertx, Spring Reactor oder JBoss Undertow verwenden. Eine beliebte Option außerhalb der JVM ist Node.js, eine Plattform, die auf der JavaScript-Engine von Chrome basiert. Eine weitere Möglichkeit ist der Einsatz von NGINX Plus. NGINX Plus bietet einen ausgereiften, skalierbaren und leistungsstarken Webserver und Reverse-Proxy, der sich einfach bereitstellen, konfigurieren und programmieren lässt. NGINX Plus kann die Authentifizierung, die Zugriffskontrolle, den Lastenausgleich von Anfragen und das Zwischenspeichern von Antworten übernehmen und bietet anwendungsbezogene Zustandsprüfungen und Überwachungsfunktionen.
Verwendung eines reaktiven Programmiermodells
Das API Gateway verarbeitet einige Anfragen, indem es sie einfach an den entsprechenden Backend-Dienst weiterleitet. Andere Anfragen verarbeitet es, indem es mehrere Backend-Dienste aufruft und die Ergebnisse zusammenführt. Bei manchen Anfragen, etwa einer Anfrage nach Produktdetails, sind die Anfragen an die Backend-Dienste voneinander unabhängig. Um die Antwortzeit zu minimieren, sollte das API Gateway unabhängige Anfragen gleichzeitig ausführen. Manchmal bestehen jedoch Abhängigkeiten zwischen den Anfragen. So muss das API Gateway die Anfrage möglicherweise zunächst durch den Aufruf eines Authentifizierungsdienstes validieren, bevor es sie an einen Backend-Dienst weiterleitet. Um Informationen über die Produkte auf der Wunschliste eines Kunden abzurufen, muss das API Gateway zunächst das Kundenprofil mit diesen Angaben und anschließend die Informationen zu den einzelnen Produkten abrufen. Ein weiteres interessantes Beispiel für die API-Komposition ist das Netflix Video Grid.
Wenn Sie Code für die API-Komposition mit dem herkömmlichen Ansatz asynchroner Callbacks schreiben, landen Sie schnell in der Callback-Hölle. Der Code wird unübersichtlich, schwer verständlich und fehleranfällig. Ein wesentlich besserer Ansatz besteht darin, den Code für das API Gateway mithilfe eines reaktiven Ansatzes in einem deklarativen Stil zu schreiben. Beispiele für reaktive Abstraktionen sind Future in Scala, CompletableFuture in Java 8 und Promise in JavaScript. Darüber hinaus gibt es Reactive Extensions (auch Rx oder ReactiveX genannt), die ursprünglich von Microsoft für die .NET-Plattform entwickelt wurden. Netflix entwickelte RxJava für die JVM speziell für den Einsatz in seinem API Gateway. Außerdem gibt es RxJS für JavaScript, das sowohl im Browser als auch in Node.js ausgeführt werden kann. Mit einem reaktiven Ansatz können Sie einfachen und zugleich effizienten Code für das API Gateway schreiben.
Dienstaufruf
Eine auf Microservices basierende Anwendung ist ein verteiltes System und muss einen Mechanismus für die Interprozesskommunikation verwenden. Es gibt zwei Arten der Interprozesskommunikation. Eine Möglichkeit ist ein asynchroner, nachrichtenbasierter Mechanismus. Einige Implementierungen verwenden einen Message Broker wie JMS oder AMQP. Andere, wie Zeromq, kommen ohne Broker aus, sodass die Dienste direkt miteinander kommunizieren. Die andere Art der Interprozesskommunikation ist ein synchroner Mechanismus wie HTTP oder Thrift. Ein System verwendet in der Regel sowohl asynchrone als auch synchrone Kommunikationsarten. Möglicherweise kommen sogar mehrere Implementierungen der jeweiligen Art zum Einsatz. Daher muss das API-Gateway eine Vielzahl von Kommunikationsmechanismen unterstützen.
Serviceerkennung
Das API-Gateway muss den Standort (IP-Adresse und Port) jedes Microservices kennen, mit dem es kommuniziert. In einer herkömmlichen Anwendung könnten die Standorte wahrscheinlich fest einprogrammiert werden, doch in einer modernen, cloudbasierten Microservices-Anwendung ist dies keine triviale Aufgabe. Infrastrukturdienste wie ein Message Broker haben in der Regel einen statischen Standort, der über Betriebssystem-Umgebungsvariablen angegeben werden kann. Den Standort eines Anwendungsdienstes zu ermitteln, ist jedoch nicht so einfach. Anwendungsdiensten werden ihre Standorte dynamisch zugewiesen. Außerdem ändert sich die Menge der Instanzen eines Dienstes aufgrund von automatischer Skalierung und Upgrades dynamisch. Daher muss das API-Gateway wie jeder andere Dienst-Client im System den Service-Discovery-Mechanismus des Systems verwenden: entweder serverseitige Service Discovery oder clientseitige Service Discovery. In einem späteren Artikel wird Service Discovery ausführlicher beschrieben. Zunächst ist festzuhalten, dass das API-Gateway bei Verwendung von clientseitiger Service Discovery in der Lage sein muss, die Service Registry abzufragen, eine Datenbank mit allen Microservice-Instanzen und ihren Standorten.
Umgang mit Teilausfällen
Ein weiteres Problem, das Sie bei der Implementierung eines API-Gateways berücksichtigen müssen, sind Teilausfälle. Dieses Problem tritt in allen verteilten Systemen auf, wenn ein Dienst einen anderen Dienst aufruft, der entweder langsam reagiert oder nicht verfügbar ist. Das API-Gateway sollte niemals unbegrenzt blockieren, während es auf einen nachgelagerten Dienst wartet. Wie es mit dem Ausfall umgeht, hängt jedoch vom jeweiligen Szenario und davon ab, welcher Dienst ausgefallen ist. Wenn beispielsweise der Empfehlungsdienst beim Abrufen der Produktdetails nicht reagiert, sollte das API-Gateway die übrigen Produktdetails an den Client zurückgeben, da sie für den Benutzer weiterhin nützlich sind. Die Empfehlungen könnten entweder leer bleiben oder beispielsweise durch eine fest hinterlegte Top-10-Liste ersetzt werden. Wenn hingegen der Produktinformationsdienst nicht reagiert, sollte das API-Gateway eine Fehlermeldung an den Client zurückgeben.
Das API Gateway könnte auch zwischengespeicherte Daten zurückgeben, sofern diese verfügbar sind. Da sich beispielsweise Produktpreise nur selten ändern, könnte das API Gateway zwischengespeicherte Preisdaten zurückgeben, wenn der Preisdienst nicht verfügbar ist. Die Daten können entweder vom API Gateway selbst zwischengespeichert oder in einem externen Cache wie Redis oder Memcached abgelegt werden. Durch die Rückgabe von Standarddaten oder zwischengespeicherten Daten stellt das API Gateway sicher, dass Systemausfälle die Benutzererfahrung nicht beeinträchtigen.
Netflix Hystrix ist eine äußerst nützliche Bibliothek zum Schreiben von Code, der Remote-Dienste aufruft. Hystrix bricht Aufrufe ab, die den festgelegten Zeitgrenzwert überschreiten. Es implementiert das Circuit-Breaker-Muster, das verhindert, dass der Client unnötig auf einen nicht reagierenden Dienst wartet. Wenn die Fehlerrate eines Dienstes einen festgelegten Schwellenwert überschreitet, löst Hystrix den Circuit Breaker aus, sodass alle Anfragen für einen bestimmten Zeitraum sofort fehlschlagen. Mit Hystrix können Sie eine Ausweichaktion für den Fall definieren, dass eine Anfrage fehlschlägt, beispielsweise das Lesen aus einem Cache oder die Rückgabe eines Standardwerts. Wenn Sie die JVM verwenden, sollten Sie den Einsatz von Hystrix unbedingt in Betracht ziehen. Wenn Sie in einer Nicht-JVM-Umgebung arbeiten, sollten Sie eine vergleichbare Bibliothek verwenden.
Zusammenfassung
Für die meisten auf Microservices basierenden Anwendungen ist es sinnvoll, ein API-Gateway zu implementieren, das als zentraler Einstiegspunkt in ein System dient. Das API-Gateway ist für die Weiterleitung und Zusammenführung von Anfragen sowie für die Protokollübersetzung zuständig. Es stellt jedem Client der Anwendung eine maßgeschneiderte API bereit. Darüber hinaus kann das API-Gateway Ausfälle der Backend-Dienste kaschieren, indem es zwischengespeicherte Daten oder Standarddaten zurückgibt. Im nächsten Artikel dieser Reihe befassen wir uns mit der Kommunikation zwischen Diensten.
Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways (dieser Artikel)
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Serviceerkennung in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe sowie Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“.
Eine ausführliche Betrachtung weiterer Anwendungsfälle finden Sie in unserer dreiteiligen Blogreihe „NGINX Plus als API-Gateway bereitstellen“:
- Teil 1 enthält detaillierte Konfigurationsanweisungen für verschiedene Anwendungsfälle.
- Teil 2 erweitert diese Anwendungsfälle und befasst sich mit einer Reihe von Schutzmaßnahmen, die zum Schutz und zur Absicherung von Backend-API-Diensten in Produktionsumgebungen eingesetzt werden können.
- Teil 3 erläutert, wie NGINX Plus als API-Gateway für gRPC-Dienste bereitgestellt wird.
Gastautor Chris Richardson ist der Gründer des ursprünglichen Unternehmens CloudFoundry.com, einer frühen Java-PaaS-Plattform (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Blogbeiträge über Microservices unter http://microservices.io.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.