Wie sieht eine KI-Anwendung eigentlich aus? Nachdem wir einige entwickelt haben, ist jetzt ein guter Zeitpunkt, sie in ihre (zahlreichen) Bestandteile zu zerlegen und die betrieblichen Auswirkungen zu untersuchen.
Wir haben bereits untersucht, was bei KI-Anwendungen gleich ist (vieles) und was sich unterscheidet (ebenfalls vieles). Eine KI-Anwendung lässt sich recht einfach als „eine Anwendung, die KI nutzt – entweder prädiktive oder generative“ definieren.
Das stimmt, aber was bedeutet das für diejenigen, die diese neuartigen Anwendungen entwickeln, bereitstellen, ausliefern, absichern und betreiben müssen?
Zum einen bedeutet das neue bewegliche Teile. Und nicht nur Inferenzdienste. Es gibt weitere neue Komponenten, die zunehmend standardmäßig zur Anwendungsarchitektur hinzugefügt werden, etwa Vektordatenbanken. Außerdem bedeutet es eine stärkere Abhängigkeit von APIs.
Außerdem sind die meisten dieser Komponenten containerisiert. Wenn ich ein neues KI-Anwendungsprojekt aufsetze, starte ich einen Container mit PostgreSQL, den ich als Vektordatenspeicher verwende. Dieser unterstützt RAG (Retrieval Augmented Generation), das laut mehreren Branchenberichten von einem erheblichen Anteil der KI-Anwendungen eingesetzt wird (zum Beispiel diesem Bericht von Databricks). Denn so kann ich ein Standard-KI-Modell mit beliebigen Daten erweitern, ohne selbst ein Modell feinabstimmen oder trainieren zu müssen. Für eine beträchtliche Anzahl von Anwendungsfällen ist das die beste Methode, eine KI-Anwendung zu implementieren.
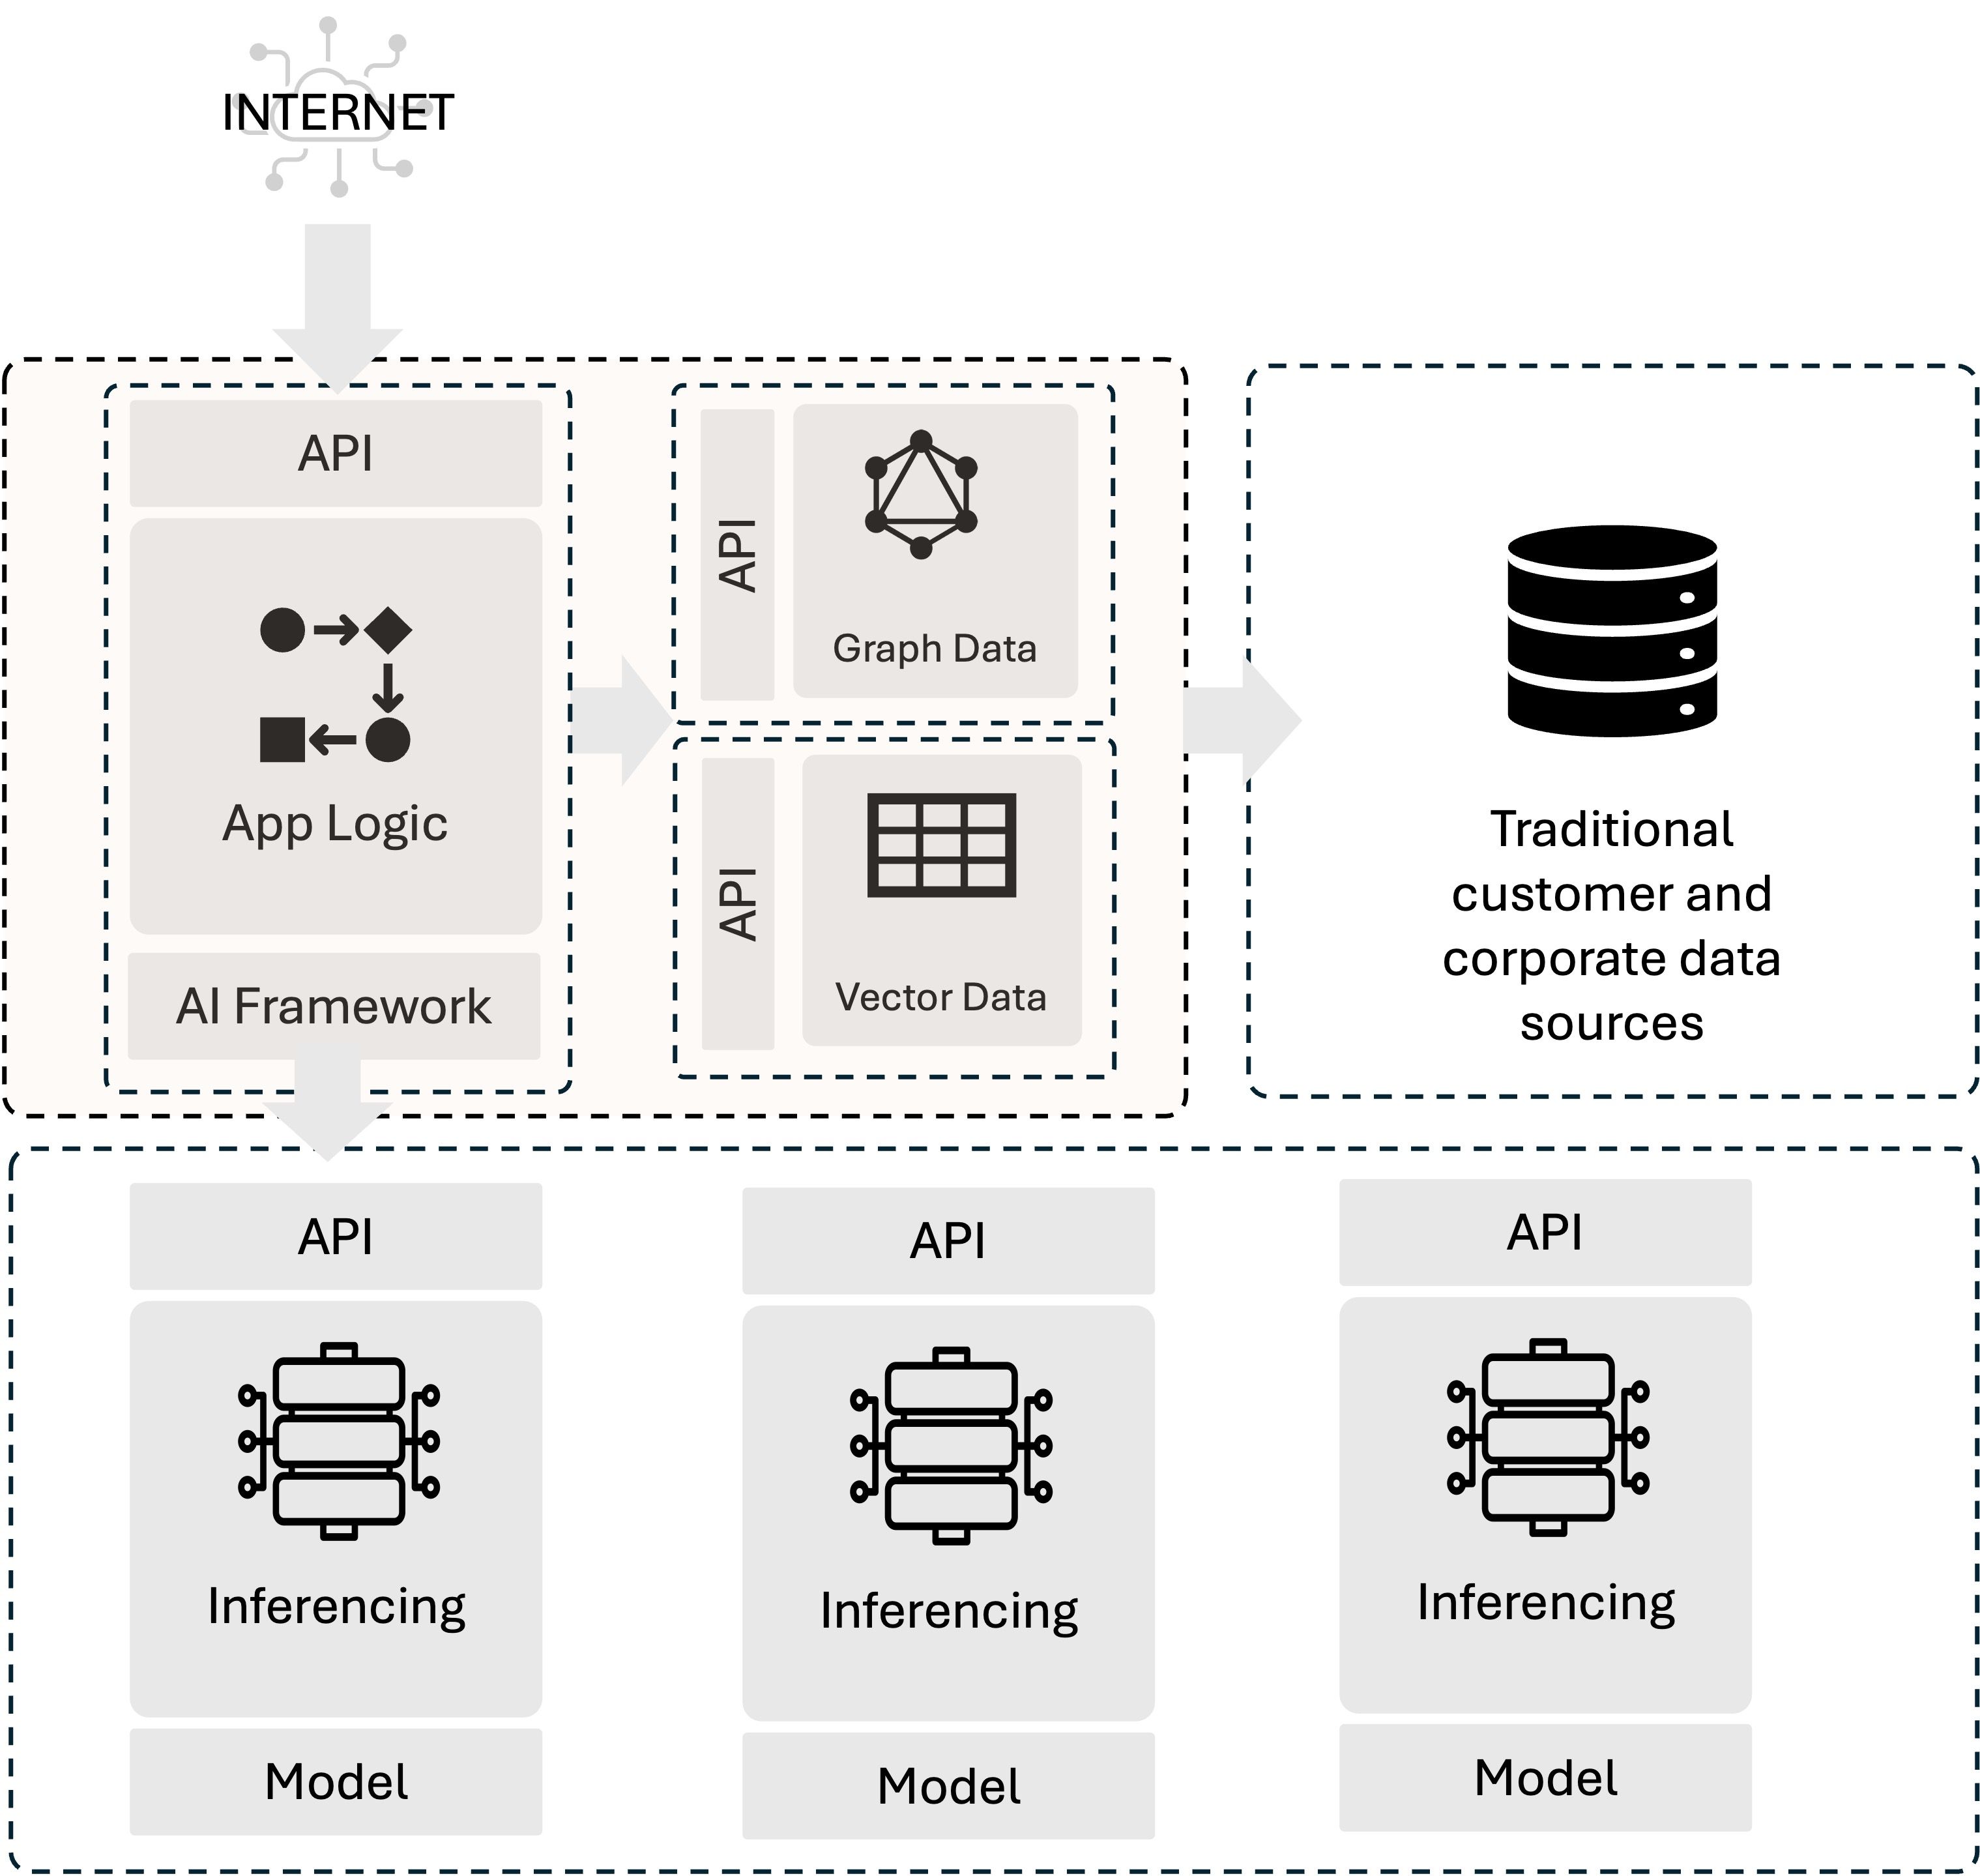
Möglicherweise setze ich auch einen Wissensgraphen ein, in der Regel durch den Betrieb einer containerisierten Graphdatenbank wie Neo4J. Graphdatenbanken sind besonders nützlich bei der Arbeit mit graphorientierten Daten, etwa aus sozialen Netzwerken, Empfehlungssystemen und der Betrugserkennung. Wie sich herausgestellt hat, eignen sie sich auch dazu, Halluzinationen bei der Richtliniengenerierung zu reduzieren, wie wir Anfang des Jahres festgestellt haben. Durch die Einbindung einer Graphdatenbank kann ein neues Protokoll, GraphQL, zur Liste der „neuen Dinge, die abgesichert werden müssen“ hinzukommen.
Dann entscheide ich, welchen Inferenzdienst ich verwenden möchte. Ich habe mehrere Möglichkeiten. Ich könnte einen Dienst eines Cloud-Anbieters oder KI als Dienst (etwa ChatGPT) nutzen oder einen lokalen Dienst betreiben. Für meine jüngsten Experimente habe ich beispielsweise Ollama und phi3 auf meinem MacBook verwendet. In diesem Fall betreibe ich nur eine Instanz des Inferenzservers, denn mehrere Instanzen würden mehr Ressourcen beanspruchen, als mir zur Verfügung stehen. In einer Produktionsumgebung gäbe es natürlich wahrscheinlich mehrere Instanzen, um sicherzustellen, dass die Nachfrage bewältigt werden kann.
Da ich phi3 verwenden werde, wähle ich phidata als Framework für den Zugriff auf den Inferenzdienst. Ich habe auch schon langchain genutzt, wenn ich KI als Dienst in Anspruch genommen habe – eine beliebte Wahl. Die gute Nachricht ist, dass das Framework aus betrieblicher Sicht nicht außerhalb der eigentlichen KI-Kernanwendung ausgeführt wird.
Betriebliche Auswirkungen von KI-Anwendungen
Ich habe noch nicht einmal eine einzige Zeile Code geschrieben, und trotzdem laufen bereits mehrere Komponenten, auf die jeweils über eine API zugegriffen wird und die in eigenen Containern ausgeführt werden. Deshalb gehen wir von der Prämisse aus, dass eine KI-Anwendung eine moderne Anwendung ist und dieselben bekannten Herausforderungen in Bezug auf Bereitstellung, Sicherheit und Betrieb mit sich bringt. Aus diesem Grund sind wir auch davon überzeugt, dass die Bereitstellung von KI-Modellen die Zahl der APIs, die bereitgestellt und abgesichert werden müssen, drastisch erhöhen wird.
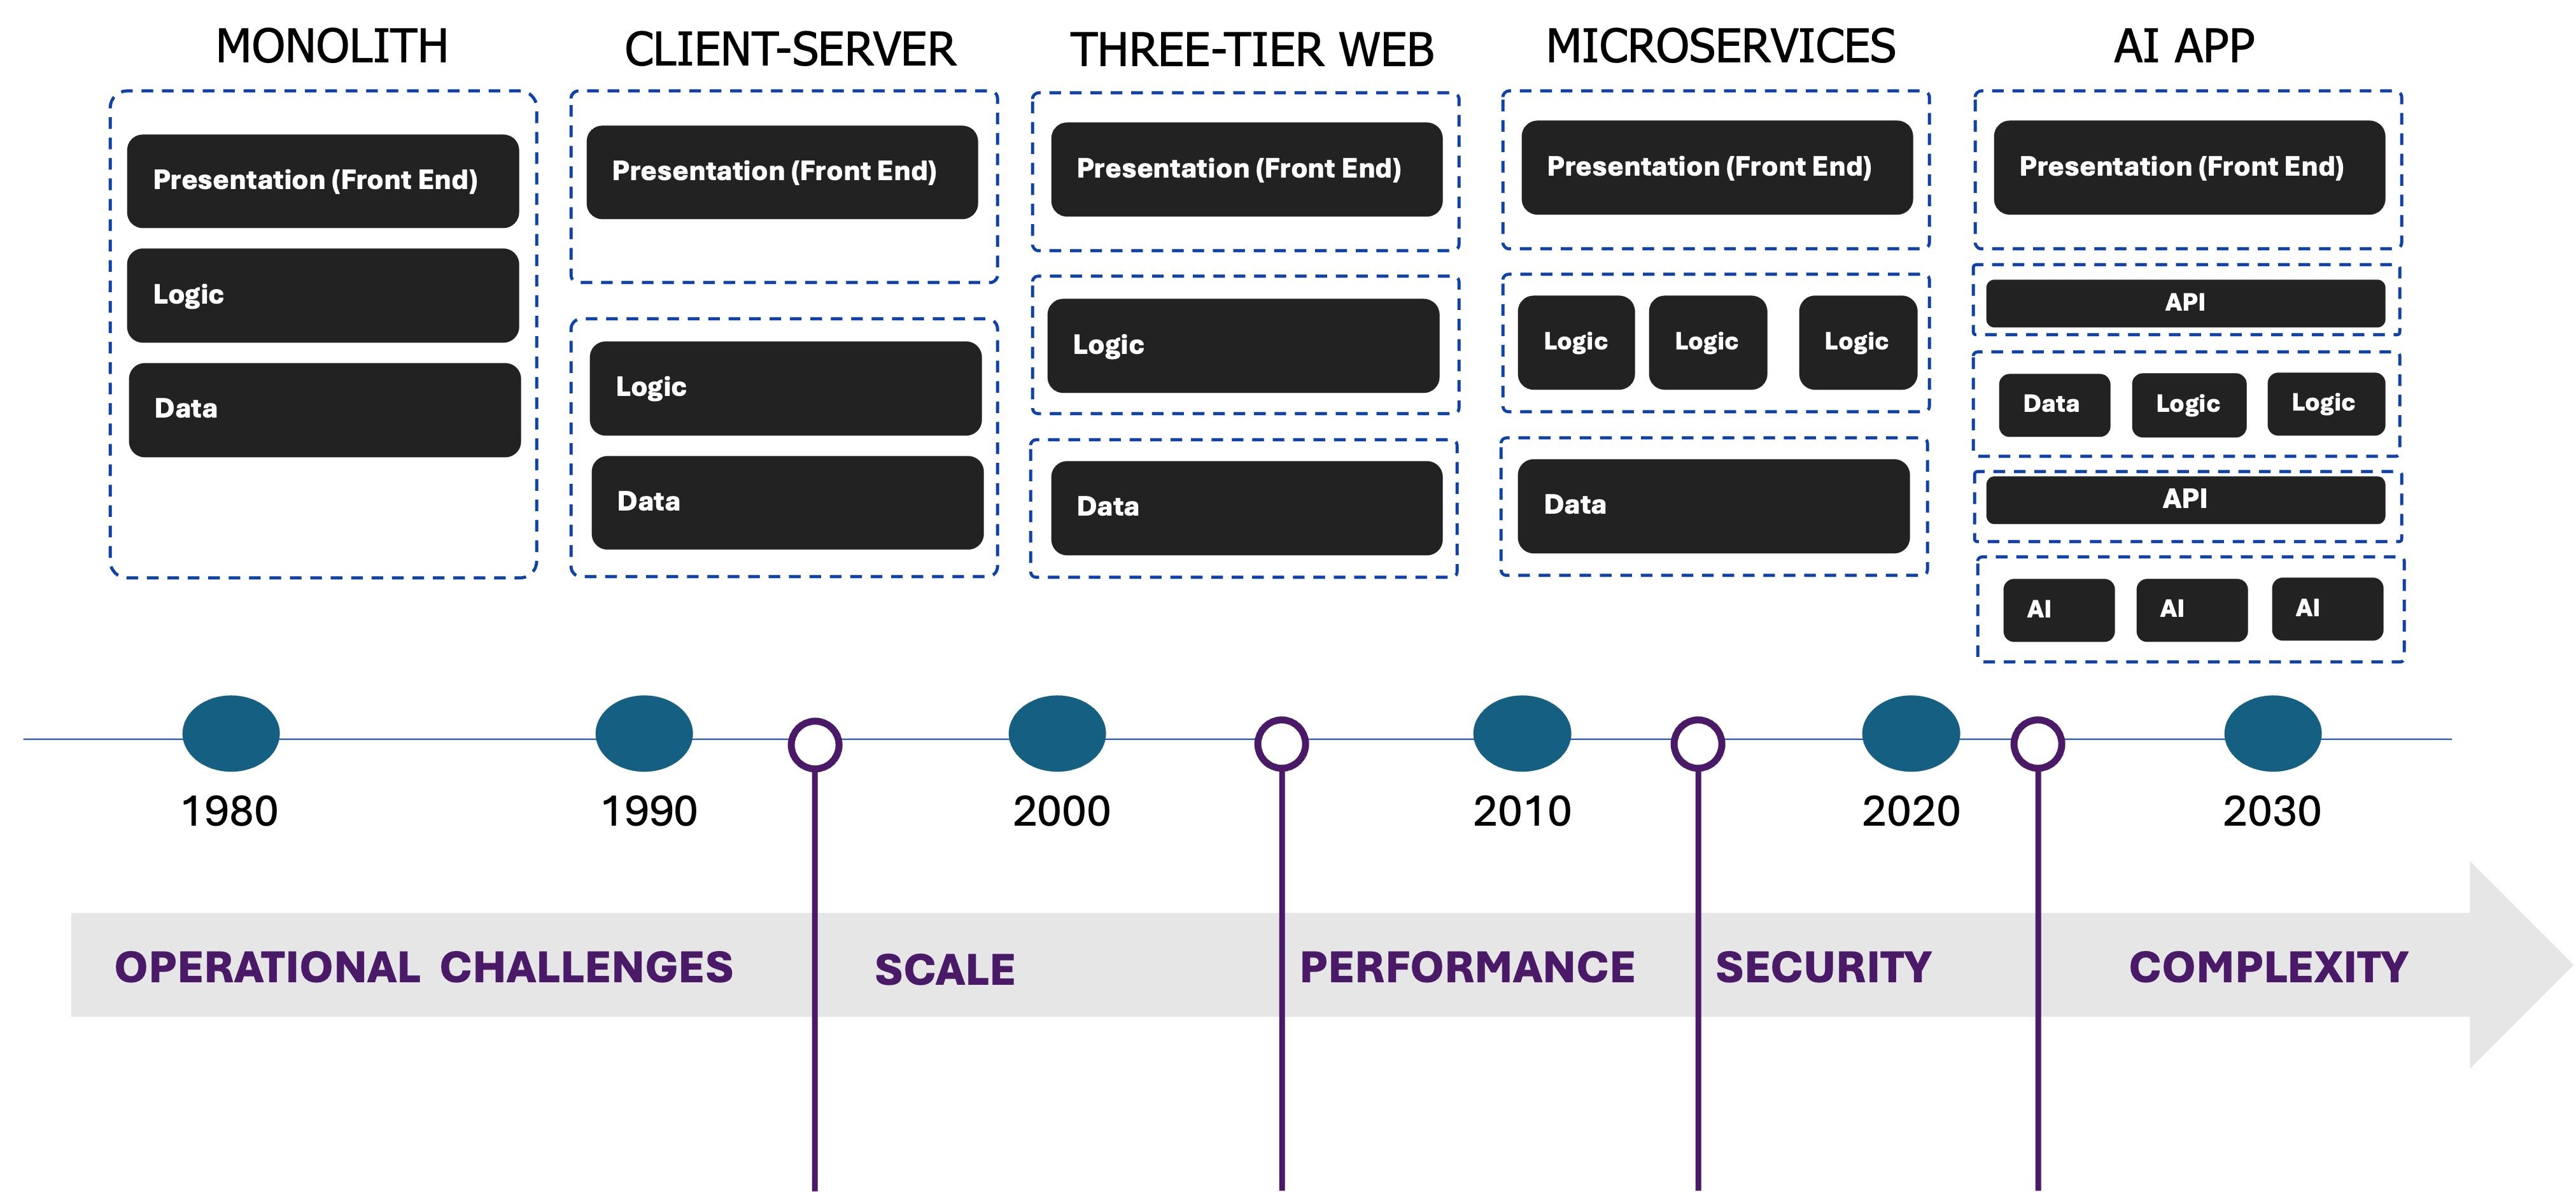
KI-Anwendungen fügen einer bereits komplexen Umgebung eine weitere Ebene hinzu, was die Komplexität natürlich weiter erhöht. Das bedeutet, dass die Architektur von KI-Anwendungen die Belastung sämtlicher Betriebsfunktionen steigern wird – von der Sicherheit über SRE bis hin zum Netzwerk. Jede dieser Komponenten weist zudem ein eigenes Skalierungsprofil auf. Das heißt, einige Komponenten müssen schneller skaliert werden als andere, und auch die Verteilung der Anfragen wird variieren, da die meisten von ihnen unterschiedliche APIs und in manchen Fällen auch unterschiedliche Protokolle nutzen.
Darüber hinaus wird die Architektur von KI-Anwendungen intern sehr unterschiedlich ausfallen. Das heißt, die von mir entwickelte KI-Anwendung wird wahrscheinlich andere lokale Datenverkehrsmerkmale und Anforderungen aufweisen als die von Ihnen entwickelte KI-Anwendung. Und eine größere Heterogenität bedeutet naturgemäß auch eine höhere Komplexität, da sie das Gegenteil von Standardisierung ist, die Homogenität fördert.
Standardisierung ist seit Jahrzehnten das Mittel, mit dem Unternehmen die Markteinführung neuer Funktionen beschleunigen, ihre betriebliche Effizienz steigern und zugleich die personellen Ressourcen freisetzen, die erforderlich sind, um der Variabilität von KI-Anwendungsarchitekturen gerecht zu werden.
Aus diesem Grund beobachten wir, dass einige gemeinsam genutzte Dienste – insbesondere für die App- und API-Sicherheit – an den Edge verlagert und nach dem Prinzip „Security as a Service“ bereitgestellt werden. Ein solches Bündel gemeinsam genutzter Dienste kann nicht nur Workloads in allen Umgebungen (Core, Cloud und Edge) besser schützen, sondern auch ein einheitliches Dienstangebot bereitstellen, das als Standard für KI-Anwendungen dienen kann.
Das Verständnis der Anatomie von KI-Anwendungen hilft Ihnen, nicht nur zu bestimmen, welche Arten von Anwendungsbereitstellungs- und Sicherheitsdiensten Sie benötigen, sondern auch, wo Sie diese benötigen.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.