
Da KI- und Machine-Learning-Funktionen zunehmend als entscheidend für Innovation und Effizienz in Unternehmen jeder Größe angesehen werden, müssen Organisationen ermitteln, wie sie ihren Anwendungsentwicklern am besten Zugang zu diesen Funktionen ermöglichen. In vielen Fällen kommt dabei ein KI-Inferenzdienst zum Einsatz – also „ein Dienst, der KI-Modelle aufruft, um auf Grundlage einer bestimmten Eingabe eine Ausgabe zu erzeugen“ (beispielsweise eine Klassifizierung vorherzusagen oder Text zu generieren), üblicherweise als Reaktion auf einen API-Aufruf aus anderem Anwendungscode.
Diese Inferenzdienste können auf vielfältige Weise entwickelt und genutzt werden – selbst innerhalb ein und derselben Organisation. Sie können vollständig intern entwickelt oder als SaaS bezogen werden, auf Open-Source-Projekten basieren und offene oder kommerzielle Modelle verwenden. Sie können Teil einer voll funktionsfähigen „Machine-Learning-Plattform“ sein, die umfassendere Data-Science- und Modellentwicklungsaktivitäten unterstützt, oder lediglich einen API-Endpunkt zum Aufrufen der Modelle bereitstellen. Sie können in einem privaten Rechenzentrum, in einer Public Cloud, in einer Colocation-Einrichtung oder in einer Kombination daraus betrieben werden. Größere Organisationen werden für die KI-Inferenz wahrscheinlich auf mehr als eine einzige Option setzen – insbesondere, wenn ihr organisatorischer Reifegrad in diesem Bereich noch gering ist. Zwar gibt es keinen universellen Ansatz, der für alle gleichermaßen geeignet ist, doch zeichnen sich einige gängige Muster ab.
Übersicht der Muster
Wir betrachten drei grundlegende Nutzungsmuster für KI-Inferenz sowie ihre jeweiligen Stärken und Schwächen:
- KI-Inferenz als SaaS – Anwendungen stellen eine Verbindung zu einem externen, spezialisierten Anbieter von KI-Inferenzdiensten her.
- Cloudverwaltete KI-Inferenz – Anwendungen stellen eine Verbindung zu vollständig verwalteten KI-Inferenzdiensten her, die in der Public Cloud ausgeführt werden.
- Selbstverwaltete KI-Inferenz – Anwendungen nutzen KI-Inferenz, die von der Organisation selbst verwaltet wird – entweder als Teil eines zentralisierten Dienstes oder direkt auf Anwendungsebene.
Wichtige Entscheidungskriterien
Bei der Abwägung der Vor- und Nachteile der folgenden Betriebsmodelle sind einige wichtige Faktoren zu berücksichtigen:
Betriebliche Überlegungen
Skalierbarkeit – Wer ist dafür verantwortlich, und wie gut lässt sich eine bestimmte Option nach oben oder unten skalieren, wenn sich der Kapazitätsbedarf im Laufe der Zeit ändert? Gibt es Skalierungsgrenzen oder Kapazitätsobergrenzen?Kosten – Vollständig verwaltete Dienste mögen auf den ersten Blick teurer erscheinen. Berücksichtigt man jedoch die Gesamtbetriebskosten (einschließlich spezieller Hardware und Fachkräfte), ist die Entscheidung möglicherweise weniger eindeutig. Wie entwickeln sich die Betriebskosten bei steigender oder sinkender Kapazität? Gibt es Kostenuntergrenzen?Wartung / Support – Wer ist für die Wartung des Inferenzdienstes verantwortlich? Muss Ihr Unternehmen Mitarbeitende einstellen oder Beratungsfachkräfte mit entsprechender Expertise beauftragen, oder wäre ein verwalteter Dienst sinnvoller?
Überlegungen zur Entwicklung
Einfache Workload-Integration – Wie schnell lässt sich der KI-Dienst in die nutzenden Workloads integrieren? Eignet sich das Dienstangebot für Ihr vorgesehenes Nutzungsmuster (z. B. Offline- oder Batch-Inferenz) und Ihre Betriebsumgebungen?Agilität – Wie schnell lässt sich die gesamte Anwendung an veränderte Geschäftsanforderungen anpassen? Welche Aspekte der Architektur sind stärker fest verankert und daher nur schwer zu ändern?
Leistungsaspekte
Leistung – Sind der physische Standort des Dienstes (im Verhältnis zu den Dienstnutzern) und die Latenz bei der Inferenz für Ihre Anwendungsfälle relevant?Hardwareverfügbarkeit – Gibt es besondere Hardwareanforderungen für den Dienst, und verfügen Sie gegebenenfalls über die Kapazitäten, um den erwarteten Bedarf zu decken (gilt sowohl für lokale als auch für Cloud-Umgebungen)?
Überlegungen zu Daten
Datenlecks – Besteht die Gefahr, dass sensible Daten an den Inferenzdienst gesendet werden oder im Inferenzergebnis enthalten sind? Falls ja, kann der Datenverkehr überprüft und können Schutzmaßnahmen angewendet werden?Data Governance – Wohin werden die Anwendungsdaten geografisch übermittelt (und wie)? Verbleibt die direkte Kontrolle innerhalb der Organisation oder werden die Daten an Dritte weitergegeben? Gibt es besondere Vorschriften oder Compliance-Richtlinien für den Umgang mit den Daten?
SaaS-Muster
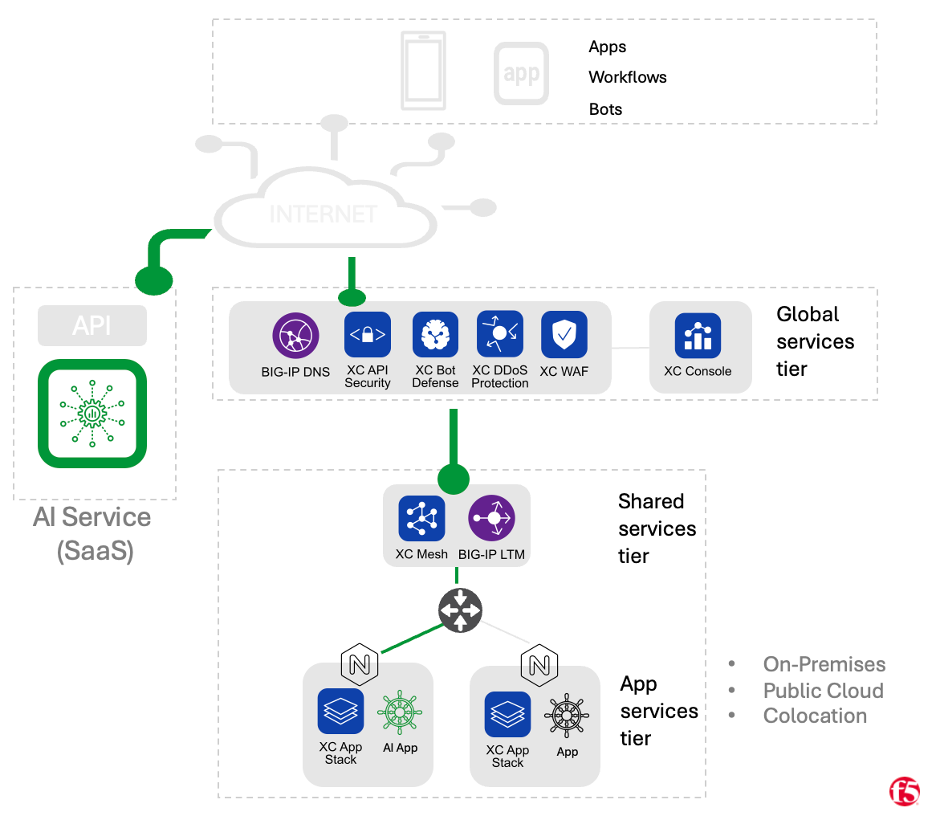
Unternehmen können Dienste eines spezialisierten SaaS-Anbieters nutzen, der sich auf das Hosting von KI-Modellen für Inferenzzwecke konzentriert (z. B. OpenAI oder Cohere). In diesem Fall greifen Workloads, die auf der Infrastruktur eines Unternehmens ausgeführt werden – sei es in einem privaten Rechenzentrum, einer Colocation-Umgebung oder einer Public Cloud –, auf die vom SaaS-Anbieter bereitgestellten APIs zurück. Bei diesem Modell liegt die gesamte Verantwortung für den Betrieb der zum Hosting der Modelle erforderlichen Infrastruktur beim SaaS-Anbieter, sodass die Inbetriebnahme sehr schnell erfolgen kann. Diese Vorteile gehen jedoch zulasten der Kontrolle, da dieses Modell von den hier vorgestellten Varianten am wenigsten „flexibel“ ist. Auch die Kontrolle über sensible Daten ist bei diesem Modell in der Regel am geringsten, da für die Verbindung mit dem Dienst üblicherweise das öffentliche Internet genutzt wird und der externe SaaS-Anbieter strenge regulatorische Compliance-Anforderungen mit geringerer Wahrscheinlichkeit erfüllen kann.
Gut geeignet für
- Markteinführungszeit: Schnelle Prototypenentwicklung und Veröffentlichung von MVPs.
- Unternehmen ohne umfassende interne Fachkenntnisse oder Erfahrung im Bereich KI-Inferenz.
- Anwendungen ohne erhebliche oder strenge Anforderungen an Datensicherheit und Data Governance.
Stärken
- Kurze Markteinführungszeit: Ein einfaches Betriebsmodell kann kurze Integrationszeiten ermöglichen.
- Spezialisierte Dienstleister sind bestens gerüstet, um die Herausforderungen bei der Skalierung von Inferenzprozessen zu bewältigen.
- Erfordert keine Investitionen in spezialisierte Hardware oder Fachpersonal.
Herausforderungen
- Bedenken hinsichtlich Latenz und Konnektivität im Vergleich zu Diensten, die gemeinsam mit den Anwendungs-Workloads betrieben werden.
- Bedenken hinsichtlich Datenschutz, Governance und Sicherheit hängen von einem externen SaaS-Anbieter ab (oder sind möglicherweise nicht mit diesem vereinbar).
- Die Betriebskosten können bei größerer Skalierung höher ausfallen als bei selbst gehosteten Modellen.
- Das Hosting benutzerdefinierter Modelle und Dienste zur Modellanpassung werden möglicherweise nicht unterstützt.
Cloud-verwaltetes Muster
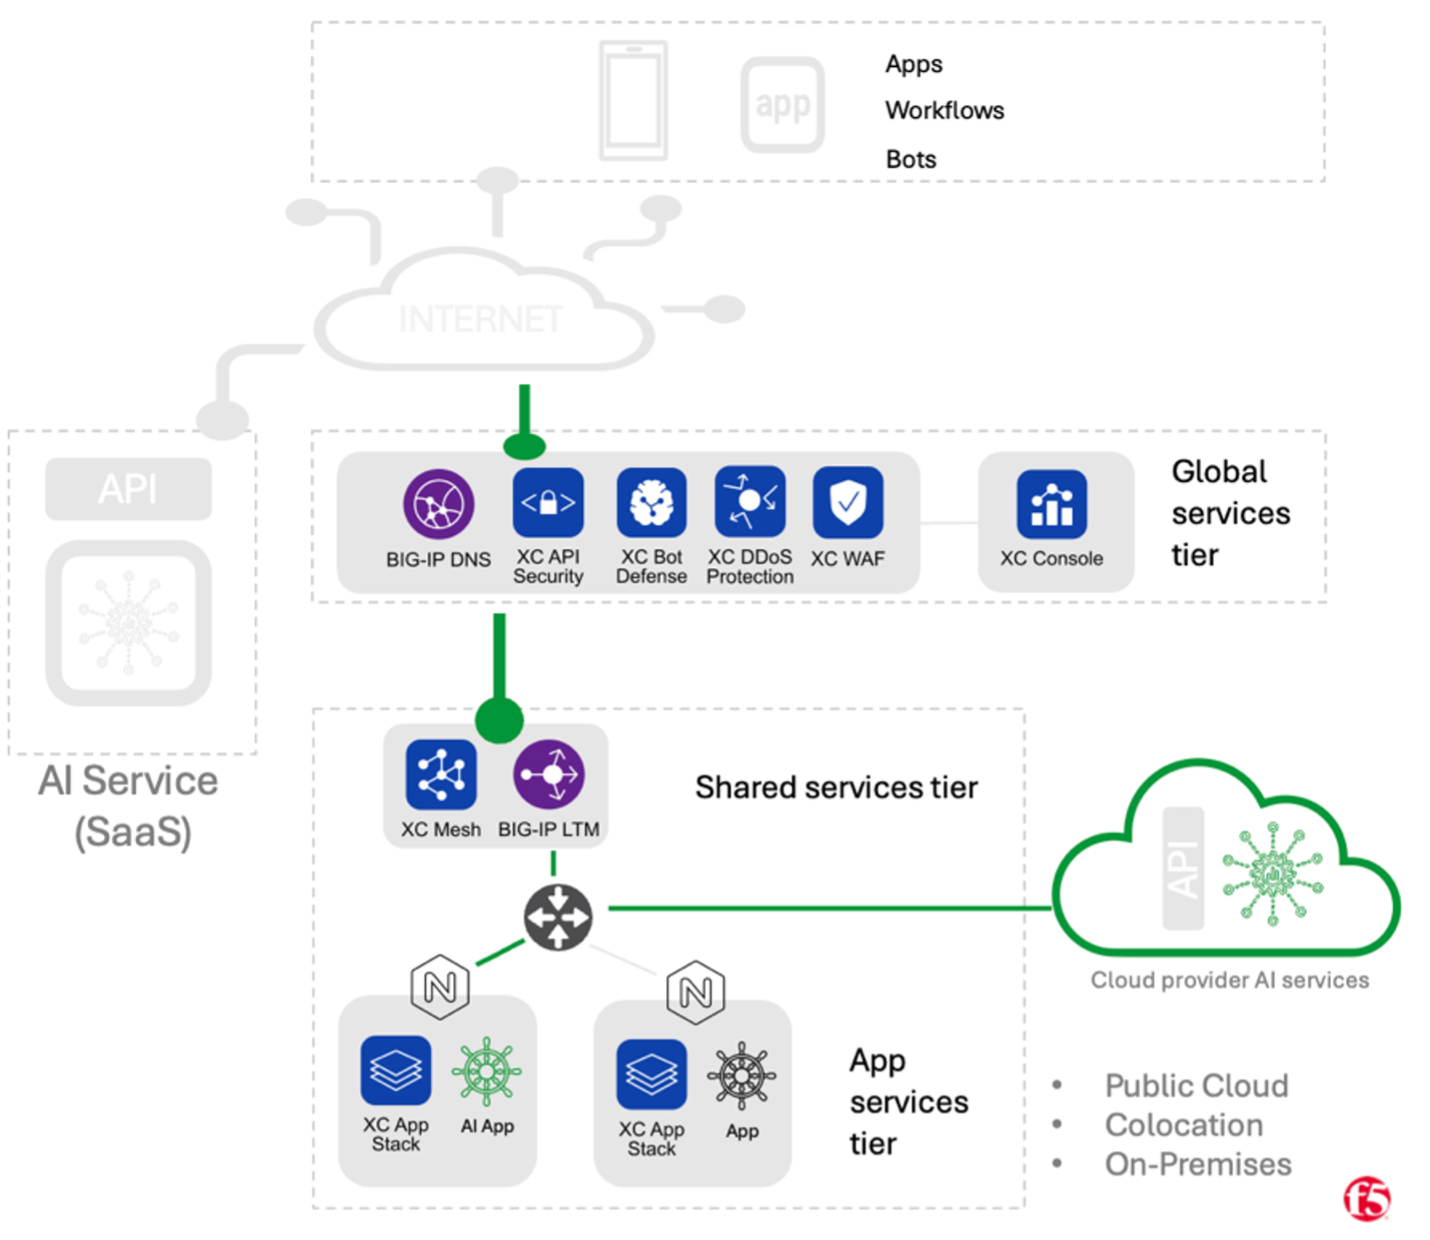
Bei diesem Muster nutzen Unternehmen verwaltete Dienste öffentlicher Cloud-Anbieter (zum Beispiel Azure OpenAI, Google Vertex oder AWS Bedrock). Wie beim ersten Muster liegt der operative Aufwand für die Bereitstellung, Skalierung und Wartung der KI-Modelle beim Cloud-Anbieter und nicht beim nutzenden Unternehmen. Der wesentliche Unterschied zwischen diesem Muster und dem oben beschriebenen SaaS-Muster besteht darin, dass die Endpunkte der Inferenz-API in diesem Fall in der Regel über private Netzwerke erreichbar sind und die Workloads der KI-Nutzer gemeinsam mit dem KI-Modelldienst am selben Standort betrieben werden können (z. B. in derselben Zone oder Region). Dadurch werden die Daten üblicherweise nicht über das öffentliche Internet übertragen, die Latenz ist voraussichtlich geringer und die Mechanismen zur Anbindung an diese Dienste ähneln denen anderer verwalteter Dienste von Cloud-Anbietern (d. h. Dienstkonten, Zugriffsrichtlinien und Netzwerk-ACLs). Unternehmen, die Multi-Cloud-Netzwerke nutzen, können einige dieser Vorteile möglicherweise auch dann erzielen, wenn Workloads und KI-Inferenzdienste in unterschiedlichen Clouds gehostet werden.
Gut geeignet für
- Organisationen mit bestehenden Investitionen in die Public Cloud.
- Anwendungen, die in anderen cloudverwalteten Diensten ausgeführt werden oder eine Verbindung zu diesen herstellen.
Stärken
- Viele Organisationen sind bereits damit vertraut, ihre Workloads mit verwalteten Diensten anderer Cloud-Anbieter zu verbinden (z. B. Datenbanken, Objektspeicher usw.).
- Der Betriebs- und Infrastrukturaufwand für die Ausführung und Skalierung von Modellen liegt hauptsächlich beim Cloud-Anbieter.
- Bedenken hinsichtlich der Latenz und des Datenschutzes lassen sich möglicherweise leichter ausräumen.
Herausforderungen
- Multi-/Hybrid-Cloud-Anwendungen erfordern zusätzlichen Aufwand für die Anbindung und Absicherung.
- Mangelnde Einheitlichkeit bei Cloud-verwalteten Diensten und APIs kann zu einer Anbieterabhängigkeit führen.
- Organisationen ohne eine umfassende Präsenz in der Public Cloud könnten auf Schwierigkeiten stoßen.
- Die Betriebskosten können bei größerer Skalierung höher ausfallen als bei selbst gehosteten Modellen.
- Das Hosting benutzerdefinierter Modelle und Dienste zur Modellanpassung werden möglicherweise nicht unterstützt.
Selbstverwaltetes Muster
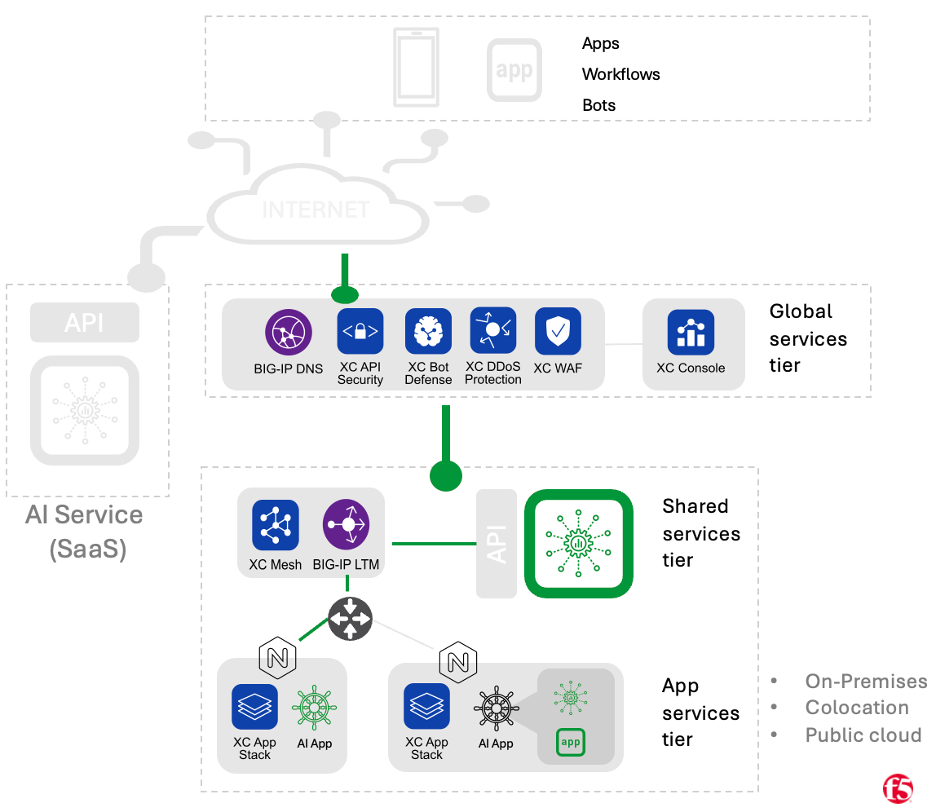
Beim selbstverwalteten Modell betrachten wir zunächst den Fall, dass die Inferenz von KI-Modellen als zentralisierter „Shared Service“ betrieben wird. Anschließend untersuchen wir den Fall, dass kein zentralisierter Dienst vorhanden ist und die einzelnen Anwendungsteams selbst für den Betrieb verantwortlich sind.
Selbstverwalteter, gemeinsam genutzter Dienst
Bei der „Shared Service“-Variante des Self-Managed-Musters verfügt eine Organisation möglicherweise über ein oder mehrere dedizierte Teams, die für die Wartung der Inferenzinfrastruktur, der darauf ausgeführten Modelle, der für den Zugriff verwendeten APIs sowie für alle betrieblichen Aspekte des Lebenszyklus des Inferenzdienstes verantwortlich sind. Wie bei den anderen Mustern würden KI-Anwendungsworkloads die Inferenzdienste über API-Aufrufe nutzen. Die Infrastruktur für die Modellbereitstellung kann in privaten Rechenzentren, in einer Public Cloud oder in einem Colocation-Rechenzentrum betrieben werden. Die für den Betrieb des Inferenzdienstes verantwortlichen Teams können selbst gehostete Plattformen für maschinelles Lernen (wie Anyscale Ray oder MLFlow) nutzen. Alternativ können sie auf stärker spezialisierte Tools zur Inferenzbereitstellung wie den Text Generation Inference-Server von Hugging Face oder auf intern entwickelte Software zurückgreifen. Bei selbstverwalteter Inferenz sind Organisationen auf Modelle beschränkt, die sie entweder selbst trainiert haben oder lokal ausführen können (proprietäre Modelle eines SaaS-orientierten Dienstes kommen daher möglicherweise nicht infrage).
Gut geeignet für
- Etablierte Organisationen mit umfassender Erfahrung im Infrastrukturmanagement.
- Organisationen mit hohen Inferenzanforderungen, die die Gesamtbetriebskosten eines selbstverwalteten Dienstes rechtfertigen.
- Anwendungen mit den strengsten Anforderungen an Datenschutz und Compliance.
Stärken
- Unternehmen haben die vollständige Kontrolle über alle Aspekte des Inferenzdienstes.
- Herausforderungen beim Datenschutz lassen sich in der Regel am einfachsten mit selbst gehosteten Modellen bewältigen.
- Bei großem Umfang können die Kosten niedriger ausfallen als bei Cloud-verwalteten oder SaaS-basierten Inferenzdiensten.
Herausforderungen
- Unternehmen haben die vollständige Kontrolle über alle Aspekte des Inferenzdienstes (dafür sind voraussichtlich umfangreiche Investitionen in Infrastruktur und Personal sowie kontinuierliche Wartung und Weiterentwicklung erforderlich; zudem müssen Fragen der Skalierbarkeit berücksichtigt werden).
- Für Organisationen mit geringem Inferenzbedarf und geringen Datenschutzbedenken in der Regel nicht kosteneffizient.
- Kein Zugriff auf geschlossene bzw. proprietäre Modelle, die möglicherweise als SaaS oder cloudverwaltete Dienste verfügbar sind.
Selbstverwaltet, kein gemeinsam genutzter Dienst
Organisationen ohne ein zentrales Team, das für den Betrieb von KI-Inferenzdiensten zur Nutzung durch Anwendungen verantwortlich ist, stellen die andere Variante des Self-Managed-Modells dar. Bei dieser Variante können einzelne Anwendungsteams ihre Modelle auf derselben Infrastruktur ausführen, die ihnen für die Anwendungslast zugewiesen wurde. Sie können über eine API auf diese Modelle zugreifen oder sie direkt im „Offline“-Modus nutzen. Mit diesem Modell können Entwickler einige der Vorteile des selbstverwalteten „Shared Service“-Modells auch in kleinerem Maßstab realisieren.
Gut geeignet für
- Anwendungen, die Stapelverarbeitung und Offline-Inferenz erfordern.
- Organisationen mit sehr geringem Inferenzbedarf, aber strengen Anforderungen an Datenschutz und Compliance.
Stärken
- Höchste Flexibilität für Anwendungsentwickler mit vielfältigen Möglichkeiten zur Integration in Workloads.
- Kann Datenschutz- und Latenzziele in kleinem Maßstab erreichen.
- Kann in einigen Fällen kostengünstiger sein als die anderen beschriebenen Modelle (z. B. bei einem einzelnen Team mit hohem Nutzungsbedarf).
Herausforderungen
- Die operative Verantwortung für den Modelllebenszyklus liegt bei den einzelnen Anwendungsteams.
- Nutzt Skaleneffekte nicht, wenn die Nutzung von KI-Inferenz in einem Unternehmen zunimmt (mangelnde Konsistenz, ineffiziente Ressourcennutzung usw.)
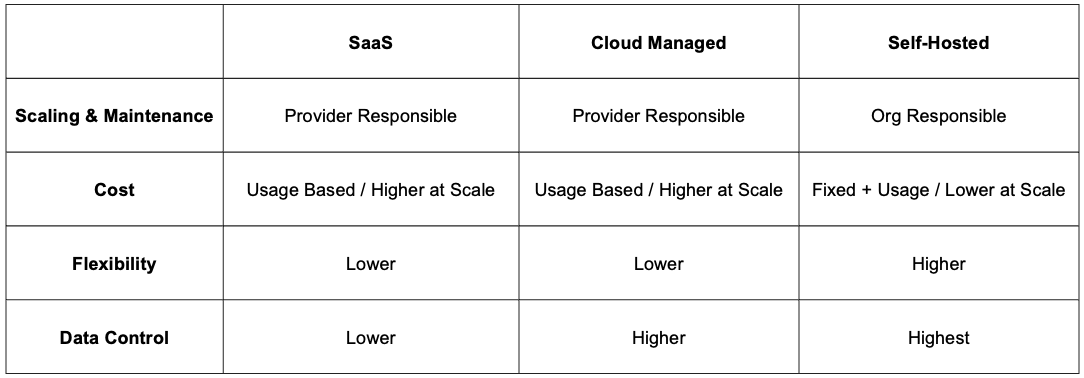
Zusammenfassung der Vor- und Nachteile der Muster
KI-Anwendungen und Modellinferenzdienste absichern
Im Kern ähneln KI-Anwendungen stark allen anderen modernen Apps. Sie bestehen aus einer Kombination aus benutzerseitigen und Backend-Komponenten, greifen häufig auf externe Datenspeicher zurück, nutzen intensiv API-Aufrufe usw. Diese Anwendungen sind mit denselben Sicherheitsherausforderungen konfrontiert wie alle modernen Apps und benötigen dieselben, auf die gleiche Weise umgesetzten Schutzmaßnahmen (z. B. AuthNZ, DDoS-Schutz, WAF, sichere Entwicklungspraktiken usw.). KI-Apps und insbesondere solche, die generative KI nutzen, bringen jedoch auch eine Reihe spezifischer Risiken mit sich, die bei anderen Anwendungen möglicherweise keine Rolle spielen (siehe beispielsweise OWASP Top 10 für LLMs). Die im Allgemeinen schwer vorhersehbare Natur dieser Modelle kann zu neuartigen Problemen führen, insbesondere in Anwendungsfällen, in denen den Modellen ein hohes Maß an Handlungsautonomie eingeräumt wird.
Da die oben beschriebenen Muster in hohem Maße auf API-gesteuerten Interaktionen mit der KI-Modellinferenz beruhen, sind viele Unternehmen glücklicherweise bereits gut aufgestellt, um diese neuen Sicherheitsmaßnahmen umzusetzen. So könnte beispielsweise ein API-Gateway, das herkömmliche Funktionen wie Ratenbegrenzung, Authentifizierung, Autorisierung und Datenverkehrsmanagement bereitstellt, um tokenbasierte Ratenbegrenzungen zur Kostenkontrolle erweitert werden (entweder ausgehend auf Anwendungsebene für einen von einem SaaS-Anbieter verwalteten Dienst oder eingehend durch RBAC-Autorisierung als Schutz vor einem selbst verwalteten Inferenzdienst). Ebenso könnte eine Infrastruktur, die derzeit klassische Web-Application-Firewall-Dienste (WAF) wie die Prüfung auf SQL-Injection oder XSS bereitstellt, ein sinnvoller Ort sein, um Schutzmaßnahmen gegen Prompt-Injection und ähnliche Angriffe hinzuzufügen. Die meisten modernen Observability-Verfahren lassen sich direkt auf spezifische Anwendungsfälle API-gesteuerter KI-Inferenz übertragen, sodass Teams vorhandene Tools und Verfahren in diesem Bereich effektiv nutzen können.
Fazit
Auch wenn der Hype um KI-gestützte Anwendungen und Inferenzdienste zweifellos neu ist, sind die grundlegenden Prinzipien für deren Bereitstellung und Absicherung schon lange bekannt. Unternehmen müssen bei der Entscheidung, wie sie KI-Funktionen am besten nutzen, Vor- und Nachteile abwägen – genau wie beim Einsatz jeder anderen Technologie. Maßgeblich sind dabei ihre konkreten Anwendungsfälle, die verfügbaren Ressourcen und ihre langfristigen Ziele. Auch wenn Anwendungsfälle für KI – insbesondere generative KI – einige neuartige Sicherheitsherausforderungen mit sich bringen, bieten die Gemeinsamkeiten mit anderen modernen Anwendungen und die starke Abhängigkeit von API-gesteuerten Modellinteraktionen eine hervorragende Gelegenheit, bestehende Muster, Verfahren und Tools zu nutzen und weiterzuentwickeln. Unabhängig davon, ob eine selbst gehostete Lösung oder ein verwalteter Dienst zum Einsatz kommt, ist es entscheidend, Entwicklern Zugang zu einer sicheren, skalierbaren und leistungsfähigen Lösung zu bieten, die Ihre spezifischen Geschäftsanforderungen erfüllt, um den Nutzen und die Wirkung Ihrer KI-Investitionen zu maximieren.
Über den Autor
Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.