長年にわたり、ネットワークセグメンテーションは、脅威の隔離、サービス品質の差別化、インシデント対応と分析、コンプライアンス監査をはじめ、相互運用性に関わる多くの重要な機能を支える要となってきました。しかし、ゼロトラストの原則を掲げ、AIの導入を急ぐあまり、現代のサイバーセキュリティとサービス運用の基盤となる、このネットワークインフラストラクチャの中核要素を軽視してはいないでしょうか。
AIファクトリーシリーズの以前の記事では、AIファクトリーを大規模かつ高性能なトレーニングと推論の要件に対応する、ストレージ、ネットワーク、コンピューティングへの大規模な投資と定義しました。この投資からリターンを得るため、AIファクトリーでは、高価値のグラフィックスプロセッシングユニット(GPU)とコンピューティングリソースの使用を動的にスケジューリングし、トレーニングと推論を実行します。GPUをスケジューリングするには、AIクラスターごとにAIサービスの複数の「テナント」を設計する必要があります。これにより、多くの運用チームが手遅れになるまで予見できない問題が生じます。
AIファクトリーのクラスターリソースとネットワークセグメンテーションの整合
AIクラスター内では、テナントコンテキストに基づいてリソースを論理的にセグメント化できるため、テナントごとのクォータやリソース消費量の制限、ホストシステムのセキュリティ、管理ロールベースのアクセス制御(RBAC)が可能になります。しかし、AIクラスターとAIファクトリーネットワークの他の部分との間でトラフィックの入出力を担う基本的なネットワークサービスには、テナントコンテキストが公開されません。このコンテキストがなければ、データセンターのサイバーセキュリティの基盤であるネットワークセグメンテーションは、テナントを識別できません。必要なテナントコンテキストを公開する一般的な方法では、AIファクトリーの高価値なコンピューティングリソースが大幅に奪われるか、ネットワーク経路の性能が低下し、サービスのレイテンシ、帯域幅、同時実行性に求められる基準を満たせなくなります。その結果、高価値なAIファクトリーリソースの効率的な活用と、テナントとネットワークの適切な統合のどちらかを選ばざるを得ないという、誤った二者択一に直面します。
パブリッククラウドインフラストラクチャでは、オーケストレーションされたマルチテナントネットワーク設計が、クラウドリージョン内のあらゆるサービスの基盤となっており、仮想プライベートクラウド(VPC)によって実装されています。この仮想化されたネットワークセグメンテーションは、セキュリティとリソース使用量の計測に不可欠です。パブリッククラウドプロバイダーは、ネットワークソフトウェア開発者のチームと、SmartNICやデータ処理ユニット(DPU)などの専用ネットワークハードウェアを活用して、この機能を維持しています。パブリッククラウド上のAIファクトリークラスターは、基盤インフラストラクチャのVPCネットワークオーケストレーションを活用できるように設計されています。VPCの維持には多額のコストがかかりますが、これはパブリッククラウドのビジネスモデルの中核を成すものです。
ここで疑問が生じます。組織は、パブリッククラウドプロバイダーと同等の投資を行うことなく、AIファクトリーへの投資効果を最大化し、GPUとコンピューティングリソースを動的にスケジューリングするには、どうすればよいのでしょうか。
この取り組みにおいて、業界が最初に採用したのは、サーバー仮想化を利用して仮想マシン(VM)を作成する方法でした。VMはハードウェアパススルーを利用して、セグメント化されたデータセンターネットワークに接続します。単一のAIクラスター内の単一テナントのみを対象とする場合は、すべてのVMを同じVLANに配置するだけで、通常どおり運用を継続できます。
GPUベンダーは、GPUデバイスをコアとメモリのセットに分割し、特定の仮想マシンに割り当てる方法をサポートしているため、VMでもGPUのセグメンテーションに対応できます。ただし、GPUデバイスのセグメンテーションは動的に行えず、VMの再起動が必要です。さらに、この設計では、複数のテナントにわたって使用量を計測できるGPUリソースプールを構築する能力が制限されます。これらは、このソリューションの重大な欠点です。
ネットワークセグメンテーションとマルチテナントAIファクトリクラスタの整合
AIファクトリークラスターが単一テナント専用ではなくなると、何が起こるのでしょうか。問題はデータセンターへと移ります。AIファクトリークラスターでは、デフォルトで、データセンターへ送出されるすべてのネットワークトラフィックに対して送信元ネットワークアドレス変換(SNAT)が行われ、ネットワークリクエストを発行したコンテナ化ワークロードが実行されている個々のクラスターノードのIPアドレスに変換されます。その結果、実際の送信元が事実上隠されます。その後、トラフィックは、そのノードがデプロイされたネットワークセグメントを送信元として送出されます。マルチテナントクラスターでは、これによりテナントのコンテキストが失われ、複数のテナントからの送出トラフィックが混在します。そのため、トラフィックの分類、保護、トラブルシューティング、監査ができなくなります。
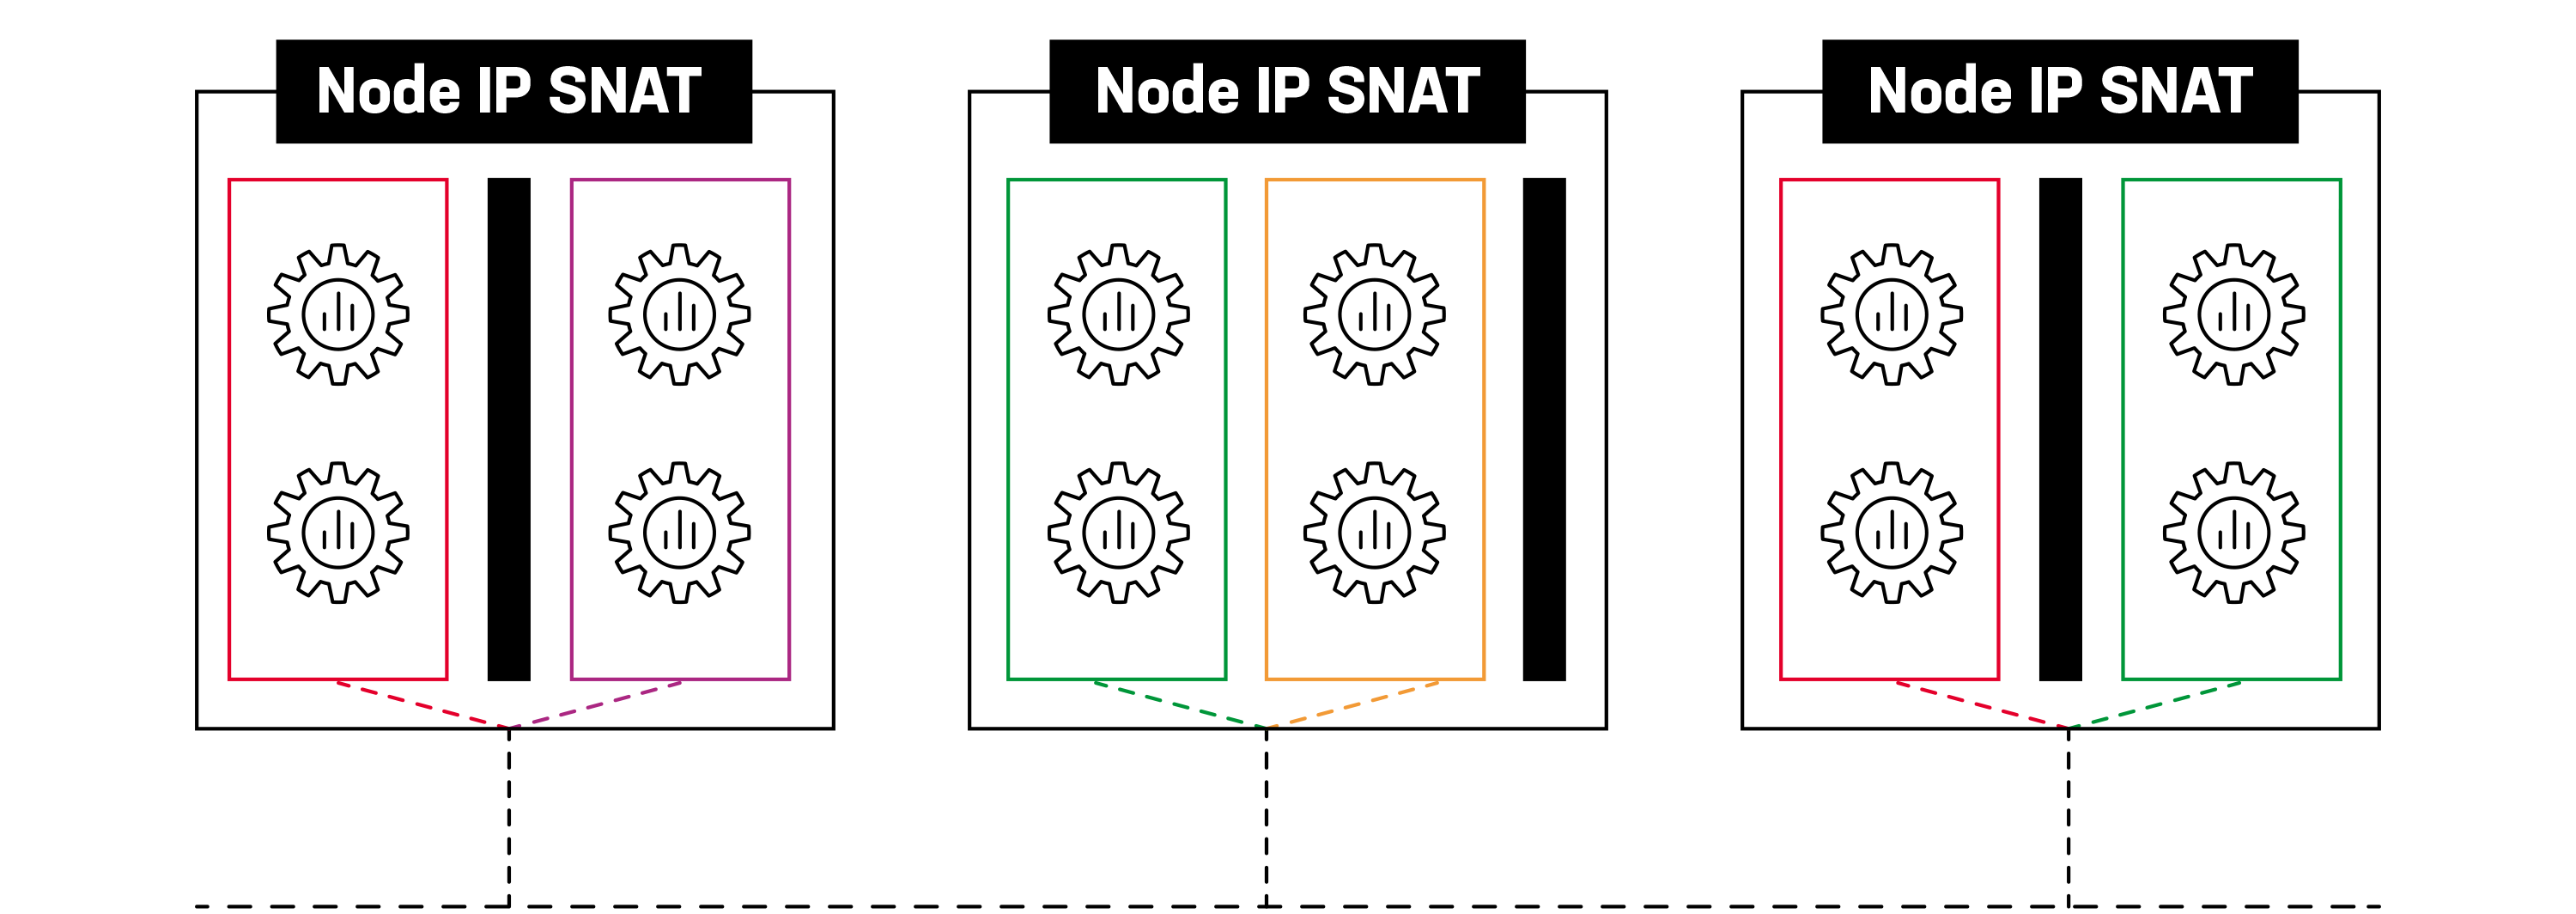
デフォルトでは、外部への送信時にクラスターテナントのコンテキストが失われます。
イングレストラフィックも対象に含めると、この問題はさらに深刻になります。イングレストラフィックは、すでにセグメント化されたデータセンターから送信されるため、比較的管理しやすい可能性があります。しかし、単一テナントのイングレストラフィックとエグレストラフィックをどのように関連付ければよいのでしょうか。その鍵となるのが、検索拡張生成(RAG)とエージェント型サービスです。これらは、外部データの取得や外部サービスの利用に伴い、頻繁に通信します。そのため、顧客に関する問題の特定やセキュリティ監査への対応には、プラットフォームエンジニアとNetOpsによる部門横断的な取り組みが必要になります。
企業からは、「ソフトウェア定義ネットワーキング(SDN)のオーバーレイ技術を使用して、ハイパースケーラーのようにVPCネットワークを構築すればよいのではないか」という疑問が出るかもしれません。これは確かに可能ですが、既存のデータセンターインフラストラクチャ上でSDN VPCネットワークを維持するためのコストが発生します。レイヤー2(VxLANなど)でのセグメンテーションが必要な場合、トップオブラックスイッチングと連携したトンネルのオーケストレーションや、ネットワークセグメンテーションに合わせたスイッチのプロビジョニングが課題となります。このため、ハイパースケーラーはSmartNICを採用し、ホスト間レベルのオーケストレーションへと移行することで、データセンターネットワークを高速かつインテリジェンスを持たない状態に保っています。
ほとんどの組織には、このような複雑なホストレベルのオーケストレーションを担うためのネットワークプログラミング人材がいないか、自ら運用する意向がありません。また、サービス品質の確保に必要なバックボーンネットワークの可視性を失うこともできません。こうした問題に対して提案されているレイヤー3(IPなど)のルーティングソリューションでは、基本的なIPサブネットのテナント分離を実現するために複数のルートリフレクターを使用し、すべてのAIクラスターノードをデータセンターの動的ルーティング(BGP)ピアにする方向へとネットワークチームを導いてきました。これもまた、運用担当者を極めて複雑なルーティング上の問題やセキュリティ監査に直面させ、リージョン全体の停止を引き起こしています。
AIファクトリー向けのクラスター対応型オーケストレーションによるネットワークセグメンテーション
AIファクトリーでは、豊富なネットワーク機能を備え、プログラム可能でセキュアかつ低遅延であり、帯域幅と同時実行性の両面で拡張可能なソリューションを計画する必要があります。レイヤー2(VLAN、VxLANなど)およびレイヤー3(サブネット、IPSECインターフェースなど)のテナントコンテキストを、クラスター内からAIファクトリーのネットワークに提供する必要があります。また、NetOpsがオブザーバビリティのメトリクス、ログ、デバッグツールを利用できるようにする必要があります。
従来、こうしたアプリケーションのテナンシーと可視化のためのソリューションの多くは、F5 BIG-IPによって提供されています。F5 BIG-IP Container Ingress Services (CIS)は、Kubernetesサービスを動的に検出し、仮想サーバーとしてデータセンターに公開します。仮想サーバーは、物理サーバーや仮想マシンを公開するための設定で使用されるため、BIG-IP管理者には馴染みのある設定オブジェクトです。BIG-IPは求められる要件の多くを満たしますが、セグメンテーションの維持に必要な、AIクラスターからAIファクトリーネットワークへのエグレストラフィックは管理しません。
この課題に対処するため、次世代プラットフォームBIG-IP Nextを基盤とする、マルチテナント型コンピューティングクラスター向けソリューションとして、F5 BIG-IP Next for Kubernetesを設計しました。
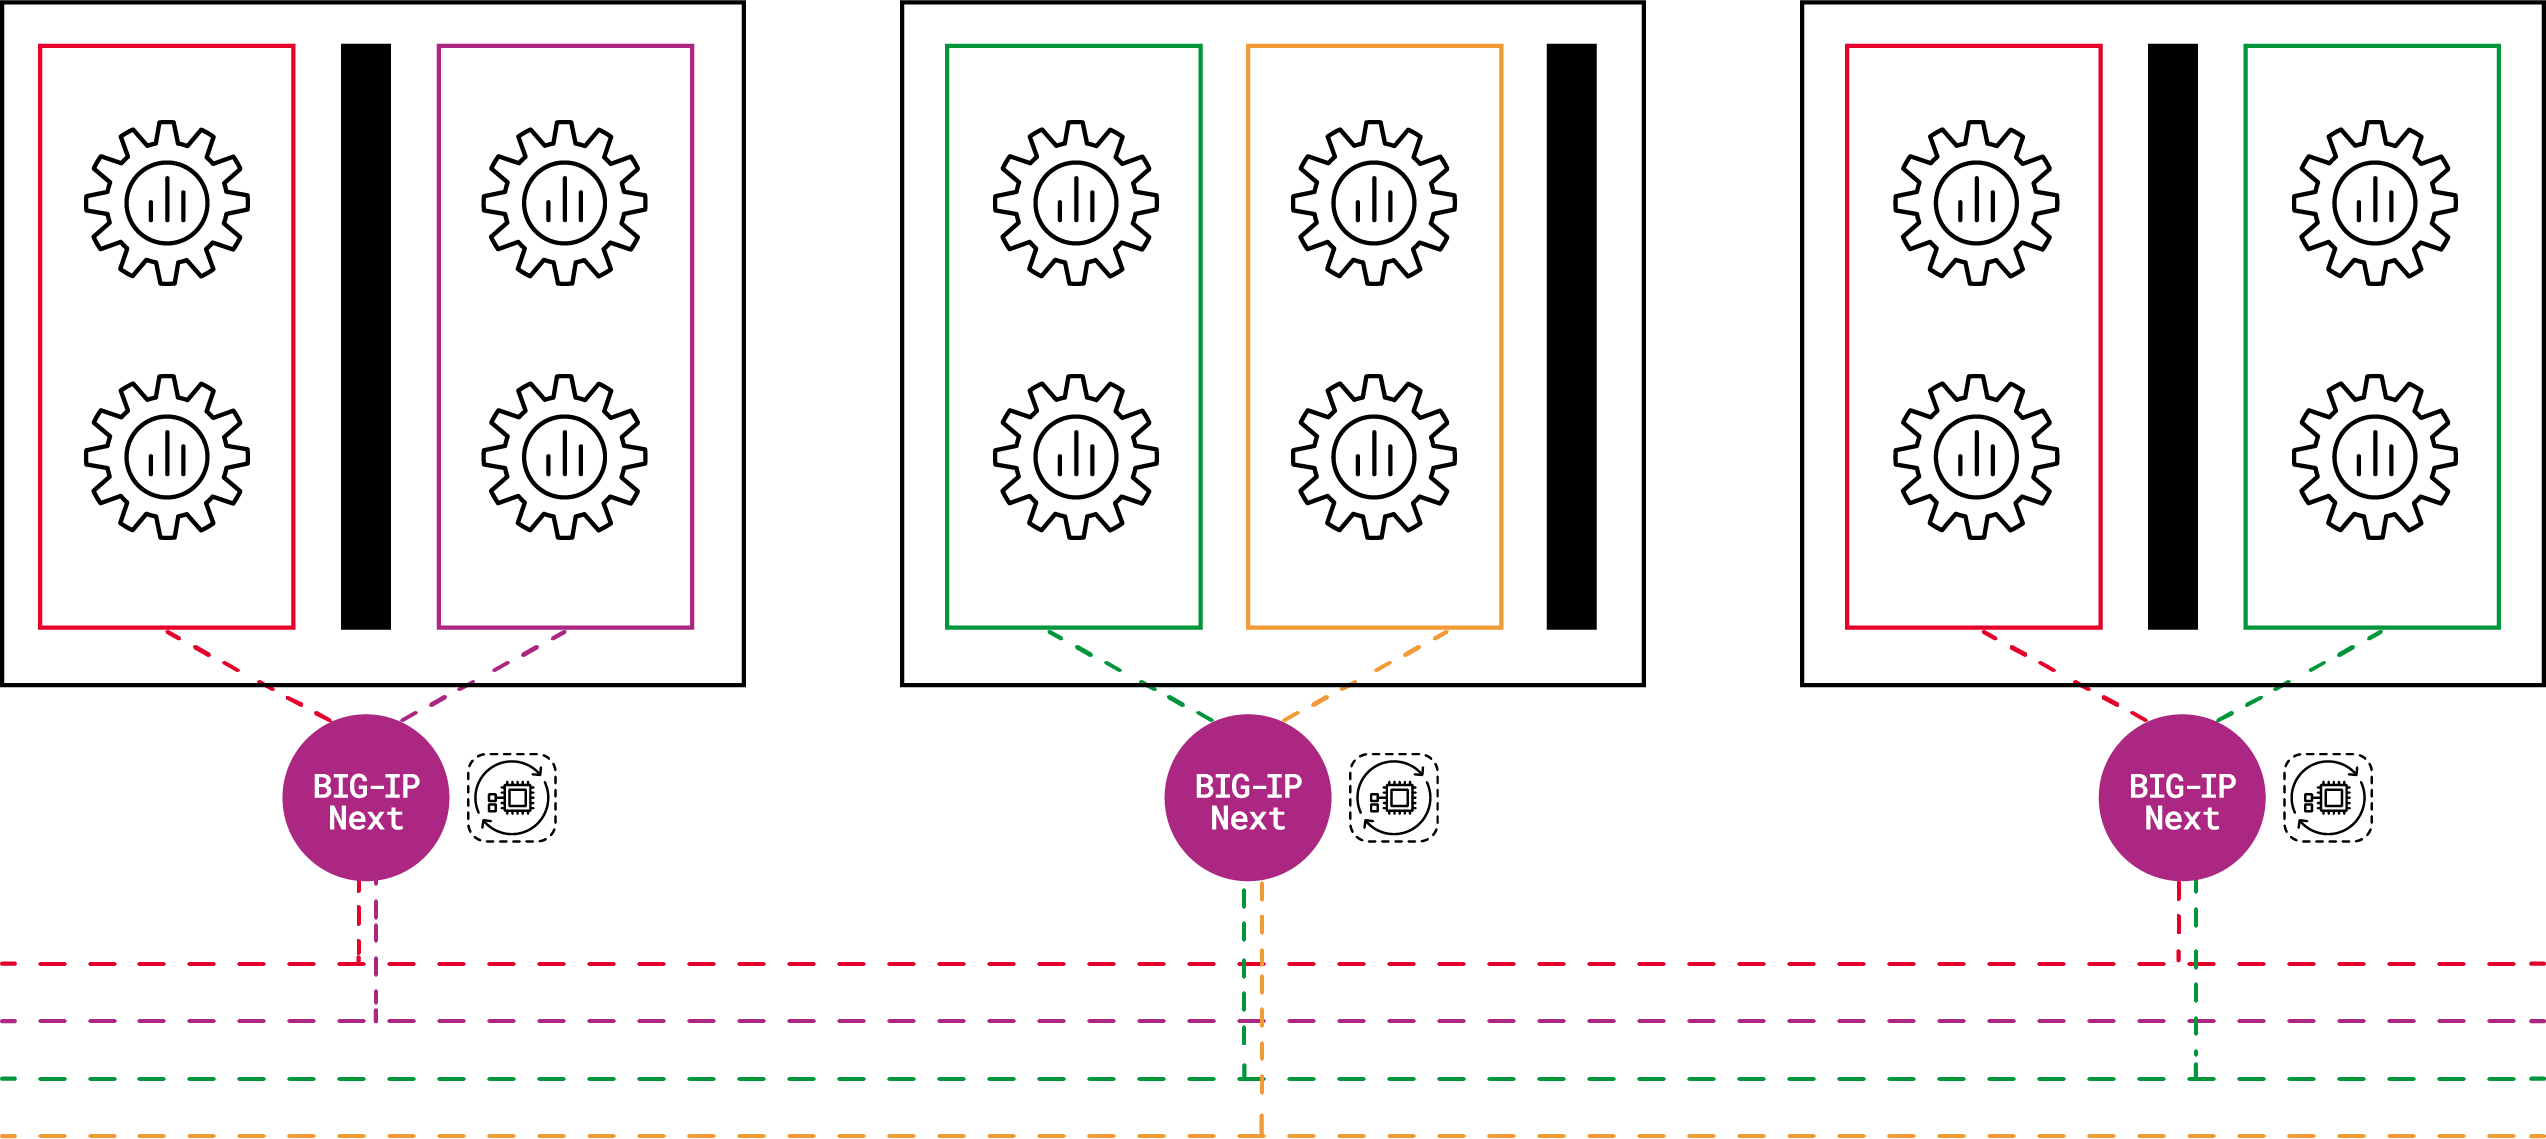
BIG-IP Next for Kubernetesにより、NetOpsはクラスターテナントをネットワークセグメントに関連付けることができます。
BIG-IP Next for Kubernetesは、Kubernetesコントロールプレーンを通じて完全に管理されます。また、Kubernetes管理認証、宣言されたすべてのリソースに対するRBACをサポートし、名前空間を通じてKubernetesのテナンシーを認識することで、イングレスとエグレスの両方のトラフィックに必要なネットワークセグメンテーションを実現します。これは、AIファクトリーのようなオーケストレーションファーストのアーキテクチャに不可欠です。
BIG-IP Next for Kubernetesにより、NetOpsはKubernetes名前空間とネットワークセグメントのマッピングを簡単に宣言できます。AIファクトリーネットワークとBIG-IP Nextインスタンス間の動的ルートピアリングには、使い慣れたルート設定構文を使用します。NetOpsチームは、クラスターのイングレスおよびエグレスのライブネットワークストリームを安全にトラブルシューティングできる独自の機能を利用できます。SecOpsチームは、クラスターテナントごとのイングレスおよびエグレス向けファイアウォールアクセス制御リスト(ACL)、分散型サービス拒否(DDoS)対策、IPSの各機能を利用できます。
プラットフォームエンジニアリングチームは、データのイングレストおよびエグレストトラフィック処理、Source NAT、ファイアウォールなどのネットワーク機能をBIG-IP Next for Kubernetesにオフロードすることで、コンピューティングリソースの負荷を軽減できます。これにより、サービスの可用性と効率性を維持しながら、運用コストの削減に役立ちます。
BIG-IP Next for Kubernetesは、NetOps、プラットフォームエンジニアリング、DevOps、MLOpsの各組織内ロール向けに設計された初のコミュニティIngress APIであるKubernetes Gateway APIにも対応しています。Gateway APIを通じて、BIG-IP Next for Kubernetesは、一般的なレイヤー4のポートベースまたはレイヤー7のHTTP(S)ルートによるIngressサービスを、DevOps/MLOps向けのTCPRoute、UDPRoute、HTTPRoute、TLSRoute、GRPCRouteへと拡張します。これらはすべて、主要なAIフレームワークで同一のCI/CD自動化によって制御されます。
管理の観点では、BIG-IP Next for Kubernetesにより、NetOps、SecOps、プラットフォームエンジニアリング、DevOps、MLOpsの各チームが、Kubernetes API宣言を通じて効果的に連携できます。ネットワークセグメンテーションをサポートしながら、BIG-IPに期待されるすべての機能をKubernetesの視点で提供します。
DPUの台頭
データ処理ユニット(DPU)は、AIファクトリーで急速に普及しています。AIファクトリーシリーズの以前のブログ記事で説明したように、DPUは、ハードウェアアクセラレーションを利用し、ネットワークのラインレートで膨大なデータの移動と処理を実行するよう設計されたプログラマブルプロセッサです。F5の製品イノベーションとNVIDIAとの協業により、NVIDIAのDOCA APIを使用してNVIDIA BlueField-3 DPUに導入することで、ネットワークセグメンテーションとセキュリティ機能をサポートしながら、イングレストラフィックとエグレストラフィックのデータフローをオフロードするBIG-IP Next for Kubernetesをリリースしました。これにより、AIクラスターへのデータ供給を確保し、AIファクトリーへの投資効果を最大化します。
F5が支えるAIファクトリー
AIファクトリーへの投資では、インフラストラクチャが最適化され、効率性と拡張性を備えていることが不可欠です。NVIDIA BlueField-3 DPU上に導入されたF5 BIG-IP Next for Kubernetesは、動的なGPUおよびコンピューティングのスケジューリングに必要なネットワークセグメンテーションを提供するとともに、高性能な拡張性によってAI投資の収益を最大化します。詳しくは、F5にお問い合わせください。F5のアカウントマネージャーおよびソリューションエンジニアまたはアーキテクトが対応します。
AIファクトリーについてさらに詳しく知りたい方は、AIファクトリーに関するブログシリーズの他の記事もご覧ください。
- AI Factoryとは? ›
- AI Factory向け検索拡張生成(RAG)›
- AI Factoryのデータ取り込みに向けたトラフィック管理の最適化 ›
- エッジデータソースとAIファクトリーの最適な接続 ›
- マルチクラウドの拡張性と柔軟性がAIファクトリーを支援 ›
- AIファクトリーにおけるNVIDIA BlueField DPUの力と意義 ›
- AIファクトリーのAPI保護:AIセキュリティへの第一歩 ›
- AIファクトリーが生み出す最先端のモダンアプリ:AIアプリ ›
著者について
関連するブログ記事

F5 Application Study Tool:OpenTelemetryによるF5 BIG-IP環境の監視
F5の新しいオープンソースツールは、BIG-IP環境を詳細に可視化し、データを追跡するとともに、強力でカスタマイズ可能なインサイトを得るための基盤を提供します。

F5 BIG-IPでAI防御を実現
F5 BIG-IP Advanced WAF、BIG-IP APM、BIG-IP SSL Orchestratorが、生成AIアプリ向けに包括的なセキュリティソリューションを提供する仕組みをご覧ください。
F5 Advanced WAFによるGraphQL APIの保護
ここ数年、多くの組織がデジタルトランスフォーメーションを進めており、COVID-19のパンデミックによってその動きは加速しています。
アプリケーションサービスの現状 通信業界版:リーダーとしての台頭
通信ネットワークが進化し、さまざまな業界の幅広いユースケースに対応するなか、通信業界の回答者がテクノロジーリーダーとしての存在感を高めていることがわかります。
デジタルトランスフォーメーションは、単なるペーパーレス化ではない
デジタルトランスフォーメーションは、単なるペーパーレス化ではありません。真のモダナイゼーションにアプリケーションアーキテクチャとセキュリティの再構築が必要な理由を、F5ブログでご覧ください。
やめましょう。もう本当にやめましょう。HTTPSはHTTPより高速ではありません。
もうやめましょう。HTTPSはHTTPより高速ではありません。プロトコルのパフォーマンスに関する微妙な違いと、暗号化トラフィックを適切に最適化する方法については、F5ブログをご覧ください。