Über generative KI (GenAI) wird derzeit überall gesprochen. Doch was davon setzt sich tatsächlich durch? Wie trägt sie dazu bei, die Welt zu verbessern? Wo liegt der geschäftliche Nutzen? Diese Fragen sind ebenso relevant, wenn man die Herausforderungen betrachtet, vor denen Unternehmen stehen, die herausfinden möchten, ob und wann sie GenAI in ihre Betriebsabläufe (AIOps) integrieren sollten. Auf Grundlage meiner Experimente mit generativer KI im vergangenen Jahr und meiner umfassenden Einblicke in Branchentrends im Rahmen meiner täglichen Recherchen bei F5 habe ich fünf zentrale Erkenntnisse zusammengestellt. Sie sollen Unternehmen dabei unterstützen, die Auswirkungen von GenAI auf den Umgang mit Betriebsdaten besser zu verstehen. So können diese Unternehmen die Zeitpläne für die Einführung von GenAI-Technologien besser auf ihre bestehenden Budgets, Prozesse und Unternehmenskulturen abstimmen.
1. GenAI-Modelle lieben semistrukturierte und unstrukturierte Daten
Betriebsdaten sind ein Sammelsurium aus semistrukturierten Daten (Objekten) und unstrukturierten Datensätzen. Große Sprachmodelle (Large Language Models, LLMs) können äußerst flexibel und effektiv mit dieser Bandbreite an Datenformaten umgehen. Daher eignen sich LLMs hervorragend für die Analyse betrieblicher Datensätze. Unternehmen können intern verschiedene Experimente und Bewertungen durchführen, um die Wirksamkeit, Benutzerfreundlichkeit und Kosten unterschiedlicher GenAI-gestützter Lösungen zu überprüfen. Durch den Einsatz von LLM-Inferenz zur Erkennung interessanter Datenmuster mit weniger falsch positiven Ergebnissen lassen sich Geschwindigkeit und Skalierbarkeit von Maschinen mit den Zielen der Teams in Einklang bringen, die betriebliche Datenströme nutzen.
2. Unternehmen müssen keine Modelle entwickeln
Unternehmen, die sich darauf konzentrieren, zu verstehen, welche Modelle welche Techniken für ihre jeweiligen Aufgaben einsetzen, müssen keine eigenen Modelle entwickeln. Named Entity Recognition (NER) beispielsweise ist ein Teilgebiet der Verarbeitung natürlicher Sprache (Natural Language Processing, NLP), das sich als effektive Technik zur Ermittlung von Schlüsselelementen in semistrukturierten Daten erweist. Ein Beispiel für NER wäre eine Liste, die eine Kategorie wie Wochentage oder eine Beschreibung wie ganze Zahlen größer als 1 und kleiner als 5 umfasst. Dies führt bei der Inferenz zu einer höheren Genauigkeit als regelbasierte Mustererkennungstechniken ohne GenAI-Unterstützung. Mit den weiteren Fortschritten in der Forschung und beim praktischen Einsatz von Techniken wie NER können sich Betriebsteams darauf konzentrieren, bewährte Techniken zu nutzen, anstatt Modelle zu entwickeln.
NER-Beispiel:
Benannte Entität: Wochentage
Liste: Sonntag, Montag, Dienstag, Mittwoch, Donnerstag, Freitag, Samstag
Abbildung 1. Die Erkennung benannter Entitäten bietet bei der Inferenz eine höhere Genauigkeit als der regelbasierte Musterabgleich.
3. Datengravitation ist real
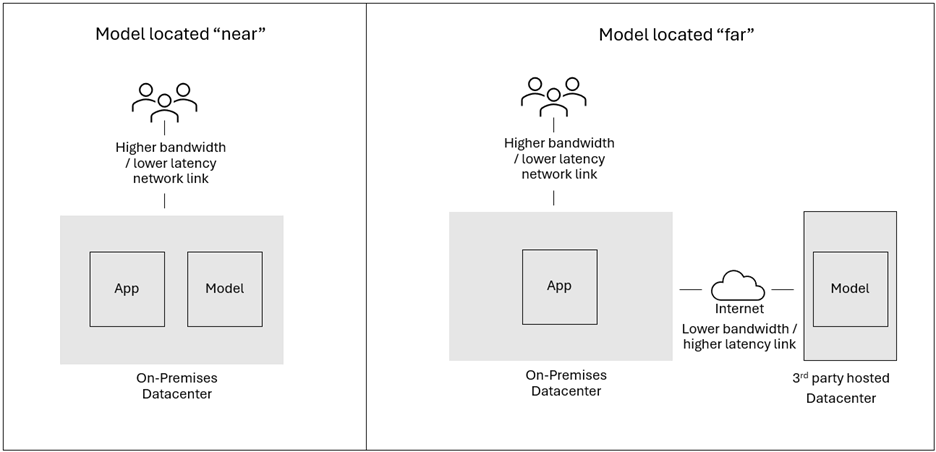
Datengravitation ist eine grundlegende Kraft, die Entscheidungen darüber beeinflusst, ob Rechenkapazität näher am Entstehungsort der Daten bereitgestellt oder die Daten näher an bereits vorhandene Rechenkapazitäten verlagert werden sollen. Je größer das Datenvolumen, desto stärker die Gravitationskraft, sodass mehr Rechenkapazität in der Nähe der Daten bereitgestellt wird. Für das Training (Erstellen und Optimieren von Modellen) werden Daten zusammengeführt und näher an die Rechenkapazität verlagert. Für die Inferenz (Nutzung von Modellen) wird das Modell näher an den Ort verlagert, an dem die Eingabeaufforderung erfolgt.
Wenn auf ein Modell zugegriffen wird, indem eine Kopie davon intern bereitgestellt wird – anstatt die API einer von einem Drittanbieter gehosteten Instanz aufzurufen –, ist es sinnvoll, das Modell näher an den Prompt und/oder an einen zusätzlichen privaten Datensatz zu verlagern, der als Teil des Prompts vektorisiert wird. Wird das Modell hingegen von einem Drittanbieter gehostet, der seine API über das Internet bereitstellt, werden weder das Modell noch die Inferenzvorgänge verlagert. In diesen Fällen können die Inferenz und private Datenvektoren mithilfe einer Colocation-Verbindung zwischen Rechenzentren an einen netzwerknahen Standort verlagert werden. Alternativ kann nach Möglichkeit versucht werden, die Hosting-Standorte auf die des Modellanbieters abzustimmen.
Das Bewusstsein für die Kräfte, die Daten und Rechenleistung zusammenführen, sowie für jene, die sie voneinander trennen, trägt dazu bei, fundierte Entscheidungen zu treffen und das richtige Gleichgewicht zwischen Kosten und Leistung zu finden.
4. Ignorieren Sie Datensilos nicht, sondern gehen Sie sie an
Bei der Verarbeitung mit generativer KI ist es wichtiger denn je, Datensilos aufzubrechen, um die Analyse operativer Daten zu vereinfachen und zu beschleunigen. Auf absehbare Zeit werden Datensilos jedoch offenbar bestehen bleiben, wenn sie sich nicht sogar weiter vermehren.
Die Frage ist vielmehr, wie mit Datensilos umzugehen ist und welche technologischen Entscheidungen getroffen werden sollten. Für den Zugriff auf Daten, die an mehreren Orten gespeichert sind, gibt es zwei Möglichkeiten: Die Daten können kopiert und verschoben werden, oder es kann eine logische Datenschicht implementiert werden, die föderierte Abfragen ermöglicht, ohne die Daten zu verschieben. Unabhängig von der gewählten Option hilft es Ihnen bei der Auswahl der erforderlichen Komponenten Ihres Datentechnologie-Stacks – etwa Streaming-Engines, Abfrage-Engines, Datenformate und Kataloge –, vorhandene Streaming-Datenquellen zu identifizieren und operative Anwendungsfälle im Hinblick auf zeitliche Anforderungen und die Aktualität der Daten zu bewerten. Die freie Technologiewahl ermöglicht es Datenteams, sich für die effektivsten und benutzerfreundlichsten Technologien zu entscheiden und dabei Leistung und Kosten gegeneinander abzuwägen. Im Idealfall entwickelt sich die Datenpraxis eines Unternehmens im Laufe der Zeit weiter, wobei das Unternehmen stets flexibel entscheiden kann, was in der jeweiligen Reifephase am besten für seine Anforderungen geeignet ist.
5. Automatisierung ist ein Freund – haben Sie keine Angst davor
Wenn Lösungen um Automatisierung ergänzt werden, lassen sie sich skalieren, indem das implizite Wissen von Fachleuten für Datenschutz und SecOps in einen wiederholbaren, AIOps-gestützten Prozess überführt wird, der von Maschinen ausgeführt werden kann. Erst dann haben Daten-, Sicherheits- und Datenschutzteams die nötigen Kapazitäten, um zusätzliche Intelligenz einzubringen. Diese Intelligenz erhöht die Wirksamkeit von Richtlinien, indem genauer festgelegt wird, wer bestimmte Daten wie lange und zu welchem Zweck nutzen darf. Gleichzeitig wird nachverfolgt, wo sich die Daten befinden, welche Kopien erstellt werden und mit wem sie geteilt werden. Dadurch bleibt mehr Zeit für die strategische Planung, die Bewertung neuer Technologien und die Abstimmung mit den Fachbereichen, um Datenzugriffsrichtlinien zu optimieren und Ausnahmen zu genehmigen.
Geschwindigkeit, Skalierbarkeit und Automatisierung sind Merkmale einer ausgereiften AIOps-Praxis und führen zu besseren Ergebnissen, schnelleren Entscheidungen und einem optimierten Einsatz personeller Ressourcen. GenAI öffnet Türen, die der Technologie bislang verschlossen geblieben sind. Die fünf oben genannten Erkenntnisse dienen IT-, Sicherheits- und Datenschutzteams als Orientierungspunkte, die sie bei der Integration von GenAI in ihre AIOps berücksichtigen können. KI-Modelle, die Nähe der Rechenressourcen zu den Betriebsdaten sowie Daten und Automatisierung bilden zentrale Bestandteile der neuen AIOps-Plattform. In dieser vielfältigen Lernumgebung können Unternehmen die Kultur und die Praktiken des Technologiebetriebs für die heutige und die nachfolgende Generation entwickeln.
Weitere Informationen zu den Auswirkungen generativer KI auf Daten finden Sie im aktuellen Bericht „Digital Enterprise Maturity Index“ von F5.
Über den Autor

Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.