Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur (dieser Artikel)
- Service Discovery in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“. Besuchen Sie auch die neue Seite „Microservices-Lösungen“.
Dies ist der dritte Artikel unserer Reihe über die Entwicklung von Anwendungen mit einer Microservices-Architektur. Der erste Artikel stellt das Microservices-Architekturmuster vor, vergleicht es mit dem monolithischen Architekturmuster und erläutert die Vor- und Nachteile des Einsatzes von Microservices. Der zweite Artikel beschreibt, wie die Clients einer Anwendung über eine als API-Gateway bezeichnete Vermittlungsinstanz mit den Microservices kommunizieren. In diesem Artikel betrachten wir, wie die Dienste innerhalb eines Systems miteinander kommunizieren. Der vierte Artikel befasst sich mit dem eng damit verbundenen Thema der Serviceerkennung.
Einleitung
In einer monolithischen Anwendung rufen sich Komponenten gegenseitig über Methoden- oder Funktionsaufrufe auf Sprachebene auf. Im Gegensatz dazu ist eine auf Microservices basierende Anwendung ein verteiltes System, das auf mehreren Rechnern ausgeführt wird. Jede Serviceinstanz ist in der Regel ein Prozess. Daher müssen Services, wie das folgende Diagramm zeigt, über einen Mechanismus zur Interprozesskommunikation (IPC) miteinander interagieren.
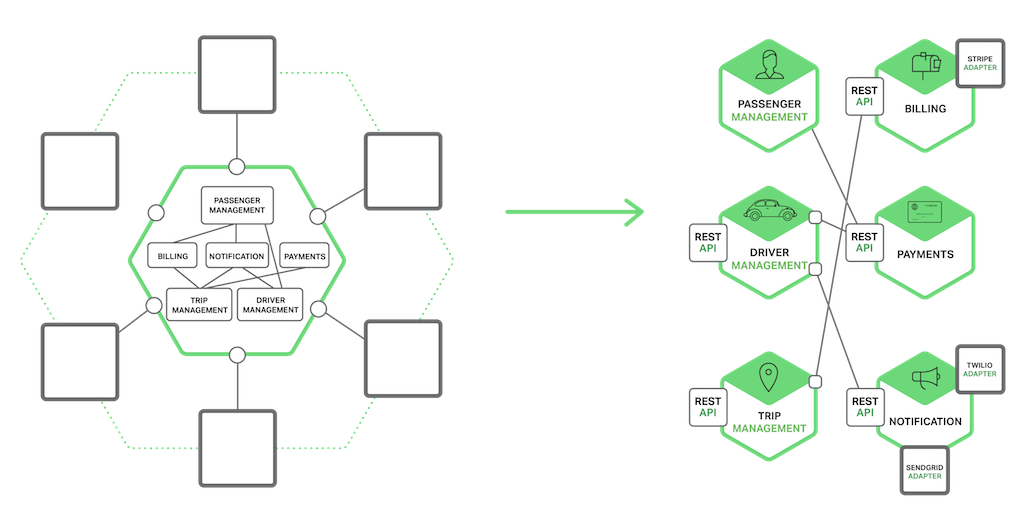
Später werden wir uns mit konkreten IPC-Technologien befassen, doch zunächst wollen wir verschiedene Aspekte des Designs untersuchen.
Interaktionsstile
Bei der Auswahl eines IPC-Mechanismus für einen Dienst ist es sinnvoll, zunächst zu überlegen, wie Dienste miteinander interagieren. Es gibt verschiedene Arten der Client⇔Dienst-Interaktion. Sie lassen sich anhand von zwei Dimensionen kategorisieren. Die erste Dimension beschreibt, ob es sich um eine Eins-zu-eins- oder eine Eins-zu-viele-Interaktion handelt:
- Eins-zu-eins – Jede Clientanfrage wird von genau einer Serviceinstanz verarbeitet.
- Eins-zu-viele – Jede Anfrage wird von mehreren Dienstinstanzen verarbeitet.
Die zweite Dimension betrifft die Frage, ob die Interaktion synchron oder asynchron erfolgt:
- Synchron – Der Client erwartet eine zeitnahe Antwort vom Dienst und blockiert möglicherweise sogar, während er darauf wartet.
- Asynchron – Der Client wird beim Warten auf eine Antwort nicht blockiert, und die Antwort wird, sofern es überhaupt eine gibt, nicht unbedingt sofort gesendet.
Die folgende Tabelle zeigt die verschiedenen Interaktionsstile.
| Eins-zu-eins | Eins-zu-viele | |
|---|---|---|
| Synchron | Anfrage/Antwort | — |
| Asynchron | Benachrichtigung | Veröffentlichen/Abonnieren |
| Anfrage/asynchrone Antwort | Veröffentlichen/asynchrone Antworten |
Es gibt die folgenden Arten von Eins-zu-eins-Interaktionen:
- Anfrage/Antwort – Ein Client sendet eine Anfrage an einen Dienst und wartet auf eine Antwort. Der Client erwartet, dass die Antwort zeitnah eintrifft. In einer Thread-basierten Anwendung kann der Thread, der die Anfrage sendet, während des Wartens sogar blockiert werden.
- Benachrichtigung (auch als Einweganfrage bezeichnet) – Ein Client sendet eine Anfrage an einen Dienst, es wird jedoch keine Antwort erwartet oder gesendet.
- Anfrage/asynchrone Antwort – Ein Client sendet eine Anfrage an einen Dienst, der asynchron antwortet. Der Client wird während des Wartens nicht blockiert und ist darauf ausgelegt, dass die Antwort möglicherweise erst nach einiger Zeit eintrifft.
Es gibt die folgenden Arten von Eins-zu-viele-Interaktionen:
- Publish/Subscribe – Ein Client veröffentlicht eine Benachrichtigung, die von keinem, einem oder mehreren interessierten Diensten verarbeitet wird.
- Veröffentlichen/asynchrone Antworten – Ein Client veröffentlicht eine Anfragenachricht und wartet anschließend eine bestimmte Zeit lang auf Antworten von interessierten Diensten.
Jeder Dienst verwendet in der Regel eine Kombination dieser Interaktionsarten. Für einige Dienste reicht ein einzelner IPC-Mechanismus aus. Andere Dienste müssen möglicherweise mehrere IPC-Mechanismen kombinieren. Das folgende Diagramm zeigt, wie Dienste in einer Taxi-App miteinander interagieren können, wenn ein Benutzer eine Fahrt anfordert.
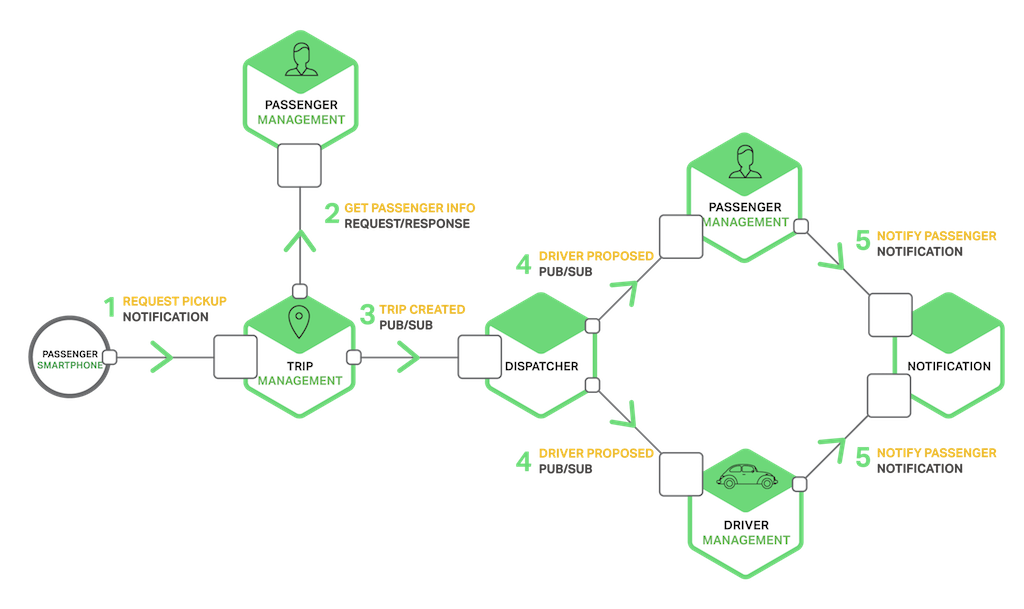
Die Dienste verwenden eine Kombination aus Benachrichtigungen, Anfrage/Antwort und Veröffentlichen/Abonnieren. Beispielsweise sendet das Smartphone des Fahrgasts eine Benachrichtigung an den Dienst „Fahrtverwaltung“, um eine Abholung anzufordern. Der Dienst „Fahrtverwaltung“ überprüft mithilfe von Anfrage/Antwort durch Aufrufen des Fahrgastdienstes, ob das Konto des Fahrgasts aktiv ist. Anschließend erstellt der Dienst „Fahrtverwaltung“ die Fahrt und benachrichtigt mithilfe von Veröffentlichen/Abonnieren andere Dienste, darunter die Disposition, die einen verfügbaren Fahrer ermittelt.
Nachdem wir uns nun mit Interaktionsstilen befasst haben, sehen wir uns an, wie APIs definiert werden.
APIs definieren
Die API eines Dienstes ist ein Vertrag zwischen dem Dienst und seinen Clients. Unabhängig davon, für welchen IPC-Mechanismus Sie sich entscheiden, ist es wichtig, die API eines Dienstes mithilfe einer Schnittstellenbeschreibungssprache (Interface Definition Language, IDL) präzise zu definieren. Es gibt sogar gute Argumente dafür, bei der Definition von Diensten einen API-First-Ansatz zu verfolgen. Sie beginnen die Entwicklung eines Dienstes, indem Sie die Schnittstellendefinition erstellen und gemeinsam mit den Cliententwicklern prüfen. Erst nachdem Sie die API-Definition mehrfach überarbeitet haben, implementieren Sie den Dienst. Wenn Sie diese Entwurfsarbeit im Vorfeld leisten, erhöhen Sie die Wahrscheinlichkeit, einen Dienst zu entwickeln, der die Anforderungen seiner Clients erfüllt.
Wie Sie später in diesem Artikel sehen werden, hängt die Art der API-Definition davon ab, welchen IPC-Mechanismus Sie verwenden. Wenn Sie Messaging verwenden, besteht die API aus den Nachrichtenkanälen und Nachrichtentypen. Wenn Sie HTTP verwenden, besteht die API aus den URLs sowie den Anfrage- und Antwortformaten. Später werden wir einige IDLs ausführlicher beschreiben.
Weiterentwicklung von APIs
Die API eines Dienstes ändert sich im Laufe der Zeit unweigerlich. In einer monolithischen Anwendung ist es in der Regel unkompliziert, die API zu ändern und alle Aufrufer zu aktualisieren. In einer auf Microservices basierenden Anwendung ist dies wesentlich schwieriger, selbst wenn alle Nutzer Ihrer API andere Dienste innerhalb derselben Anwendung sind. Normalerweise können Sie nicht alle Clients dazu zwingen, zeitgleich mit dem Dienst ein Upgrade durchzuführen. Außerdem werden Sie wahrscheinlich neue Versionen eines Dienstes schrittweise bereitstellen, sodass alte und neue Versionen eines Dienstes gleichzeitig ausgeführt werden. Es ist wichtig, eine Strategie für den Umgang mit diesen Herausforderungen zu haben.
Wie Sie mit einer API-Änderung umgehen, hängt vom Umfang der Änderung ab. Manche Änderungen sind geringfügig und abwärtskompatibel mit der vorherigen Version. Sie können beispielsweise Anfragen oder Antworten um Attribute ergänzen. Es ist sinnvoll, Clients und Dienste so zu konzipieren, dass sie das Robustheitsprinzip befolgen. Clients, die eine ältere API verwenden, sollten weiterhin mit der neuen Version des Dienstes funktionieren. Der Dienst stellt Standardwerte für fehlende Anfrageattribute bereit, und die Clients ignorieren zusätzliche Antwortattribute. Es ist wichtig, einen IPC-Mechanismus und ein Nachrichtenformat zu verwenden, mit denen Sie Ihre APIs problemlos weiterentwickeln können.
Manchmal müssen Sie jedoch größere, inkompatible Änderungen an einer API vornehmen. Da Sie Clients nicht zu einem sofortigen Upgrade zwingen können, muss ein Dienst ältere Versionen der API für einen gewissen Zeitraum unterstützen. Wenn Sie einen HTTP-basierten Mechanismus wie REST verwenden, besteht eine Möglichkeit darin, die Versionsnummer in die URL einzubetten. Jede Dienstinstanz kann mehrere Versionen gleichzeitig verarbeiten. Alternativ können Sie verschiedene Instanzen bereitstellen, die jeweils eine bestimmte Version verarbeiten.
Umgang mit Teilausfällen
Betrachten wir zum Beispiel das Produktdetails-Szenario aus diesem Artikel. Nehmen wir an, dass der Empfehlungsdienst nicht reagiert. Eine naive Implementierung eines Clients könnte beim Warten auf eine Antwort auf unbestimmte Zeit blockieren. Dies würde nicht nur die Benutzerfreundlichkeit beeinträchtigen, sondern in vielen Anwendungen auch eine wertvolle Ressource wie einen Thread belegen. Schließlich würden der Laufzeitumgebung die Threads ausgehen und sie würde nicht mehr reagieren, wie in der folgenden Abbildung dargestellt.
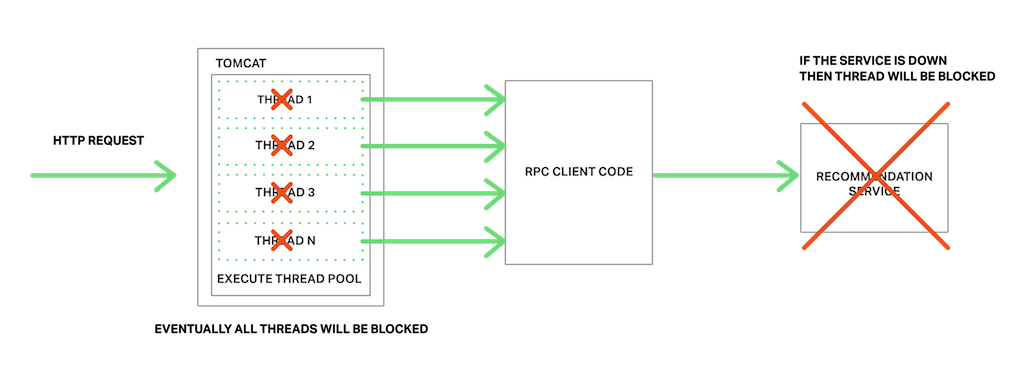
Um dieses Problem zu vermeiden, müssen Sie Ihre Dienste unbedingt so konzipieren, dass sie Teilausfälle bewältigen können.
Ein guter Ansatz ist der von Netflix beschriebene Ansatz. Zu den Strategien für den Umgang mit Teilausfällen gehören:
- Netzwerk-Timeouts – Blockieren Sie niemals auf unbestimmte Zeit und legen Sie beim Warten auf eine Antwort immer ein Zeitlimit fest. Durch die Verwendung von Timeouts wird sichergestellt, dass Ressourcen niemals auf unbestimmte Zeit gebunden sind.
- Begrenzung der Anzahl ausstehender Anfragen – Legen Sie eine Obergrenze für die Anzahl ausstehender Anfragen fest, die ein Client an einen bestimmten Dienst stellen kann. Wenn diese Grenze erreicht ist, sind weitere Anfragen wahrscheinlich nicht sinnvoll und müssen sofort fehlschlagen.
- Circuit-Breaker-Muster – Erfasst die Anzahl der erfolgreichen und fehlgeschlagenen Anfragen. Überschreitet die Fehlerrate einen konfigurierten Schwellenwert, wird der Circuit Breaker ausgelöst, sodass weitere Versuche sofort fehlschlagen. Wenn eine große Anzahl von Anfragen fehlschlägt, deutet dies darauf hin, dass der Dienst nicht verfügbar ist und weitere Anfragen sinnlos sind. Nach Ablauf einer Zeitüberschreitung sollte der Client es erneut versuchen und bei Erfolg den Circuit Breaker schließen.
- Fallbacks bereitstellen – Führen Sie eine Fallback-Logik aus, wenn eine Anfrage fehlschlägt. Geben Sie beispielsweise zwischengespeicherte Daten oder einen Standardwert zurück, etwa eine leere Liste von Empfehlungen.
Netflix Hystrix ist eine Open-Source-Bibliothek, die diese und weitere Muster implementiert. Wenn Sie die JVM verwenden, sollten Sie den Einsatz von Hystrix unbedingt in Betracht ziehen. Wenn Sie in einer Nicht-JVM-Umgebung arbeiten, sollten Sie eine vergleichbare Bibliothek verwenden.
IPC-Technologien
Es stehen zahlreiche unterschiedliche IPC-Technologien zur Auswahl. Dienste können synchrone, auf Anfrage und Antwort basierende Kommunikationsmechanismen wie HTTP-basiertes REST oder Thrift verwenden. Alternativ können sie asynchrone, nachrichtenbasierte Kommunikationsmechanismen wie AMQP oder STOMP nutzen. Darüber hinaus gibt es eine Vielzahl unterschiedlicher Nachrichtenformate. Dienste können menschenlesbare, textbasierte Formate wie JSON oder XML verwenden. Alternativ können sie ein binäres Format wie Avro oder Protocol Buffers nutzen, das effizienter ist. Später werden wir uns mit synchronen IPC-Mechanismen befassen, doch zunächst wollen wir asynchrone IPC-Mechanismen erörtern.
Asynchrone, nachrichtenbasierte Kommunikation
Bei der Verwendung von Messaging kommunizieren Prozesse durch den asynchronen Austausch von Nachrichten. Ein Client sendet eine Nachricht an einen Dienst, um eine Anfrage zu stellen. Wird von dem Dienst eine Antwort erwartet, sendet er eine separate Nachricht an den Client zurück. Da die Kommunikation asynchron erfolgt, wird der Client nicht blockiert, während er auf eine Antwort wartet. Stattdessen wird der Client unter der Annahme implementiert, dass die Antwort nicht sofort eingeht.
Eine Nachricht besteht aus Headern (Metadaten wie dem Absender) und einem Nachrichtenkörper. Nachrichten werden über Kanäle ausgetauscht. Eine beliebige Anzahl von Produzenten kann Nachrichten an einen Kanal senden. Ebenso kann eine beliebige Anzahl von Konsumenten Nachrichten von einem Kanal empfangen. Es gibt zwei Arten von Kanälen: Punkt-zu-Punkt und Publish-Subscribe. Ein Punkt-zu-Punkt-Kanal stellt eine Nachricht genau einem der Konsumenten zu, die den Kanal auslesen. Dienste verwenden Punkt-zu-Punkt-Kanäle für die zuvor beschriebenen Eins-zu-eins-Interaktionsmuster. Ein Publish-Subscribe-Kanal stellt jede Nachricht allen angeschlossenen Konsumenten zu. Dienste verwenden Publish-Subscribe-Kanäle für die oben beschriebenen Eins-zu-viele-Interaktionsmuster.
Das folgende Diagramm zeigt, wie die Taxi-App Publish-Subscribe-Kanäle verwenden könnte.
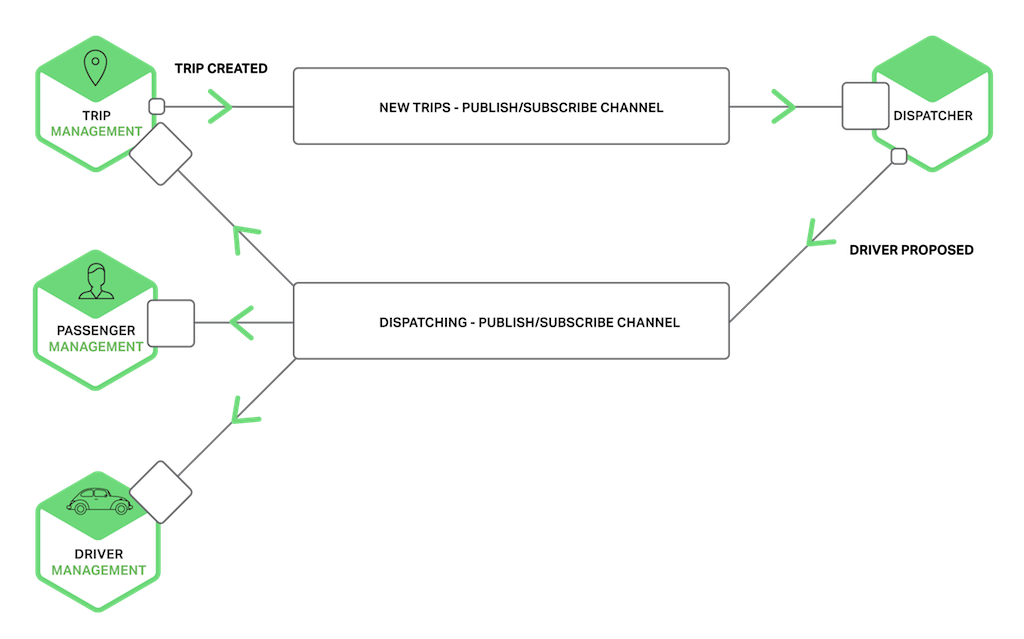
Der Trip-Management-Service benachrichtigt interessierte Services wie den Dispatcher über eine neue Fahrt, indem er eine Trip-Created-Nachricht in einem Publish-Subscribe-Kanal veröffentlicht. Der Dispatcher findet einen verfügbaren Fahrer und benachrichtigt andere Services, indem er eine Driver-Proposed-Nachricht in einem Publish-Subscribe-Kanal veröffentlicht.
Es gibt viele Messaging-Systeme zur Auswahl. Sie sollten eines wählen, das eine Vielzahl von Programmiersprachen unterstützt. Einige Messaging-Systeme unterstützen Standardprotokolle wie AMQP und STOMP. Andere Messaging-Systeme verwenden proprietäre, aber dokumentierte Protokolle. Es steht eine große Zahl von Open-Source-Messaging-Systemen zur Auswahl, darunter RabbitMQ, Apache Kafka, Apache ActiveMQ und NSQ. Auf einer übergeordneten Ebene unterstützen sie alle irgendeine Form von Nachrichten und Kanälen. Sie alle sind auf Zuverlässigkeit, hohe Leistung und Skalierbarkeit ausgelegt. In den Details des Messaging-Modells der einzelnen Broker gibt es jedoch erhebliche Unterschiede.
Die Verwendung von Messaging bietet viele Vorteile:
- Entkoppelt den Client vom Dienst – Ein Client stellt eine Anfrage, indem er einfach eine Nachricht an den entsprechenden Kanal sendet. Die Dienstinstanzen sind dem Client völlig unbekannt. Er muss keinen Ermittlungsmechanismus verwenden, um den Standort einer Dienstinstanz zu bestimmen.
- Nachrichtenpufferung – Bei einem synchronen Anfrage-Antwort-Protokoll wie HTTP müssen sowohl der Client als auch der Dienst während des gesamten Austauschs verfügbar sein. Im Gegensatz dazu stellt ein Message Broker die in einen Kanal geschriebenen Nachrichten so lange in eine Warteschlange, bis sie vom Empfänger verarbeitet werden können. Das bedeutet beispielsweise, dass ein Onlineshop Bestellungen von Kunden auch dann annehmen kann, wenn das Auftragsabwicklungssystem langsam oder nicht verfügbar ist. Die Bestellnachrichten werden einfach in die Warteschlange gestellt.
- Flexible Client-Service-Interaktionen – Messaging unterstützt alle zuvor beschriebenen Interaktionsmuster.
- Explizite Interprozesskommunikation – RPC-basierte Mechanismen versuchen, den Aufruf eines Remote-Dienstes wie den Aufruf eines lokalen Dienstes erscheinen zu lassen. Aufgrund der physikalischen Gesetze und der Möglichkeit von Teilausfällen unterscheiden sich beide jedoch erheblich. Messaging macht diese Unterschiede sehr deutlich, damit sich Entwickler nicht in falscher Sicherheit wiegen.
Die Verwendung von Messaging hat jedoch auch einige Nachteile:
- Zusätzliche betriebliche Komplexität – Das Messaging-System ist eine weitere Systemkomponente, die installiert, konfiguriert und betrieben werden muss. Der Message Broker muss unbedingt hochverfügbar sein, da andernfalls die Zuverlässigkeit des Systems beeinträchtigt wird.
- Komplexität bei der Implementierung einer anfrage-/antwortbasierten Interaktion – Die Implementierung einer Interaktion nach dem Anfrage-Antwort-Prinzip ist mit einem gewissen Aufwand verbunden. Jede Anfragenachricht muss eine Kennung für den Antwortkanal und eine Korrelationskennung enthalten. Der Dienst schreibt eine Antwortnachricht mit der Korrelations-ID in den Antwortkanal. Der Client verwendet die Korrelations-ID, um die Antwort der Anfrage zuzuordnen. Häufig ist es einfacher, einen IPC-Mechanismus zu verwenden, der Anfrage-Antwort-Interaktionen direkt unterstützt.
Nachdem wir uns nun mit der Verwendung von Messaging-basierter IPC befasst haben, wollen wir uns als Nächstes die anfrage-/antwortbasierte IPC ansehen.
Synchrone Anfrage-Antwort-IPC
Bei Verwendung eines synchronen, auf Anfragen und Antworten basierenden IPC-Mechanismus sendet ein Client eine Anfrage an einen Dienst. Der Dienst verarbeitet die Anfrage und sendet eine Antwort zurück. Bei vielen Clients wird der Thread, der die Anfrage stellt, blockiert, während er auf eine Antwort wartet. Andere Clients verwenden möglicherweise asynchronen, ereignisgesteuerten Clientcode, der gegebenenfalls durch Futures oder Rx Observables gekapselt ist. Anders als bei der Verwendung von Messaging geht der Client jedoch davon aus, dass die Antwort zeitnah eintrifft. Es stehen zahlreiche Protokolle zur Auswahl. Zwei beliebte Protokolle sind REST und Thrift. Sehen wir uns zunächst REST an.
REST
Heutzutage ist es üblich, APIs im RESTful-Stil zu entwickeln. REST ist ein IPC-Mechanismus, der (fast immer) HTTP verwendet. Ein zentrales Konzept von REST ist die Ressource, die in der Regel ein Geschäftsobjekt wie einen Kunden oder ein Produkt oder eine Sammlung von Geschäftsobjekten darstellt. REST verwendet die HTTP-Verben zur Bearbeitung von Ressourcen, auf die über eine URL verwiesen wird. Beispielsweise gibt eine GET-Anfrage die Repräsentation einer Ressource zurück, etwa in Form eines XML-Dokuments oder JSON-Objekts. Eine POST-Anfrage erstellt eine neue Ressource, und eine PUT-Anfrage aktualisiert eine Ressource. Um Roy Fielding, den Schöpfer von REST, zu zitieren:
„REST stellt eine Reihe architektonischer Einschränkungen bereit, die in ihrer Gesamtheit die Skalierbarkeit der Interaktionen zwischen Komponenten, die Allgemeingültigkeit von Schnittstellen, die unabhängige Bereitstellung von Komponenten sowie den Einsatz von Vermittlungskomponenten fördern, um die Latenz bei Interaktionen zu verringern, Sicherheitsvorgaben durchzusetzen und Altsysteme zu kapseln.“
Das folgende Diagramm zeigt eine Möglichkeit, wie die Taxi-App REST verwenden könnte.
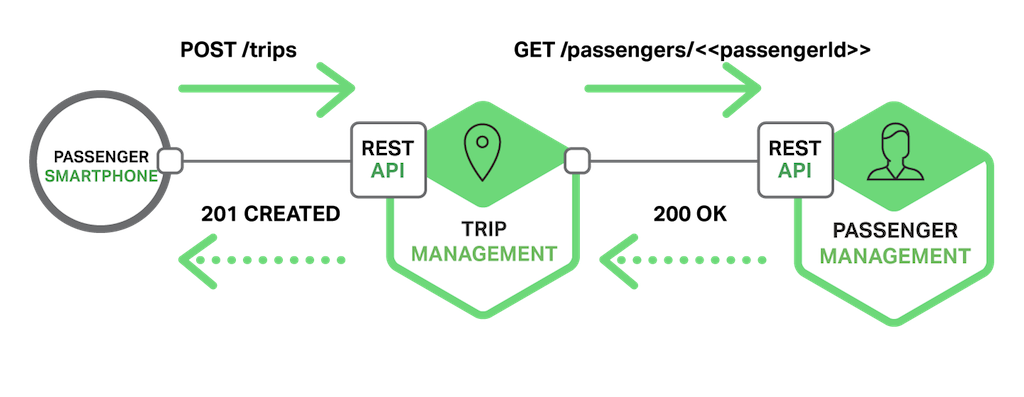
Das Smartphone des Fahrgasts fordert eine Fahrt an, indem es eine POST-Anfrage an die Ressource /trips des Fahrtverwaltungsdienstes sendet. Dieser Dienst verarbeitet die Anfrage, indem er eine GET-Anfrage nach Informationen über den Fahrgast an den Fahrgastverwaltungsdienst sendet. Nachdem überprüft wurde, dass der Fahrgast berechtigt ist, eine Fahrt zu erstellen, erstellt der Fahrtverwaltungsdienst die Fahrt und sendet eine 201-Antwort an das Smartphone zurück.
Viele Entwickler behaupten, ihre HTTP-basierten APIs seien RESTful. Wie Fielding jedoch in diesem Blogbeitrag beschreibt, trifft das nicht auf alle tatsächlich zu. Leonard Richardson (nicht mit dem Autor verwandt) definiert ein sehr nützliches Reifegradmodell für REST, das aus den folgenden Stufen besteht.
- Stufe 0 – Clients einer API der Stufe 0 rufen den Dienst auf, indem sie HTTP-
POST-Anfragen an dessen einzigen URL-Endpunkt senden. Jede Anfrage gibt die auszuführende Aktion, das Ziel der Aktion (z. B. das Geschäftsobjekt) und etwaige Parameter an. - Level 1 – Eine API auf Level 1 unterstützt das Konzept von Ressourcen. Um eine Aktion für eine Ressource auszuführen, sendet ein Client eine
POST-Anfrage, in der die auszuführende Aktion und etwaige Parameter angegeben werden. - Stufe 2 – Eine API der Stufe 2 verwendet HTTP-Verben, um Aktionen auszuführen:
GETzum Abrufen,POSTzum Erstellen undPUTzum Aktualisieren. Die Abfrageparameter und gegebenenfalls der Textkörper der Anfrage geben die Parameter der Aktion an. Dadurch können Dienste Webinfrastruktur wie Caching fürGET-Anfragen nutzen. - Level 3 – Das Design einer Level-3-API basiert auf dem unglücklich benannten HATEOAS-Prinzip (Hypertext As The Engine Of Application State). Die Grundidee besteht darin, dass die von einer
GET-Anfrage zurückgegebene Repräsentation einer Ressource Links enthält, über die die zulässigen Aktionen für diese Ressource ausgeführt werden können. Beispielsweise kann ein Client eine Bestellung über einen Link in der Bestellungsrepräsentation stornieren, die als Antwort auf die zum Abrufen der Bestellung gesendeteGET-Anfrage zurückgegeben wurde. Zu den Vorteilen von HATEOAS gehört, dass URLs nicht mehr fest im Clientcode hinterlegt werden müssen. Ein weiterer Vorteil besteht darin, dass die Repräsentation einer Ressource Links für die zulässigen Aktionen enthält, sodass der Client nicht erraten muss, welche Aktionen im aktuellen Zustand der Ressource ausgeführt werden können.
Die Verwendung eines auf HTTP basierenden Protokolls bietet zahlreiche Vorteile:
- HTTP ist einfach und vertraut.
- Sie können eine HTTP-API in einem Browser mit einer Erweiterung wie Postman oder über die Befehlszeile mit
curltesten (sofern JSON oder ein anderes Textformat verwendet wird). - Es unterstützt direkt die Kommunikation nach dem Anfrage-Antwort-Prinzip.
- HTTP ist natürlich Firewall-freundlich.
- Es ist kein zwischengeschalteter Broker erforderlich, was die Systemarchitektur vereinfacht.
Die Verwendung von HTTP hat einige Nachteile:
- Es unterstützt direkt nur Interaktionen nach dem Anfrage-Antwort-Prinzip. HTTP kann zwar für Benachrichtigungen verwendet werden, der Server muss jedoch immer eine HTTP-Antwort senden.
- Da Client und Dienst direkt miteinander kommunizieren (ohne eine Zwischeninstanz, die Nachrichten zwischenspeichert), müssen beide während des gesamten Austauschs aktiv sein.
- Der Client muss den Standort (d. h. die URL) jeder Serviceinstanz kennen. Wie im vorherigen Artikel über das API-Gateway beschrieben, ist dies in einer modernen Anwendung kein triviales Problem. Clients müssen einen Service-Discovery-Mechanismus verwenden, um Serviceinstanzen zu finden.
Die Entwickler-Community hat kürzlich den Wert einer Schnittstellenbeschreibungssprache für RESTful APIs wiederentdeckt. Es stehen einige Optionen zur Auswahl, darunter RAML und Swagger. Mit einigen IDLs wie Swagger lässt sich das Format von Anfrage- und Antwortnachrichten definieren. Andere wie RAML erfordern die Verwendung einer separaten Spezifikation wie JSON Schema. Neben der Beschreibung von APIs bieten IDLs in der Regel auch Tools, die aus einer Schnittstellendefinition Client-Stubs und Server-Skelette generieren.
Thrift
Apache Thrift ist eine interessante Alternative zu REST. Es handelt sich um ein Framework zur Entwicklung sprachübergreifender RPC-Clients und -Server. Thrift stellt eine IDL im C-Stil zur Definition Ihrer APIs bereit. Mit dem Thrift-Compiler generieren Sie clientseitige Stubs und serverseitige Grundgerüste. Der Compiler erzeugt Code für verschiedene Sprachen, darunter C++, Java, Python, PHP, Ruby, Erlang und Node.js.
Eine Thrift-Schnittstelle besteht aus einem oder mehreren Diensten. Eine Dienstdefinition entspricht einer Java-Schnittstelle. Sie ist eine Sammlung stark typisierter Methoden. Thrift-Methoden können entweder einen Wert (möglicherweise void) zurückgeben oder als unidirektional definiert werden. Methoden, die einen Wert zurückgeben, implementieren das Anfrage-Antwort-Interaktionsmuster. Der Client wartet auf eine Antwort und löst möglicherweise eine Ausnahme aus. Unidirektionale Methoden entsprechen dem Benachrichtigungs-Interaktionsmuster. Der Server sendet keine Antwort.
Thrift unterstützt verschiedene Nachrichtenformate: JSON, Binärformat und kompaktes Binärformat. Das Binärformat ist effizienter als JSON, da es schneller dekodiert werden kann. Und wie der Name schon sagt, ist das kompakte Binärformat besonders platzsparend. JSON ist natürlich benutzer- und browserfreundlich. Bei Thrift können Sie außerdem zwischen verschiedenen Transportprotokollen wählen, darunter Raw-TCP und HTTP. Raw-TCP ist wahrscheinlich effizienter als HTTP. HTTP ist jedoch firewall-, browser- und benutzerfreundlich.
Nachrichtenformate
Nachdem wir uns nun mit HTTP und Thrift befasst haben, wollen wir uns dem Thema Nachrichtenformate zuwenden. Wenn Sie ein Messaging-System oder REST verwenden, können Sie Ihr Nachrichtenformat selbst wählen. Andere IPC-Mechanismen wie Thrift unterstützen möglicherweise nur wenige Nachrichtenformate, vielleicht sogar nur eines. In jedem Fall ist es wichtig, ein sprachübergreifendes Nachrichtenformat zu verwenden. Selbst wenn Sie Ihre Microservices heute nur in einer einzigen Sprache schreiben, werden Sie in Zukunft wahrscheinlich auch andere Sprachen einsetzen.
Es gibt zwei Hauptarten von Nachrichtenformaten: textbasierte und binäre Formate. Beispiele für textbasierte Formate sind JSON und XML. Ein Vorteil dieser Formate besteht darin, dass sie nicht nur für Menschen lesbar, sondern auch selbstbeschreibend sind. In JSON werden die Attribute eines Objekts durch eine Sammlung von Name-Wert-Paaren dargestellt. In XML werden die Attribute entsprechend durch benannte Elemente und Werte dargestellt. Dadurch kann der Empfänger einer Nachricht die für ihn relevanten Werte herausgreifen und den Rest ignorieren. Folglich können kleinere Änderungen am Nachrichtenformat problemlos abwärtskompatibel sein.
Die Struktur von XML-Dokumenten wird durch ein XML-Schema festgelegt. Im Laufe der Zeit hat die Entwicklergemeinschaft erkannt, dass auch JSON einen ähnlichen Mechanismus benötigt. Eine Möglichkeit ist die Verwendung von JSON Schema, entweder eigenständig oder als Teil einer IDL wie Swagger.
Ein Nachteil eines textbasierten Nachrichtenformats besteht darin, dass die Nachrichten in der Regel sehr umfangreich sind, insbesondere bei XML. Da die Nachrichten selbstbeschreibend sind, enthält jede Nachricht neben den Attributwerten auch die Namen der Attribute. Ein weiterer Nachteil ist der Aufwand für das Parsen von Text. Daher sollten Sie möglicherweise die Verwendung eines Binärformats in Betracht ziehen.
Es stehen mehrere Binärformate zur Auswahl. Wenn Sie Thrift RPC verwenden, können Sie das binäre Thrift-Format nutzen. Wenn Sie das Nachrichtenformat selbst wählen können, gehören Protocol Buffers und Apache Avro zu den gängigen Optionen. Beide Formate bieten eine typisierte IDL zur Definition der Struktur Ihrer Nachrichten. Ein Unterschied besteht jedoch darin, dass Protocol Buffers mit markierten Feldern arbeitet, während ein Avro-Consumer das Schema kennen muss, um Nachrichten interpretieren zu können. Daher lässt sich eine API mit Protocol Buffers leichter weiterentwickeln als mit Avro. Dieser Blogbeitrag bietet einen hervorragenden Vergleich von Thrift, Protocol Buffers und Avro.
Zusammenfassung
Microservices müssen über einen Mechanismus zur Interprozesskommunikation miteinander kommunizieren. Bei der Konzeption der Kommunikation zwischen Ihren Services müssen Sie verschiedene Aspekte berücksichtigen: wie die Services interagieren, wie die API für jeden Service spezifiziert wird, wie die APIs weiterentwickelt werden und wie mit Teilausfällen umzugehen ist. Microservices können zwei Arten von IPC-Mechanismen nutzen: asynchrones Messaging und synchrone Anfrage/Antwort-Kommunikation. Im nächsten Artikel dieser Reihe befassen wir uns mit dem Problem der Serviceerkennung in einer Microservices-Architektur.
Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur (dieser Artikel)
- Service Discovery in einer Microservices-Architektur
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe sowie Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Design bis zur Bereitstellung“.
Gastautor Chris Richardson ist der Gründer der ursprünglichen Plattform CloudFoundry.com, einer frühen Java-PaaS-Lösung (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Beiträge über Microservices auf http://microservices.io.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.