Redaktion – Diese siebenteilige Artikelserie ist nun vollständig:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Service Discovery in einer Microservices-Architektur (dieser Artikel)
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe mit zusätzlichen Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“. Werfen Sie auch einen Blick auf die neue Seite „Microservices-Lösungen“.
Dies ist der vierte Artikel unserer Reihe über die Entwicklung von Anwendungen mit Microservices. Der erste Artikel stellt das Microservices-Architekturmuster vor und erörtert die Vor- und Nachteile des Einsatzes von Microservices. Der zweite<.htmla> und der dritte Artikel der Reihe beschreiben verschiedene Aspekte der Kommunikation innerhalb einer Microservices-Architektur. In diesem Artikel befassen wir uns mit dem eng damit verbundenen Thema der Serviceerkennung.
Warum Service Discovery verwenden?
Stellen wir uns vor, Sie schreiben Code, der einen Dienst mit einer REST-API oder Thrift-API aufruft. Um eine Anfrage zu stellen, muss Ihr Code den Netzwerkstandort (IP-Adresse und Port) einer Dienstinstanz kennen. Bei einer herkömmlichen Anwendung, die auf physischer Hardware ausgeführt wird, sind die Netzwerkstandorte der Dienstinstanzen relativ statisch. Ihr Code kann die Netzwerkstandorte beispielsweise aus einer Konfigurationsdatei auslesen, die gelegentlich aktualisiert wird.
In einer modernen, cloudbasierten Microservices-Anwendung ist dieses Problem jedoch wesentlich schwieriger zu lösen, wie die folgende Abbildung zeigt.
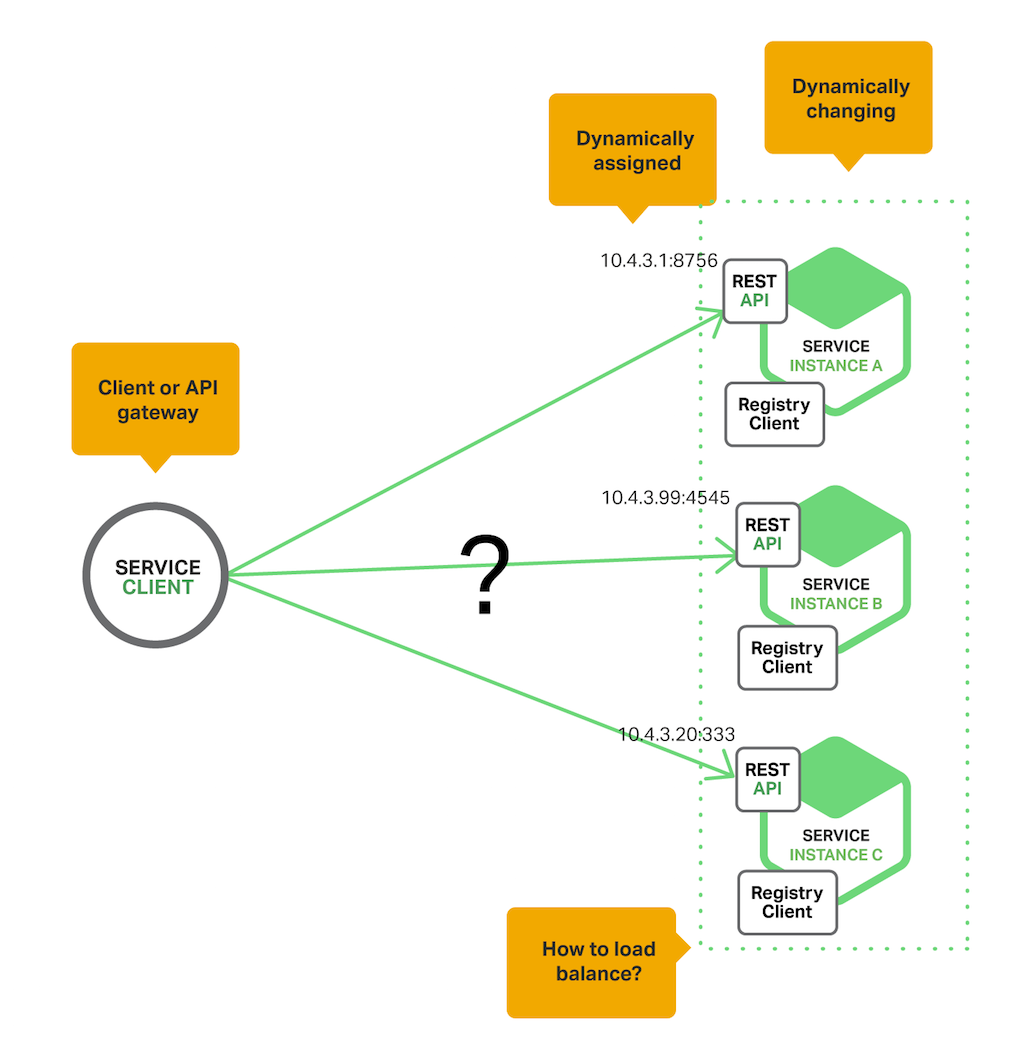
Dienstinstanzen verfügen über dynamisch zugewiesene Netzwerkadressen. Darüber hinaus ändert sich die Menge der Dienstinstanzen aufgrund von automatischer Skalierung, Ausfällen und Upgrades fortlaufend. Daher muss Ihr Clientcode einen ausgefeilteren Mechanismus zur Diensterkennung verwenden.
Es gibt zwei grundlegende Muster für die Serviceerkennung: clientseitige Serviceerkennung und serverseitige Serviceerkennung. Sehen wir uns zunächst die clientseitige Serviceerkennung an.
Das clientseitige Service-Discovery-Muster
Bei Verwendung der clientseitigen Diensterkennung ist der Client dafür verantwortlich, die Netzwerkadressen der verfügbaren Dienstinstanzen zu ermitteln und die Anfragen auf diese zu verteilen. Der Client fragt eine Dienstregistrierung ab, also eine Datenbank der verfügbaren Dienstinstanzen. Anschließend wählt er mithilfe eines Lastverteilungsalgorithmus eine der verfügbaren Dienstinstanzen aus und sendet eine Anfrage.
Das folgende Diagramm zeigt die Struktur dieses Musters.
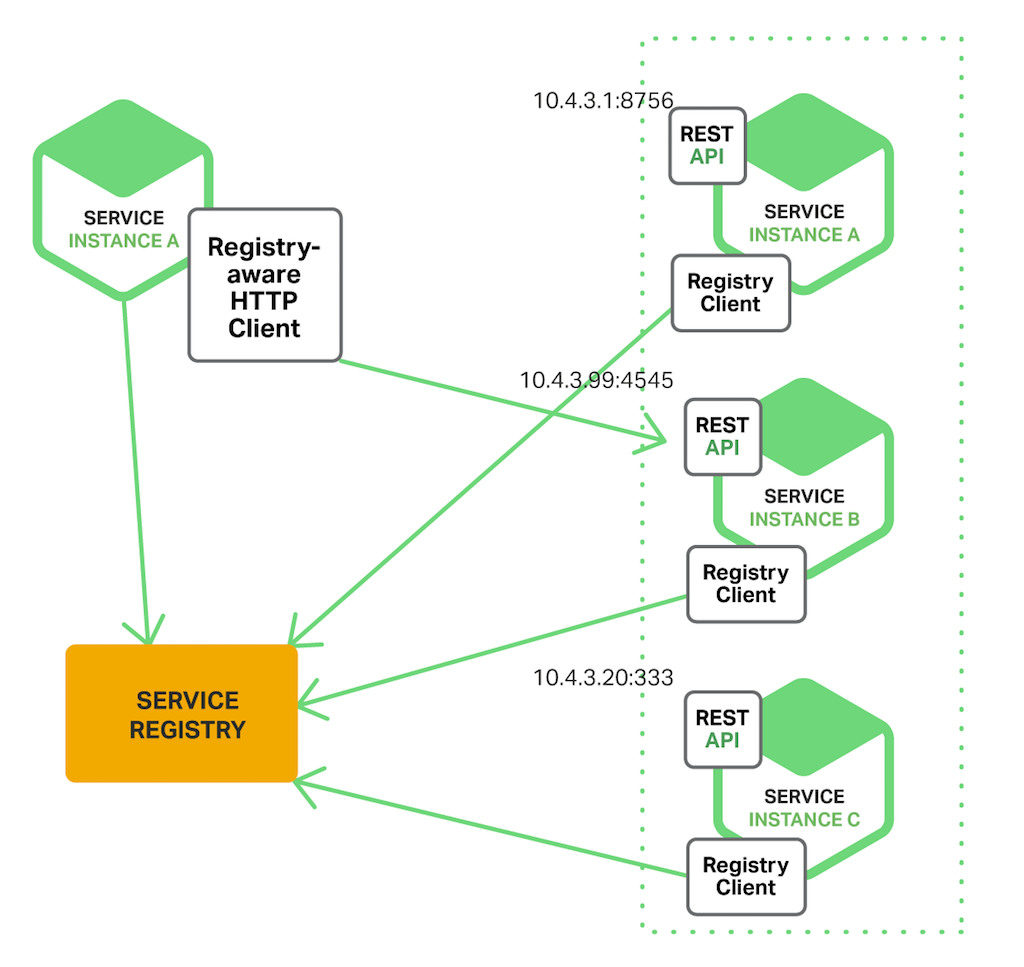
Der Netzwerkstandort einer Serviceinstanz wird beim Start im Serviceverzeichnis registriert. Beim Beenden der Instanz wird er aus dem Serviceverzeichnis entfernt. Die Registrierung der Serviceinstanz wird in der Regel regelmäßig mithilfe eines Heartbeat-Mechanismus aktualisiert.
Netflix OSS ist ein hervorragendes Beispiel für das clientseitige Service-Discovery-Muster. Netflix Eureka ist eine Service-Registry. Sie stellt eine REST-API bereit, mit der sich Serviceinstanzen registrieren und verfügbare Instanzen abfragen lassen. Netflix Ribbon ist ein IPC-Client, der mit Eureka zusammenarbeitet, um Anfragen per Lastverteilung auf die verfügbaren Serviceinstanzen zu verteilen. Im weiteren Verlauf dieses Artikels gehen wir näher auf Eureka ein.
Das clientseitige Service-Discovery-Muster bietet verschiedene Vor- und Nachteile. Dieses Muster ist relativ unkompliziert und umfasst abgesehen von der Service-Registry keine weiteren beweglichen Komponenten. Da der Client außerdem die verfügbaren Serviceinstanzen kennt, kann er intelligente, anwendungsspezifische Entscheidungen zur Lastverteilung treffen, beispielsweise durch den Einsatz von Consistent Hashing. Ein wesentlicher Nachteil dieses Musters besteht darin, dass es den Client an die Service-Registry koppelt. Sie müssen die Logik für die clientseitige Service Discovery für jede Programmiersprache und jedes Framework implementieren, die von Ihren Service-Clients verwendet werden.
Nachdem wir uns nun mit der clientseitigen Diensterkennung befasst haben, sehen wir uns als Nächstes die serverseitige Diensterkennung an.
Das Muster der serverseitigen Diensterkennung
Der andere Ansatz für die Serviceerkennung ist das serverseitige Discovery-Muster. Das folgende Diagramm zeigt die Struktur dieses Musters.
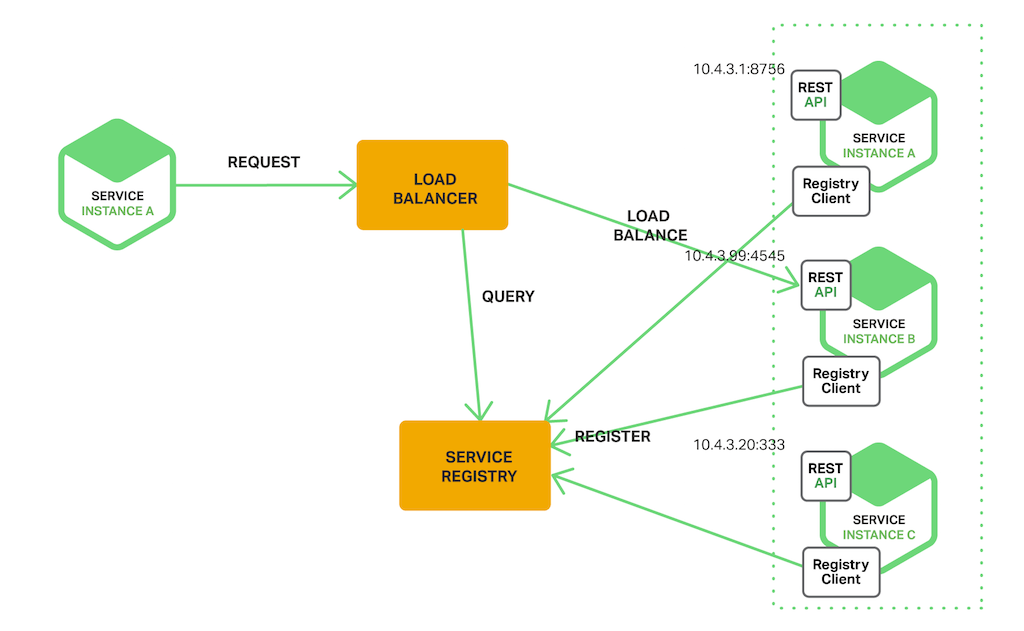
Der Client sendet über einen Load Balancer eine Anfrage an einen Dienst. Der Load Balancer fragt die Service Registry ab und leitet jede Anfrage an eine verfügbare Dienstinstanz weiter. Wie bei der clientseitigen Diensterkennung werden Dienstinstanzen bei der Service Registry registriert und abgemeldet.
Der AWS Elastic Load Balancer (ELB) ist ein Beispiel für einen Router zur serverseitigen Diensterkennung. Ein ELB wird üblicherweise für den Lastenausgleich von externem Datenverkehr aus dem Internet verwendet. Sie können einen ELB jedoch auch für den Lastenausgleich von Datenverkehr innerhalb einer Virtual Private Cloud (VPC) verwenden. Ein Client sendet über den ELB unter Verwendung seines DNS-Namens Anfragen (HTTP oder TCP). Der ELB verteilt den Datenverkehr auf eine Gruppe registrierter Elastic Compute Cloud (EC2)-Instanzen oder EC2 Container Service (ECS)-Container. Es gibt keine separate Dienstregistrierung. Stattdessen werden EC2-Instanzen und ECS-Container direkt beim ELB registriert.
HTTP-Server und Load Balancer wie NGINX Plus und NGINX können ebenfalls als Load Balancer für die serverseitige Serviceerkennung verwendet werden. Dieser Blogbeitrag beschreibt beispielsweise, wie sich Consul Template zur dynamischen Neukonfiguration des NGINX-Reverse-Proxyings einsetzen lässt. Consul Template ist ein Tool, das beliebige Konfigurationsdateien regelmäßig anhand von Konfigurationsdaten neu generiert, die in der Consul-Service-Registry gespeichert sind. Bei jeder Änderung der Dateien führt es einen beliebigen Shell-Befehl aus. In dem im Blogbeitrag beschriebenen Beispiel generiert Consul Template eine nginx.conf-Datei, die das Reverse-Proxying konfiguriert, und führt anschließend einen Befehl aus, der NGINX anweist, die Konfiguration neu zu laden. Eine ausgereiftere Implementierung könnte NGINX Plus dynamisch neu konfigurieren und dazu entweder dessen HTTP-API oder DNS verwenden.
In einigen Bereitstellungsumgebungen wie Kubernetes und Marathon wird auf jedem Host im Cluster ein Proxy ausgeführt. Der Proxy übernimmt die Rolle eines Load Balancers für die serverseitige Diensterkennung. Um eine Anfrage an einen Dienst zu senden, leitet ein Client die Anfrage über den Proxy weiter und verwendet dabei die IP-Adresse des Hosts und den dem Dienst zugewiesenen Port. Der Proxy leitet die Anfrage dann transparent an eine verfügbare Dienstinstanz weiter, die irgendwo im Cluster ausgeführt wird.
Das serverseitige Service-Discovery-Muster hat mehrere Vor- und Nachteile. Ein großer Vorteil dieses Musters besteht darin, dass die Details der Service-Erkennung vor dem Client verborgen werden. Clients senden ihre Anfragen einfach an den Load Balancer. Dadurch entfällt die Notwendigkeit, die Service-Discovery-Logik für jede Programmiersprache und jedes Framework zu implementieren, die von Ihren Service-Clients verwendet werden. Wie bereits erwähnt, stellen einige Bereitstellungsumgebungen diese Funktionalität zudem kostenlos bereit. Dieses Muster hat jedoch auch einige Nachteile. Sofern der Load Balancer nicht von der Bereitstellungsumgebung bereitgestellt wird, handelt es sich um eine weitere hochverfügbare Systemkomponente, die Sie einrichten und verwalten müssen.
Die Service-Registry
Die Dienstregistrierung ist ein zentraler Bestandteil der Diensterkennung. Sie ist eine Datenbank, die die Netzwerkadressen von Dienstinstanzen enthält. Eine Dienstregistrierung muss hochverfügbar und auf dem neuesten Stand sein. Clients können die aus der Dienstregistrierung abgerufenen Netzwerkadressen zwischenspeichern. Diese Informationen veralten jedoch mit der Zeit, sodass Clients Dienstinstanzen nicht mehr erkennen können. Daher besteht eine Dienstregistrierung aus einem Cluster von Servern, die mithilfe eines Replikationsprotokolls die Konsistenz gewährleisten.
Wie bereits erwähnt, ist Netflix Eureka ein gutes Beispiel für eine Service-Registry. Es stellt eine REST-API zum Registrieren und Abfragen von Serviceinstanzen bereit. Eine Serviceinstanz registriert ihren Netzwerkstandort mithilfe einer POST-Anfrage. Alle 30 Sekunden muss sie ihre Registrierung mithilfe einer PUT-Anfrage aktualisieren. Eine Registrierung wird entweder durch eine HTTP-DELETE-Anfrage oder durch das Ablaufen der Registrierung der Instanz entfernt. Wie zu erwarten, kann ein Client die registrierten Serviceinstanzen mithilfe einer HTTP-GET-Anfrage abrufen.
Netflix erreicht eine hohe Verfügbarkeit durch den Betrieb eines oder mehrerer Eureka-Server in jeder Amazon-EC2-Verfügbarkeitszone. Jeder Eureka-Server wird auf einer EC2-Instanz mit einer Elastic-IP-Adresse ausgeführt. DNS-TEXT-Einträge werden zum Speichern der Eureka-Clusterkonfiguration verwendet. Diese ordnet den Verfügbarkeitszonen jeweils eine Liste der Netzwerkadressen von Eureka-Servern zu. Beim Start fragt ein Eureka-Server die DNS-Daten ab, um die Eureka-Clusterkonfiguration abzurufen, seine Peers zu finden und sich selbst eine ungenutzte Elastic-IP-Adresse zuzuweisen.
Eureka-Clients – Dienste und Dienst-Clients – fragen DNS ab, um die Netzwerkadressen von Eureka-Servern zu ermitteln. Clients verwenden bevorzugt einen Eureka-Server in derselben Verfügbarkeitszone. Ist dort jedoch keiner verfügbar, verwendet der Client einen Eureka-Server in einer anderen Verfügbarkeitszone.
Weitere Beispiele für Dienstregistrierungen sind:
- etcd – Ein hochverfügbarer, verteilter und konsistenter Schlüssel-Wert-Speicher, der für die gemeinsame Konfiguration und Diensterkennung verwendet wird. Zwei bekannte Projekte, die etcd verwenden, sind Kubernetes und Cloud Foundry.
- consul – Ein Tool zum Erkennen und Konfigurieren von Diensten. Es stellt eine API bereit, über die Clients Dienste registrieren und erkennen können. Consul kann Zustandsprüfungen durchführen, um die Verfügbarkeit von Diensten zu ermitteln.
- Apache Zookeeper – Ein weit verbreiteter, leistungsstarker Koordinierungsdienst für verteilte Anwendungen. Apache Zookeeper war ursprünglich ein Unterprojekt von Hadoop, ist inzwischen jedoch ein eigenständiges Top-Level-Projekt.
Wie bereits erwähnt, verfügen einige Systeme wie Kubernetes, Marathon und AWS nicht über eine explizite Service-Registry. Stattdessen ist die Service-Registry ein fester Bestandteil der Infrastruktur.
Nachdem wir uns nun mit dem Konzept einer Service-Registry befasst haben, sehen wir uns an, wie Serviceinstanzen bei der Service-Registry registriert werden.
Optionen für die Dienstregistrierung
Wie bereits erwähnt, müssen Dienstinstanzen bei der Dienstregistrierung an- und abgemeldet werden. Für diese An- und Abmeldung gibt es verschiedene Möglichkeiten. Eine davon besteht darin, dass sich die Dienstinstanzen selbst registrieren. Dies wird als „Selbstregistrierungsmuster“ bezeichnet. Eine andere Möglichkeit besteht darin, die Registrierung der Dienstinstanzen durch eine andere Systemkomponente verwalten zu lassen. Dies wird als „Drittanbieter-Registrierungsmuster“ bezeichnet. Sehen wir uns zunächst das Selbstregistrierungsmuster an.
Das Muster der Selbstregistrierung
Bei Verwendung des Selbstregistrierungsmusters ist eine Dienstinstanz dafür verantwortlich, sich selbst bei der Dienstregistrierung zu registrieren und wieder abzumelden. Falls erforderlich, sendet eine Dienstinstanz außerdem Heartbeat-Anfragen, um zu verhindern, dass ihre Registrierung abläuft. Das folgende Diagramm zeigt die Struktur dieses Musters.
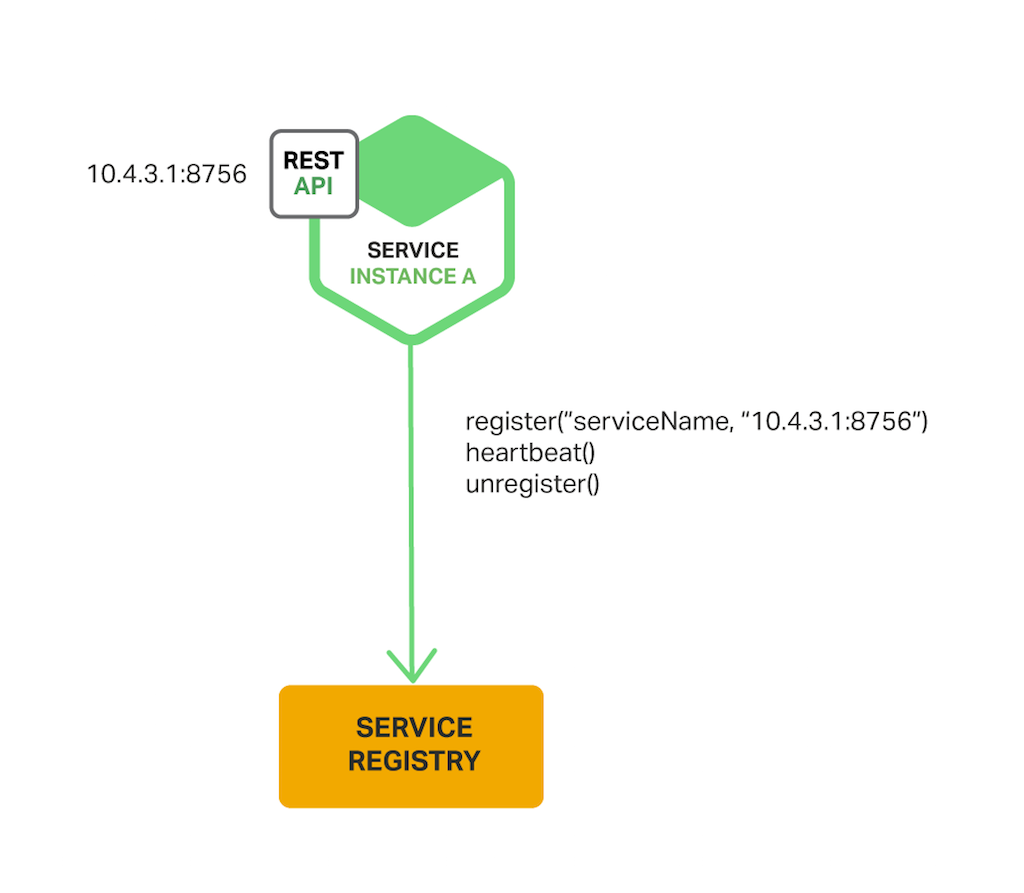
Ein gutes Beispiel für diesen Ansatz ist der Netflix OSS Eureka-Client. Der Eureka-Client übernimmt sämtliche Aspekte der Registrierung und Abmeldung von Serviceinstanzen. Das Spring Cloud-Projekt, das verschiedene Muster einschließlich der Serviceerkennung implementiert, erleichtert die automatische Registrierung einer Serviceinstanz bei Eureka. Sie müssen Ihre Java-Konfigurationsklasse lediglich mit der Annotation @EnableEurekaClient versehen.
Das Selbstregistrierungsmuster hat verschiedene Vor- und Nachteile. Ein Vorteil besteht darin, dass es relativ einfach ist und keine weiteren Systemkomponenten erfordert. Ein wesentlicher Nachteil ist jedoch, dass es die Serviceinstanzen an die Service-Registry koppelt. Sie müssen den Registrierungscode für jede Programmiersprache und jedes Framework implementieren, die von Ihren Services verwendet werden.
Der alternative Ansatz, bei dem die Dienste von der Service Registry entkoppelt werden, ist das Registrierungsmuster durch Drittanbieter.
Das Registrierungsmuster durch Drittanbieter
Bei Verwendung des Registrierungsmusters durch Drittanbieter sind die Dienstinstanzen nicht selbst für ihre Registrierung bei der Dienstregistrierung zuständig. Stattdessen übernimmt eine andere Systemkomponente, der sogenannte Dienstregistrator, die Registrierung. Der Dienstregistrator verfolgt Änderungen an den ausgeführten Instanzen, indem er entweder die Bereitstellungsumgebung abfragt oder Ereignisse abonniert. Sobald er eine neu verfügbare Dienstinstanz erkennt, registriert er sie bei der Dienstregistrierung. Außerdem meldet der Dienstregistrator beendete Dienstinstanzen wieder ab. Das folgende Diagramm zeigt die Struktur dieses Musters.
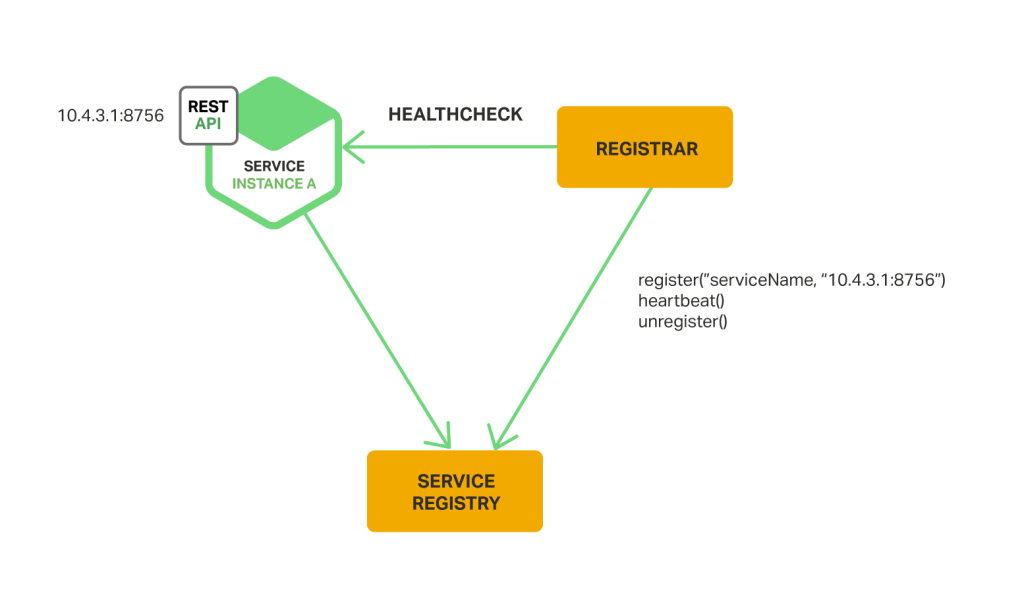
Ein Beispiel für einen Dienstregistrar ist das Open-Source-Projekt „Registrator“. Es registriert Dienstinstanzen, die als Docker-Container bereitgestellt werden, automatisch und hebt deren Registrierung wieder auf. Registrator unterstützt mehrere Dienstregister, darunter etcd und Consul.
Ein weiteres Beispiel für einen Dienstregistrar ist NetflixOSS Prana. Diese Sidecar-Anwendung ist in erster Linie für Dienste vorgesehen, die in Nicht-JVM-Sprachen geschrieben sind, und wird parallel zu einer Dienstinstanz ausgeführt. Prana registriert die Dienstinstanz bei Netflix Eureka und hebt ihre Registrierung wieder auf.
Der Service-Registrar ist eine integrierte Komponente von Bereitstellungsumgebungen. Die von einer Auto Scaling Group erstellten EC2-Instanzen können automatisch bei einem ELB registriert werden. Kubernetes-Services werden automatisch registriert und für die Serviceerkennung verfügbar gemacht.
Das Registrierungsmuster durch Drittanbieter bietet verschiedene Vor- und Nachteile. Ein wesentlicher Vorteil besteht darin, dass die Dienste von der Dienstregistrierung entkoppelt sind. Sie müssen nicht für jede von Ihren Entwicklern verwendete Programmiersprache und jedes Framework eine Logik zur Dienstregistrierung implementieren. Stattdessen wird die Registrierung von Dienstinstanzen zentral durch einen dedizierten Dienst verwaltet.
Ein Nachteil dieses Musters besteht darin, dass es sich – sofern es nicht in die Bereitstellungsumgebung integriert ist – um eine weitere hochverfügbare Systemkomponente handelt, die Sie einrichten und verwalten müssen.
Zusammenfassung
In einer Microservices-Anwendung ändert sich die Menge der ausgeführten Serviceinstanzen dynamisch. Den Instanzen werden dynamisch Netzwerkadressen zugewiesen. Damit ein Client eine Anfrage an einen Service senden kann, muss er daher einen Service-Discovery-Mechanismus verwenden.
Ein zentraler Bestandteil der Serviceerkennung ist die Service-Registry. Die Service-Registry ist eine Datenbank der verfügbaren Serviceinstanzen. Sie stellt eine Verwaltungs-API und eine Abfrage-API bereit. Über die Verwaltungs-API werden Serviceinstanzen in der Service-Registry registriert und daraus entfernt. Die Abfrage-API wird von Systemkomponenten verwendet, um verfügbare Serviceinstanzen zu ermitteln.
Es gibt zwei grundlegende Muster für die Serviceerkennung: die clientseitige und die serverseitige Serviceerkennung. In Systemen mit clientseitiger Serviceerkennung fragen Clients die Service-Registry ab, wählen eine verfügbare Instanz aus und senden eine Anfrage. In Systemen mit serverseitiger Serviceerkennung senden Clients ihre Anfragen über einen Router, der die Service-Registry abfragt und die Anfrage an eine verfügbare Instanz weiterleitet.
Es gibt zwei grundlegende Möglichkeiten, wie Dienstinstanzen bei der Dienstregistrierung registriert und wieder abgemeldet werden. Eine Möglichkeit besteht darin, dass sich die Dienstinstanzen selbst bei der Dienstregistrierung registrieren. Dies wird als „Selbstregistrierungsmuster“ bezeichnet. Die andere Möglichkeit besteht darin, dass eine andere Systemkomponente die Registrierung und Abmeldung im Namen des Dienstes übernimmt. Dies wird als „Drittanbieter-Registrierungsmuster“ bezeichnet.
In einigen Bereitstellungsumgebungen müssen Sie mithilfe einer Service-Registry wie Netflix Eureka, etcd oder Apache Zookeeper eine eigene Infrastruktur für die Serviceerkennung einrichten. In anderen Bereitstellungsumgebungen ist die Serviceerkennung bereits integriert. Beispielsweise übernehmen Kubernetes und Marathon die Registrierung und Deregistrierung von Serviceinstanzen. Außerdem führen sie auf jedem Cluster-Host einen Proxy aus, der als Router für die serverseitige Serviceerkennung fungiert.
Ein HTTP-Reverse-Proxy und Load Balancer wie NGINX kann auch als Load Balancer für die serverseitige Serviceerkennung eingesetzt werden. Die Service Registry kann die Routing-Informationen an NGINX übertragen und eine unterbrechungsfreie Aktualisierung der Konfiguration auslösen; beispielsweise können Sie Consul Template verwenden. NGINX Plus unterstützt zusätzliche Mechanismen zur dynamischen Neukonfiguration – es kann mithilfe von DNS Informationen zu Serviceinstanzen aus der Registry abrufen und stellt eine API für die Remote-Neukonfiguration bereit.
In zukünftigen Blogbeiträgen werden wir weitere Aspekte von Microservices näher beleuchten. Melden Sie sich über das unten stehende Formular für den NGINX-Newsletter an, um über die Veröffentlichung weiterer Artikel dieser Reihe informiert zu werden.
Redaktion – Diese siebenteilige Artikelreihe ist nun abgeschlossen:
- Einführung in Microservices
- Microservices entwickeln: Verwendung eines API-Gateways
- Microservices entwickeln: Interprozesskommunikation in einer Microservices-Architektur
- Service Discovery in einer Microservices-Architektur (dieser Artikel)
- Ereignisgesteuertes Datenmanagement für Microservices
- Auswahl einer Bereitstellungsstrategie für Microservices
- Refactoring eines Monolithen in Microservices
Sie können außerdem die vollständige Artikelreihe sowie Informationen zur Implementierung von Microservices mit NGINX Plus als E-Book herunterladen: „Microservices: Vom Entwurf bis zur Bereitstellung“.
Gastautor Chris Richardson ist der Gründer des ursprünglichen CloudFoundry.com, einer frühen Java-PaaS-Lösung (Platform as a Service) für Amazon EC2. Heute berät er Unternehmen dabei, die Entwicklung und Bereitstellung ihrer Anwendungen zu verbessern. Außerdem veröffentlicht er regelmäßig Blogbeiträge über Microservices auf https://microservices.io.
Ähnliche Blogbeiträge

Die Zukunft von NGINX: Zurück zu unseren Open-Source-Wurzeln
Beim NGINX Sprint 2022 besinnen wir uns auf unsere Open-Source-Wurzeln. Erfahren Sie mehr über die Initiativen, die wir im kommenden Jahr verfolgen, und teilen Sie uns mit, was Sie sich wünschen.

Ein Leitfaden zur Auswahl eines Ingress-Controllers, Teil 1: Ermitteln Sie Ihre Anforderungen
Ein Ingress-Controller kann eines der leistungsstärksten Tools in Ihrem Kubernetes-Stack sein. Erfahren Sie, wie Sie Ihre Ingress-Anforderungen ermitteln, um die beste Option auszuwählen.
Bereitstellung des NGINX Ingress Controllers auf Amazon EKS: So haben wir getestet
Wir haben kürzlich den Lösungsleitfaden zum NGINX Ingress Controller um Empfehlungen zur Dimensionierung für Amazon Elastic Kubernetes Service (EKS) ergänzt. In diesem Blogbeitrag erläutern wir, wie wir diese Empfehlungen erarbeitet haben, und stellen Ihnen alle Informationen zur Verfügung, die Sie benötigen, um selbst ähnliche Tests durchzuführen.

Protokollierung des Datenverkehrs zwischen NGINX und Upstream-Servern bei CDN77
Bei der Fehlersuche bei Datenverkehrsproblemen zwischen NGINX und Upstream-Servern konnte CDN77 die benötigten Daten nur aus dem Fehlerprotokoll mit aktivierter Debug-Ausgabe beziehen, was die Leistung beeinträchtigt und riesige Dateien erzeugt. Daher entwickelte das Team ein neues benutzerdefiniertes Modul, das ausschließlich die benötigten Daten protokolliert.
Ankündigung von NGINX Plus R16
NGINX Plus R16 ist eine einheitliche, elastische Ingress- und Egress-Schicht für Anwendungen, die die Funktionen eines Load Balancers, API-Gateways und einer WAF vereint und neue Features wie clusterfähige Ratenbegrenzung, Schlüssel-Wert-Speicher, „Random with Two Choices“, verbessertes UDP-Load-Balancing und vieles mehr bietet.
5 Gründe für den Umstieg auf softwarebasiertes Load Balancing
Entdecken Sie fünf Gründe für den Wechsel zu einem softwarebasierten Load Balancer wie NGINX Plus, darunter Kosteneinsparungen, die Einführung von DevOps und eine einheitliche Lösung für alle Umgebungen.