Die Renaissance der Infrastruktur hat ein Schlagwort: Server sollen Serveraufgaben übernehmen und Inferenzsysteme die Inferenz.
In den Anfangsjahren der Technologie verbrachte ich Jahre damit, SSL-Beschleuniger zu testen und zu analysieren. Diese kleinen Karten sollten ein erhebliches Problem lösen, das durch das explosionsartige Wachstum digitaler Geschäftsmodelle und des Onlinehandels entstanden war: SSL-basierte Sicherheitsfunktionen beanspruchten CPU-Ressourcen und verursachten erhebliche Leistungseinbußen. Daher entwickelte die Branche – einschließlich F5 – Hardware, um diese Funktionen auszulagern und Server ihre eigentliche Arbeit erledigen zu lassen.
Heute sehen wir, dass bei KI – insbesondere bei der Inferenz – dieselben Probleme auftreten, und ironischerweise kommen auch dieselben Lösungsansätze auf: spezialisierte Hardware, die dafür sorgt, dass Server sich auf ihre eigentliche Aufgabe konzentrieren können und Inferenzen von dedizierter Hardware ausgeführt werden.
Ja, ich bin mir nicht sicher, ob das grammatikalisch korrekt ist, aber belassen wir es fürs Erste dabei, okay? Thx.
Wie bereits erwähnt, sind KI-Anwendungen hinsichtlich ihrer Architektur moderne Anwendungen. Doch das Herzstück einer KI-Anwendung ist die Inferenz, und genau darin unterscheidet sich KI von „normalen“ modernen Anwendungen.
Inferenz in der Praxis
Wir haben gesehen, wie KI-Rechenzentren aus Gruppen von CPUs und GPUs aufgebaut sind. Bei diesen Rechenressourcen müssen bestimmte Verhältnisse und ein ausgewogenes Zusammenspiel gewahrt werden, damit der Cluster effizient arbeitet. Jedes Mal, wenn eine CPU nicht mithalten kann, bleibt eine sehr teure GPU ungenutzt.
Denn tatsächlich entfällt nur ein Teil der Verarbeitung auf einem Inferenzserver auf die eigentliche Inferenz. Ein Großteil besteht aus der üblichen Webverarbeitung von HTTP- und API-Anfragen. Es ist dieser Teil des Inferenzdienstes, der die CPU beansprucht und häufig überlastet wird. In diesem Fall werden die GPUs immer weniger ausgelastet, da die Serverseite der Inferenz bei der Verarbeitung der Anfragen zunehmend ins Stocken gerät.
Das ist wahrscheinlich der Grund, warum 15 % der Unternehmen angeben, dass weniger als 50 % ihrer verfügbaren und erworbenen GPUs genutzt werden (State of AI Infrastructure at Scale 2024).
Ein Teil des Problems besteht darin, dass CPU-Ressourcen für Aufgaben genutzt werden, die eigentlich von der Infrastruktur übernommen werden sollten. Auch Dienste wie Datenverkehrsmanagement, Sicherheitsmaßnahmen und Überwachung beanspruchen CPU-Ressourcen und erhöhen die Last des Gesamtsystems. Dadurch sinken Kapazität und Leistung der Inferenzserver, und die GPU-Ressourcen werden weniger stark ausgelastet.
Glücklicherweise geht es bei dieser Renaissance der Infrastruktur darum, CPU-Ressourcen für Inferenzaufgaben freizuhalten, indem Infrastrukturvorgänge auf eine neue Verarbeitungseinheit ausgelagert werden: die DPU.
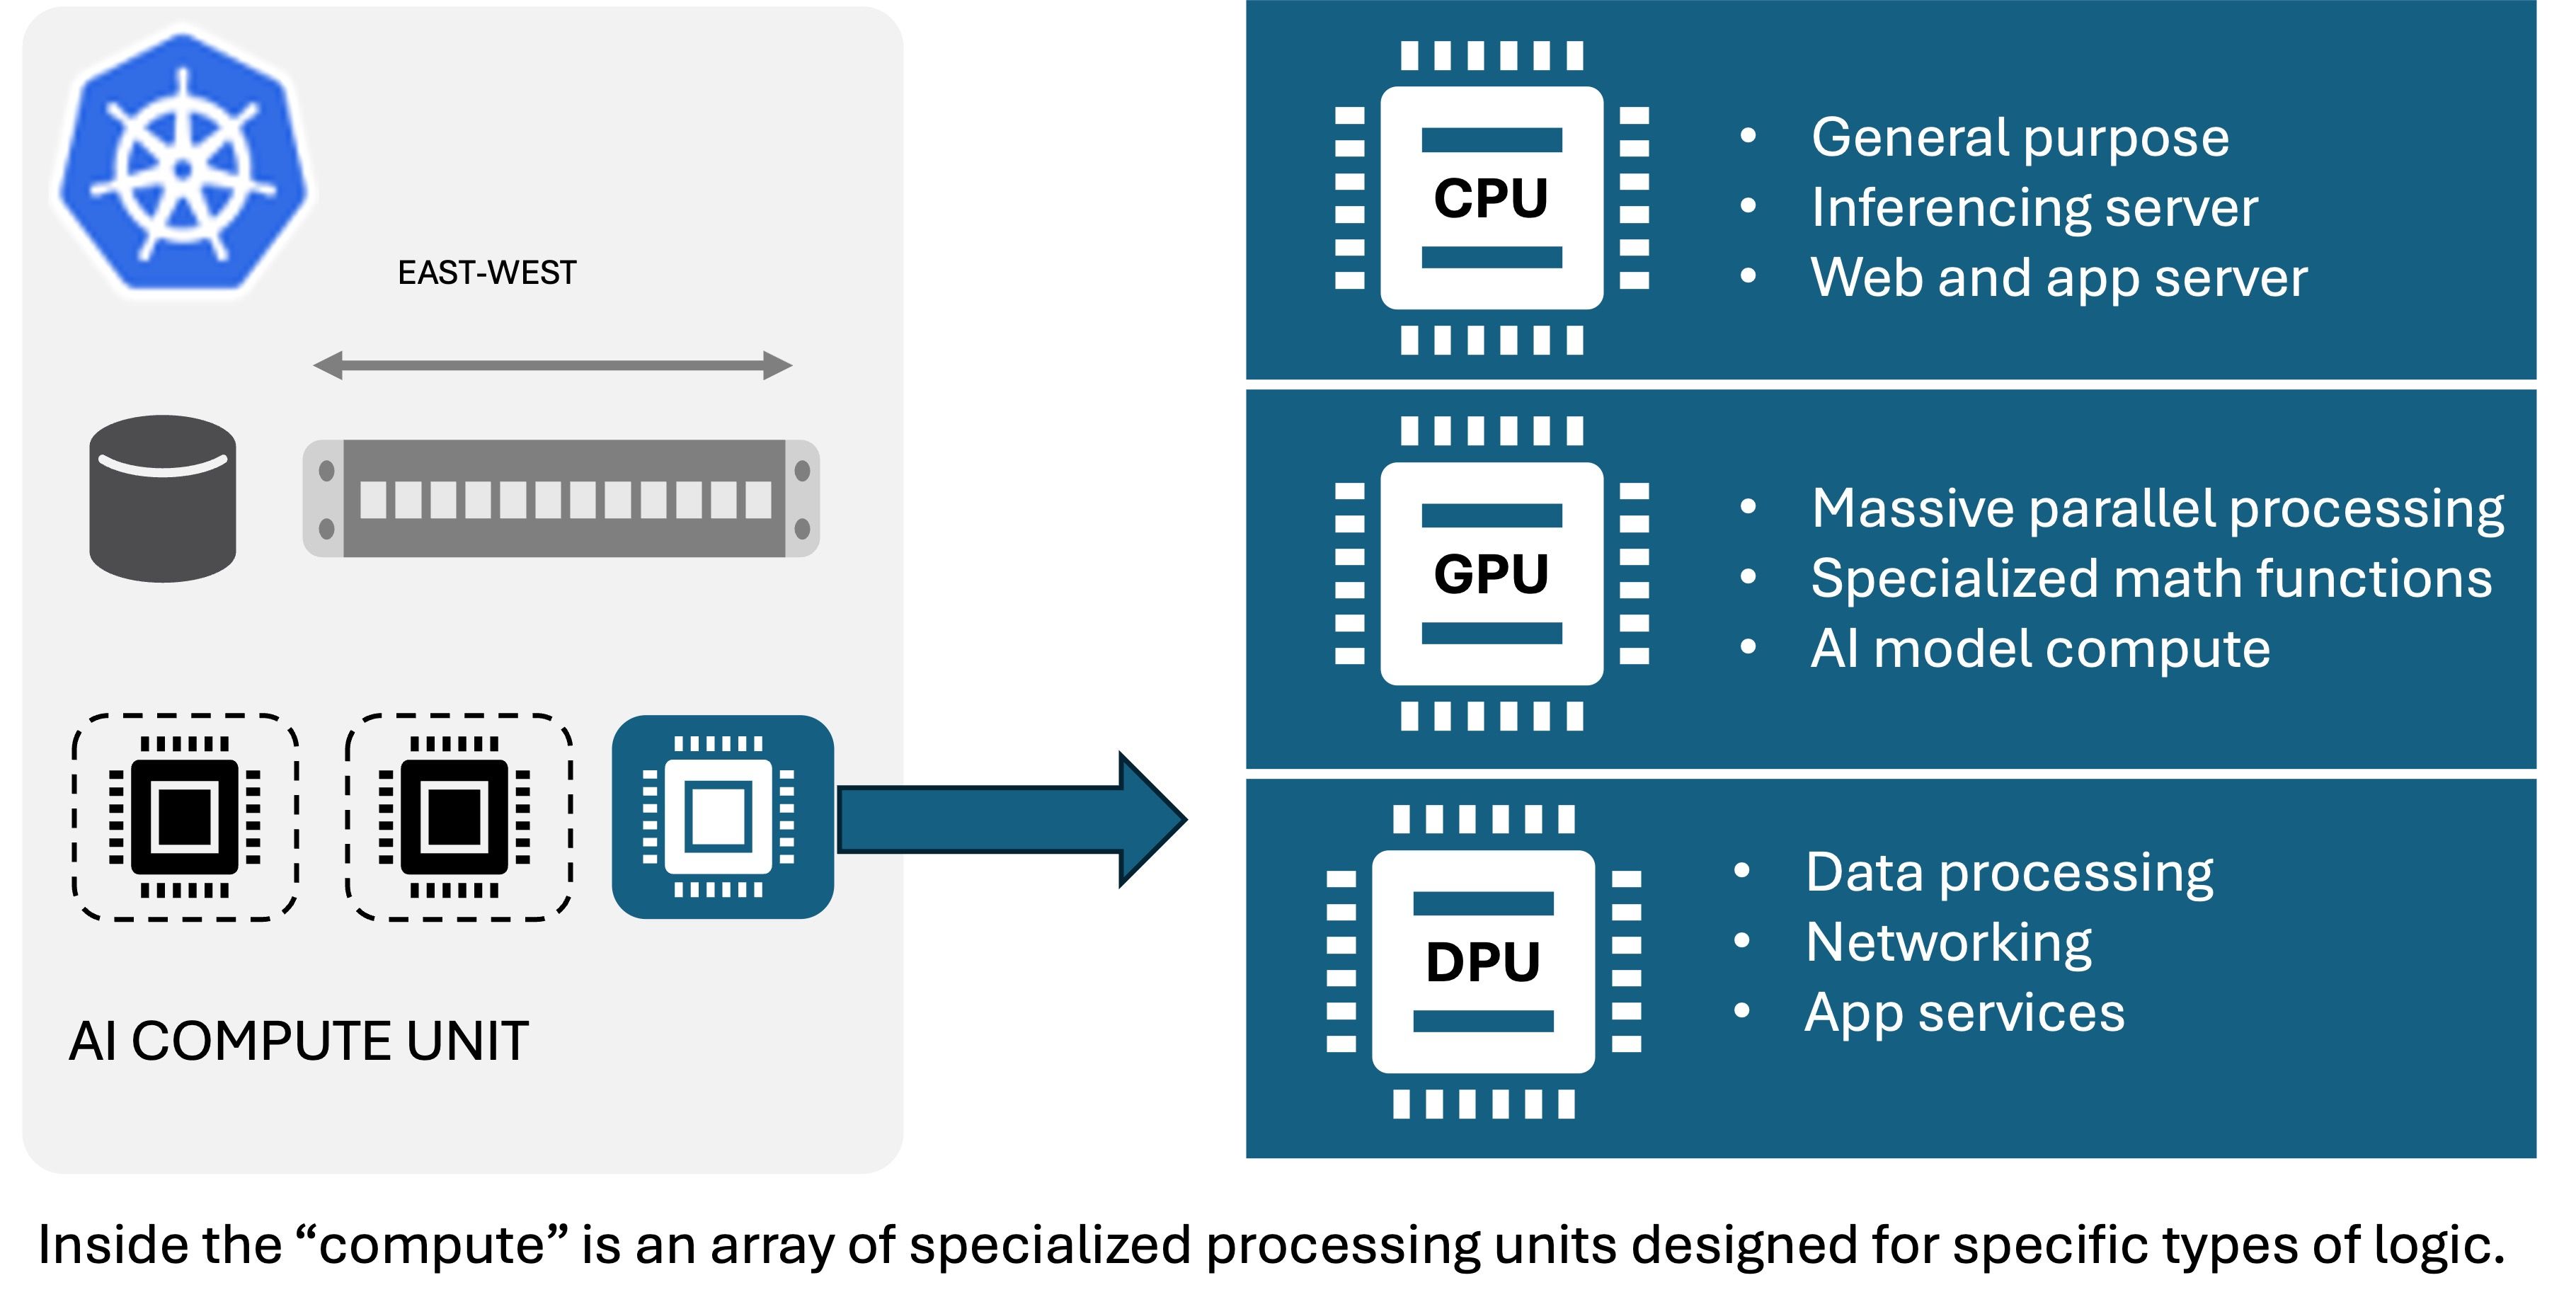
Das Interessante an DPUs ist, dass sie zwei verschiedene Modi unterstützen. In einem davon können sie Netzwerkaufgaben wie RDMA über InfiniBand oder Ethernet auslagern. Dies ist beim Aufbau eines KI-Rechenzentrums, in dem erhebliche Datenmengen übertragen werden, äußerst hilfreich – etwa beim Trainieren eines KI-Modells oder beim Skalieren der Inferenz für eine große Nutzerbasis.
DPUs können jedoch auch im „DPU“-Modus konfiguriert werden. In Kubernetes werden sie dadurch als separater Knoten angezeigt, auf dem Funktionen wie Anwendungsbereitstellung und Sicherheit ausgeführt werden können. So bleibt die CPU-Rechenleistung effektiv für Inferenzdienste reserviert, indem die weniger vorhersehbaren und anspruchsvolleren Infrastruktur-Workloads auf einen eigenen Knoten im Cluster „ausgelagert“ werden. Dadurch können Lösungen wie F5 BIG-IP Next SPK (Service Proxy for Kubernetes) eingehende N-S-KI-Anfragen über eine API verwalten und absichern sowie ordnungsgemäß an den entsprechenden Inferenzdienst innerhalb des KI-Rechenkomplexes verteilen.
Dieser Ansatz ermöglicht es Unternehmen, vorhandenes Know-how und bestehende Investitionen in die Verwaltung von Infrastruktur mit Kubernetes zu nutzen, da unsere Lösung Kubernetes-nativ ist. Ob Rechenzentrum, Cloud oder Edge spielt keine Rolle, denn der Betrieb erfolgt auf Clusterebene und ist damit in allen Umgebungen einheitlich.
Darüber hinaus werden die Zuständigkeiten für die Verwaltung der Anwendungsbereitstellung und der Sicherheitsdienste getrennt, sodass Netzwerk- und Security-Ops-Teams die Infrastruktur unabhängig von den KI-Workloads verwalten können, die von Dev- und MLOps-Teams betreut werden.
Schließlich lassen sich durch den Einsatz der DPU für die Anwendungsbereitstellung und Sicherheit die Mandantenfähigkeitsanforderungen von Unternehmen besser erfüllen. Dabei geht es nicht nur um die Isolierung von Kunden-Workloads, sondern auch von Modell-Workloads. Unsere Untersuchungen zeigen, dass Unternehmen bereits durchschnittlich 2,9 verschiedene Modelle einsetzen. Wenn sich die Nutzung jedes einzelnen Modells über eine einheitliche Lösung verwalten lässt, schafft dies mehr Vertrauen in die Sicherheit und den Datenschutz der Daten, die von den einzelnen Modellen verarbeitet und generiert werden.
Dies ist nicht das erste Mal, dass F5 mit NVIDIA-DPUs an KI-bezogenen Anwendungsfällen arbeitet. Es ist jedoch das erste Mal, dass wir gemeinsam eine Lösung entwickelt haben, die Kunden jeder Größe dabei unterstützt, skalierbare und sichere KI-Rechenkomplexe aufzubauen. So können sie die Leistungsfähigkeit von Inferencing in jeder Umgebung sicher und zuverlässig nutzen und die Auslastung ihrer GPU-Ressourcen optimieren, damit diese nicht ungenutzt bleiben.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.