Seit Jahren ist die Netzwerksegmentierung der Dreh- und Angelpunkt für die Isolierung von Bedrohungen, die Differenzierung der Dienstgüte, die Reaktion auf und Analyse von Vorfällen, Compliance-Prüfungen und viele weitere zentrale Interoperabilitätsfunktionen. Doch haben wir angesichts unserer Begeisterung für Zero-Trust-Prinzipien und unseres überstürzten Einsatzes von KI dieses Kernelement der Netzwerkinfrastruktur vernachlässigt, das die Grundlage moderner Cybersicherheit und des IT-Servicebetriebs bildet?
In einem früheren Beitrag unserer Reihe über KI-Fabriken haben wir eine KI-Fabrik definiert als eine umfangreiche Investition in Speicher-, Netzwerk- und Recheninfrastruktur, die für das Training und die Inferenz mit hohem Datenvolumen und hohen Leistungsanforderungen ausgelegt ist. Um eine Rendite aus dieser Investition zu erzielen, planen KI-Fabriken den Einsatz hochwertiger Grafikprozessoren (GPUs) und Rechenressourcen für dieses Training und diese Inferenz dynamisch. Die Zuweisung von GPUs erfordert eine Architektur mit mehreren „Mandanten“ für KI-Dienste pro KI-Cluster. Dadurch entsteht ein Problem, das viele Betriebsteams erst erkennen, wenn es häufig bereits zu spät ist.
Abstimmung der Clusterressourcen einer KI-Fabrik auf die Netzwerksegmentierung
Innerhalb eines KI-Clusters können wir Ressourcen logisch anhand eines Mandantenkontexts segmentieren und so Mandantenkontingente, Beschränkungen des Ressourcenverbrauchs, die Sicherheit des Hostsystems sowie eine rollenbasierte Zugriffskontrolle (RBAC) für die Verwaltung ermöglichen. Die grundlegenden Netzwerkdienste, die den ein- und ausgehenden Datenverkehr zwischen dem KI-Cluster und dem übrigen Netzwerk der KI-Fabrik bereitstellen, machen Mandantenkontexte jedoch nicht sichtbar. Ohne diesen Kontext ist die Netzwerksegmentierung – das Fundament der Cybersicherheit im Rechenzentrum – blind. Gängige Methoden zur Bereitstellung der erforderlichen Mandantenkontexte entziehen der KI-Fabrik entweder erhebliche Mengen wertvoller Rechenleistung oder verlangsamen die Netzwerkpfade so stark, dass die erforderlichen Grenzwerte für Dienstlatenz, Bandbreite oder Parallelität nicht eingehalten werden. Dadurch entsteht ein falsches Dilemma zwischen der effizienten Nutzung wertvoller Ressourcen der KI-Fabrik und der ordnungsgemäßen Integration von Mandanten in das Netzwerk.
In Public-Cloud-Infrastrukturen bilden orchestrierte mandantenfähige Netzwerkarchitekturen die Grundlage aller Dienste in einer Cloud-Region und werden mithilfe virtueller privater Clouds (VPCs) implementiert. Diese virtualisierte Netzwerksegmentierung ist für die Sicherheit und die Erfassung der Ressourcennutzung von entscheidender Bedeutung. Public-Cloud-Anbieter stellen diese Funktion mithilfe von Teams aus Netzwerksoftwareentwicklern und spezialisierter Netzwerkhardware bereit, darunter SmartNICs und Datenverarbeitungseinheiten (DPUs). KI-Fabrik-Cluster in Public Clouds sind darauf ausgelegt, die VPC-Netzwerkorchestrierung der zugrunde liegenden Infrastruktur zu nutzen. Die Kosten für den Betrieb von VPCs sind beträchtlich, doch sie sind ein zentraler Bestandteil des Geschäftsmodells von Public Clouds.
Es stellt sich die Frage: Wie kann ein Unternehmen seine Investition in eine KI-Fabrik optimal nutzen und GPUs sowie Rechenressourcen dynamisch einplanen, ohne dafür ebenso viel investieren zu müssen wie ein Public-Cloud-Anbieter?
Der erste Schritt der Branche auf diesem Weg bestand darin, mithilfe der Servervirtualisierung virtuelle Maschinen (VMs) zu erstellen. VMs nutzen Hardware-Passthrough, um eine Verbindung zu segmentierten Rechenzentrumsnetzwerken herzustellen. Wenn es lediglich um einen einzelnen Mandanten in einem einzelnen KI-Cluster geht, können wir einfach alle virtuellen Maschinen in denselben VLANs platzieren und den Betrieb wie gewohnt fortsetzen.
VMs können auch die GPU-Segmentierung ermöglichen, da GPU-Anbieter Verfahren unterstützen, mit denen sich GPU-Geräte in Gruppen von Rechenkernen und Speicher unterteilen und anschließend bestimmten virtuellen Maschinen zuweisen lassen. Die Segmentierung von GPU-Geräten ist jedoch nicht dynamisch und erfordert einen Neustart der VM. Darüber hinaus schränkt dieses Design die Möglichkeit ein, einen Pool von GPU-Ressourcen zu erstellen, dessen Nutzung mandantenübergreifend erfasst und abgerechnet werden kann. Dies sind erhebliche Nachteile dieser Lösung.
Netzwerksegmentierung auf mandantenfähige KI-Fabrik-Cluster abstimmen
Was geschieht mit unseren KI-Fabrik-Clustern, wenn sie nicht mehr nur einen Mandanten bedienen können? Das Problem verlagert sich ins Rechenzentrum. In KI-Fabrik-Clustern wird standardmäßig für den gesamten ins Rechenzentrum ausgehenden Netzwerkverkehr eine Source Network Address Translation (SNAT) durchgeführt. Dabei wird als Quelladresse die IP-Adresse des jeweiligen Clusterknotens verwendet, auf dem die containerisierte Workload ausgeführt wird, die die Netzwerkanfrage stellt. Dadurch wird die tatsächliche Quelle effektiv verschleiert. Der Datenverkehr stammt dann scheinbar aus dem Netzwerksegment, in dem dieser Knoten bereitgestellt wurde. Bei einem mandantenfähigen Cluster bedeutet dies, dass der Mandantenkontext verloren geht und ein vermischter Strom ausgehendem Datenverkehrs mehrerer Mandanten entsteht, der sich weder auseinanderhalten noch absichern, analysieren oder prüfen lässt.
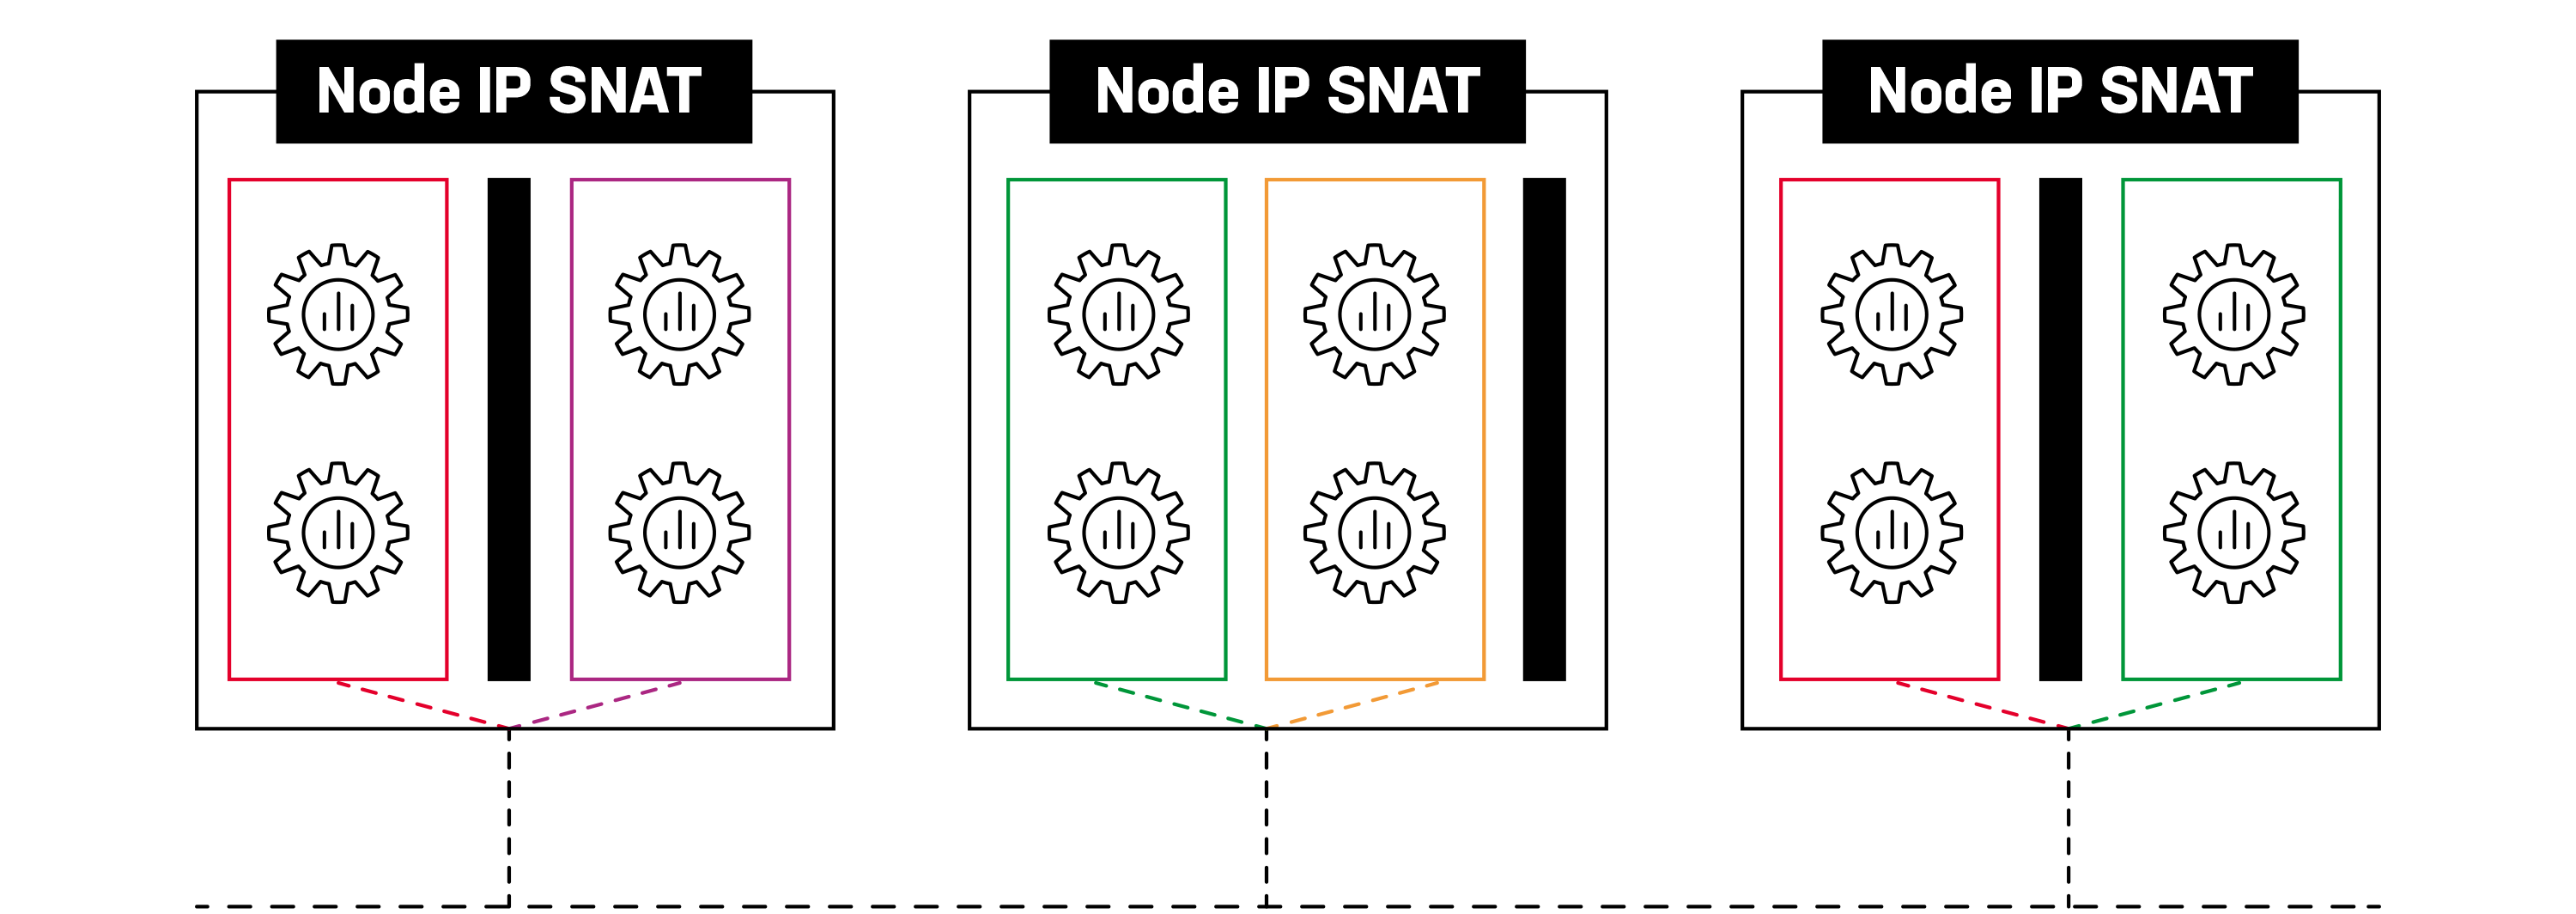
Standardmäßig geht der Mandantenkontext des Clusters beim ausgehenden Datenverkehr verloren.
Dieses Problem verschärft sich, wenn auch der eingehende Datenverkehr berücksichtigt wird. Dieser lässt sich möglicherweise leichter verwalten, da er aus einem bereits segmentierten Rechenzentrum stammt. Doch wie lässt sich der eingehende Datenverkehr eines einzelnen Mandanten seinem ausgehenden Datenverkehr zuordnen? Die Antwort liegt in Retrieval-Augmented Generation (RAG) und agentenbasierten Diensten, die intensiv kommunizieren, um externe Daten abzurufen und externe Dienste zu nutzen. Dies erfordert eine teamübergreifende Zusammenarbeit, bei der Plattformingenieure und NetOps Probleme für einen Kunden identifizieren oder versuchen, Sicherheitsaudits zu bestehen.
Unternehmen fragen sich vielleicht: „Warum können wir nicht einfach Overlay-Technologie für softwaredefinierte Netzwerke (SDN) einsetzen und VPC-Netzwerke aufbauen, wie es Hyperscaler tun?“ Das ist durchaus möglich, verlagert die Kosten jedoch auf die Wartung von SDN-VPC-Netzwerken über der bestehenden Rechenzentrumsinfrastruktur. Wenn eine Segmentierung auf Layer 2 (z. B. VxLAN) gewünscht ist, wird die Orchestrierung von Tunneln unter Einbeziehung der Top-of-Rack-Switches sowie die Bereitstellung dieser Switches entsprechend der Netzwerksegmentierung zur Herausforderung. Aus diesem Grund haben sich Hyperscaler für SmartNICs entschieden und die Orchestrierung auf die Host-zu-Host-Ebene verlagert, sodass die Rechenzentrumsnetzwerke schnell und einfach bleiben.
Den meisten Unternehmen fehlen entweder die Fachkräfte für die Netzwerkprogrammierung oder der Wunsch, eine derart komplexe Orchestrierung auf Hostebene selbst zu betreiben. Oder sie können schlicht nicht auf die für die Dienstgüte erforderliche Transparenz im Backbone-Netzwerk verzichten. Vorgeschlagene Layer-3-Routing-Lösungen (z. B. IP) für diese Probleme haben Netzwerkteams dazu veranlasst, jeden einzelnen Knoten eines KI-Clusters als dynamischen Routing-Peer (BGP) an das Rechenzentrum anzubinden, wobei mehrere Route Reflectors versuchen, eine grundlegende Mandantenfähigkeit für IP-Subnetze bereitzustellen. Auch dies konfrontiert Betreiber mit äußerst komplexen Routing-Problemen und Sicherheitsprüfungen und hat bereits zu regionsweiten Ausfällen geführt.
Clusterbewusste, orchestrierte Netzwerksegmentierung für KI-Fabriken
KI-Fabriken müssen eine funktionsreiche, programmierbare, sichere Netzwerklösung mit geringer Latenz einplanen, die sowohl hinsichtlich der Bandbreite als auch der Anzahl gleichzeitiger Verbindungen skalierbar ist. Mandantenkontexte auf Layer 2 (z. B. VLANs, VxLAN) und Layer 3 (z. B. Subnetze, IPSEC-Schnittstellen) müssen aus einem Cluster heraus im Netzwerk der KI-Fabrik bereitgestellt werden. NetOps müssen Metriken zur Beobachtbarkeit, Protokolle und Debugging-Tools zur Verfügung stehen.
Traditionell werden viele dieser Lösungen für Anwendungstenancy und Transparenz von F5 BIG-IP bereitgestellt. F5 BIG-IP Container Ingress Services (CIS) erkennt Kubernetes-Dienste dynamisch und stellt sie Rechenzentren als virtuelle Server zur Verfügung. Dabei handelt es sich um ein Konfigurationsobjekt, das BIG-IP-Administratoren bereits von der Konfiguration zur Bereitstellung physischer Server und virtueller Maschinen kennen. BIG-IP erfüllt zwar viele der Anforderungen, die wir an eine Lösung stellen, verwaltet jedoch nicht den ausgehenden Datenverkehr vom KI-Cluster in das Netzwerk der KI-Fabrik, was für die Aufrechterhaltung der Segmentierung erforderlich ist.
Um dieses Problem zu lösen, haben wir F5 BIG-IP Next for Kubernetes entwickelt, eine Lösung für mandantenfähige Compute-Cluster, die auf unserer Plattform der nächsten Generation, BIG-IP Next, basiert.
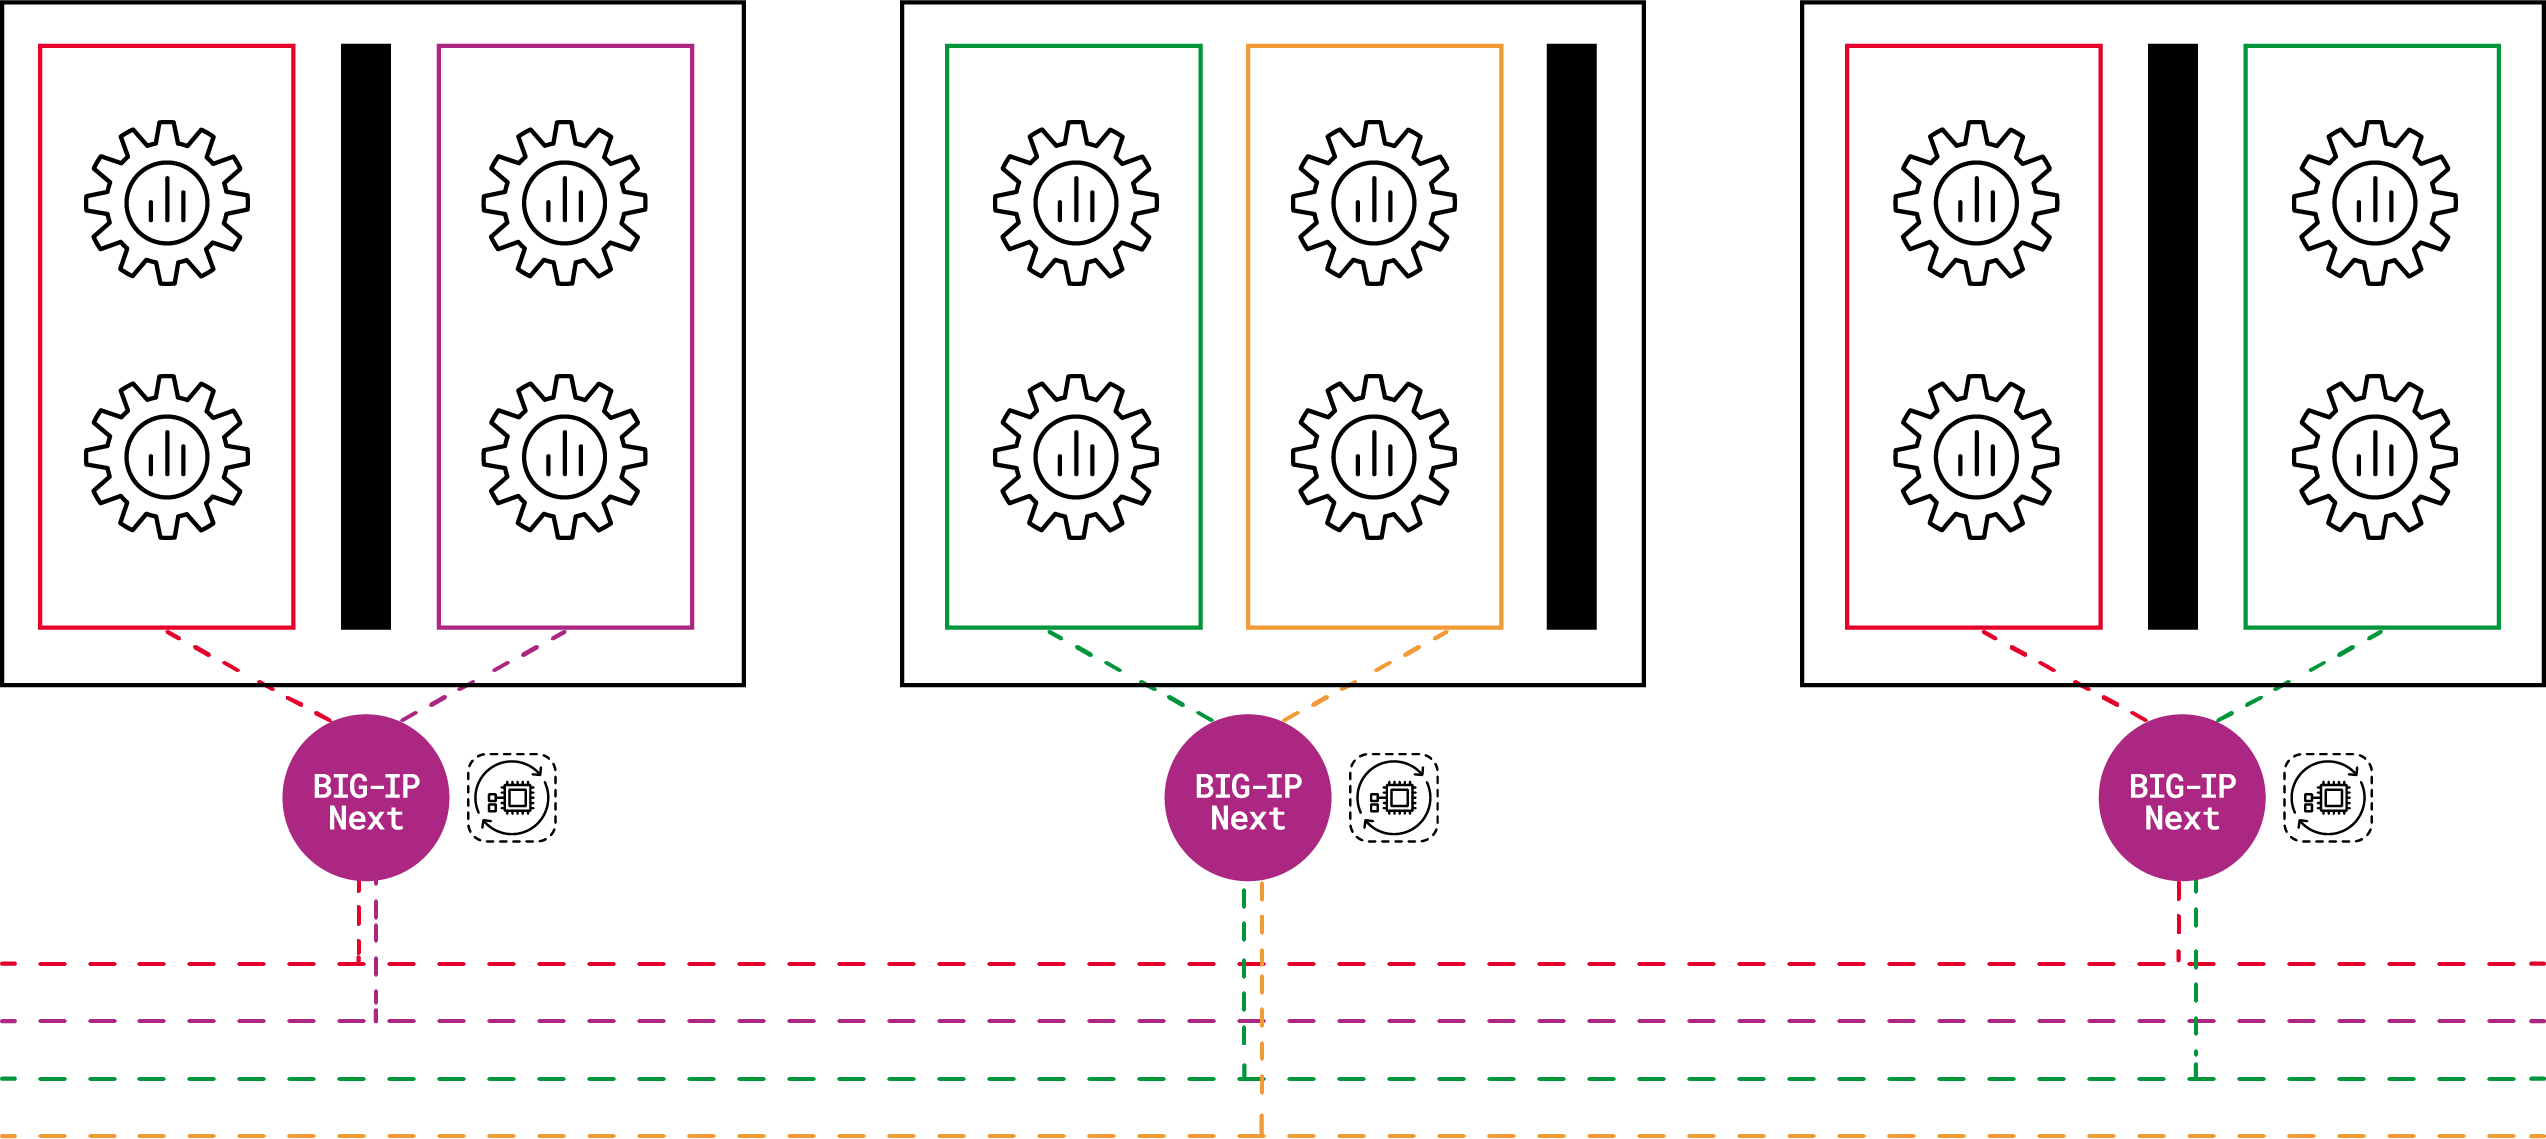
BIG-IP Next for Kubernetes ermöglicht es NetOps, Cluster-Mandanten Netzwerksegmenten zuzuordnen.
BIG-IP Next for Kubernetes wird vollständig über die Kubernetes-Steuerungsebene verwaltet, unterstützt die Kubernetes-Verwaltungsauthentifizierung sowie RBAC für alle deklarierten Ressourcen und erkennt Kubernetes-Mandanten anhand von Namespaces, um die erforderliche Netzwerksegmentierung sowohl für eingehenden als auch für ausgehenden Datenverkehr zu ermöglichen. Dies ist entscheidend für Architekturen, bei denen die Orchestrierung im Vordergrund steht, wie etwa KI-Fabriken.
BIG-IP Next for Kubernetes bietet NetOps eine einfache Möglichkeit, die Zuordnungen zwischen Kubernetes-Namespaces und Netzwerksegmenten zu definieren. Das dynamische Route-Peering zwischen dem Netzwerk der KI-Fabrik und BIG-IP Next-Instanzen verwendet eine vertraute Syntax für die Routenkonfiguration. NetOps-Teams verfügen über die einzigartige Möglichkeit, Live-Netzwerkdatenströme für den ein- und ausgehenden Cluster-Datenverkehr sicher zu analysieren und Fehler zu beheben. SecOps-Teams erhalten für jeden Cluster-Mandanten Firewall-Zugriffssteuerungslisten (ACLs) für den ein- und ausgehenden Datenverkehr sowie Funktionen für den Schutz vor Distributed-Denial-of-Service-Angriffen (DDoS) und IPS.
Für die Plattform-Engineering-Teams entlastet BIG-IP Next for Kubernetes die Rechenressourcen, indem Netzwerkfunktionen wie die Verarbeitung des ein- und ausgehenden Datenverkehrs sowie Source NAT und Firewall-Funktionen ausgelagert werden. Dies trägt zur Senkung der Betriebskosten bei und sorgt gleichzeitig dafür, dass die Dienste verfügbar und effizient bleiben.
BIG-IP Next for Kubernetes unterstützt außerdem die Kubernetes Gateway API, die erste von der Community entwickelte Ingress-API, die auf bestimmte organisatorische Rollen in den Bereichen NetOps, Platform Engineering, DevOps und MLOps zugeschnitten ist. Über die Gateway API erweitert BIG-IP Next for Kubernetes typische portbasierte Layer-4- oder HTTP(S)-routenbasierte Layer-7-Ingress-Dienste um eine Suite für DevOps/MLOps, nämlich TCPRoute, UDPRoute, HTTPRoute, TLSRoute und GRPCRoute, die alle über dieselbe CI/CD-Automatisierung in führenden KI-Frameworks gesteuert werden.
Aus Verwaltungssicht sorgt BIG-IP Next for Kubernetes mithilfe von Kubernetes-API-Deklarationen für eine effektive Zusammenarbeit zwischen NetOps, SecOps, Plattform-Engineering, DevOps und MLOps. Es bietet alles, was Sie von BIG-IP erwarten – jedoch aus der Kubernetes-Perspektive und mit Unterstützung für die Netzwerksegmentierung.
Der Aufstieg der DPU
Datenverarbeitungseinheiten (DPUs) haben in KI-Fabriken rasant an Bedeutung gewonnen. Wie in einem früheren Blogbeitrag unserer Reihe über KI-Fabriken erläutert, ist eine DPU ein programmierbarer Prozessor, der dafür ausgelegt ist, enorme Datenbewegungen und -verarbeitungsaufgaben mithilfe von Hardwarebeschleunigung bei voller Netzwerkgeschwindigkeit zu bewältigen. Durch Produktinnovationen bei F5 und die Zusammenarbeit mit NVIDIA haben wir BIG-IP Next for Kubernetes auf den Markt gebracht. Die Lösung lagert Datenströme für ein- und ausgehenden Datenverkehr aus, unterstützt die Netzwerksegmentierung und stellt Sicherheitsfunktionen bereit, indem sie mithilfe der DOCA-APIs von NVIDIA auf NVIDIA BlueField-3-DPUs implementiert wird. So wird die Investition in eine KI-Fabrik optimal genutzt, da sichergestellt ist, dass die KI-Cluster kontinuierlich mit Daten versorgt werden.
KI-Fabriken mit F5
Bei Investitionen in KI-Fabriken ist es unerlässlich, dass die Infrastruktur optimiert, effizient und skalierbar ist. F5 BIG-IP Next for Kubernetes wird auf NVIDIA BlueField-3-DPUs bereitgestellt und ermöglicht die für die dynamische Planung von GPU- und Rechenressourcen erforderliche Netzwerksegmentierung. Gleichzeitig bietet die Lösung leistungsstarke Skalierbarkeit, um die Rendite von KI-Investitionen zu maximieren. Weitere Informationen erhalten Sie, indem Sie F5 kontaktieren, um mit Ihrem F5-Kundenbetreuer und Ihrem Solutions Engineer oder Lösungsarchitekten in Kontakt zu treten.
Möchten Sie mehr über KI-Fabriken erfahren? Entdecken Sie weitere Beiträge aus unserer Blogreihe zu KI-Fabriken:
- Was ist eine KI-Fabrik? ›
- Retrieval-Augmented Generation (RAG) für KI-Fabriken ›
- Traffic-Management für die Datenaufnahme in KI-Fabriken optimieren ›
- Edge-Datenquellen optimal mit KI-Fabriken verbinden ›
- Multicloud-Skalierbarkeit und -Flexibilität unterstützen KI-Fabriken ›
- Die Leistungsfähigkeit und Bedeutung der NVIDIA BlueField DPU für KI-Fabriken ›
- API-Schutz für KI-Fabriken: Der erste Schritt zur KI-Sicherheit ›
- KI-Fabriken produzieren die modernsten aller modernen Anwendungen: KI-Anwendungen ›
Über den Autor
Ähnliche Blogbeiträge

F5 und Equinix bündeln ihre Kräfte, um die sichere Anwendungsbereitstellung in Multicloud-Umgebungen zu vereinfachen
F5 und Equinix ermöglichen es Unternehmen, sich weltweit sicher und zuverlässig mit ihren Partnern zu vernetzen.

API-Sicherheitsrisiken und -herausforderungen
Erfahren Sie, warum APIs für die moderne App-Entwicklung unverzichtbar sind und wie Sie sie vor den häufigsten Sicherheitslücken schützen. Profitieren Sie von Expertentipps und direkt umsetzbaren Strategien.
Ein Meilenstein für die Community Impact Grants von F5
F5 feiert das fünfjährige Bestehen seines innovativen Community Impact Grant-Programms, das gemeinnützige Organisationen, bei denen sich F5-Mitarbeitende ehrenamtlich engagieren, mit Fördermitteln in Höhe von 5.000 US-Dollar unterstützt.
Mit moderner, anpassungsfähiger und sicherer Gesundheits-IT Leben retten
Die IT-Investitionen im Gesundheitswesen tragen dazu bei, die schnellsten Wege zu einer besseren Versorgung zu finden, indem sie die medizinische Betreuung näher an die Patientinnen und Patienten bringen. Viele Gesundheitsunternehmen nutzen riesige Mengen an klinischen und anderen Gesundheitsdaten, um Entwicklungen zu verfolgen und übergreifende Trends in der gesamten Gesundheitslandschaft zu erkennen. Gleichzeitig nähern sie sich einer möglichst präzisen, individuell zugeschnittenen Versorgung an.
Verbesserung der Benutzer- und Administrationserfahrung durch sicheren hybriden Zugriff
Diese Kombination aus BIG-IP Access Policy Manager und Azure Active Directory ermöglicht Identitätsföderation, zentralisierten Benutzerzugriff (über Single Sign-on) und erhöhte Anwendungssicherheit (durch Multi-Faktor-Authentifizierung) für geschäftskritische Anwendungen sowie cloudbasierte und SaaS-Anwendungen. Dieser Ansatz vereinfacht die Einrichtung und Bereitstellung, reduziert den Verwaltungsaufwand und verbessert die gesamte Administration.
Das Internet der Sicherheitsdinge
Nein, das ist keine Tirade über die Sicherheit des IoT. Es ist eine Geschichte über Veränderung – genauer gesagt über Veränderung und ihre Auswirkungen auf die Sicherheit. Veränderung ist allgegenwärtig. Es gibt unzählige Axiome und Sprichwörter über Veränderung, also ist es ...