このブログ記事は、AIデータデリバリーに関するシリーズの第2回です。
AIの利用が加速する中、ボトルネックを防ぎ、パフォーマンスを維持するには、データパイプラインをさらに速いペースで拡張する必要があります。McKinsey & Companyなどの企業による最近の調査では、AI対応データセンターの処理能力に対する需要は、2030年まで年間約33%の割合で増加すると予測されています。つまり、デリバリーパイプラインをそれに応じて拡張しなければ、どれほど優れたモデルアーキテクチャでもデータ不足に陥ります。
しかし、AIワークロードの規模が拡大するにつれ、多くの組織が意外な事実に気付き始めています。処理速度の低下は、モデルのトレーニングやファインチューニングのプロセス自体ではなく、モデルファウンドリに大量かつ高品質なデータを継続的に供給する必要がある上流のデータパイプラインで生じることがほとんどです。
“新たなイノベーションにより、F5 BIG-IPは、トレーニング、埋め込み生成、ファインチューニングの各ワークフローで大量のAIデータを高速に流し続けるために必要な、インテリジェントなトラフィック管理、データパスの最適化、セキュリティ制御を提供できます。”
最新のAIシステムは、オブジェクトストア、検索レイヤー、特徴量パイプライン、埋め込み生成ワークフローの間、さらに該当する場合は推論エンドポイントとの間で、データを高速かつ予測可能な形で移動できることに依存しています。この「フロー」が滞ると、パフォーマンスが大幅に低下し、GPUがアイドル状態となり、企業が価値を実感し始めるまでの時間が想定以上に長くなります。
これを理解するうえで役立つのが、本シリーズの最初のブログ記事で取り上げた石油パイプラインの例えです。世界最先端の製油所、つまり、トレーニング、ファインチューニング、埋め込み生成に使用する大規模言語モデル(LLM)、ベクトル検索エンジン、マルチモーダルモデルファウンドリクラスターがあったとしても、そこに原料を供給するパイプラインが細かったり、漏れがあったり、詰まっていたりすれば、生産は停止します。問題は精製プロセスではなく、輸送システムにあります。現在のAIパイプラインも同じ原理で動作しており、データの流れがシステムのパフォーマンスを左右します。
AIのボトルネックが実際に生じる場所
AIパイプラインが単一の箇所で破綻することはまれで、通常は一連の細かなやり取りを通じて速度が低下します。1つのワークフローでも、オブジェクトストレージからトレーニングデータセット、企業のナレッジリポジトリ、または埋め込みを取得し、取り込み用にデータを変換して、ベクトルストアにクエリを実行し、複数のマイクロサービスにアクセスした後、ようやくファインチューニングやモデル構築のステップに進む場合があります。
各ステップには、処理を妨げる要因が潜んでいます。個々の遅延は無視できるように見えても、積み重なるとエンドツーエンドの処理時間が長くなり、GPUに必要なデータが供給されなくなります。特に、大規模なトレーニングやデータ拡張のジョブでは顕著です。
これは、圧力低下、バルブの位置ずれ、予期しない急激な流量変化が生じている石油パイプラインに相当します。流れが不安定になり、下流の施設には安定した予測可能な供給が届きません。AIモデルファウンドリシステムでも、ストレージノードの速度低下、ネットワーク経路の劣化、予測不能なワークロードの急増が起きると、同じ現象が発生します。
既存の調査から、AIのパフォーマンス問題は通常、モデルではなくデータパイプラインに起因することが極めて明確に示されています。Fivetranの調査では、企業の42%が、データの準備が整っていなかった、または必要なときにアクセスできなかったため、AIプロジェクトの半数超で遅延、期待を下回るパフォーマンス、または失敗が発生したと回答しています。
Broadcomによる別の調査では、組織の96%が、データパイプラインのパフォーマンス問題によってAIの目標達成が直接妨げられ、トレーニングや準備のワークフローの遅延、自動化の縮小、コストのかかる手戻りにつながったと回答しています。
これらの数字は、重要な事実を示しています。データがパイプライン内を迅速かつ確実に移動できなければ、どれほど高度なモデルファウンドリ運用でも、一貫した成果を上げることはできません。
F5 BIG-IPがAIデータ配信をモダナイズする仕組み
With the release of F5 BIG-IP version 21のリリースにより、BIG-IPは従来のアプリケーションデリバリーコントローラー(ADC)としての役割を大きく超えて進化しました。現在では、AI主導のデータパイプライン、特にS3互換オブジェクトストレージを中心に構築されたパイプライン向けに設計された、全面的にモダナイズされたADCとして機能します。
新たなイノベーションにより、F5 BIG-IPは、推論だけでなく、トレーニング、埋め込み生成、ファインチューニングの各ワークフロー全体で、AIデータを大容量かつ高速に流し続けるために必要なインテリジェントなトラフィック管理、データパスの最適化、セキュリティ制御を提供します。
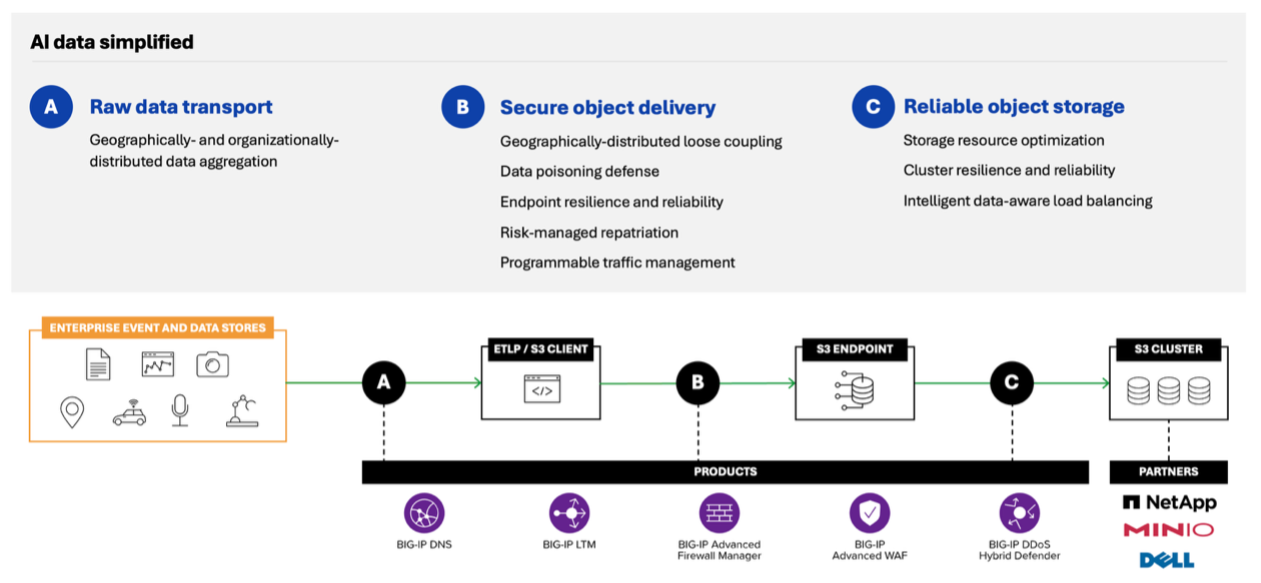
データフロー全体の安定化と高速化を目的に設計されています。オブジェクトストアとAIアプリケーションスタックの間にデリバリー層として配置され、高負荷時でもデータの取り込み、取得、ルーティングを円滑かつセキュアでレジリエントな状態に保ちます。
BIG-IPはストレージノードの健全性を継続的に監視し、低速または障害が発生しているエンドポイントを回避するよう、トラフィックを自動的に再ルーティングします。大容量のマルチパートアップロード向けに強化されたTCP/TLSプロファイルなど、S3に特化した最適化により、リクエストのオーバーヘッドを削減し、大容量データの読み取りを高速化できます。また、オブジェクトサイズ、プレフィックス、バケットなどのメタデータに基づいてトラフィックを振り分けることもできるため、組織は運用上のニーズに応じて、ファインチューニング用データセット、トレーニング成果物、RAG埋め込みデータの優先度を個別に設定できます。
主要な柱:ロケーション認識型ルーティング、キャッシュ、セキュリティ
BIG-IPの有効性を支えるもう1つの重要な要素は、ロケーションを考慮したルーティングの処理方法です。ストレージリージョンで遅延が発生した場合や、クラスターのメンテナンスが行われる場合でも、アプリケーション自体を変更することなく、正常なサイトへトラフィックフローがシームレスにリダイレクトされます。これにより、背後のストレージレイヤーの状況にかかわらず、AIパイプラインへ継続的にデータを供給できます。
トラフィック管理とセキュリティは、データ転送エコシステムに緊密に統合する必要があります。AIデータエンドポイントは運用コストが高く、攻撃者にとって価値の高い標的です。下図に示すように、BIG-IPはAIデータパイプラインに不可欠な配信機能とセキュリティ機能を提供します。高度なDDoS対策、WAF機能、きめ細かなAPIガバナンスにより、セキュリティをデータパイプラインのボトルネックではなく、その一部として組み込めます。
レジリエンスと信頼性の重要性
最適化されたパイプラインでも、中断は発生します。トラフィックの急増、ノード障害、レプリケーションの急増、ネットワークの変更はいずれも、AIのパフォーマンスを低下させる可能性があります。レジリエンスとは、こうした状況でもデータの流れを維持できる能力です。BIG-IPは、アクティブフェイルオーバー、メンテナンス時のトラフィックドレイン、プログラム可能なルーティングポリシーを提供し、パイプラインの安定性維持に優れた能力を発揮します。
具体的には、データストアの可用性とアクセス性が維持されます。トレーニングサイクルは滞りなく進み、RAGの埋め込み処理とデータ拡張プロセスは予定どおりに完了します。また、AIスタックの1つのレイヤーが過負荷状態または利用不能になった場合に生じる連鎖的な障害を回避できます。
BIG-IPは、AIデータパイプライン全体の圧力制御、流量調整、安全弁の各システムのような役割を果たします。これにより、製油所、すなわちAIモデルファウンドリに、必要な高品質の「石油」が常に安定して供給されます。
F5は、あらゆる環境でAIアプリケーションの配信とセキュリティ確保を実現
AIのパフォーマンス最適化は、モデル推論だけの問題ではありません。トレーニング、ファインチューニング、埋め込みの各ワークフローに必要な膨大な量のデータを、高速かつ予測可能でセキュアに転送できるようにすることが重要です。
F5のAIデータ配信ソリューションの詳細については、AI Data Delivery and Infrastructure SolutionsのWebページをご覧ください。
F5のAIへの取り組みは、データ配信にとどまりません。F5があらゆる環境でAIアプリを保護し、配信する仕組みをご覧ください。
AIデータ配信シリーズのほかのブログ記事もぜひご覧ください:
大規模なAIインフラストラクチャを最適化するためのベストプラクティス
パイプラインの速度を低下させることなく、AIデータパイプラインを保護
著者について

Hunter Smitは、F5でソリューションおよび戦略担当のプロダクトマーケティングシニアマネージャーを務めています。AIインフラストラクチャやアプリケーションセキュリティを含むF5ポートフォリオ全体のソリューションマーケティングを統括し、新興のAIデータデリバリー市場へのF5の参入を推進しています。Whitworth University School of Businessの諮問委員会メンバーであり、プロダクトマーケティングの非常勤講師も務めました。Whitworth UniversityでMBAおよび経営学の学士号を取得しています。
Hunter Smitのその他のブログ記事関連するブログ記事

経営幹部が抱くAIに関する4つの誤解
AIに関する誤解は数多くあります。ここでは、組織が自社環境にAIを導入する際に見直す必要があるかもしれない4つの誤解を紹介します。

IT/OTコンバージェンスの現状と、セキュリティを最優先すべき理由
ITシステムとOTシステムの融合が進むにつれ、攻撃対象領域は拡大します。組織が安全に統合する方法と、F5 ADSPが大規模な運用の保護にどのように役立つかをご紹介します。

AIのレイテンシ:セキュリティを犠牲にできない理由
AIのレイテンシは、単なる速度の問題ではありません。パフォーマンス、セキュリティ、信頼性のバランスを考慮したシステム設計が重要です。

AIアプリケーションを大規模に提供する:ADCの役割
AIアプリケーションを確実に提供するには、高速なモデルや柔軟に拡張できるインフラストラクチャだけでは不十分です。AIアプリケーションの利用方法を管理するための制御レイヤーが必要です。

MCP:AI対応のアプリケーションデリバリを実現する鍵
Model Context Protocol(MCP)は、最新のアプリケーションにおける安全で低遅延なAI統合を可能にします。将来を見据えたアプリケーションデリバリ戦略にMCPが不可欠な理由をご覧ください。

AIガードレールとは?基盤モデルプロバイダーの枠を超えて進化する安全対策
急速に変化する組織の脅威領域におけるリスクをより包括的に捉えるために、AIガードレールの進化が必要な理由をご覧ください。