
Die enorme Komplexität der modernen Anwendungsbereitstellung ist mit der Situation vor zehn Jahren nicht mehr vergleichbar. Früher setzten wir auf statische Load-Balancing-Strategien, die vorhersehbare Datenströme auf eine Handvoll Server verteilten. Heute haben wir es mit dynamischen Multicloud-Umgebungen, Microservices, die bei Bedarf spontan hoch- oder heruntergefahren werden, und Nutzerzahlen zu tun, die über Nacht von tausend auf eine Million anwachsen können. Herkömmliches, regelbasiertes Load Balancing kann damit nicht immer Schritt halten.
Hier kommt Reinforcement Learning (RL) ins Spiel. Indem ein RL-Agent seine Umgebung kontinuierlich beobachtet und Entscheidungen trifft, die die Gesamtleistung maximieren, kann er sich potenziell besser an Veränderungen in Echtzeit anpassen als jedes vorprogrammierte Skript. Es ist der Unterschied zwischen dem strikten Befolgen eines Rezepts und intuitivem Kochen: Das eine lässt sich für bekannte Bedingungen skalieren, während sich das andere dynamisch an die jeweilige Situation anpasst.
These: Da Anwendungsinfrastrukturen immer komplexer werden, müssen wir von statischem oder heuristikbasiertem Lastausgleich zu adaptiven, durch bestärkendes Lernen gesteuerten Systemen übergehen, um die Ausfallsicherheit zu gewährleisten, die Leistung zu optimieren und unsere Netzwerke zukunftssicher zu machen.
An Hype rund um KI mangelt es nicht, doch RL ist ein Bereich, in dem sowohl die akademische Forschung als auch Pilotprojekte unter realen Bedingungen zunehmend greifbare Erfolge erkennen lassen. Wir sprechen hier nicht von einem vagen „Vielleicht“ in ferner Zukunft: RL-Techniken erzielen bereits positive Ergebnisse in Simulationsumgebungen und bestimmten Produktivumgebungen.
Reinforcement Learning – Grundlagen: Warum es sinnvoll ist
Bevor wir tiefer in das Thema einsteigen, wollen wir Reinforcement Learning (RL) zunächst einfacher erklären. Stellen Sie sich einen Agenten vor – das „Gehirn“ des Systems –, der Daten sammelt, Entscheidungen trifft und seine Strategie an veränderte Bedingungen anpasst. Dieser Agent agiert in einer dynamischen Umgebung (etwa einem Multicloud-System), in der er für erfolgreiche Ergebnisse eine „Belohnung“ erhält – beispielsweise für eine geringere Latenz oder einen höheren Durchsatz. Im Laufe der Zeit optimiert er seine Strategie, um häufiger größere Belohnungen zu erzielen.
- Adaptiv und kontinuierlich: Im Gegensatz zu einem statischen Algorithmus, der an einen bestimmten Regelsatz gebunden ist, lernt RL kontinuierlich aus neuen Datenverkehrsmustern.
- Skalierbare Logik: RL-Frameworks können Tausende von Variablen – etwa CPU-Auslastung, Speicherverbrauch oder Knotenverfügbarkeit – koordinieren und gleichzeitig optimieren.
- Robust gegenüber Störungen: Plötzliche Veränderungen, etwa ein sprunghafter Anstieg des E-Commerce-Datenverkehrs während der Weihnachtszeit, können automatisch ausgeglichen werden, ohne darauf zu warten, dass ein Mensch die Schwellenwerte anpasst.
Kontroverse: Ist Reinforcement Learning übertrieben?
Einige Entwickler haben RL als unnötig kompliziert abgetan. „Warum etwas reparieren, das nicht kaputt ist?“, lautet eine häufig gestellte Frage. Nun, bei F5 haben wir neue Kundenszenarien erlebt – etwa global verteilte Microservices oder mandantenfähige Edge-Bereitstellungen –, in denen statische Regeln nicht nur suboptimal, sondern mitunter sogar gefährlich sind. Eine Richtlinie, die im letzten Quartal noch perfekt war, kann unter neuen Bedingungen auf spektakuläre Weise scheitern. Die Fähigkeit von RL, sich trotz Unsicherheit anzupassen, kann in solchen Szenarien entscheidend sein.
Einblicke in F5: Ein Blick auf Experimente aus der Praxis
Bei F5 haben wir kleine RL-Experimente in Simulationsumgebungen durchgeführt, die realem Client-Datenverkehr nachempfunden sind. Hier ein Beispiel:
- Das Szenario: Wir erstellten ein synthetisches „Shopathon“-Szenario – man stelle sich große Shopping-Events auf verschiedenen Kontinenten vor, die gleichzeitig starten. Das Datenverkehrsaufkommen stieg unvorhersehbar an, wobei speicherintensive Abfragen zu ungewöhnlichen Zeiten sprunghaft zunahmen.
- Der RL-Agent: In einer containerisierten Umgebung passte der RL-Agent anhand der Nutzungsmuster an, welche Microservices gestartet wurden. Er lernte, rechenintensive Aufgaben an Knoten mit spezialisierter Hardware weiterzuleiten und weniger rechenintensive Prozesse auf kostengünstigere Cloud-Instanzen zu verlagern.
- Die Ergebnisse: Im Vergleich zu einem klassischen Round-Robin-Ansatz mit teilweiser automatischer Skalierung verkürzte die RL-gestützte Methode die durchschnittlichen Antwortzeiten um 12–15 %. Entscheidend war zudem, dass die Fehlerraten bei extremen Lastspitzen stabiler blieben.
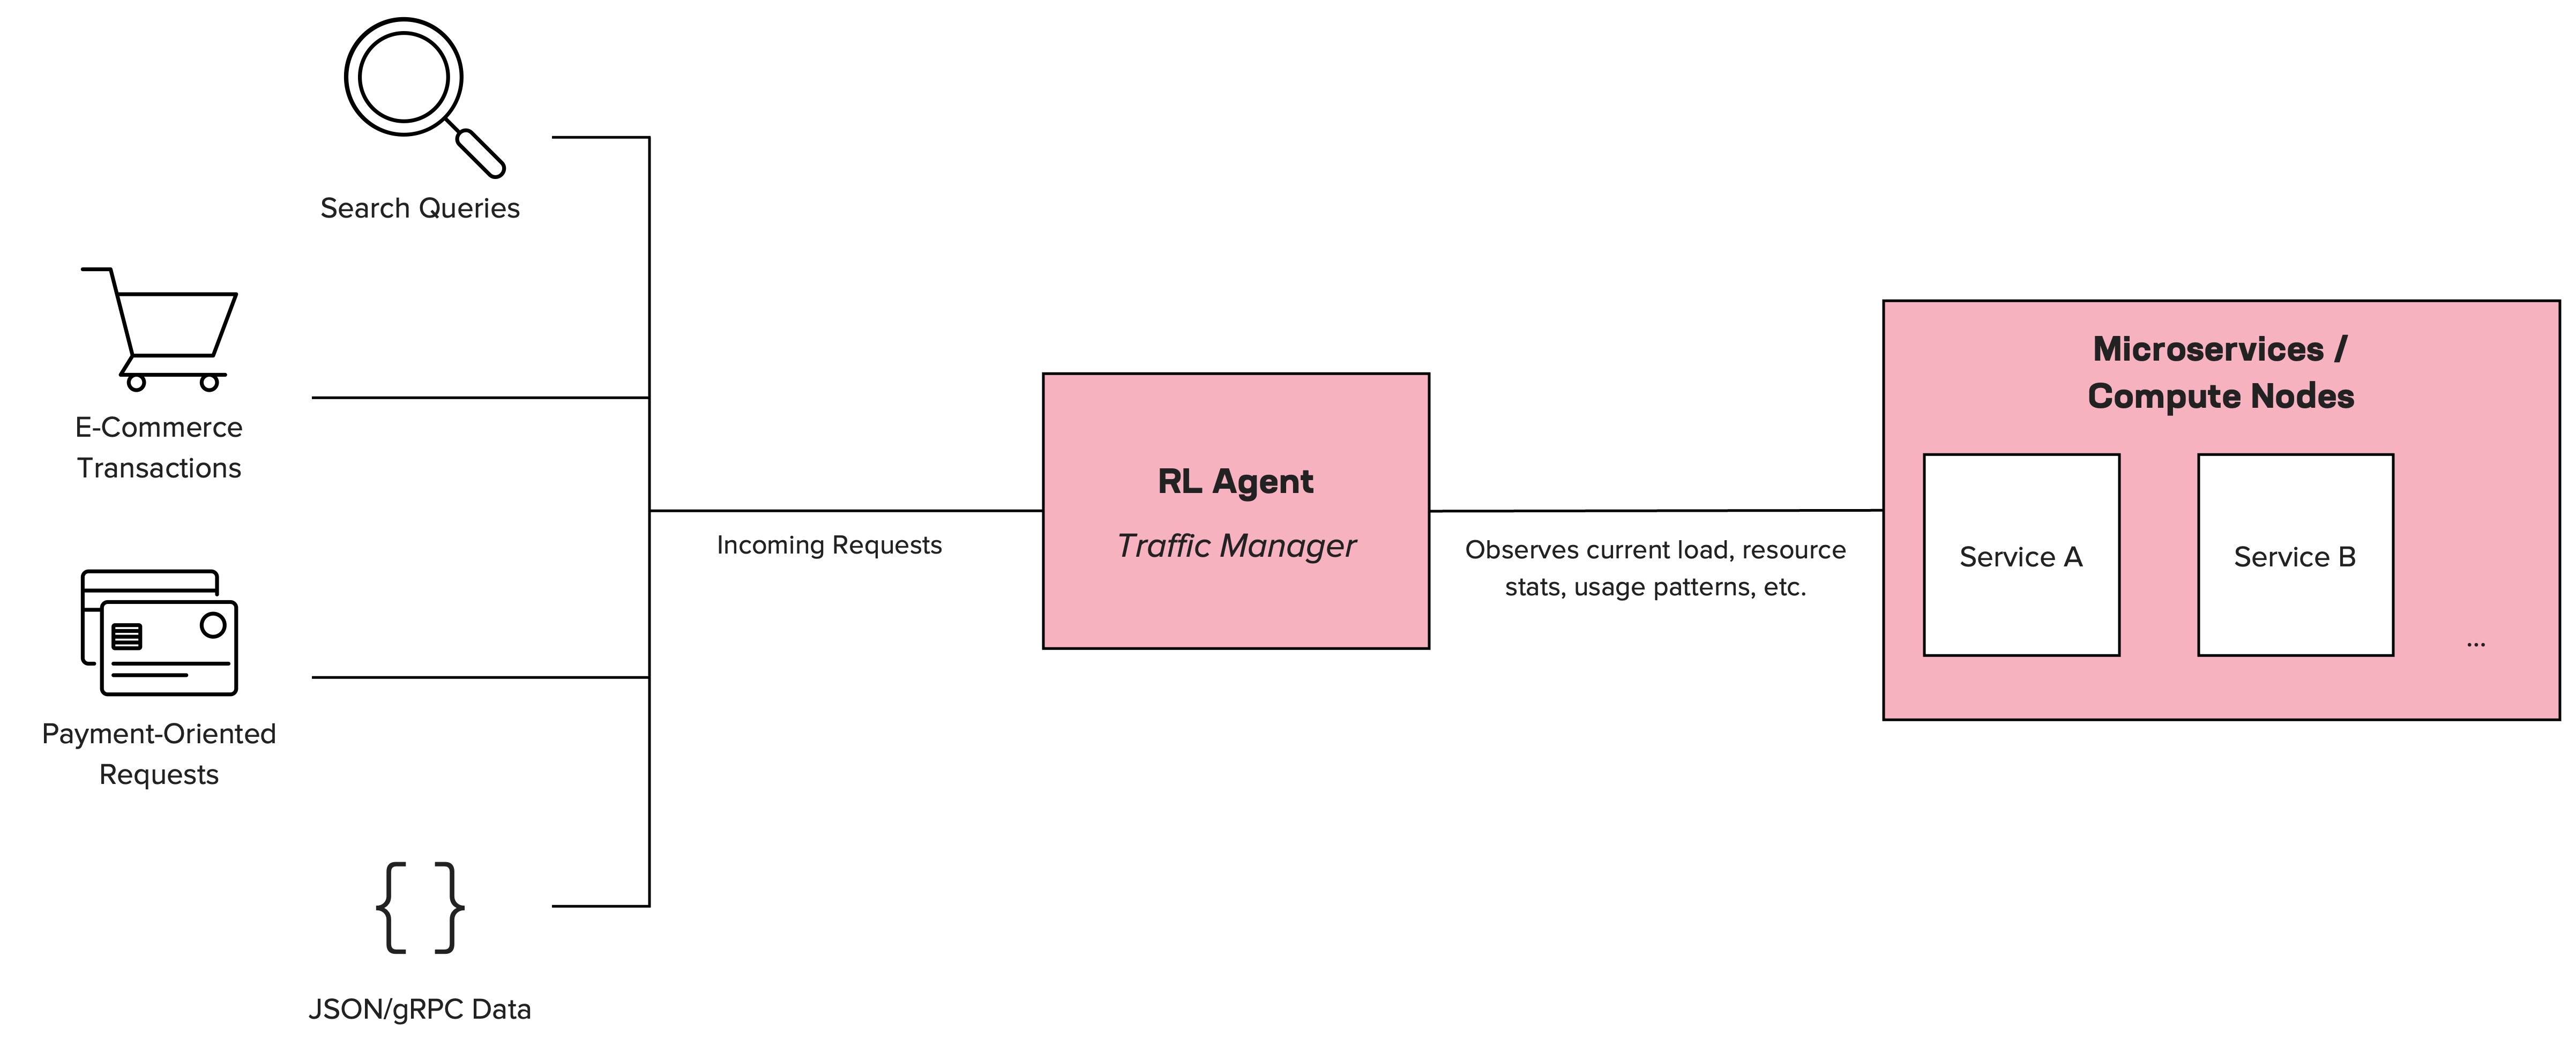
Dieses konzeptionelle Diagramm zeigt, wie der RL-Agent anstelle eines typischen Load Balancers (oder parallel dazu) eingesetzt wird.
- Eingehende Anfragen: Benutzer oder Clientanwendungen senden Anfragen.
- RL-Agent: Fungiert als zentrale Steuerungsinstanz für das Traffic-Management. Er überwacht Echtzeitmetriken (CPU-Auslastung, Arbeitsspeicher, Fehlerraten) und trifft Entscheidungen zur Weiterleitung oder Skalierung.
- Microservices / Knoten: Der RL-Agent startet auf Grundlage der Lernergebnisse die passenden Microservices oder leitet den Datenverkehr an bestimmte Knoten weiter.
Dieses Beispiel zeigt das Potenzial von RL, herkömmliche Lastverteilung in vielen Szenarien zu übertreffen.
Mögliche Fallstricke: Verfallen Sie noch nicht dem Hype
Natürlich ist RL kein Allheilmittel. Die Trainingszeiten können lang sein, und wir mussten in ein robustes Monitoring investieren, um sicherzustellen, dass der RL-Agent das Belohnungssignal nicht durch kurzfristige Entscheidungen „austrickst“, die dem Gesamtziel schaden. Wenn RL jedoch funktioniert, kann es herkömmliche Heuristiken deutlich übertreffen. Hier sind einige weitere Aspekte, die es zu berücksichtigen gilt:
1. Komplexität vs. Zuverlässigkeit
- Problem: RL führt eine zusätzliche Komplexitätsebene in ohnehin schon komplexe Systeme ein. Ohne sorgfältige Steuerung kann ein Agent in lokalen Optima stecken bleiben oder widersprüchliche Ziele verfolgen (Durchsatz vs. Kosten vs. Latenz).
- Gegenmaßnahme: Hybride Ansätze, bei denen RL übergeordnete Entscheidungen übernimmt, während bewährte Heuristiken als Ausfallsicherung dienen.
2. Datenqualität und Belohnungsdesign
- Problem: RL ist auf Belohnungssignale angewiesen. Wenn Ihre Kennzahlen nicht stimmen oder Sie Anreize für das falsche Verhalten setzen, kann der Agent Besonderheiten der Umgebung ausnutzen, die keinen echten geschäftlichen Mehrwert bieten.
- Gegenmaßnahme: Investieren Sie in eine zuverlässige Überwachung, die sorgfältige Konzeption von Metriken und umfassende Offline-Tests.
3. Ethische und regulatorische Bedenken
- Problem: Wenn ein RL-Agent aus Gründen der Kosteneffizienz unbeabsichtigt bestimmte Regionen oder Nutzungsmuster benachteiligt, könnte er ethische oder rechtliche Grenzen überschreiten.
- Gegenmaßnahme: Implementierungsteams müssen zulässige Maßnahmen im Voraus festlegen und ML-gestützte Entscheidungen regelmäßig überprüfen.
Allgemeine Trends bei der Einführung in der Branche im Jahr 2025
Über unsere internen Experimente hinaus sorgt RL in der Branche für viel Gesprächsstoff. Einige Highlights:
- Konferenzbeiträge: Renommierte KI-Konferenzen wie die NeurIPS ‘24 widmen dem verteilten bestärkenden Lernen zur Netzwerkoptimierung ganze Themenbereiche.
- Cloud-Anbieter: Große Cloud-Anbieter bieten inzwischen spezialisierte Toolkits für RL-basierte automatische Skalierung und Datenverkehrssteuerung an und schließen damit die Lücke zwischen akademischer Forschung und praktischen Werkzeugen.
- Edge-Bereitstellungen: Mit dem Aufkommen von 5G- und Edge-Netzwerken besteht ein dringender Bedarf, Ressourcen über viele kleine Rechenzentren hinweg zu orchestrieren. Die Anpassungsfähigkeit von RL eignet sich gut für diese dynamischen, geografisch verteilten Architekturen.
Dennoch steckt der Einsatz von RL für das Verkehrsmanagement in Unternehmen noch in den Kinderschuhen. Viele Unternehmen zögern weiterhin, da sie Bedenken hinsichtlich der Unvorhersehbarkeit haben oder Schwierigkeiten sehen, Compliance-Teams oder Aufsichtsbehörden die Entscheidungen von RL zu erklären. Dies unterstreicht die Bedeutung von erklärbarer künstlicher Intelligenz (XAI) – einem aktiven Forschungsgebiet, das darauf abzielt, nachvollziehbar zu machen, wie ML-Modelle zu ihren Entscheidungen gelangen.
Eine Vision für 2030
Meiner Ansicht nach wird sich das RL-basierte Verkehrsmanagement in den nächsten fünf Jahren von Nischenversuchen hin zu einer breiteren Einführung bei zukunftsorientierten Unternehmen entwickeln. Für 2030 prognostiziere ich:
- Dynamische Multi-Cloud-Orchestrierung: RL wird sich als Standard für die Orchestrierung von Workloads über mehrere öffentliche und private Clouds hinweg etablieren und Kosten sowie Leistung deutlich effizienter optimieren als die heute übliche manuelle Feinabstimmung.
- Engere Integration mit KI-Observability: Tools, die Entscheidungen von RL-Agenten nahtlos protokollieren, visualisieren und interpretieren, werden Compliance-Bedenken ausräumen und die Fehlerbehebung vereinfachen.
- Kollaborative Agenten: Wir werden erleben, wie mehrere RL-Agenten in einer gemeinsamen Umgebung zusammenarbeiten und dabei jeweils spezialisierte Aufgaben übernehmen – ähnlich wie ein Expertenteam, in dem sich einige um die Ressourcenzuweisung kümmern, während andere den Schwerpunkt auf Sicherheits- oder Dienstgüteanforderungen legen.
Auch wenn einige Skeptiker bezweifeln, dass RL diese Versprechen einlösen wird, sehe ich darin einen vielversprechenden Weg, um die unvermeidlichen Herausforderungen zu bewältigen, die mit zunehmender Komplexität einhergehen. Meiner Erfahrung nach gewinnt diese Entwicklung bereits an Dynamik, und ich bin überzeugt, dass RL die Zukunft des Traffic-Managements weiterhin prägen wird, da Unternehmen nach anpassungsfähigeren, intelligenteren Lösungen suchen.
Ihre nächsten Schritte
Ist es also an der Zeit, Ihre bewährten Load Balancer auszumustern? Noch nicht – aber wenn Sie es nicht ohnehin schon tun, sollten Sie unbedingt damit beginnen, mit RL-basierten Ansätzen zu experimentieren. Testen Sie diese in Umgebungen mit geringerem Risiko, messen Sie die Leistungssteigerungen und arbeiten Sie mit funktionsübergreifenden Teams zusammen. So können Sie einen praxisnahen Fahrplan entwickeln, der das Potenzial von RL mit den realen Rahmenbedingungen in Einklang bringt.
Ähnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.