In der sich stetig weiterentwickelnden Welt der Anwendungsbereitstellung investieren Unternehmen massiv in moderne Infrastrukturen, Anwendungen und intelligente Automatisierung. Doch trotz dieser Investitionen kämpfen viele noch immer mit Problemen, die längst gelöst sein sollten: Systeme, die unter hoher Belastung ausfallen, Bereitstellungsrichtlinien, die nicht in allen Umgebungen greifen, und Arbeitsabläufe, die genau dann zum Erliegen kommen, wenn Geschwindigkeit am dringendsten gefragt ist.
Zwei der zehn größten Herausforderungen bei der Bereitstellung, mit denen Unternehmen heute konfrontiert sind, sind besonders aufschlussreich: mangelnde Fehlertoleranz und Ausfallsicherheit sowie inkompatible Bereitstellungsrichtlinien. Auf den ersten Blick mag es sich dabei um Infrastruktur- oder Toolprobleme handeln. Bei genauerer Betrachtung wird jedoch deutlich, dass sie Symptome eines tiefer liegenden strukturellen Mangels sind: der Komplexität operativer Workflows.
Diese Komplexität ist nicht nur lästig. Sie beeinträchtigt aktiv die Laufzeitleistung, untergräbt die Konsistenz von Richtlinien und hindert Unternehmen daran, das volle Potenzial ihrer Investitionen in die digitale Transformation auszuschöpfen.
Komplexität ist das größte betriebliche Hindernis
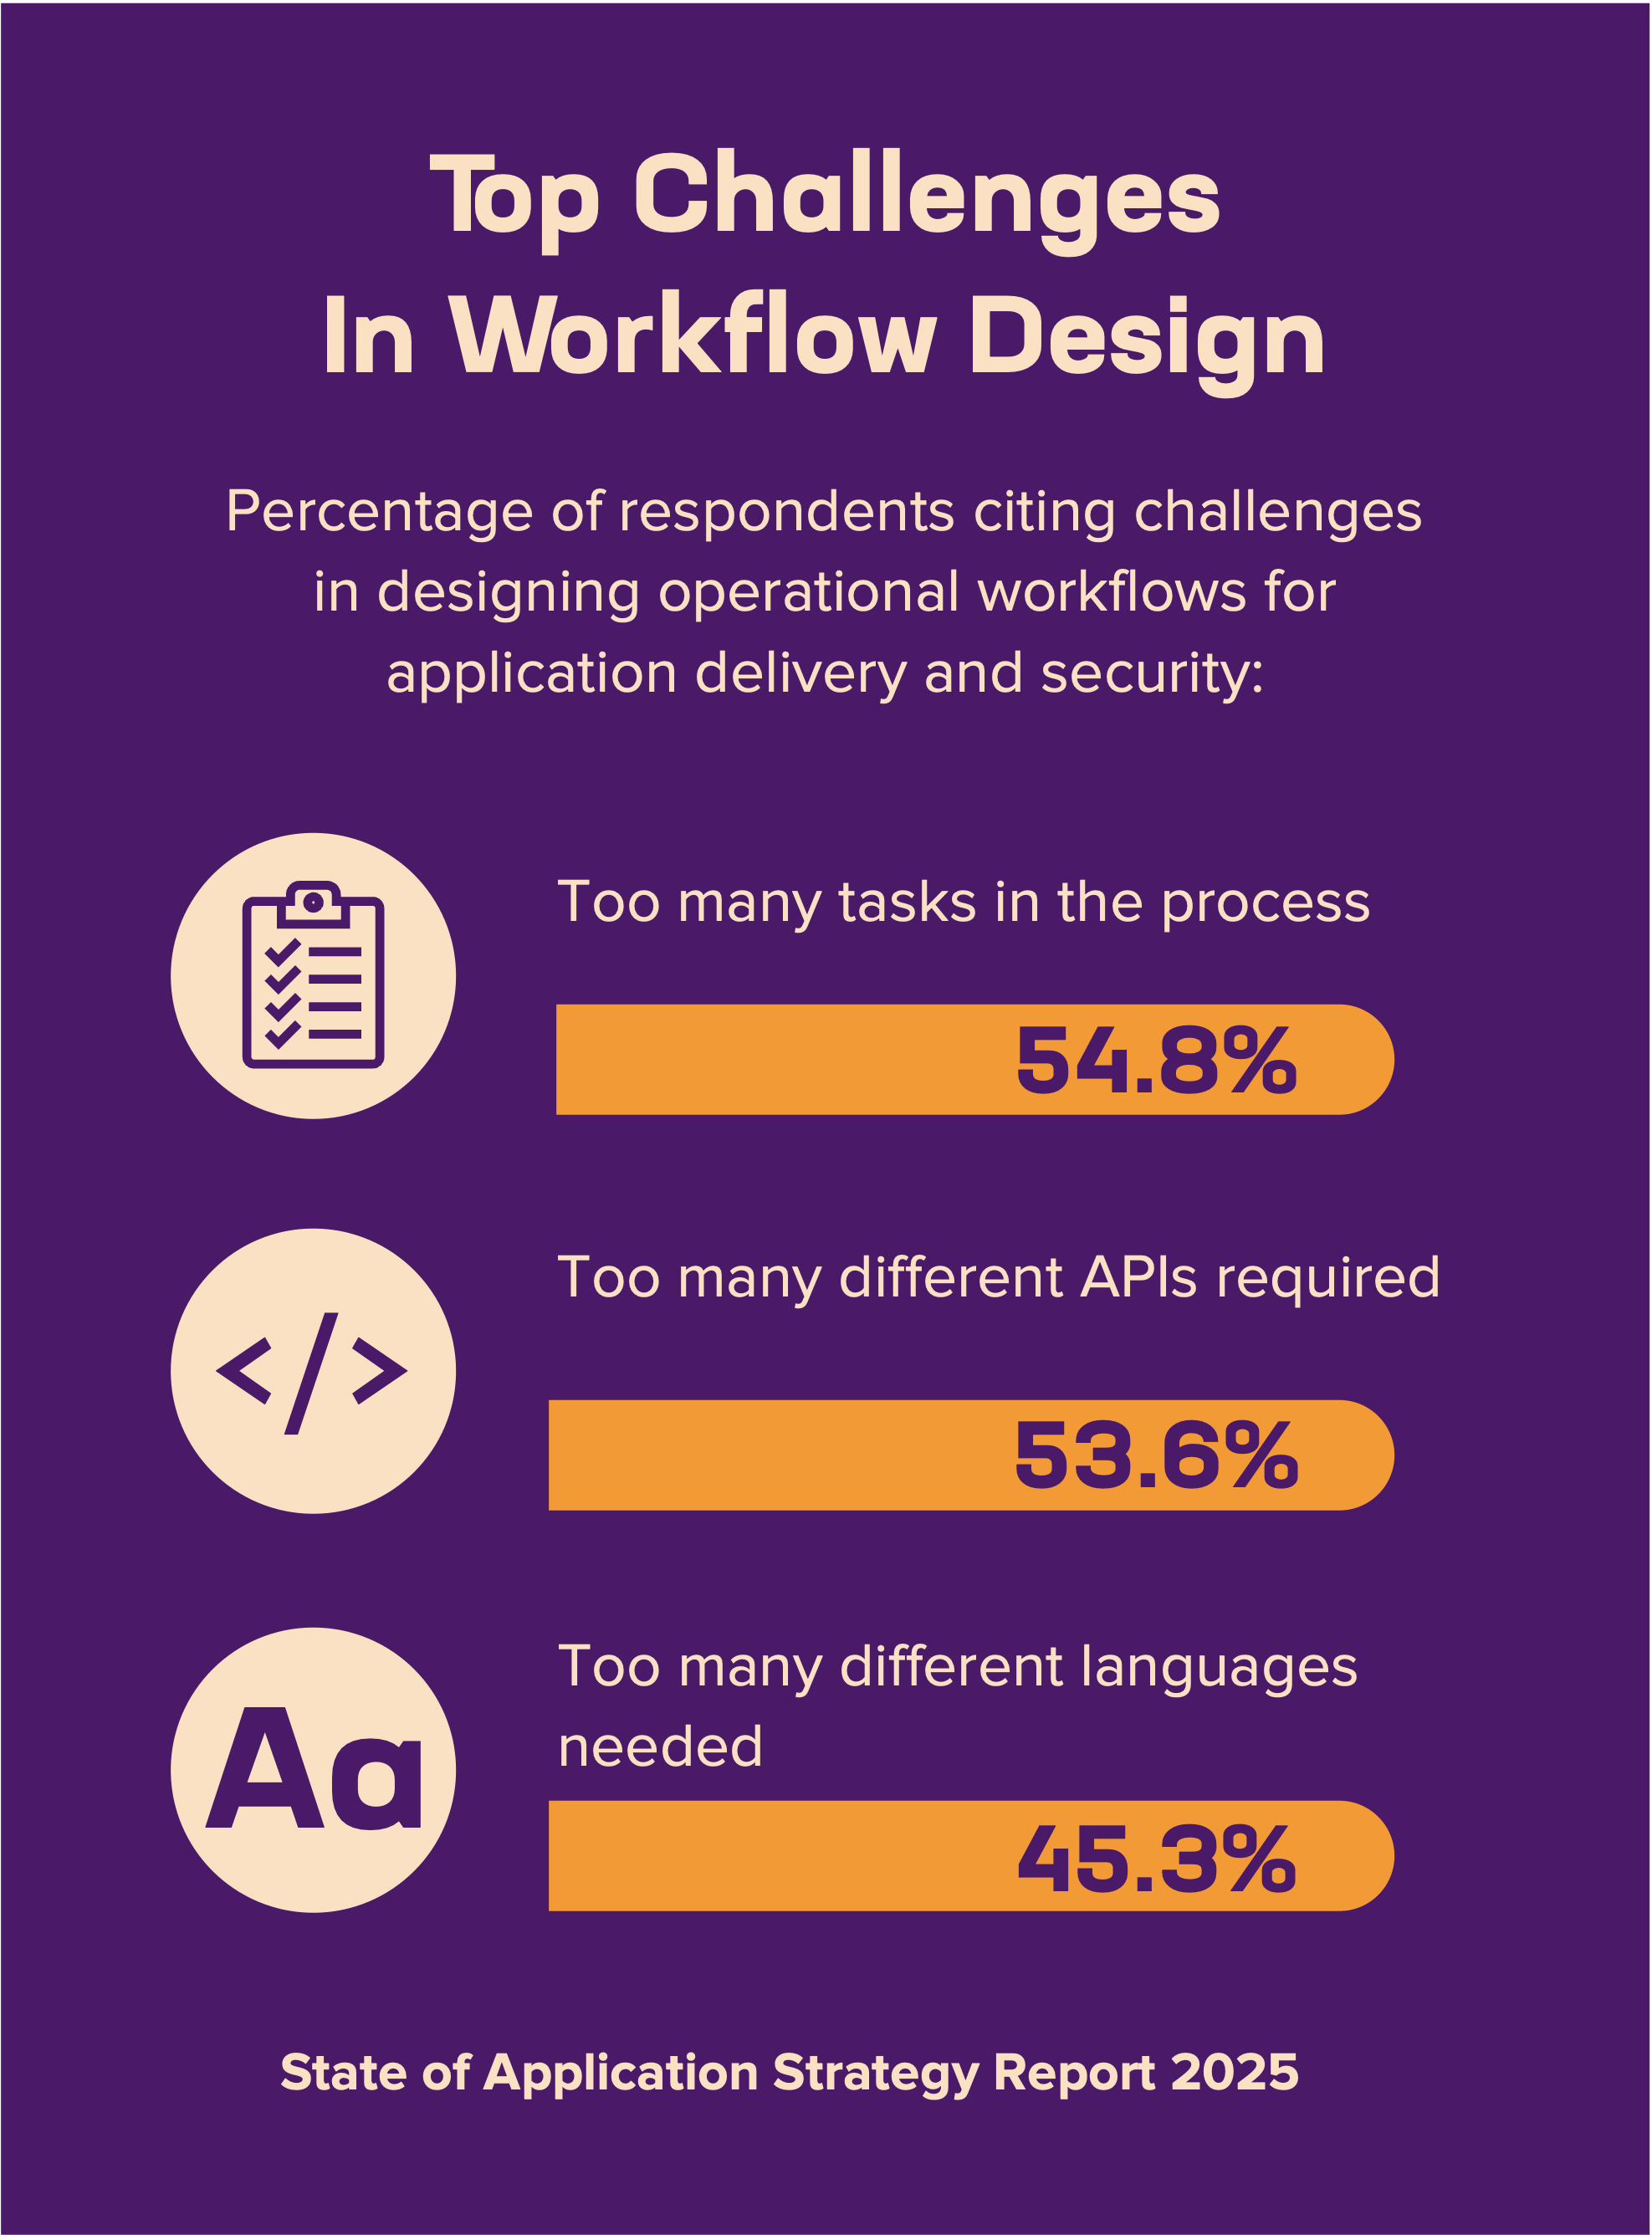
Und das ist nicht das einzige Warnsignal. Fast ebenso viele, nämlich 53,6 %, gaben an, dass „zu viele verschiedene APIs“ an ihren Workflows beteiligt seien. Weitere 45,3 % nannten „zu viele erforderliche Programmiersprachen“ als eine der größten Herausforderungen. Das ist Fragmentierung auf der operativen Ebene: unterschiedliche Tools, unterschiedliche Syntaxen, unterschiedliche Verantwortliche. All das verursacht zusätzlichen Aufwand und birgt Risiken.
Diese Zahlen sollten jeden beunruhigen, dem Verfügbarkeit, Benutzerfreundlichkeit oder operative Geschwindigkeit wichtig sind.
Wie Komplexität die Resilienz beeinträchtigt
Beginnen wir mit „ADC02 Mangelnde Fehlertoleranz und Resilienz“. In einem typischen modernen Anwendungs-Stack gibt es möglicherweise ein halbes Dutzend verschiedener Schichten, die für Routing, Lastverteilung, Service Discovery, Authentifizierung, Telemetrie und die Durchsetzung von Richtlinien zuständig sind. Jede dieser Schichten könnte von einem anderen Team verantwortet werden. Jede könnte über eine eigene API, einen eigenen Prozess zur Änderungskontrolle und eine eigene Sprache verfügen.
Was passiert, wenn etwas schiefgeht?
Ein Failover wird nicht ausgelöst, weil die vorgelagerte Abhängigkeit den Ausfall des Knotens nicht erkannt hat. Ein neues Deployment leitet den Datenverkehr fehl, weil das Service Mesh nicht mit dem Load Balancer synchronisiert war. Es dauert mehrere Minuten, einen Latenzanstieg einzugrenzen, weil die Observability-Tools nicht über alle Ebenen hinweg einheitlich konfiguriert waren.
Das sind keine seltenen Sonderfälle. Es handelt sich um alltägliche Betriebsstörungen, die durch ausufernde Workflows verursacht werden. Und sie stehen in direktem Zusammenhang mit den Daten, denen zufolge 29 % der Befragten zur Unterstützung der Automatisierung noch immer auf benutzerdefinierte Skripte setzen. Das ist ein deutliches Warnsignal. Komplexität mit Skripten zu überbrücken, ist keine Automatisierung, sondern ein fragiles Provisorium. Es versagt, wenn sich die Umgebung ändert, und verzögert die Wiederherstellung, wenn die Leistung nachlässt.
Wenn betriebliche Workflows durch zahlreiche Übergaben, nur informell weitergegebenes Wissen und manuelle Fehlerbehebung aufgebläht sind, gibt es keine echte Fehlertoleranz. Nur Hoffnung.
Wenn Richtlinien nicht mit der Anwendung mitwandern
Wenn die meisten Menschen den Begriff „Policy Drift“ hören, denken sie an Sicherheit. Doch Abweichungen bei Richtlinien für die Anwendungsbereitstellung – etwa bei Regeln für die Datenverkehrssteuerung, dem Lastverteilungsverhalten oder Konfigurationen zur Ratenbegrenzung – können ebenso schädlich sein. Dies ist eine der Ursachen für ADC07 Inkompatible Bereitstellungsrichtlinien.
In einer gut orchestrierten Pipeline sollten die Richtlinien der Anwendung von der Entwicklungs- über die Staging- bis hin zur Produktionsumgebung folgen. In der Praxis erfolgen die Übergaben zwischen den Umgebungen jedoch häufig manuell, uneinheitlich und abhängig von den eingesetzten Tools. Eine in der Staging-Umgebung definierte Lastverteilungsregel stimmt möglicherweise nicht mit der Konfiguration in der Public Cloud überein. Eine in der Entwicklungsumgebung getestete Routing-Richtlinie wird unter Umständen aufgrund umgebungsspezifischer Einschränkungen oder eines Versehens nicht in die Produktionsumgebung übernommen. Schwellenwerte für Canary-Releases, Caching-Verhalten und Failover-Logik – all dies sind Richtlinien der Bereitstellungsebene, die sich während des Deployments häufig ungewollt verändern.
Die Ursache ist dieselbe, die auch im F5 2025 State of Application Strategy Report genannt wird: Komplexität. Da 45,3 % der Befragten angaben, dass „zu viele verschiedene Sprachen erforderlich“ seien, und 53,6 % „zu viele verschiedene APIs“ nannten, wird deutlich, dass die Bereitstellungsabläufe über verschiedene Tool-Ökosysteme hinweg fragmentiert sind. Jede Umgebung verwendet möglicherweise andere Konfigurationsmodelle oder Infrastructure-as-Code-Plattformen, sodass bei jedem Schritt eine Übertragung erforderlich ist.
Übersetzungen bergen Risiken. Sie führen außerdem zu Verzögerungen. Wenn Bereitstellungsrichtlinien manuell neu geschrieben oder zwischen Systemen angepasst werden müssen, leidet die Konsistenz der Rollouts. Und in verteilten Systemen ist Inkonsistenz oft schlimmer als ein Ausfall, da sie zu unvorhersehbarem Verhalten führt.
Stellen Sie sich eine Bereitstellung über mehrere Regionen hinweg vor, bei der eine Richtlinie zur Datenverkehrssteuerung nur in einer Zone greift. Oder eine globale Anwendung mit uneinheitlichen Cache-Regeln auf verschiedenen Edge-Knoten. Das Ergebnis ist eine beeinträchtigte Benutzererfahrung, deren Ursache schwer nachzuvollziehen und noch schwerer zu beheben ist.
Damit Unternehmen schnell vorankommen können, ohne dabei Probleme zu verursachen, benötigen sie Bereitstellungsrichtlinien, die deklarativ und portabel sind und auf jeder Ebene des Stacks einheitlich durchgesetzt werden. Das ist unmöglich, wenn Workflows auf einem Flickenteppich aus manuellen Prozessen und teamspezifischer Logik beruhen.
Solange Bereitstellungsrichtlinien nicht als vollwertige Bestandteile behandelt werden – also auf Augenhöhe mit Anwendungscode und Infrastrukturkonfiguration –, werden Unternehmen weiterhin mit Konfigurationsabweichungen, Ausfallzeiten und Verzögerungen bei der Bereitstellung zu kämpfen haben. Die Vereinfachung dieser Workflows ist der erste und wichtigste Schritt.
Optimierung ist längst kein optionaler Schritt mehr
Bei der Reduzierung der Workflow-Komplexität geht es nicht darum, das Architekturdiagramm aufzuräumen oder die Betriebsteams zufriedenzustellen (auch wenn beides dadurch erreicht würde). Vielmehr geht es darum, die zentralen Versprechen moderner Anwendungsinfrastrukturen einzulösen: Geschwindigkeit, Ausfallsicherheit und Konsistenz.
Unternehmen, die die Laufzeitleistung verbessern und ein vorhersehbares Bereitstellungsverhalten sicherstellen möchten, müssen genau prüfen, wie viele Tools, Teams und Übergaben an ihren Pipelines beteiligt sind. Und noch wichtiger: Sie müssen sich fragen, wie viele dieser Schritte einen Mehrwert schaffen und wie viele lediglich dazu dienen, Einschränkungen des Systems zu umgehen.
Die Antwort ist nicht immer ein neues Tool. Manchmal sind es weniger Tools. Manchmal ist es eine einzige, einheitliche Plattform, die die Bereitstellungslogik in jeder Umgebung mit derselben Syntax und demselben Verhalten durchsetzt. Manchmal geht es darum, nicht nur die Bereitstellung, sondern auch die Governance zu automatisieren, sodass Bereitstellungsrichtlinien als Code und nicht als Checkliste umgesetzt werden.
Der Weg zu einer resilienten und zuverlässigen Softwarebereitstellung führt über Vereinfachung. Solange wir Komplexität nicht als kritisches Risiko betrachten, wird sie weiterhin alles untergraben, was wir darauf aufgebaut haben.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.