Manche scheinen LLMs mit KI-Agenten gleichzusetzen. Räumen wir doch ein für alle Mal mit diesem Missverständnis auf. Zwar „erweitern“ einige Chatbots so, dass sie Tools ausführen können, und bezeichnen sie dann als KI-Agenten. Doch wenn Sie Agenten für fortschrittliche Automatisierung einsetzen möchten, ist das kein ausgereifter Ansatz. Und das möchten Sie natürlich, denn Sie wissen, dass dies einer der wertvollsten Anwendungsfälle ist – schließlich gilt es, der zunehmenden betrieblichen Überlastung entgegenzuwirken, die durch die Komplexität hybrider Multicloud-Umgebungen verursacht wird.
Ein KI-Agent sollte eine Softwareeinheit (eine Anwendung) sein – ein abgegrenztes System, das Ziele interpretiert, den Kontext aufrechterhält und Aktionen durch den Aufruf von Tools ausführt. Er kann ein Large Language Model (LLM) verwenden, um zu ermitteln, was geschehen muss, doch das LLM ist nur ein Teil des Gesamtmechanismus. Der Agent ist das System.
In der Praxis erhält ein KI-Agent eine Aufgabe (explizit oder implizit), bewertet sie innerhalb eines festgelegten Kontexts und entscheidet, wie er vorgeht. Zu den möglichen Aktionen gehören das Aufrufen von Tools, das Abfragen von Systemen oder das Auslösen von Workflows.
Sie brauchen jedoch keinen ganzen Schwarm von Agenten, um von einem einzelnen zu profitieren. Ein klar abgegrenzter einzelner Agent, der an eine kompakte Toolchain angebunden ist, kann schon heute nützliche Aufgaben übernehmen. Er kann Zusammenfassungen automatisieren, Berichte erstellen, Tickets klassifizieren oder sogar Warnmeldungen an die richtigen Warteschlangen weiterleiten. Solange er seinen Zuständigkeitsbereich und die geltenden Richtlinien einhält, bietet er bereits einen echten Mehrwert.
Sie können KI-Agenten einsetzen, ohne agentische KI zu betreiben. Sobald Agenten jedoch zusammenarbeiten, betreiben Sie agentische KI – selbst wenn Ihre Architektur noch nicht darauf vorbereitet ist.
Auf Grundlage unserer neuesten Forschungsergebnisse gehe ich davon aus, dass Sie entweder bereits mit agentischem Verhalten zu tun haben (9 % der Befragten) oder sich darauf zubewegen (79 % der Befragten). Agentische KI erfordert ein Framework, das auf kontrollierter Ausführung basiert und in dem mehrere Agenten (ja, „Minions“, weil sie sich so leichter von agentischer KI unterscheiden lassen) mit gemeinsam genutzten Tools, kontextbezogenen Zielen und Durchsetzungsebenen wie MCP interagieren.
Was ist ein Agent?
Ein Agent ist ein Softwarekonstrukt, das innerhalb klar definierter Grenzen autonom oder teilautonom agiert. Er interpretiert Aufgaben, verwaltet den Kontext, ruft Tools auf und trifft Entscheidungen im Namen eines Benutzers oder eines übergeordneten Systems. In MCP-konformen Architekturen folgen Agenten einem strukturierten Protokoll, das das Zusammenspiel von Aufgaben, Status und Richtlinien regelt.
Agenten können schlussfolgern, Aufgaben delegieren und handeln – jedoch nur innerhalb der ihnen zugewiesenen Sandbox. Sie führen nicht eigenmächtig Systemaufrufe aus. Sie verschaffen sich nicht selbst Zugriff auf Tools. Jede Aktion sollte über eine deklarierte Schnittstelle erfolgen, die abgesichert, überwacht und widerrufen werden kann.
Ein Agent verfügt mindestens über Folgendes:
- Kontextverwaltung – Behält den Überblick über Zustand, Ziele und Gedächtnis (kurzfristig oder dauerhaft)
- Schlussfolgerungsmodul – In der Regel ein LLM oder symbolischer Planer, der Aufgaben interpretiert und deren Ausführung plant
- Werkzeugschnittstelle – Ordnet Absichten konkreten Aktionen zu und steuert, welche Vorgänge der Agent ausführen kann
- Sicherheitsgrenze – Legt fest, welche Aktionen der Agent in welchem Umfang ausführen darf
- Transportschicht – Überträgt Nachrichten und Kontext, typischerweise über MCP, HTTP oder einen Event-Bus
Ein LLM denkt. Ein Agent handelt. Die Plattform steuert.
Modelle zur Agentenerstellung
Es gibt zwei vorherrschende Modelle, und eines davon ist eine Falle.
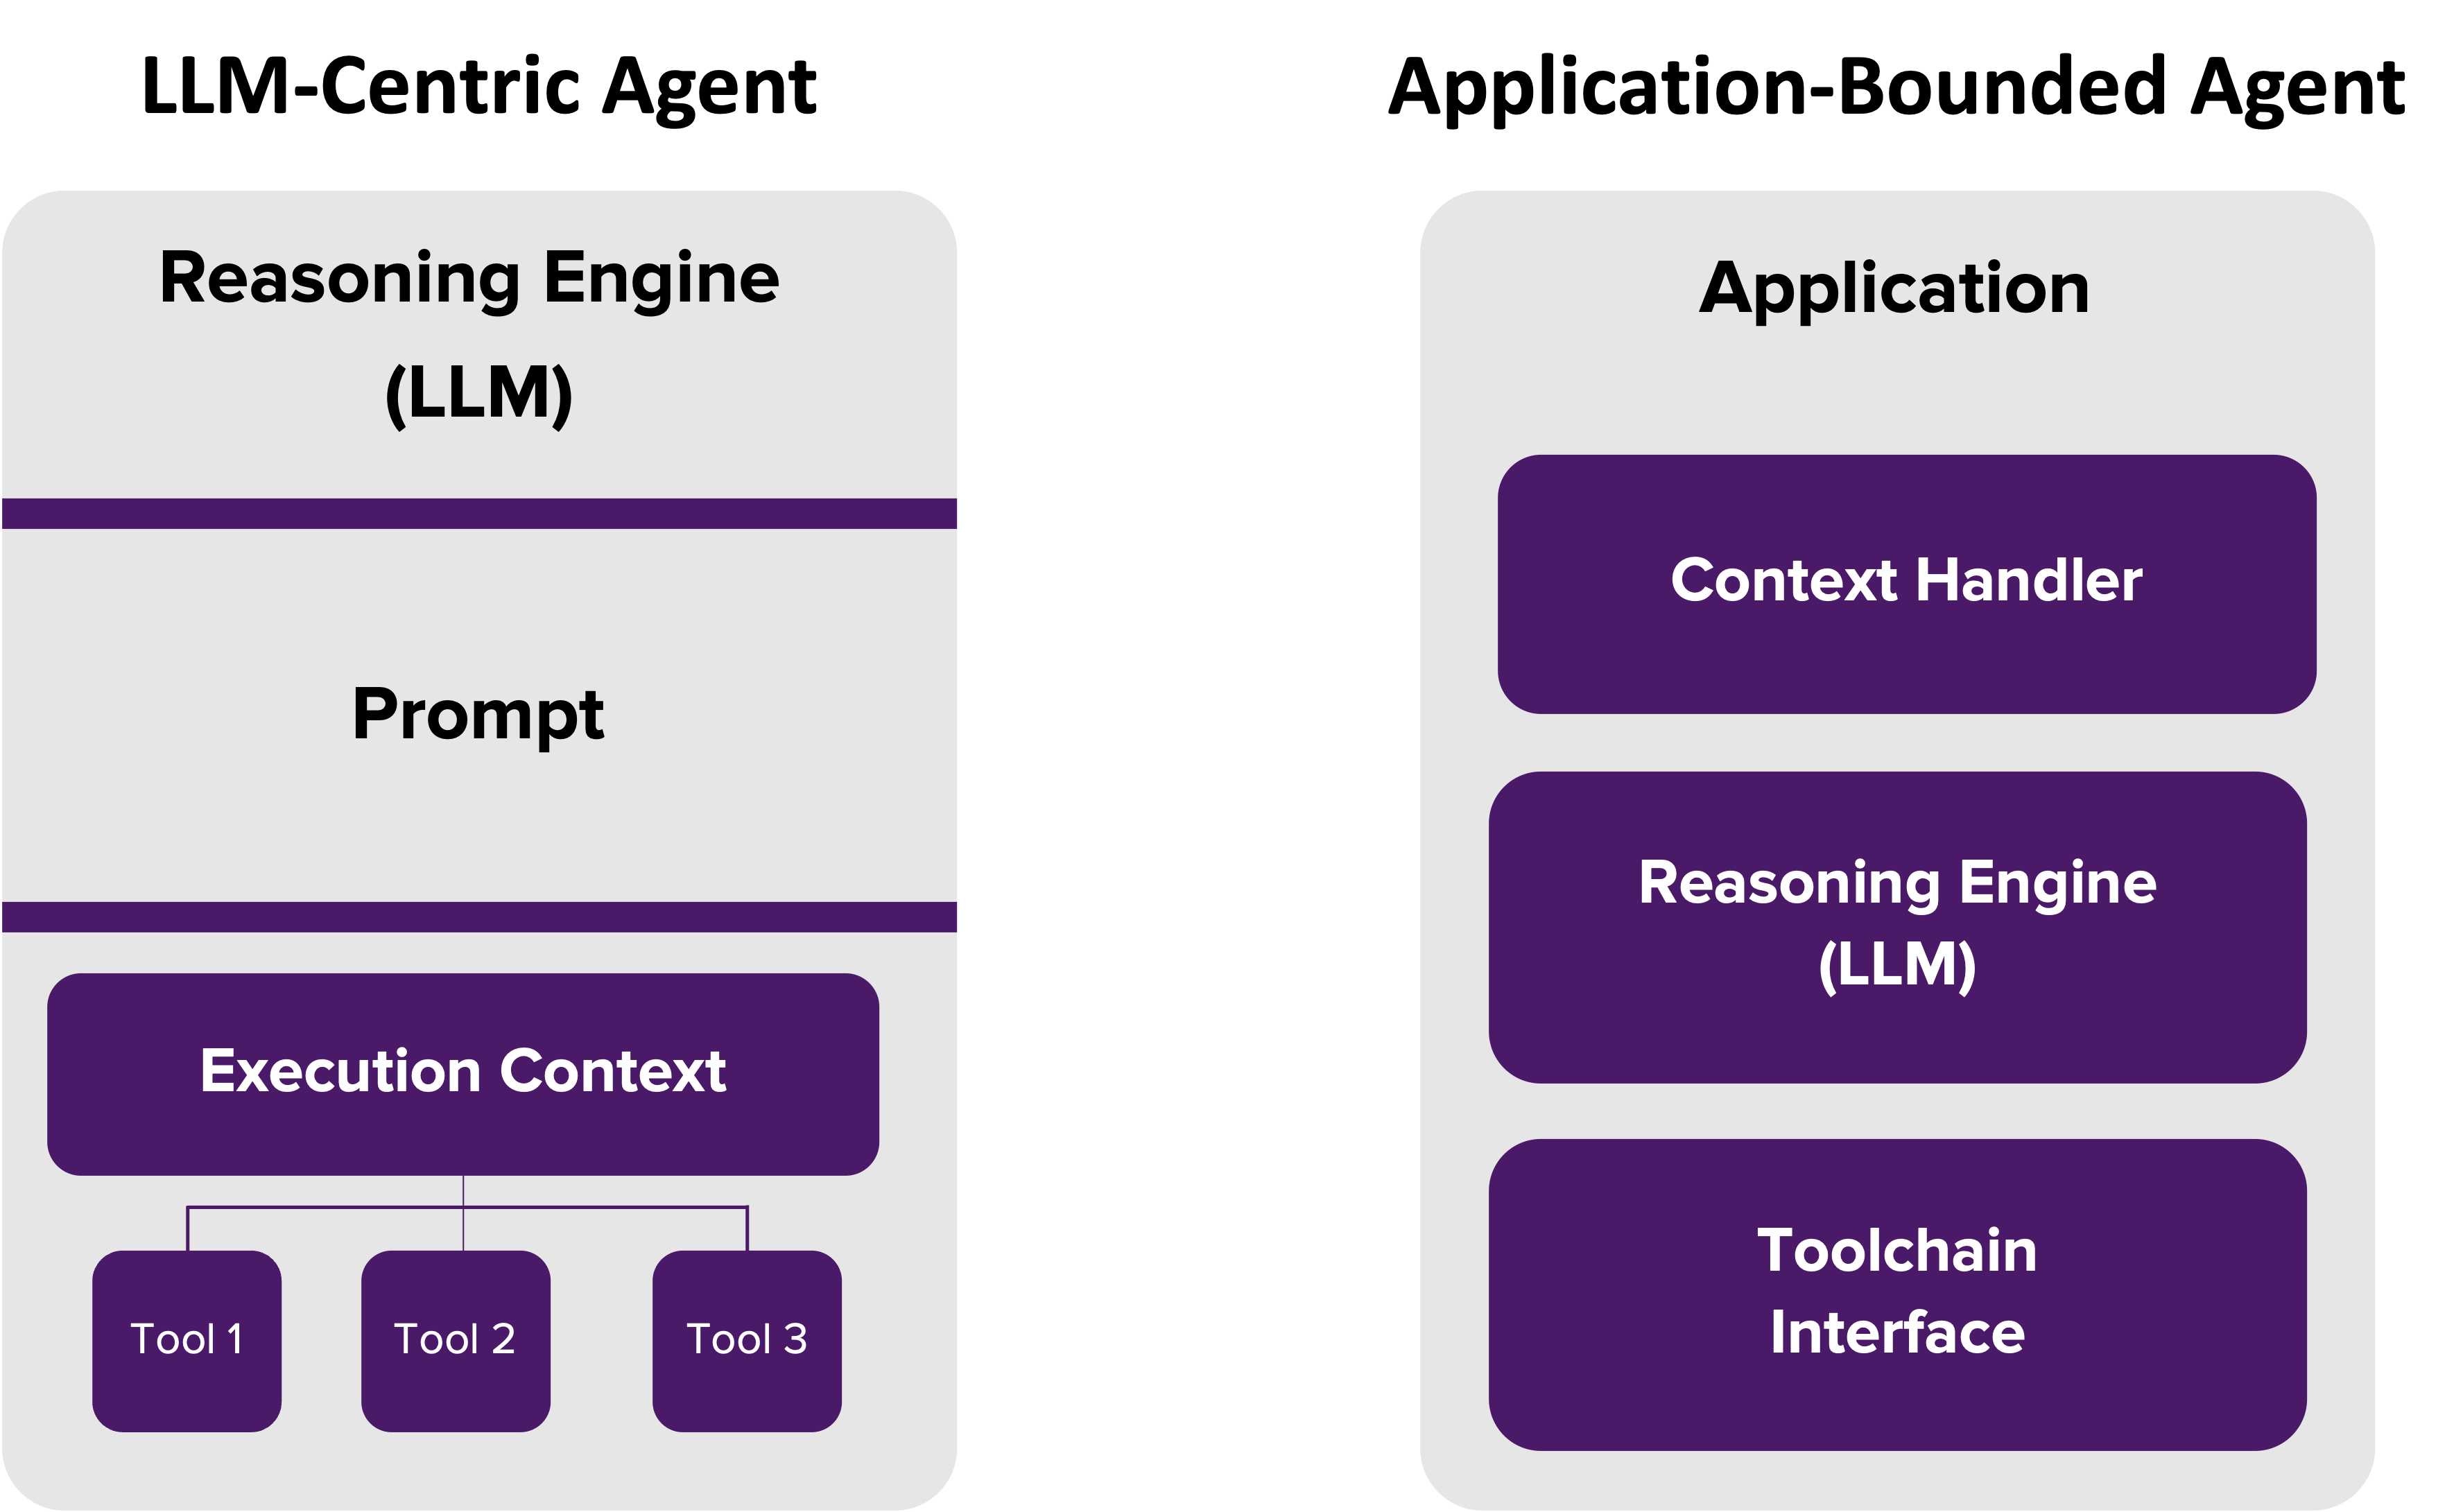
1. LLM-zentrierte Agenten (monolithisch)
Dies ist heute der Standard für die meisten Frameworks: LangChain, AutoGen, CrewAI usw. Der Agent ist im Wesentlichen ein Chat-Prompt mit eingebundenen Tools und optionalem Gedächtnis – alles im Rahmen einer einzigen LLM-Sitzung.
- Schnell als Prototyp umsetzbar
- Einfach zu demonstrieren
- Nicht sicher skalierbar
Einschränkungen:
- Keine persistente Architektur
- Keine native Richtliniendurchsetzung
- Das Modell kann leicht Tool-Aufrufe halluzinieren oder Einschränkungen vergessen
- Ohne Erweiterung keinerlei Beobachtbarkeit außerhalb von Token-Protokollen
Kurz gesagt: Es ist ein cleverer Praktikant mit Root-Zugriff und ohne Aufsicht. Funktioniert hervorragend – bis es das nicht mehr tut.
2. Anwendungsgebundene Agenten (modular)
Dieses Modell sollten Sie in der Produktion einsetzen.
Hier ist der Agent ein vollständiger Softwaredienst, der auf einem Framework basiert, das ein LLM nutzt, bei der Ausführung jedoch nicht davon abhängig ist.
- Der Zustand wird extern verwaltet (Redis, Vektordatenbanken, Richtlinien-Engines)
- Die Nutzung von Tools erfolgt explizit und wird durch eine Steuerungsebene verwaltet (MCP-Server, Gateway-Proxy)
- Sicherheit und Beobachtbarkeit haben höchste Priorität und sind kein nachträglicher Gedanke
- Der Agent ist ein bereitgestellter Dienst, kein Prompt
Dieser Ansatz bietet Ihnen Versionskontrolle, Zugriffsprotokolle, Governance auf Tool-Ebene und Laufzeitisolierung. So machen Sie aus Agenten statt Spielzeugen eine belastbare Infrastruktur.
Agenten sind keine Personas
Wenn Menschen Agenten so konzipieren, als wären sie intelligente Persönlichkeiten, greifen sie instinktiv auf menschenzentrierte Zugriffsmodelle zurück: rollenbasierte Zugriffskontrolle (RBAC), Anmelde-Token, Benutzerattribute und Identitätsbereiche. Diese sind sinnvoll, wenn man es über eine gesamte Sitzung hinweg mit einer konsistenten menschlichen Identität zu tun hat. Agenten verhalten sich jedoch nicht so. Sie sind keine Benutzer, sondern Ausführende. Und das ändert alles.
Agenten wechseln während ihrer Arbeit die Rollen. Ein einzelner Agent kann zunächst Daten abrufen, dann als Planer fungieren und anschließend eine Automatisierung auslösen – oft innerhalb derselben Sitzung und im Rahmen derselben übergeordneten Aufgabe. Er meldet sich nicht einfach an, ruft ein statisches Token ab und bleibt dann auf eine einzige Rolle beschränkt.
Hier versagt die herkömmliche Zugriffskontrolle. RBAC geht von statischen Rollen aus. Die attributbasierte Zugriffskontrolle (ABAC) setzt feste Attribute voraus. Sitzungstoken gehen von einem gleichbleibenden Geltungsbereich aus. Nichts davon trifft zu, wenn Agenten dynamisch agieren. In agentenbasierten Systemen ist Identität funktional, nicht personenbezogen.
Deshalb erfordert die Governance von Agenten eine Abkehr von identitätsbasierten Richtlinien hin zu ausführungsbasierten Richtlinien. Jeder Tool-Aufruf muss in Echtzeit anhand der aktuellen Aufgabenrolle, des Kontextstatus und des zulässigen Handlungsspielraums des Agenten validiert werden. Richtlinien sind auf der Tool-Ebene angesiedelt, nicht auf der Authentifizierungsebene. Kontextblöcke – nicht Anmeldesitzungen – enthalten die erforderlichen Metadaten, um diese Richtlinien durchzusetzen. Daher bezeichnen wir diesen Paradigmenwechsel als „Policy in Payload“, denn die Richtlinie befindet sich buchstäblich in der Nutzlast.
Behandeln Sie Agenten wie Agenten. Steuern Sie sie wie Software. Und vergessen Sie nie: Das LLM denkt, der Agent handelt und die Plattform kontrolliert. Wer diese Rollen verwechselt, erschafft eine Persönlichkeit mit Administratorrechten, die sich nicht an ihren letzten Fehler erinnert.
Das LLM denkt. Der Agent handelt. Die Plattform steuert.
Halten Sie sich daran, und Sie schaffen eine Agenteninfrastruktur, die skalierbar und sicher ist und auch dem Praxiseinsatz standhält.
Über den Autor

Lori MacVittie ist Distinguished Engineer und Chief Evangelist im Office of the CTO von F5 und verfügt über umfassende Expertise in den Bereichen Anwendungsbereitstellung, Automatisierungsstrategie und Infrastruktur. Sie ist dafür bekannt, Komplexität verständlich zu machen – ob sie Leitplanken für KI-Agenten definiert, fragile Multicloud-Architekturen analysiert oder die Grenzen skalierbarer Systeme auslotet. Sie verfügt über mehr als dreißig Jahre Branchenerfahrung in der Anwendungsentwicklung, IT-Architektur sowie im Netzwerk- und Systembetrieb. Bevor sie zu F5 kam, war sie als mehrfach ausgezeichnete Technologie-Redakteurin tätig. MacVittie hat einen Masterabschluss in Informatik und ist eine produktive Autorin, deren Veröffentlichungen die Bereiche Sicherheit, Cloud und Unternehmensarchitektur abdecken. Außerdem spielt sie leidenschaftlich gern Brett- und Videospiele und vertritt mit voller Überzeugung klare Ansichten zum Thema Käse.
Weitere Blogbeiträge von Lori Mac VittieÄhnliche Blogbeiträge

Ein umfassender Leitfaden zur Bereitstellung und Sicherheit von KI-Anwendungen
Entdecken Sie optimale Strategien für die Absicherung und Bereitstellung von KI-Anwendungen.
KI zulassen und einführen? Lehren aus der Public Cloud
Die Einführung von KI steht unmittelbar bevor und könnte entscheidend sein, um wettbewerbsfähig zu bleiben. Daher muss die IT-Sicherheit proaktiv handeln und der KI-Einführung schon jetzt einen Schritt voraus sein, um sie auf einen risikogerechten Weg zu lenken.
Stand der Anwendungsstrategie 2022: Zeit für die Modernisierung des Betriebs
Es ist deutlich geworden, dass Unternehmen ihren Fokus erneut auf die Geschäftsfunktionen richten müssen, um die Dynamik ihrer digitalen Transformation aufrechtzuerhalten. Kundenerlebnisse haben zwar weiterhin Priorität, doch auch Geschäftsfunktionen wie Recht, Personalwesen und Finanzen müssen digitalisiert werden. Das bedeutet, dass CIOs das Steuer übernehmen, während sich die digitale Transformation von der Modernisierung von Anwendungen hin zur Modernisierung von Betriebsabläufen verlagert.
F5s Weg zu einer vielseitigen Plattform für Anwendungsanalysen
F5 bietet heute die umfassendsten Anwendungsdienste entlang des gesamten Weges vom Code bis zum Kunden. Künftig werden wir verstärkt auf Anwendungstelemetrie und -analysen setzen, damit unsere Kunden wertvolle Erkenntnisse über ihre Anwendungen, Geschäftsabläufe und Benutzererlebnisse gewinnen können. Beim Ausbau unserer Cloud-Analysefunktionen werden wir ML und KI noch stärker nutzen, um unsere Kunden bei der Verbesserung ihrer Geschäftsdienste zu unterstützen.
Telemetrie: Eine andere Art von Daten
Verwenden wir den Begriff „Telemetrie“ nur, weil er attraktiver klingt als „Daten“? Letztlich sind sowohl Daten als auch Telemetrie strukturierte Informationseinheiten. Es ist kein Verbrechen, die Begriffe synonym zu verwenden. Doch wenn man es genau nimmt, gibt es einen Unterschied. Und dieser Unterschied wird immer wichtiger werden, je weiter Unternehmen in die Datenökonomie vordringen.
MTTR bedeutet nicht „Mean Time to Reboot“
„Schnell scheitern“ lautet heute das Mantra für mehr Geschwindigkeit. Ob in DevOps oder im Geschäftsleben: Wer in einer digitalen Wirtschaft agiert, muss eine möglichst perfekte Verfügbarkeit gewährleisten.