AIデータパイプラインには、大規模なデータセットへの高速かつ信頼性の高いアクセスが不可欠です。トレーニングやファインチューニングに加え、RAGワークロードを処理するには、AIモデルファウンドリのワークフローとストレージ環境の間でデータを移動する高性能なパイプラインが必要です。F5 BIG-IPは、インテリジェントな負荷分散と詳細なトラフィック検査によってS3データ配信を最適化し、AIワークロードのスケーラビリティ、パフォーマンス、保護を確保します。
エンタープライズAIワークロードが直面するデータのボトルネック
AIモデルは、トレーニング、ファインチューニング、検索拡張生成(RAG)のワークフローで膨大な量のデータを使用します。これらのデータセットは、多くの場合、マルチクラウドおよびオンプレミスのオブジェクトストレージシステムに分散しています。データパスでインテリジェントなトラフィック管理を行わなければ、予測不能なレイテンシーや不均一なスループットが発生するほか、ボトルネックによってGPUがアイドル状態となり、インフラストラクチャコストが増加するという課題に直面します。
従来のストレージネットワーキング手法は、こうした課題をさらに深刻化させます。多くの場合、アプリケーションはオブジェクトストアに直接接続されるため、ワークロードが単一ベンダーのAPIや特定のリージョンに密接に結び付けられます。この柔軟性の欠如により、クラスターの処理速度が低下した場合、プロバイダー間でデータを移動する必要がある場合、または規制要件によってデータを自社環境へ戻す必要がある場合に、パイプラインの負荷を再調整することが困難になります。変更のたびに、ダウンタイムやデータの不整合、高コストなアプリケーションの書き換えといったリスクが生じます。
セキュリティによって、状況はさらに複雑になります。機密性の高いトレーニングデータや価値あるモデル出力は、共有ネットワークや、場合によっては信頼できないネットワークを経由します。一元的な検査とポリシー適用がなければ、組織はデータセットポイズニング、不正アクセス、データ流出を確実に防止できません。こうした不備により、AIの取り組みは運用の遅延、コンプライアンス違反、レピュテーションリスクにさらされます。
F5® Application Delivery and Security Platform(ADSP)でAIデータ配信の課題を解決
F5 BIG-IPを搭載したF5 ADSPは、S3互換のデータ配信に対応する、プログラム可能で高性能な制御ポイントを提供します。F5 BIG-IPは、特定のストレージバックエンドをアプリケーションから抽象化することで疎結合を実現し、ワークロードを変更することなく、クラウドとオンプレミスの環境間でシームレスに運用できるようにします。F5 BIG-IPはストレージの健全性を継続的に監視し、インテリジェントDNSと負荷分散を活用して、最もパフォーマンスの高いエンドポイントにトラフィックをルーティングします。これにより、高負荷時やトラフィック急増時にもパイプラインのレジリエンスを維持し、予測可能なパフォーマンスを確保します。
大規模環境でのパフォーマンスは、設計上の重要なポイントです。専用設計のF5ハードウェア上で動作するF5 BIG-IPソフトウェアは、毎秒数テラビットのスループットを処理し、個々のノードに過剰な負荷をかけることなく、ストレージクラスター間でデータを振り分けることができます。プログラム可能なトラフィック管理により、アーキテクトはフローの調整、優先順位付け、複製を行い、GPU使用率を最大化しながら輻輳を防止できます。これにより、トレーニングジョブとファインチューニングを効率的に実行できるほか、RAGクエリは効率的な実行に必要な速度と一貫性でデータを受信できます。
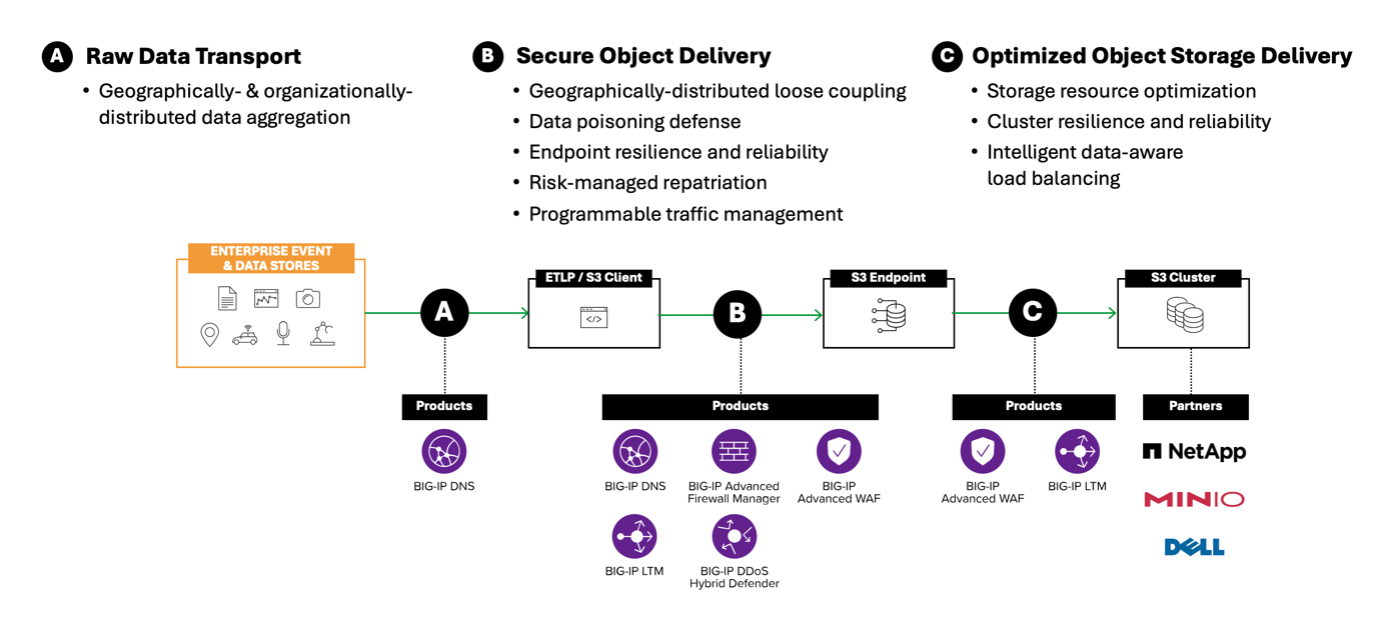
次の図は、F5 BIG-IPがあらゆるAIデータ取り込みワークフローの3つの重要な部分(モデルのトレーニング、ファインチューニング、RAG)をどのように支援するかを示しています。これらのワークフローコンポーネントはそれぞれ、地理的に分散したデータの集約、エンドポイントのレジリエンス、ストレージ配信の最適化といった基盤上の課題に対応します。インテリジェントDNSルーティング、プログラム可能なトラフィック管理、高度なセキュリティ適用などの機能を活用することで、F5はAIパイプラインの拡張性、信頼性、セキュリティの維持を支援します。このアーキテクチャは高いパフォーマンスを維持しながら、データ移動のライフサイクル全体にわたってデータポイズニングや不正アクセスから保護します。
F5では、セキュリティは後付けではなく、あらかじめ組み込まれています。F5 BIG-IPは、すべてのデータの受信ポイントと送信ポイントで一元的な検査を行い、汚染されたデータセットや不正な形式のデータセットがパイプラインに混入する前にブロックします。TLS終端、DDoS緩和、レイヤー7 API保護などの機能は、ストレージベンダーによる制御の範囲を超え、各種フレームワークや業界固有の要件への準拠に必要なガバナンスと監査可能性を組織に提供します。
AIアプリのデータフローを管理し、大規模環境でのネットワーク輻輳を防ぐことは、特にコアネットワーク内や複数拠点間において極めて重要です。F5は、単一シャーシで最大6 Tbpsまで拡張でき、複雑さとデータトラフィック量が増大し続ける最新のAIワークロードの要件に対応できます。F5® VELOS®は、AIデータをシステム間で最適にルーティングする、安全でレジリエントかつ高性能な負荷分散を実現し、迅速な処理と中断のない可用性を確保します。これにより、データが目的の宛先へ迅速かつ安全に到達し、AIアプリケーション全体のパフォーマンス向上につながります。
最適化されたAIデータパイプラインがビジネスに確かな成果をもたらす
AIデータパスにF5 BIG-IPを導入することで、組織はパイプラインの脆弱性を解消し、無駄なコンピューティングリソースを削減できます。GPUの使用率を最大限に維持し、ジョブの完了時間を短縮できるほか、データ量の増加に伴ってワークロードを予測可能な形で拡張できるという確信をAIチームが得られます。不要なボトルネックを回避することで、企業はモデル完成までの時間を短縮し、インフラストラクチャのROIを向上できます。
アプリケーションとストレージを疎結合にすることで、企業はコストのかかる書き換えやダウンタイムを伴わずに、新しいオブジェクトストレージソリューションの導入、新たなリージョンへの展開、パブリッククラウドからのワークロードの回帰が可能になります。この俊敏性は、コスト削減、ベンダー選択の柔軟性、レジリエンスの向上に直結します。これらは、AIの導入が加速し、ストレージ戦略が進化する中で極めて重要です。
最後に、ポリシー適用を一元化することで、データの完全性とコンプライアンスを後回しにすることなく確保できます。F5 BIG-IPは、機密データがエンドツーエンドで保護されていることを経営層に示すためにアーキテクトが必要とする可視性、オブザーバビリティ、適用機能を提供します。その結果、より高速で信頼性が高いだけでなく、セキュアでコンプライアンスに準拠し、エンタープライズ規模に対応できるAIインフラストラクチャを実現します。
主なメリット
パイプラインのボトルネックを解消
一貫した高性能のデータ配信によってGPUの稼働率を最大限に維持し、コンピューティングリソースのアイドル時間とジョブの遅延を削減します。
ストレージ環境全体の俊敏性を向上
アプリケーションを特定のストレージバックエンドから切り離すことで、コストのかかる書き換えを行わずに、クラウド間、リージョン間、またはオンプレミスへシームレスに移行できます。
データセキュリティとコンプライアンスを強化
一元化されたポリシー適用により、規制要件への準拠を確保しながら、データポイズニングや不正アクセスを阻止し、機密性の高いデータセットを保護します。
主な機能
サイトのレジリエンスと負荷分散を実現
ストレージの健全性を継続的に監視し、最適なエンドポイントまたはサイトにトラフィックをルーティングすることで、サービスのレジリエンスと予測可能なスループットを実現します。
インテリジェントなトラフィック管理を導入
フローのシェーピング、優先順位付け、複製を大規模に行い、GPU使用率を最大化するとともに、AIのトレーニング、ファインチューニング、RAGワークロードの処理における輻輳を防止します。
統合されたセキュリティ適用を確保
データパス上でTLS終端、分散型サービス拒否(DDoS)攻撃の緩和、レイヤー7のAPI保護を直接実行し、パイプラインを多層的に保護します。