Edge 2.0 – Grundprinzipien
Von Rajesh Narayanan, Michael Wiley
Einleitung
Die Definition der Edge war schon immer eng mit der Entwicklung der Rechenzentrumsarchitektur verknüpft. Im vergangenen Jahrzehnt hat sich die Architektur von Unternehmensinfrastrukturen rasant gewandelt und von lokalen Rechenzentren hin zu den heutigen verteilten Cloud-Architekturen entwickelt. Wir verstehen Edge 2.0 als einen technologischen Wandel, der es Anwendungen ermöglichen wird, die Vorteile einer verteilten Cloud-Architektur zu nutzen.
Jede Person, Organisation oder Institution hat eine andere Vorstellung davon, was unter Edge zu verstehen ist. Manche betrachten einen Mobilfunkmast als Edge, andere ihr Mobilgerät. Für Cloud-Service-Provider (CSPs) ist die Edge eine verwaltete Infrastruktur, die sich nahtlos in ihr Backend integrieren lässt. Bei militärischen Anwendungen ist die Edge der Einsatzraum – ob zu Land, zu Wasser oder in der Luft. Wenn wir etwas über die Edge lesen, wird sie im Allgemeinen anhand der Rechen-, Netzwerk- und Speicherkapazitäten der Infrastruktur und/oder ihres Standorts beschrieben.
Wir verstehen Edge 2.0 jedoch auch als das Erlebnis, das es allen Beteiligten im Ökosystem bietet, und nicht nur als Infrastrukturressource oder deren Standort.
Dieses Dokument beschreibt, welche Funktionen Edge 2.0 unabhängig von seiner physischen oder virtuellen Infrastruktur sowie seinem Standort oder Bereitstellungsort bieten sollte. Es soll nicht erläutern, wie sich eine bessere verteilte Anwendung entwickeln lässt, sondern aufzeigen, welche Fähigkeiten Edge 2.0 bieten muss, um die Entwicklung optimaler verteilter Anwendungen für spezifische Anforderungen zu unterstützen.
“Bei Edge 2.0 geht es um das Erlebnis, nicht um die Infrastruktur oder deren Standort.”
Was ist Edge 2.0?
Aus Sicht einer Entität, die sich in dieser verteilten Cloud befindet, liegt der Edge dort, wo sich die Entität gerade befindet. Daher schlagen wir eine Definition von Edge 2.0 vor, bei der das Nutzungserlebnis im Mittelpunkt steht und die nicht allein an den Standort oder die Art der Infrastruktur beziehungsweise an die kontrollierende Instanz gebunden ist.
Edge 2.0 konzentriert sich darauf, die anwendungs-, betriebs- und entwicklerzentrierte Nutzererfahrung zu verbessern. Edge 2.0 muss die Metaeigenschaften der Anwendung (wie SLAs und SLOs) berücksichtigen, indem es sich an deren wechselnde Anforderungen anpasst. Edge 2.0 muss einfach zu betreiben sein und Betriebsteams davon entlasten, für jede verteilte Anwendung neue Automatisierungen erstellen zu müssen. Edge 2.0 muss die Hürden für Entwickler bei der Entwicklung und Bereitstellung verteilter Anwendungen in großem Maßstab verringern, indem es Sicherheit, Governance und Service-Level-Ziele nahtlos unterstützt.
Nehmen wir als Beispiel eine Banking-Anwendung. Das Ziel von Edge 2.0 besteht nicht darin, die Geschäftslogik der Transaktion zu verbessern. Vielmehr soll die Anwendung sicherer, schneller und vertraulicher werden, in allen Regionen (je nach Bedarf) nutzbar sein und sich entsprechend den Geschäftszielen nach oben oder unten skalieren lassen.
Konzepte und Aussagen
Im Folgenden werden die zentralen Konzepte und Thesen dieses Beitrags vorgestellt:
- Erlebniszentrierter Edge-Ansatz: Schafft eine Grundlage für Edge 2.0, bei der das bereitgestellte Erlebnis im Mittelpunkt steht – und nicht ein Asset oder dessen Standorte.
- Designüberlegungen: Beschreibt die wichtigsten Designaspekte für eine erfolgreiche Implementierung der Edge-2.0-Architektur.
- Heterogene Infrastruktur: Hebt hervor, dass bei der Konzeption einer verteilten Cloud die dezentrale Steuerung der Infrastruktur berücksichtigt werden muss.
- Telemetrie als Grundlage: Betont die Bedeutung der Telemetrie als grundlegenden Baustein, der über alle Ebenen der Infrastruktur hinweg unterstützt werden muss. Ohne Telemetrie verliert eine Data-First-Strategie an Wirkung.
- Clusterübergreifende Herausforderungen: Hebt als grundlegende Herausforderung von Edge2.0 hervor, dass die Kommunikation zwischen Clustern statt innerhalb eines Clusters erfolgt.
- Adaptive Schnittstellen: Stellt adaptive Schnittstellen vor und bietet einen klaren Vergleich mit deklarativen und imperativen Schnittstellen.
- Edge 2.0 Application Platform (EAP): Stellt die EAP als Framework vor, das es Edge 2.0 ermöglicht, sich an die Anforderungen der Anwendungen anzupassen.
Nicht behandelte Themen
Es gibt mehrere Themen, die wir in diesem Beitrag noch nicht behandelt haben:
- Verteilung von Anwendungsdaten: Dieser Bereich umfasst zahlreiche Unterthemen wie Content Delivery Networks (CDNs), verteilte Speicherung, Datenverteilung, Caching usw. Hinzu kommen neue Technologien wie konfliktfrei replizierte Datentypen (Conflict-free Replicated Datatype, CRDT). Ein Edge-2.0-Framework sollte die Unterstützung für die Verteilung von Anwendungsdaten in seinen Anwendungsbereich aufnehmen.
- Funktionsverteilung: Die Weiterentwicklung des Edge Computing lässt sich als Verlagerung zentraler Cloud-Funktionen und -Logik näher an den Ort verstehen, an dem das Ereignis erzeugt wird oder sich die Daten befinden. Angesichts der erheblichen Rechenkapazität, die am Netzwerkrand verfügbar wird, sollten wir nun ähnliche Probleme lösen, wie sie üblicherweise in herkömmlichen Cloud-Architekturen bewältigt werden, wenn wir diese Rechenkapazität nutzen möchten. Dazu gehören beispielsweise Overlay-Netzwerke, Middleware-Workloads und andere Arten von Workloads, die miteinander verflochten und komplexer sind als die einfachen Anwendungsfälle, die wir in der Anfangsphase des Edge Computing gesehen haben – etwa Storlets, also einfache zustandslose Abläufe, die in unmittelbarer Nähe zu den Daten ausgeführt werden.
- Wahrscheinlich gibt es noch weitere Bereiche, die nicht behandelt wurden. Ziel des Frameworks ist es, erweiterbar zu sein, sodass bei Bedarf weitere Zuständigkeiten hinzugefügt werden können.
Edge-Entwicklung
Abbildung 1 veranschaulicht am besten die parallele Entwicklung von Edge- und Rechenzentrumsarchitekturen. Edge 1.0 und 1.5 basierten auf dem Konzept eines Ursprungsstandorts und der Verlagerung von Daten und Diensten vom Ursprung zum Verbraucher. Bei Edge 1.0 ging es um die Bereitstellung einer Internetinfrastruktur, die in erster Linie darauf ausgerichtet war, die Bandbreitennutzung durch verteiltes Content-Caching, auch bekannt als Content Delivery Networks, zu optimieren. CDNs sind ein grundlegendes Entwurfsmuster, da die Gesamtmenge der zu übertragenden Inhalte stets größer sein wird als die verfügbare Bandbreite.
Als die Kosten für CPU und Arbeitsspeicher rapide sanken, entstanden neben CDN-Knoten auch Rechencluster. Anwendungen wurden über serviceorientierte Architekturen (SOA) als Dienste genutzt. Daher wird Edge 1.5 auch als Service Distribution Network bezeichnet.
“Jede Entität betrachtet sich aus ihrer eigenen Perspektive als am Edge befindlich.”
Ein gemeinsames Merkmal von Edge 1.0 und Edge 1.5 ist das Konzept eines Ursprungsstandorts. Vor dem Aufkommen mobiler Technologien luden Menschen, Geräte und Dinge hauptsächlich Inhalte herunter oder nutzten den Dienst als Verbraucher. Der Standort, von dem der Dienst ausging, unterschied sich weiterhin vom Standort des Verbrauchers.
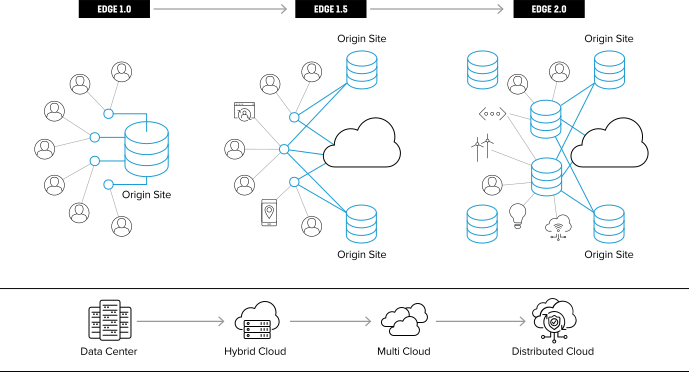
In Edge 2.0 kann jedoch jede Entität als Ursprungsstandort oder als Verbraucher fungieren. Der Datenverkehr hat sich verändert. Menschen, Smartphones und Geräte produzieren aktiv Daten, indem sie Inhalte hochladen oder regelmäßig Daten generieren. Apps werden zu Verbrauchern, da sie von anderen Apps abhängig sind. Alle Entitäten können als Anbieter oder Verbraucher eines Dienstes fungieren – ob APIs, Menschen, IoT-Geräte oder Web-, Back-End- und Headless-Anwendungen. Aus ihrer eigenen Perspektive betrachtet sich jede Entität in der Infrastruktur als am Edge befindlich.
Die verteilte Cloud ist die jüngste Entwicklungsstufe des Rechenzentrums. Rechenleistung ist inzwischen allgegenwärtig – von Mobilgeräten bis hin zur Einbettung in vernetzte Alltagsgegenstände. Parallel dazu haben sich Softwarearchitekturen entwickelt, die verteilte und skalierbare Anwendungen ermöglichen.
Folgen von Edge Computing: Erhöhte Komplexität
Die allgegenwärtige Verfügbarkeit und hochgradig verteilte Bereitstellung von Rechen- und Speicherkapazitäten bietet Unternehmen die Chance auf eine schnelle digitale Transformation. Doch diese rasante Entwicklung hat auch ihre Folgen.
Die meisten Unternehmen verfügen in der Regel über eine heterogene Infrastruktur mit uneinheitlichen Umgebungen. Die effektive Skalierung solcher Umgebungen erfordert eine komplexe Orchestrierung und Automatisierung durch die eingesetzten Systeme. Schnelle Änderungen der Anwendungsanforderungen, etwa hinsichtlich der benötigten CPU-Leistung und Bandbreite, erhöhen die betriebliche Komplexität in einer verteilten Cloud. Dies belastet die Betriebsteams, die möglicherweise nicht ausreichend darauf vorbereitet sind, effizient auf die sich ändernden Anforderungen der Anwendung oder der Endkunden zu reagieren.
Die Folge dieser Probleme ist eine betriebliche Komplexität, die mögliche Vorteile der digitalen Transformation für ein Unternehmen zunichtemacht.
Im Folgenden werden einige der miteinander verknüpften Probleme und Begleiterscheinungen hervorgehoben, die sich aus dieser Komplexität ergeben.
“Die Vorteile der digitalen Transformation werden zunichtegemacht, wenn die Technologie im Betrieb komplex ist.”
Sicherheitsmodelle müssen ständig Schritt halten
Hybrid Clouds vergrößern die Angriffsfläche, die durch eine Vielzahl von Angriffsvektoren kompromittiert werden kann. Unterschiedliche Anwendungsfälle bringen vielfältige Sicherheitsherausforderungen mit sich, und während sich die Infrastruktur weiterentwickelt, versuchen wir ständig, mit dieser Entwicklung Schritt zu halten. Daher stellt sich für uns die Frage: Werden sich nur die Technologieempfehlungen häufig ändern oder auch die Entwurfsmuster für die Implementierung von Sicherheitsmaßnahmen?
Hier sind einige der Probleme bestehender Ansätze:
- Software Defined Perimeter (SDP) lässt sich nicht ohne Weiteres skalieren, da gängige Lösungen agentenbasiert sind, was eine einfache operative Bereitstellung erschwert.
- Die Implementierung von Zero Trust Network Access (ZTNA) ist häufig nicht praktikabel, da ZTNA-Lösungen eine Vielzahl bereitgestellter Produktivdienste wie Datenverkehrsprüfung, zentrale Protokollverwaltung, globale PKI und Identitätsverwaltung sowie weitere Dienste erfordern.
- Secure Access Service Edge (SASE) kombiniert Network-as-a-Service und Security-as-a-Service – ein schwer zu implementierendes Sammelsurium aus mehreren Technologien und Abkürzungen. Darüber hinaus liegt der Schwerpunkt von SASE meist auf softwaredefinierten Weitverkehrsnetzen (SD-WAN), sodass nur ein kleiner Teil der Anwendungsfälle am Netzwerkrand von Unternehmen abgedeckt wird.
- Unterschiede zwischen den Infrastrukturen verschiedener Public-Cloud-Anbieter und den ohnehin schon komplexen Sicherheitsmodellen, beispielsweise beim Identitäts- und Zugriffsmanagement (Identity and Access Management, IAM), führen häufig dazu, dass Teams die Anbieter mit uneinheitlichen Maßnahmen absichern und umständliche Multi-Cloud-Konfigurationen erstellen.
“Bei der Sicherheit läuft man dem Puck ständig hinterher.”
Herausforderungen bei der Automatisierung
Eine der größten Herausforderungen bei der hochgradigen Verteilung stromsparender und kostengünstiger Rechenressourcen am Edge besteht darin, die Infrastruktur einheitlich zu orchestrieren und zu planen. Betriebsteams haben Schwierigkeiten, Anwendungen, die die verteilte Cloud nutzen, zu skalieren und zu unterstützen, da diese Anwendungen in der Regel heterogene Technologien mit unterschiedlichen Verwaltungsanforderungen umfassen.
Automatisierungsplattformen wie Terraform bieten zwar ausgefeilte Möglichkeiten zur individuellen Anpassung der Automatisierung, doch Betriebsteams müssen weiterhin Skripte für zahlreiche Kombinationen pflegen: beispielsweise für fünf verschiedene Computing-Varianten, vier verschiedene Firewall-Typen und drei Arten von Load Balancern. Der personelle Aufwand für die Verwaltung und Pflege der Automatisierungsskripte lässt sich nicht skalieren.
Dies führt dazu, dass Infrastrukturkunden weiterhin über ticketbasierte Systeme mit den Betriebsteams interagieren müssen, was die Automatisierung bestehender Arbeitsabläufe erschwert. Der Service Desk wird mit Tickets überlastet und muss Sicherheit und Stabilität Vorrang vor Agilität einräumen.
API-Wildwuchs
Microservice-Architekturen haben sich mit der Entwicklung hin zu Multi-Cloud bereits als De-facto-Methode für die Erstellung neuer Anwendungen etabliert. APIs werden veröffentlicht und können jederzeit und überall nach Bedarf instanziiert werden, was zu einer unkontrollierten Ausbreitung von APIs führt. Die automatisierte Erkennung, Vernetzung und Verwaltung dieser APIs stellt eine große Herausforderung dar.
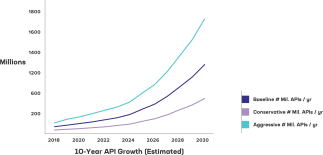
Zur Bewältigung der API-Ausbreitung ist ein Paradigmenwechsel erforderlich. Unsere internen Modelle zeigen, dass selbst moderate Annahmen zu Parametern wie der weltweiten Anzahl von API-Entwicklern, der Anzahl der pro Entwickler und Jahr entwickelten APIs und der Lebensdauer von APIs dazu führen, dass bis 2030 viele Hundert Millionen (wenn nicht Milliarden) APIs gleichzeitig aktiv sein werden (Abbildung 2). Der API-Sprawl-Bericht 2021 bietet einen umfassenden Überblick über dieses aufkommende Thema.
Mangelnde End-to-End-Transparenz des Systems
Die zunehmende Komplexität erfordert, dass Unternehmen eine detaillierte und aussagekräftige End-to-End-Transparenz über das gesamte System hinweg schaffen. In verteilten Cloud-Umgebungen erstrecken sich Anwendungen über mehrere heterogene Infrastruktur-Stacks, die von unterschiedlichen Einheiten verwaltet werden.
Darüber hinaus hat heute keiner der Betreiber einen Anreiz, Unternehmenskunden native Telemetriedaten seiner Infrastruktur zur Verfügung zu stellen. Unternehmen agieren bei der Bereitstellung von Anwendungen in einer verteilten Cloud daher im Wesentlichen im Blindflug und müssen auf mehrere Observability-Tools zurückgreifen. Um diese Transparenzlücken zu schließen, stammen die eingesetzten Tools in der Regel von verschiedenen Anbietern, die an unterschiedlichen Stellen der Infrastruktur oder der Anwendungs-Stacks ansetzen.
Nicht standardisierte Infrastrukturmetriken verschärfen die Probleme innerhalb eines Unternehmens zusätzlich. In der Regel sind die Metriken aufgrund betrieblicher Silos und anderer Faktoren wie uneinheitlicher Infrastrukturen in verschiedenen Infrastrukturumgebungen nicht vereinheitlicht. So unterscheiden sich beispielsweise die Metriken der verschiedenen Public-Cloud-Anbieter, und auch die Technologien in lokalen Rechenzentren folgen keinen einheitlichen Metrikstandards.
“Viele Unternehmen agieren aufgrund einer fehlenden „Observability-Praxis“ im Blindflug.”
Geschäftsergebnis: Beeinträchtigte Nutzererfahrung
Umsatzgenerierende Workloads und geschäftskritische Systeme beanspruchen in der Regel den Großteil der in einem Unternehmen verfügbaren Betriebsressourcen und Budgets. Kleinere Projekte sind zwar weniger komplex, machen jedoch meist den Großteil der Anwendungen eines Unternehmens aus. Abbildung 3 veranschaulicht dies als Long-Tail-Verteilung der Anzahl der Projekte, die ein Unternehmen im Verhältnis zu ihrer betrieblichen Komplexität voraussichtlich aufweist.
Auch wenn kleinere Anwendungen eine geringere betriebliche Komplexität aufweisen, werden die Prozesse und Workflows für ihre Überführung in den operativen Betrieb in vielen Fällen noch manuell durchgeführt. Daher kann es Wochen dauern, bis Service-Tickets mehrere Betriebsteams erfolgreich durchlaufen haben. So kann die Bereitstellung einer Anwendung, die dedizierte Netzwerkressourcen mit granularen Sicherheitsrichtlinien erfordert, zunächst voraussetzen, dass die globalen Sicherheitsteams die Genehmigung der Sicherheitsrichtlinien klären. Anschließend kann das Service-Ticket an das Netzwerkteam weitergeleitet werden, damit dieses die erforderlichen Subnetz- und Routingkonfigurationen plant. Abschließend müssen die Firewallregeln möglicherweise noch von einem weiteren Betriebsteam validiert werden, das für die Firewallverwaltung zuständig ist.
Stellen wir uns nun vor, dass die oben beschriebene Komplexität für jede Anwendung bewältigt werden muss, die in einer verteilten Cloud bereitgestellt wird, in der das Unternehmen keinen Teil der zugrunde liegenden Infrastruktur besitzt. Angesichts der schieren Menge an kleinen Projekten oder Anwendungen, die eingebunden und unterstützt werden müssen, ist es für Betriebsteams unrealistisch, jedes einzelne Projekt zu betreuen. Dadurch entsteht die Notwendigkeit einer Priorisierung und zugleich die Möglichkeit, Self-Service-Angebote bereitzustellen.
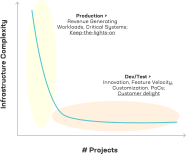
Dieses Priorisierungsproblem fällt besonders ins Gewicht, da sich die Investitionen der Infrastrukturteams auf die Unterstützung kritischer und umsatzgenerierender Systeme konzentrieren. Dadurch bleibt kaum Zeit oder Budget für völlig neue Projekte, die vor dem Produktivbetrieb einen eigenen Entwicklungs-, Test- und Staging-Lebenszyklus durchlaufen müssen. Dies führt zu geringeren Kapazitäten und Investitionen in eine schnellere Funktionsentwicklung, individuelle Anpassungen und Innovationen zur Unterstützung neuer Produkte, was letztlich zur Stagnation des Unternehmens und seines Angebots führt.
“Die Infrastrukturteams versinken in Komplexität.”
Lösungsraum für Edge-Technologien
Die Weiterentwicklung des Edge-Ökosystems erweitert den Lösungsraum erheblich, da sie die Möglichkeit bietet, diese Herausforderungen mithilfe einer Anwendungsplattform zu bewältigen.
Abbildung 4 zeigt den Lösungsraum von Edge 2.0. Dabei verstehen wir die Gesamtheit aller Komponenten, die unter eine verteilte Cloud-Architektur fallen, als den vollständigen Lösungsraum.
Daher muss Edge 2.0 im Kontext des Lösungsraums die von allen folgenden Gruppen gewünschte Nutzererfahrung bieten:
- Alle Entitäten, die zum Lösungsumfang gehören – Apps, Menschen und Geräte, die als Verbraucher fungieren, sowie Web-Backend- und Headless-Anwendungen, aus denen die Dienste bestehen.
- Die SRE-Teams und Anwendungsverantwortlichen dieser Apps unter Einhaltung der für die Infrastruktur vorgesehenen Sicherheitsvorkehrungen und regulatorischen Leitplanken.
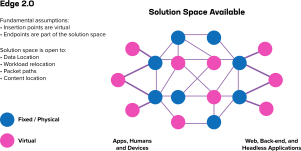
Edge 2.0 wird einfach zu betreiben, sicher und regelkonform sein und allen daran beteiligten Akteuren des Ökosystems ein hochwertiges Nutzungserlebnis bieten.
Designüberlegungen zu Edge 2.0
Standardmäßig sicher
Eine verteilte Cloud verschärft dieses Problem der Sicherheit im großen Maßstab, da die Anzahl der Endpunkte exponentiell zunimmt. Bei einer derart großen Skalierung steigt auch die Komplexität der Implementierung einer Lösung. Die Sicherheitsstrategie sollte darauf beruhen, dass die Anwendung davon ausgeht, dass die Umgebung, in der sie aktuell bereitgestellt ist, bereits kompromittiert wurde. Ebenso darf die Infrastruktur keiner Anwendung vertrauen, die auf ihr ausgeführt wird.
Die Grundlage dieser Ideen findet sich in den Konzepten des Zero-Trust-Ansatzes wieder. Das Beispiel BeyondCorp1 veranschaulicht diese Konzepte für den Anwendungsfall des Anwendungszugriffs. Edge 2.0 führt dieses Modell künftig auf der Grundlage der folgenden fünf Kernprinzipien weiter:
- Identität ist die Grundlage: In Edge 2.0 ist Identität tief verankert. Jede Entitätsinstanz verfügt über eine eigene, global eindeutige Identität sowie über eine Position in der Organisationshierarchie und eine entsprechende Berechtigungsstufe. Identität sollte nicht nur beim Nord-Süd-Datenverkehr, sondern auch intern beim Ost-West-Zugriff eine zentrale Rolle spielen.
- Prinzip der geringsten Rechte: Die für einen Akteur zulässigen Aktionen sollten auf diejenigen beschränkt werden, die er zur Erfüllung seiner Rolle im System benötigt. Ein Beispiel hierfür ist die Beschränkung der Workloads, die gemäß der Designspezifikation mit dem Datenbankserver kommunizieren dürfen.
- Kontinuierliche Authentifizierung: Jede Aussage eines Systemakteurs muss überprüfbar sein und sollte bei jeder solchen Aussage ausdrücklich verifiziert werden. Die Authentifizierung sollte nicht ausschließlich explizit anhand gemeinsam genutzter Geheimnisse oder einer Vertrauenskette erfolgen, sondern auch implizite Verhaltensmuster und kontextbezogene Metadaten berücksichtigen.
- Kontinuierliche Überwachung und Bewertung: Die Handlungen aller Akteure im System müssen überwacht werden, was die zentrale Rolle von Technologien zur Datenerfassung und -speicherung in einer Edge-2.0-Architektur unterstreicht. Darüber hinaus müssen diese Aktivitäten kontinuierlich bewertet werden, um Versuche, verbotene oder gefährliche Handlungen auszuführen, zu erkennen und einzudämmen. Die Bewertung muss nahezu in Echtzeit und in großem Maßstab erfolgen, was einen umfassenden Einsatz von Automatisierung und maschinellen Lernverfahren voraussetzt.
- Von einer Kompromittierung ausgehen: Angesichts der Ressourcen, die heutigen hoch entwickelten Angreifern zur Verfügung stehen, muss davon ausgegangen werden, dass jedes System in irgendeiner Weise kompromittiert wurde. Daher reichen vollständig deterministische Richtlinien, die auf Workload- und Benutzeridentitäten basieren und den durch a und b dargestellten privilegienbasierten Zugriff durchsetzen, häufig nicht aus, um alle Angriffe zu verhindern. Ein vollständig ausgereiftes Edge-2.0-System muss deshalb außerdem in der Lage sein, auf Grundlage kontinuierlicher Überwachung und Bewertung Risiko-Nutzen-Abwägungen in Echtzeit vorzunehmen.
“Gehen Sie stets davon aus, dass die Infrastruktur bereits kompromittiert ist. Die Herausforderung besteht dann darin, eine Anwendung sicher darauf bereitzustellen.”
Bietet native Observability
Edge 2.0 muss Telemetrie als integralen Bestandteil tief im Infrastruktur-Stack verankern, eine einfache und skalierbare Möglichkeit zur Erfassung schichtübergreifender Telemetriedaten innerhalb der Infrastruktur bereitstellen und diese auf einer gemeinsamen Plattform verfügbar machen. So können Observability-Teams den „Infrastrukturzustand“ bei Bedarf untersuchen. Anwendungsteams können sich dadurch auf die Geschäftslogik konzentrieren, ohne ihre Anwendungs-Stacks explizit instrumentieren zu müssen.
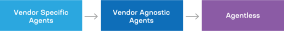
Der aktuelle Stand der Observability-Technologie ist weitgehend anbieterspezifisch und proprietär. Dies hat dazu geführt, dass zahlreiche anbieterspezifische Agenten ähnliche Signale erfassen und dabei um kostspielige Arbeitsspeicher- und CPU-Ressourcen konkurrieren.
Der nächste logische Schritt ist der Einsatz eines herstellerunabhängigen Telemetrie-Collectors, mit dem Infrastruktur- und Verkehrsdaten an eine zentrale Datenplattform gestreamt werden können.
Viele Produktteams tun sich schwer damit, Investitionen in die Instrumentierung zu rechtfertigen, da der Aufwand mit einer Umsatzchance verknüpft sein muss. Die Infrastruktur sollte wie jede andere Geschäftsfunktion oder jeder andere Geschäftsprozess instrumentiert werden, denn das Team muss ihr Verhalten verstehen, um sie im Hinblick auf die Unternehmensziele zu optimieren. Daher sollte sich die Diskussion weniger um die Notwendigkeit der Instrumentierung drehen, sondern vielmehr darum, was dabei priorisiert werden sollte.
Um detailliertere und genauere Messungen des Anwendungsverhaltens zu erzielen, gehen wir davon aus, dass die Instrumentierung „nach links verlagert“ wird, indem sie bereits bei der Programmierung eingesetzt wird – Abbildung 5.
“Die Instrumentierung muss nach links verlagert werden.”
Unterstützt adaptive Benutzeroberflächen
Im Sinne einer verteilten Cloud verfügt jede Cloud – wenn man einige Ebenen tiefer geht – innerhalb ihres Geltungsbereichs (lokal oder global) über einen eigenen Manager, Administrator, Orchestrator und weitere Komponenten. Jede agiert unabhängig und trifft ihre eigenen Entscheidungen, stellt anderen Entitäten jedoch bei Bedarf Schnittstellen zur Verfügung.
Somit bedeutet das Konzept einer verteilten Cloud im Wesentlichen eine dezentrale Verwaltung und Steuerung. An dieser Tatsache führt kein Weg vorbei, und es ist wichtig, dass wir sie anerkennen, um die feinen Unterschiede zwischen adaptiven, deklarativen und imperativen Schnittstellen besser zu verstehen.
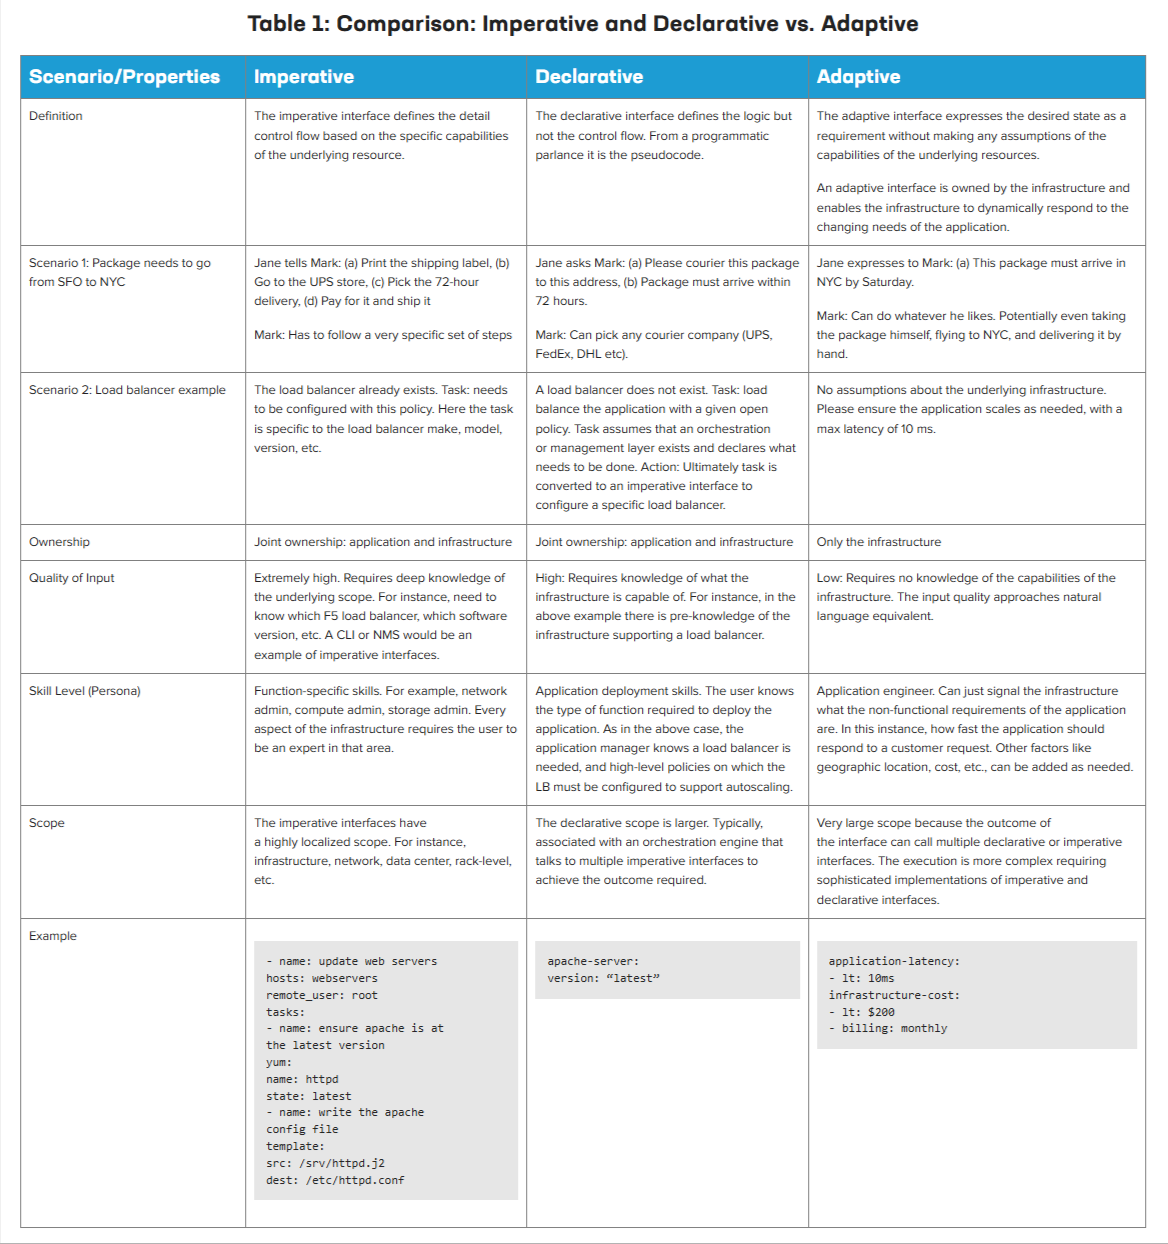
Um die Edge-2.0-Infrastruktur effektiv zu nutzen, reichen imperative und deklarative Schnittstellen nicht aus, da sie weiterhin auf manuell erstellten Artefakten basieren, die im Wesentlichen statische Konstrukte sind und sich nicht schnell genug an rasch verändernde Bedingungen anpassen.
Wir müssen zu einem ergebnisorientierten Ansatz übergehen. Dabei müssen die Systeme intelligent genug sein, um Richtlinien in der gesamten Infrastruktur (End-to-End) so anzupassen, dass die gewünschten Ergebnisse erreicht werden. Wir nennen dies adaptive Schnittstellen.
Um es klarzustellen: Imperative, deklarative und adaptive Schnittstellen schließen sich nicht gegenseitig aus:
Imperativ: Macht sehr genaue Vorgaben und definiert detailliert eine Reihe von Aktionen, mit denen der gewünschte Zustand erreicht werden soll. Die Konfiguration eines Routers ist beispielsweise eine imperative Aktion. Im obigen Szenario werden die vorgegebenen Aktionen präzise festgelegt – welches Rechenzentrum, wie viel CPU/Arbeitsspeicher, die erforderliche Bandbreite, bestimmte Routen und mehr. Die Eingabequalität des Datenmodells ist sehr hoch und erfordert daher fundiertere Kenntnisse und Fachwissen über die Infrastruktur. Es wird vorausgesetzt, dass sowohl das Modell als auch die Struktur der Infrastruktur bekannt sind.
Deklarativ: Die Besonderheit des deklarativen Ansatzes besteht darin, dass er sich auf die Beschreibung des gewünschten Zustands konzentriert und nicht auf die Maßnahmen, mit denen dieser Zustand erreicht wird. Die Anforderungen an die Eingabequalität sind geringer, dennoch muss die Anwendung zumindest die Struktur der zugrunde liegenden Infrastruktur kennen.
Adaptiv: Steht für sich und ist weder imperativ noch deklarativ. Eine adaptive Schnittstelle konzentriert sich auf das gewünschte Ergebnis oder Ziel und nicht auf den Zustand. Ihr Zweck besteht darin, das Ziel des Stakeholders zu erfassen, der die Anwendung bereitstellen möchte, anstatt Vorkenntnisse über das zugrunde liegende System vorauszusetzen. Der adaptive Ansatz unterscheidet sich dadurch, dass er keine Annahmen über die Fähigkeiten der zugrunde liegenden Infrastruktur trifft. Es gibt keine Vorgaben dafür, wie die Aufgabe zu erledigen ist; daher steht dieser Ansatz für sich.
Bei einem adaptiven Ansatz sind die Anforderungen an die Eingabe gering, und sie ähnelt natürlicher Sprache. Anwendungsverantwortliche können in einer Anfrage dem Infrastruktur-Controller mitteilen, welches Ergebnis sie erwarten, anstatt die erforderliche Funktion angeben oder eine Ressource gezielt konfigurieren zu müssen.
“Proklamation: Wir erklären, dass Edge 2.0 unbedingt adaptive Schnittstellen unterstützen muss.”
Löst das Inter-Cluster-Problem
Eine verteilte Cloud unterstützt per Definition alle Arten von Anwendungsarchitekturen: monolithische Architekturen, Microservices oder serverlose Architekturen. Unabhängig von der Architektur nutzen Anwendungen APIs, um ihre Dienste bereitzustellen.
Die Probleme bei der API-Erkennung, Konnektivität und Netzwerksicherheit werden durch den Einsatz eines Service Mesh weitgehend gelöst. Ein Service Mesh löst diese Probleme jedoch nur innerhalb des Clusters (clusterintern).
Edge-2.0-Anwendungen hingegen nutzen APIs über eine hyperverteilte Cloud-Infrastruktur hinweg, also im Wesentlichen in einer Multi-Cluster-Umgebung. Neue Anwendungen werden mit APIs entwickelt, die organisatorische und geografische Grenzen überschreiten. Bei einigen dieser APIs kann es sich um private APIs oder Partner-APIs handeln, die sich hinter mehreren Firewall-Ebenen befinden und zwischen denen keine explizite Route besteht, selbst wenn sie auffindbar sind. Für dieses Problem heterogener Cluster (clusterübergreifend) gibt es bislang keine elegante, schlanke, skalierbare, sichere und zugleich praktikable Lösung.
Wir haben APIs im Bericht „API Sprawl 2021“2 ausführlich behandelt und gehen darin auf viele Fragen ein, die sich möglicherweise stellen. Abbildung 6 zeigt den Unterschied zwischen Inter-Cluster- und Intra-Cluster-Kommunikation.
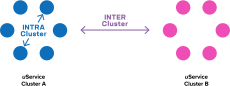
Cluster-intern: In einer monolithischen Architektur werden möglicherweise nur sehr wenige APIs bereitgestellt, während die interne Kommunikation zwischen den Modulen über andere Methoden der Interprozesskommunikation erfolgt. Eine Microservice-Architektur hingegen ist in Dutzende, wenn nicht Hunderte von APIs unterteilt.
Unabhängig davon wird jeder Anwendungscluster nach klar definierten Vorgaben entwickelt und verwaltet. Bei einer Microservice-Architektur könnte ein Team beispielsweise eine beliebige Service-Mesh-Lösung einsetzen – etwa Istio, Linkerd, Aspen Mesh oder eine andere. Jeder Ansatz verfügt über eigene Mechanismen zur Verwaltung und Steuerung der APIs innerhalb seines Clusters, also für die clusterinterne Kommunikation.
Hierfür gibt es viele Lösungen, und das Ziel von Edge 2.0 besteht nicht darin, das Rad neu zu erfinden oder Unternehmen beziehungsweise Entwicklungsteams zur Einführung einer weiteren neuen Technologie zu zwingen.
Clusterübergreifend: Mit der zunehmenden Anzahl von Diensten, die über APIs bereitgestellt werden, entstehen neue Anwendungen auf Basis von Diensten, die bereits von verschiedenen Anwendungsteams im Unternehmen entwickelt oder eingeführt wurden, da das Rad nicht neu erfunden werden muss.
Neue Anwendungen werden auch durch unterschiedliche Kombinationen aus öffentlichen und privaten APIs erstellt. Aus architektonischer Sicht nutzen moderne Anwendungen Dienste, die von anderen Clustern bereitgestellt werden. In einer verteilten Cloud werden diese Cluster weltweit bereitgestellt und können sich daher an jedem Standort befinden, der die Anwendung hosten kann oder Teil des Anwendungsclusters ist.
Umfang eines Anwendungsclusters
Noch einmal zur Verdeutlichung: Der Geltungsbereich eines Anwendungsclusters ist nicht auf eine einzelne Organisation beschränkt. Cluster können sich über zwei beliebige Netzwerke, Anwendungen oder Organisationssilos hinweg oder sogar zwischen zwei Unternehmen erstrecken.
Der Umfang deckt das gesamte Spektrum aller Permutationen und Kombinationen ab, wodurch die Komplexität des Betriebs exponentiell zunimmt. Abbildung 7 zeigt die möglichen Varianten des Datenverkehrs innerhalb des Anwendungsbereitstellungsbereichs.
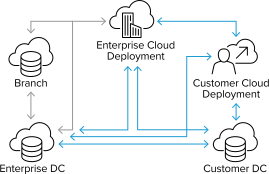
Ein typisches Unternehmen verfügt über unterschiedliche Anwendungsarchitekturen. Je nachdem, welches Team eine Anwendung entwickelt und bereitstellt, können verschiedene Varianten eines Service Mesh, eine auf einer serviceorientierten Architektur basierende Web-2.0-Anwendung oder eine monolithische Softwarebereitstellung zum Einsatz kommen. APIs sind daher über das gesamte Unternehmen verteilt – seien es private APIs oder die Nutzung öffentlicher APIs. Dieses Problem ist noch nicht gelöst. Die API-Kommunikation zwischen mehreren Standorten ist von entscheidender Bedeutung und stellt für Unternehmen jeder Größe ein Problem dar, für das es bislang keine leicht greifbare Lösung gibt.
Es gibt verschiedene Lösungen für die Verwaltung von APIs innerhalb eines Clusters (zum Beispiel Ingress-Controller, API-Gateways und weitere), während es für die API-Kommunikation zwischen Clustern noch keine praktikable, skalierbare und sichere Lösung gibt. Daher beschränken wir den Umfang der einheitlichen API-Steuerung und -Verwaltung auf clusterübergreifende Aspekte.
Ermöglicht Autonomie
Ein unterschätzter Vorteil der Cloud ist die Autonomie, die sie dem „Cloud-Nutzer“ bietet. Unternehmen und Unternehmer können bei Bedarf ihre eigenen Infrastrukturen bereitstellen und dabei ein Gefühl nahezu vollständiger Kontrolle genießen.
Das grundlegende Designprinzip, dem eine Edge-2.0-Plattform folgen muss, besteht darin, Cloud-Kunden ein autonomes Nutzungserlebnis zu bieten und gleichzeitig die richtigen Leitplanken zu implementieren. Da die Entitäten in jeder beliebigen Infrastruktur (vertrauenswürdig oder nicht vertrauenswürdig) auftreten können, müssen die Leitplanken so implementiert werden, dass sie weder den Geschäftsbereich noch das für die Entwicklung der Anwendung zuständige DevOps-Team belasten.
Zusammenfassung der Grundsätze
Die neue Herausforderung bei Edge 2.0 wird in der Erkennung, Identität, Vertrauenswürdigkeit und Beobachtbarkeit verschiedener Dienste untereinander liegen.
Selbst in mittelständischen Unternehmen ist die Zahl der jährlich entwickelten APIs groß. Wie finden Teams diese Dienste innerhalb des Unternehmens? Und wie können sie feststellen, ob die Dienste noch gültig sind und wem sie gehören? Können sie sicher sein, dass es sich um einen validierten, vertrauenswürdigen Dienst handelt? Das Problem verschärft sich, wenn Teams Dienste nutzen möchten, die von Clustern außerhalb der Unternehmensgrenzen bereitgestellt werden, beispielsweise von SaaS-Anbietern oder Anwendungen, die auf Edge-Geräten ausgeführt werden und sich der administrativen Kontrolle der Infrastrukturteams des Unternehmens vollständig entziehen.
Edge-2.0-Anwendungsplattform
Angesichts der in den vorherigen Abschnitten beschriebenen Herausforderungen müssen wir die gesamte verteilte Cloud als Plattform betrachten. Auf übergeordneter Ebene formulieren wir das Ziel der Lösung: verteilte Anwendungen in einer dezentralen Infrastruktur autonom (ohne menschliches Eingreifen) zu erkennen, zu skalieren und abzusichern.
Im Wesentlichen lässt sich die Aufgabe der Edge 2.0 Application Platform (EAP) wie folgt beschreiben:
- API-Erkennung, Identität und Vertrauen
- Infrastrukturplanung und -orchestrierung
- Sichere Anwendungskonnektivität
“Verteilte Anwendungen in dezentralen Infrastrukturen autonom erkennen, skalieren und absichern.”
EAP-Umfang
Die Infrastruktur umfasst den gesamten Lösungsraum, in dem Infrastrukturelemente fortlaufend hinzukommen und wieder verschwinden können. Das Eigentum an der Infrastruktur und ihren Ressourcen einerseits sowie die Verwaltung und Kontrolle dieser Ressourcen andererseits sind zwei voneinander getrennte Konzepte. Ein Infrastruktureigentümer kann eine bestimmte Infrastruktur oder eine Instanz davon einer anderen Organisation zuweisen, die sie verwaltet und konfiguriert, oder bei Bedarf die Kontrolle wieder übernehmen. Die Organisation, die die Elemente verwaltet und konfiguriert, kann sie wiederum einzelnen Projekten oder Anwendungen zuweisen. Dieses Konzept ist nicht neu: Cloud-Service-Anbieter bieten beispielsweise eine hierarchische administrative Kontrolle, die von den IT-Teams eines Unternehmens genutzt werden kann, um internen Geschäftsbereichen, Teams usw. Infrastructure-as-a-Service (IaaS) bereitzustellen. Die zentrale Herausforderung für Edge 2.0 besteht darin, dies in großem Umfang in einer hyperverteilten Cloud umzusetzen, die den gegenwärtigen und zukünftigen Zustand der Edge-Infrastruktur darstellt.
An dieser Stelle wird der Geltungsbereich der EAP deutlich. Abbildung 8 unten zeigt den Geltungsbereich der EAP im Kontext verschiedener Arten von Schnittstellen. Jede EAP orchestriert innerhalb ihres lokalen Geltungsbereichs mithilfe deklarativer und imperativer Schnittstellen. In diesem Fall:
- Deklarative bzw. imperative Schnittstellen wären beispielsweise die AWS-APIs, Azure-APIs usw.
- Adaptive Schnittstellen wären völlig neu und müssten von Fall zu Fall definiert werden.
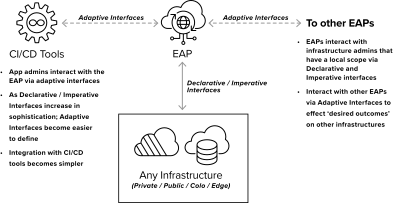
Um die Vorteile der verteilten Cloud zu nutzen, sollte die EAP in der Lage sein, alle über eine verteilte Cloud verfügbaren Knoten und Entitäten einzubeziehen. Die Vision besteht darin, dass die einzelne EAP für die Anwendungsschicht zum Äquivalent des Konzepts des autonomen Systems3 in IP-Netzwerken wird.
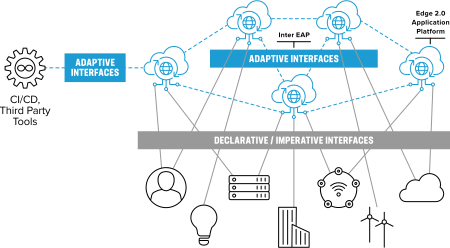
Wenn wir all dies zusammenführen (siehe Abbildung 9 unten), können wir nun auf übergeordneter Ebene darstellen, wie mehrere EAPs in einer dezentralen Cloud-Infrastruktur bereitgestellt werden und autonom miteinander interagieren können.
Adaptive Schnittstellen erleichtern zudem die Integration von CI/CD- und anderen Anwendungen für den Anwendungslebenszyklus in die verteilte Cloud. CI/CD-Plattformen können über einfache adaptive Schnittstellen, die lediglich das gewünschte Ergebnis angeben, direkt mit dem EAP interagieren.
Es ist wichtig zu beachten, dass die Kommunikation zwischen EAPs auch über adaptive Schnittstellen erfolgen kann.
Das EAP-Framework
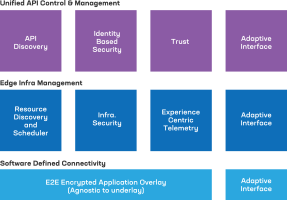
Das EAP-Framework organisiert, wie in Abbildung 10 dargestellt, die Verantwortlichkeiten anhand der Fähigkeiten der einzelnen EAP-Instanzen. Die Aufgabe des EAP besteht darin, eine Schnittstelle zu den Controllern der zugrunde liegenden Infrastruktur bereitzustellen – unabhängig davon, ob es sich um Infrastructure as a Service (IaaS), Platform as a Service (PaaS) oder Software as a Service (SaaS) handelt – und bei Bedarf geeignete Ressourcen zu orchestrieren und einzuplanen.
Einheitliche API-Steuerung und -Verwaltung
Die Zukunft wird von einer API-getriebenen Wirtschaft geprägt sein, in der APIs mehr sind als nur ein durch Service Mesh vereinfachter Ansatz für die Softwarearchitektur. Eine API wird zum wichtigsten Mittel, über das jede an einer verteilten Cloud beteiligte Einheit ihren Dienst bereitstellt.
Wie bereits dargelegt, wird die Zahl der weltweit verfügbaren öffentlichen und privaten APIs innerhalb dieses Jahrzehnts in die Hunderte Millionen, wenn nicht sogar in die Milliarden gehen. APIs werden unsere Wirtschaft grundlegend verändern. Daher müssen wir genauer untersuchen, welche Funktionen die EAP bereitstellen muss, um diese Wirtschaft zu unterstützen.
API-Erkennung
Die drohende Ausbreitung von APIs erfordert, dass jede API innerhalb und außerhalb der EAP auffindbar ist. In einer verteilten Cloud können sich die APIs an beliebigen Orten über mehrere Cluster hinweg befinden.
Die zugrunde liegende Annahme ist, dass die API-Erkennung tatsächlich ein clusterübergreifendes Problem darstellt. Der Geltungsbereich einer EAP kann sich über zahlreiche Anwendungscluster erstrecken, die unterschiedliche Softwareansätze verfolgen (von Microservices bis hin zu monolithischen Architekturen) und jeweils eine eigene API-Gateway-Strategie implementieren. Eine EAP stellt ein gemeinsames Repository bereit, in dem alle APIs registriert werden und innerhalb ihres Geltungsbereichs auffindbar sind – nicht nur innerhalb eines Clusters. Diese Unterscheidung ist entscheidend, um die Grenzen bestehender API-Gateway-Strategien, beispielsweise in einem Service Mesh, aufzuzeigen.
Die Herausforderung für die EAP besteht darin, die Auffindbarkeit einer API zu ermöglichen, die richtige Dokumentation für ihre Nutzung bereitzustellen und den Lebenszyklus der API im Hinblick auf Konsistenz, Genauigkeit und Versionierung zu verwalten. Die EAP stellt eine Möglichkeit bereit, Entitäten, die ihre APIs nutzen, über den aktuellen Status bestimmter verwendeter APIs zu informieren. Dies kann einfach durch das Festlegen von Ablaufdaten oder durch eine ausdrückliche Benachrichtigung über ein Nachrichtensystem erfolgen.
Identitätsbasierte Sicherheit
Bei diesem Sicherheitsansatz geht eine Anwendung davon aus, dass die Infrastruktur, in der sie derzeit bereitgestellt ist, bereits kompromittiert wurde.
Der zentrale Pfeiler bei der Umsetzung dieses Sicherheitskonzepts ist die Identität. Jeder API-Endpunkt muss über eine global eindeutige Identität verfügen. Sicherheitsrichtlinien und Kontrollmechanismen werden separat in einem zentralen Repository verwaltet.
APIs müssen als öffentlich oder privat gekennzeichnet werden, damit die zugrunde liegenden Sicherheitskomponenten der Infrastruktur automatisch für die jeweilige API konfiguriert werden.
Für die gesamte Kommunikation zwischen Anwendungen gilt zunächst eine „Deny-all“-Richtlinie. Nur weil eine API sichtbar ist, bedeutet das nicht, dass eine andere Anwendung sie aufrufen kann. Dies muss ausdrücklich in der Sicherheitsrichtlinie der Anwendung konfiguriert werden.
“Auch Vertrauen ist nicht von Dauer und muss regelmäßig überprüft werden.”
Vertrauen: Reputation im Laufe der Zeit
Die EAP muss sicherstellen, dass alle APIs in ihrem Zuständigkeitsbereich vertrauenswürdig sind und zugleich auch allen externen APIs vertraut werden kann, die von Diensten in ihrem Zuständigkeitsbereich verwendet werden.
„Vertrauen lässt sich nicht beweisen – genau das macht es zu ‚Vertrauen‘.“ – Aus Traitors auf Netflix
Vertrauen ist im Wesentlichen „Reputation im Laufe der Zeit“, und dieses Vertrauen muss kontinuierlich neu validiert werden, um sicherzustellen, dass es nicht unter ein akzeptables Niveau gesunken ist. Dieser Ansatz findet bei der Modellierung und Implementierung von Vertrauen in Systemen zunehmend Verbreitung und erfordert, dass Vertrauen kontinuierlich bewertet wird, anstatt es lediglich bei der erstmaligen Ausführung statisch festzustellen.
Die Tatsache, dass sich Vertrauen im Laufe der Zeit verändern kann, stellt möglicherweise eine Herausforderung für Unternehmen dar, denen die Zeit fehlt, eine wechselseitige Vertrauensbasis zwischen den eigenen Systemen und denen von Drittanbietern aufzubauen. Sowohl Infrastrukturen als auch APIs können verheerende Folgen haben, wenn ihre Vertrauenswürdigkeit nicht genau überwacht wird.
Wenn ein Dienst innerhalb des EAP-Geltungsbereichs auf eine externe API zugreift, muss die Plattform einen Mechanismus implementieren, mit dem der aufrufende Dienst die Richtigkeit der von der externen API empfangenen Antwort überprüfen kann. Nur weil die API-Antwort gültig erscheint, bedeutet das nicht, dass sie vertrauenswürdig ist. Die Antwort könnte aufgrund von Qualitätsproblemen fehlerhaft sein, oder es könnten gezielt Ungenauigkeiten eingefügt worden sein, um die Wettbewerbsfähigkeit des Unternehmens zu beeinträchtigen. Die Möglichkeit, jeder internen oder externen API einen Vertrauensfaktor zuzuweisen, ist ein Alleinstellungsmerkmal des EAP-Konzepts.
Eine Strategie zur Implementierung von Vertrauen besteht darin, den Durchschnittswert für einen aktuellen „Zeitraum“ zu bilden, anstatt die gesamte Historie des Dienstes heranzuziehen. Das ist vergleichbar mit der Gegenüberstellung von „Top-Rezensionen“ und „Neueste“ bei einem Produkt auf Amazon. Das Produkt mag durchaus vier Sterne haben, doch wenn die meisten negativen Bewertungen aus den vergangenen sechs Monaten stammen, deutet dies auf einen kürzlich eingetretenen Vertrauensverlust hin. Eine Häufung positiver Kommentare in den vergangenen sechs Monaten würde hingegen darauf hindeuten, dass das Problem behoben oder das Vertrauen wiederhergestellt wurde.
Der Vertrauensfaktor beschränkt sich nicht nur darauf, ob eine API als Quelle falscher oder irreführender Daten bekannt ist. Der Ruf eines EAP hängt auch davon ab, wie gut es die in seinen Zuständigkeitsbereich fallenden APIs verwaltet und aktualisiert. Darüber hinaus ist „Vertrauen“ relativ. Dienst A kann Dienst C vertrauen, während Dienst B möglicherweise andere Erfahrungen mit Dienst C gemacht hat.
Edge-Infrastrukturmanager
Da eine verteilte Cloud die Grundlage der Edge-2.0-Infrastruktur bildet, müssen die Ressourcen im Geltungsbereich einer EAP leicht auffindbar, abgesichert und mit Instrumentierungsfunktionen ausgestattet sein. Die folgenden Punkte sind als Empfehlungen für die erforderlichen Funktionen des Edge Infrastructure Managers zu verstehen.
Erkennung und Planung
Innerhalb eines EAP können Ressourcen nach Bedarf eingeplant werden. Aufgrund von Mobilität können neue Ressourcen dynamisch hinzukommen oder vorhandene Ressourcen wegfallen. Ein EAP kann außerdem Anfragen an andere EAPs senden oder von ihnen empfangen, damit diese in seinem Auftrag Ressourcen nach Bedarf ermitteln und einplanen.
Sicherheit
Um die Sicherheitslage noch einmal zu verdeutlichen: Die Infrastruktur, auf der die Anwendung bereitgestellt wird, ist bereits kompromittiert. Die EAP muss daher die Sicherheit der in ihrem Geltungsbereich bereitgestellten Anwendung gewährleisten.
Unabhängig von der Verwaltungsebene muss das EAP-Framework verschiedene Sicherheitsaspekte berücksichtigen, darunter unter anderem:
Externe Bedrohungen: Zum Beispiel Distributed-Denial-of-Service-Angriffe (DDoS) und Advanced Persistent Threats (APT). Diese können mithilfe bewährter Sicherheitsmaßnahmen wie DDoS-Schutz, Firewalls und weiteren Maßnahmen eingedämmt werden. Es wird empfohlen, diese Maßnahmen für den gesamten Datenverkehr verbindlich vorzuschreiben.
Man-in-the-Middle: Der gesamte Datenverkehr muss verschlüsselt werden, und es darf nicht davon ausgegangen werden, dass die Anwendungsschicht die richtigen Maßnahmen ergreift. Dies gewährleistet die grundlegende Vertraulichkeit der Daten gegenüber Geräten, die den Datenverkehr ausspähen, und schützt die Integrität der Daten vor Manipulationen während der Übertragung.
Interne Bedrohungen: Der Umfang der Infrastrukturebene muss begrenzt und in erster Linie auf ihren eigenen Schutz ausgerichtet sein. Es wird empfohlen, zu verhindern, dass eine Ressource innerhalb der Infrastruktur einen internen Angriff auf den Infrastrukturmanager startet.
Erlebniszentrierte Telemetrie
Wenn es bei Edge 2.0 um das bereitgestellte Erlebnis und nicht um das Asset oder dessen Standort geht, folgt daraus logischerweise, dass auch die Telemetrie erlebnisorientiert sein muss.
Die Frage ist: Wessen Erfahrung ist gemeint? Es geht um die Erfahrung jeder Entität, die sich in einer Infrastruktur befindet oder diese nutzt, um einen Dienst bereitzustellen oder in Anspruch zu nehmen – etwa Anwendungen, Geräte, Menschen, Backend-Anwendungen, Datenbanken und mehr. Die Erfahrung wird somit aus der Perspektive der jeweiligen Entität betrachtet. Ein Dienst, den eine Entität bereitstellt oder in Anspruch nimmt, steht in direktem Zusammenhang mit den ihr zugewiesenen Rechen-, Speicher- und Netzwerkressourcen.
Doch es reicht nicht aus, die Erfahrung lediglich zu messen; es muss auch eine Möglichkeit geben, sie zu verbessern.
Jede Entität, die einen Dienst nutzt oder bereitstellt, kann feststellen, ob sie die gewünschte Nutzererfahrung erhält. In verteilten Cloud-Umgebungen kann es jedoch nahezu unmöglich sein, nachzuvollziehen, welche Vorgänge auf der Infrastrukturebene zu der unzureichenden Nutzererfahrung geführt haben.
Übergeordnete Metriken wie CPU-Auslastung, Arbeitsspeicher, Bandbreite und Latenzmessungen reichen nicht aus, um festzustellen, warum eine Anwendung nicht die gewünschte3 Leistung erhält. Metriken müssen zeitlich hochauflösend sein und tief im Anwendungs-Stack sowie, sofern verfügbar, auf verschiedenen Ebenen des Infrastruktur-Stacks erfasst werden.
Eine robuste, skalierbare und erweiterbare Telemetrie- und Datenstrategie ist für die EAP von entscheidender Bedeutung. Strategien für maschinelles Lernen (ML) und künstliche Intelligenz (KI) können anschließend genutzt werden, um die bestmögliche Entscheidung über die Reservierung neuer Ressourcen oder die Optimierung der Nutzung vorhandener Ressourcen zu treffen.
“Ozean-Analogie: Underlay-Netzwerke möchten wie der Meeresgrund sein – ruhig, friedlich und im Laufe der Zeit nahezu unveränderlich, aber dennoch eine dunkle Umgebung, in der hoher Druck herrscht. Ein Underlay-Netzwerk, das versucht, auf jede Anforderung jeder Anwendung zu reagieren, bringt lediglich turbulente Strömungen und Wirbel von der Oberfläche bis hinunter auf den Meeresgrund.”
Softwaredefinierte Anwendungskonnektivität
Obwohl Konnektivität und Erreichbarkeit als gelöste Probleme gelten, fällt es vielen Netzwerkteams nach wie vor schwer, ihre Netzwerkstruktur mit den dynamischen Anforderungen der Anwendungsebene in Einklang zu bringen. Eine Plattform muss auch diese Herausforderungen bewältigen.
Plädoyer für die Trennung der Anwendungskonnektivitätsebene
Das Problem bei bestehenden Ansätzen besteht darin, dass wir die Konnektivitätsanforderungen von Anwendungen auf die WAN-Konnektivität des Unternehmens übertragen, insbesondere in einer verteilten Cloud. Zur Umsetzung eines verteilten Cloud-Netzwerks können verschiedene SDN-Strategien oder rein routingbasierte Methoden zum Einsatz kommen. Diese Lösungen sind jedoch stark auf eine homogene Infrastruktur angewiesen und können daher kein konsistentes Verhalten gewährleisten.
Die einzige Möglichkeit, ein global skalierbares, sicheres und stabiles Netzwerk für die Anwendung zu schaffen, besteht darin, die Konnektivitätsebene der Anwendung vom zugrunde liegenden Netzwerk zu trennen, wie im Folgenden erläutert.
Vorgeschlagener Konnektivitäts-Stack
Im Zuge der Entwicklung hin zu einer verteilten Cloud-Architektur zeichnet sich bei SDN der Ansatz ab, sowohl die Underlay- als auch die Overlay-Netzwerke gemeinsam zu orchestrieren und eine durchgängige Programmierbarkeit des Anwendungspfads zu ermöglichen.
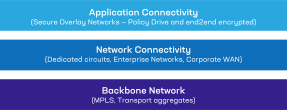
Mit Edge 2.0 müssen wir auch bei der Anbindung von Unternehmensnetzwerken ein gewisses Maß an Stabilität gewährleisten. Wir schlagen vor, die Konnektivitätsebene der Anwendungen von der Konnektivität des Unternehmensnetzwerks zu trennen. Das Konnektivitätsmuster der Anwendungen kann sich an derselben SDN-Konnektivität orientieren, wie sie bei Rechenzentrums-Overlays (z. B. VXLAN, NVGRE oder anderen) oder BGP-basierten SDN-Mustern zum Einsatz kommt, muss dies aber nicht.
Nicht alle Netzwerke wurden in Overlay und Underlay getrennt. Netzwerkteams erkennen inzwischen, dass diese gemeinsame Programmierbarkeit eine wichtige Voraussetzung für eine durchgängige Automatisierung ist, für die die Trennung von Underlay- und Overlay-Netzwerk entscheidend ist.
Durch die Trennung der Anwendungsebene vom Underlay-Netzwerk und der Transportschicht müssen die Netzwerkteams nicht mehr aktiv auf jede Anwendungsanforderung reagieren. Ihr Aufgabenbereich beschränkt sich damit auf die Bereitstellung robuster, stabiler und klar definierter Pfade, wobei der Schwerpunkt auf der Optimierung der Nutzung der Gesamtbandbreite bei möglichst niedrigen Latenzen liegt.
Adaptives Schnittstellenmodell
Der zentrale Grundsatz eines EAP besteht darin, dass es unabhängig und autonom ist und einen Teilbereich des gesamten Lösungsraums verwaltet. EAPs benötigen jedoch eine Möglichkeit, miteinander zu kommunizieren, ihre Ressourcen anzubieten oder Ressourcen von anderen EAPs anzufordern. Dieser Ansatz bietet mehrere Vorteile.
Vereinfachte Schnittstelle
Eine ergebnisorientierte Schnittstelle macht es überflüssig, dass der EAP die Details der anderen Infrastruktur kennt. Angenommen, es gibt zwei EAPs: A und B. Jeder EAP verfügt über einen lokalen Zuständigkeitsbereich innerhalb seiner Infrastruktur, um Ressourcen einzuplanen und zu reservieren. EAP-A muss die von EAP-B bereitgestellten Ressourcen nicht kennen. Wenn EAP-A beispielsweise die Anforderungen der Anwendung nicht erfüllen kann und Ressourcen aus der Infrastruktur benötigt, die in den Zuständigkeitsbereich von EAP-B fallen, kann er EAP-B einfach das gewünschte Ziel mitteilen. EAP-B ist dann dafür verantwortlich, deklarative oder imperative Schnittstellen aufzurufen, um Ressourcen aus seinem Pool freier Ressourcen zu reservieren, zuzuweisen und zu konfigurieren. EAP-B ist außerdem dafür verantwortlich, sicherzustellen, dass die SLOs für diesen Dienst innerhalb seiner Infrastruktur eingehalten werden.
Eine gemeinsame Syntax ist zwar hilfreich, um einen ersten Satz adaptiver APIs bereitzustellen, doch durch den Einsatz natürlicher Sprachverarbeitung und KI wird die Implementierung im Laufe der Zeit immer ausgefeilter und ausgereifter, sodass geringere Anforderungen an die Qualität der Eingaben gestellt werden können.
EAP-Funktionen
- Mandantenfähig: Das in Abbildung 9 dargestellte EAP-Netz ist zwar für eine einzelne Bereitstellung vorgesehen, es sind jedoch mehrere EAPs pro Cloud möglich. Eine andere Anwendung könnte mit einem anderen EAP oder einem EAP-Netz kommunizieren.
- Auf Skalierbarkeit ausgelegt: Jedes Mesh ist ein Peer-to-Peer-Mesh (P2P) und lässt sich horizontal skalieren. Gleichrangige EAPs können unabhängig nachverfolgen, welche EAPs über welche Ressourcentypen verfügen und wie eine Verbindung zu der jeweiligen Ressource hergestellt werden kann. KI/ML wird künftig weiter optimieren, wie jeder EAP Ressourcen innerhalb seines eigenen Zuständigkeitsbereichs einplant oder bei Bedarf auf andere EAPs zugreift.
- Integrierte Netzwerkfunktionen: Damit Anwendungen über die verteilte Cloud hinweg miteinander kommunizieren können, muss der EAP integrierte Netzwerkfunktionen unterstützen, die unabhängig von der zugrunde liegenden Infrastruktur sind.
Alles zusammenführen
Abbildung 12 veranschaulicht die Rolle der verschiedenen Schichten bei der Bereitstellung einer Anwendung in einer verteilten Cloud.
Die wichtigsten Aspekte dieser Darstellung sind:
- Jeder EAP hat einen lokal begrenzten Geltungsbereich, und nicht alle seine Funktionen sind in Abbildung 10 dargestellt. Der EAP muss die Ressourcenerkennung und die Scheduler-Funktion unterstützen. EAPs planen Ressourcen, indem sie über adaptive APIs mit dem entsprechenden Infrastruktur-Controller kommunizieren.
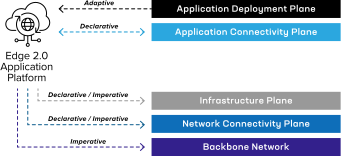
- Anwendungskonnektivität ist nicht dasselbe wie Netzwerkkonnektivität. Ähnlich wie beim Sidecar-Modell eines Service Mesh müssen die Ressourcen zur Verbindung von Anwendungen über mehrere Clouds hinweg Teil der Anwendungsinfrastruktur sein. Man könnte argumentieren, dass die Infrastrukturebene ebenfalls Netzwerkkonnektivität für Anwendungen bereitstellt und daher unterhalb der Netzwerkebene angesiedelt sein sollte. Das wäre technisch ebenfalls korrekt, wir haben uns jedoch dafür entschieden, sie der Ebene „Anwendungskonnektivität“ zuzuordnen, da es sich dabei in erster Linie um Netzwerkfunktionen handelt.
- Die Infrastrukturebene muss als von der Anwendungsebene getrennt betrachtet werden.
- Die Netzwerkkonnektivität unterscheidet sich vom Transport, da es sich im Wesentlichen um bestimmte routingfähige Netzwerke handelt, die von der Anwendungskonnektivität getrennt sind.
- Die Transportebene kann als Verbund von Backbone-Netzen betrachtet werden, die bereitgestellt werden können, sofern der Telekommunikationsanbieter Prozesse und APIs für die Anbindung der darüberliegenden Netzwerkschicht ermöglicht.
Zusammenfassung
Dieses Whitepaper vertieft einige Aspekte des ursprünglichen Edge-2.0-Manifests. Wir haben einige neue Themen aufgenommen, um verschiedene Interessengruppen innerhalb von Organisationen sowie externe Akteure der Branche zu informieren.
Edge 2.0 basiert auf dem Konzept einer verteilten Cloud, in der jede Einheit sowohl als Quelle als auch als Ziel von Diensten fungieren kann. Im Mittelpunkt von Edge 2.0 steht das Erlebnis und nicht die Ressource oder der Standort.
Die Edge Application Platform (EAP) wird als Technologie-Stack eingeführt, der die Umsetzung von Edge 2.0 über eine verteilte Cloud ermöglicht.
Auf Implementierungsdetails wurde bewusst verzichtet, um eine herstellerunabhängige Sichtweise zu vermitteln.