
Cet article est le deuxième d’une série consacrée aux différents aspects de la création et de l’exploitation de notre service SaaS :
- Plan de contrôle pour une PaaS Kubernetes distribuée
- Maillage de services global pour les applications distribuées
- Sécurité de la plateforme pour les infrastructures, les applications et les données distribuées
- Sécurité des applications et du réseau des clusters distribués
- Observabilité sur l’ensemble d’une plateforme distribuée à l’échelle mondiale
- Opérations et SRE d’une plateforme distribuée à l’échelle mondiale
- Framework de services en Go pour les microservices distribués
Dans un précédent article de blog, nous avions expliqué le contexte et les besoins qui nous ont conduits à créer une nouvelle plateforme. Grâce à cette plateforme, nos clients peuvent développer un ensemble complexe et varié d’applications, telles que la fabrication intelligente, l’analyse vidéo à des fins de sécurité publique, le trading algorithmique et les réseaux 5G des opérateurs télécoms.
Le premier article de blog de cette série présentait un plan de contrôle distribué permettant de déployer plusieurs clusters d’applications Kubernetes mutualisés dans le cloud public, les points de présence de notre réseau privé et les sites en périphérie.
Cet article aborde les défis liés à la connexion et à la sécurisation de ces clusters d’applications distribués sous trois angles : d’application à application, d’un utilisateur ou d’une machine à une application, et d’une application à l’Internet public. Nous présenterons un tout nouveau chemin de données L3-L7+ entièrement intégré, un plan de contrôle distribué à l’échelle mondiale et notre réseau mondial haute performance. Ces trois éléments se combinent pour fournir un ensemble complet de services réseau et de sécurité en périphérie, au sein de n’importe quel VPC cloud ou dans les PoP de notre réseau mondial. Après plus d’un an d’exploitation en production auprès de plus de 35 clients, nous avons commencé à déployer cette solution à plus grande échelle et estimé que le moment était venu de partager notre parcours.
TL;DR (Résumé)
- Pour fournir une connectivité performante, fiable et sécurisée aux clusters d’applications distribués, nous avons dû construire un nouveau réseau mondial. S’il existe de nombreux fournisseurs de services permettant de connecter les utilisateurs aux applications et de sécuriser ces connexions (Akamai, Cloudflare, etc.), ainsi que de connecter les employés aux applications (par exemple, Zscaler, Netskope, etc.), aucun fournisseur ne répond aux besoins de connectivité et de sécurité entre applications.
- Outre un réseau mondial permettant de connecter les applications distribuées, ces clusters d’applications nécessitent des services de mise en réseau, de fiabilité et de sécurité — routage des API, équilibrage de charge, sécurité et routage réseau — reposant sur un modèle de configuration et d’exploitation cohérent. Ces services doivent pouvoir s’exécuter dans plusieurs régions de fournisseurs cloud, sur des sites périphériques aux ressources limitées et/ou sur notre réseau mondial.
- Pour fournir ces services de réseau et de sécurité, nous avons décidé de créer un nouveau plan de données réseau L3-L7+ entièrement intégré, offrant une configuration, des politiques et une observabilité cohérentes, quel que soit son environnement d’exécution — notre réseau, de nombreux clouds publics ou des sites en périphérie. Comme plusieurs de ces plans de données peuvent être déployés sur différents sites, nous avons également dû mettre en place un plan de contrôle distribué à l’échelle mondiale afin de les orchestrer.
- La combinaison d’un réseau mondial, d’un nouveau chemin de données réseau et d’un plan de contrôle distribué nous a permis de créer une « passerelle applicative distribuée à l’échelle mondiale », qui assure une sécurité Zero Trust, la connectivité des applications et la fiabilité des clusters sans accorder d’accès réseau à travers ce réseau mondial — un « maillage de services mondial » qui simplifie le travail de notre équipe chargée de la sécurité et de la conformité.
Où sont les câbles ? Pourquoi avons-nous construit un réseau mondial ?
Alors que nos clients développent des applications relativement complexes et critiques — telles que la fabrication intelligente, l’analyse vidéo à des fins de sécurité publique, le trading algorithmique ou encore la transition des opérateurs télécoms vers la 5G — nous devons offrir une expérience disponible en permanence, connectée et fiable, tant pour ces applications que pour leurs utilisateurs finaux. Certaines de ces applications exécutent des pipelines de données entre plusieurs clusters au sein d’un même cloud, doivent sauvegarder des données auprès de différents fournisseurs de cloud, acheminer de manière fiable les requêtes d’utilisateurs du monde entier vers les back-ends applicatifs, ou encore assurer une connectivité hautes performances entre leurs machines et les back-ends hébergés dans des clouds centralisés.
Pour répondre à ces besoins, le réseau physique devait satisfaire à deux exigences :
R1 — Cloud à cloud — Connectivité à hautes performances et à la demande des applications entre des environnements de cloud public ou privé partout dans le monde
R2 — D’Internet vers le cloud — Afin que les appareils et les machines situés en périphérie puissent se connecter de manière fiable au backend de l’application, nous devions proposer plusieurs chemins redondants et établir les connexions au plus près de ces utilisateurs, plutôt que d’acheminer le trafic via Internet jusqu’aux backends.
Nous aurions pu répondre aux exigences R1 et R2 en faisant appel à un fournisseur de services réseau comme AT&T, mais celui-ci n’aurait pas pu nous offrir une expérience réseau fluide ni une intégration transparente avec nos services applicatifs — configuration via API, télémétrie en continu, possibilité d’ajouter facilement nos propres préfixes IP ou ceux de nos clients, services réseau accessibles par API, etc. En outre, obtenir une couverture mondiale auprès de fournisseurs de services est très difficile, voire excessivement coûteux. Nous aurions pu faire appel à deux ou trois fournisseurs différents pour résoudre tous ces problèmes, mais nous nous serions alors retrouvés avec un ensemble disparate de systèmes au comportement, aux modes de défaillance, aux SLA et aux dispositifs d’assistance différents, ainsi qu’avec des API différentes, voire inexistantes.
Nous avons donc dû construire notre propre réseau, ce qui impliquait que celui-ci devait présenter trois caractéristiques :
- Pour répondre à R1, nous devions créer un réseau privé reliant toutes les régions, à l’échelle mondiale et auprès de plusieurs fournisseurs de cloud. La meilleure approche consistait à établir des accords de peering avec les fournisseurs de cloud dans les principales régions cloud, tout en utilisant une combinaison de liaisons Direct Connect dans les principaux centres de colocation. Le peering ne garantit pas les meilleurs SLA, tandis que les liaisons Direct Connect offrent des garanties de SLA au sein d’une région cloud.
- Pour répondre à l’exigence R2 concernant les machines situées en périphérie, nous devions prendre en charge plusieurs liaisons actives-actives depuis chaque site périphérique. Il peut s’agir de connexions Internet à faible coût (via un réseau cellulaire, le câble ou la fibre) et/ou de liaisons dédiées plus coûteuses (via la fibre ou Ethernet). Pour garantir les performances et la fiabilité, le trafic doit être équilibré et acheminé vers un point de terminaison aussi proche que possible du site périphérique, plutôt que de transiter sur de longues distances via un réseau Internet peu fiable. Dans le jargon du secteur, cette fonctionnalité est également appelée SD-WAN.
- Répondre à l’exigence R2 pour les internautes et les applications en périphérie impliquait de terminer le trafic TLS en périphérie, au plus près de l’utilisateur. Nous avons donc dû mettre en place des points de présence en périphérie du réseau, bénéficiant d’un interappairage dense avec les opérateurs mobiles et les fournisseurs de contenu, et acheminer également le trafic via plusieurs opérateurs de transit afin de garantir un routage optimal.
Pour répondre à ces trois exigences, nous avons dû prendre de nombreuses mesures. Nous allons toutefois mettre en avant cinq grands axes :
- PoP de réseau mondiaux équipés de notre propre matériel réseau — nous avons finalement dû déployer plusieurs PoP réseau dans de grandes métropoles. Au début de la construction de notre plateforme, nous avons commencé par plusieurs villes européennes — Paris, Londres, Amsterdam et Luxembourg — ainsi que par un PoP aux États-Unis, à New York, avant de nous étendre à Seattle, San José, Ashburn, Francfort, Singapour et Tokyo. Cela nous a permis d’assurer une couverture mondiale tout en restant proches de tous les principaux fournisseurs de cloud. Nous avons choisi Equinix comme partenaire mondial, complété par Interxion, Telehouse/KDDI et Westin dans les sites où Equinix n’était pas le choix optimal. Convaincus des avantages de l’automatisation, nous avons opté pour les équipements de commutation et de routage de Juniper Networks, ainsi que pour Adva afin d’assurer l’interconnexion métropolitaine par fibre avec des liaisons de 400G et 100G.
- Backbone privé — Afin de relier tous ces PoP avec des performances et une fiabilité élevées, nous avons décidé de ne pas construire un réseau superposé reposant sur plusieurs fournisseurs de transit, mais plutôt de mettre en place un backbone privé mondial combinant plusieurs longueurs d’onde 100G fournies par des opérateurs tels que Zayo, Centurylink, EuNetworks, etc. Si de nombreux CDN (par ex. Cloudflare, Fastly) et fournisseurs de solutions de sécurité (par ex. Zscaler) s’appuient entièrement sur des connexions de transit et de peering, car ils acheminent du trafic vers les utilisateurs finaux, nous estimons qu’il existe de bonnes raisons de combiner backbone privé et transit, puisque nous gérons des flux est-ouest entre applications. Cette approche ne nous est pas propre : tous les grands fournisseurs de cloud disposent d’un backbone privé mondial reliant leurs différentes régions cloud.
- Fournisseurs de peering Internet et de transit — Afin d’accroître la diversité et d’obtenir les meilleures performances pour atteindre les utilisateurs et les fournisseurs de contenu ou de services SaaS, la solution idéale consiste à établir des accords de peering directs avec autant d’opérateurs et de fournisseurs de contenu que possible. Nous sommes présents sur plusieurs points d’échange, comme indiqué dans PeeringDB (ASN-35280 dans PeeringDB). Tout le trafic ne pouvant pas être acheminé via les connexions de peering, les connexions de transit prennent alors le relais. Les liaisons de transit et les ports de peering doivent faire l’objet d’une surveillance très rigoureuse afin de maintenir un niveau de qualité élevé. Nous avons finalement retenu les meilleurs fournisseurs de niveau 1, tels que NTT, CenturyLink et Telia, pour assurer notre connectivité dans différents sites à travers le monde.
- Peering et interconnexions avec les fournisseurs cloud — Nous avons récemment commencé à établir des connexions de peering directes avec des fournisseurs cloud, mais ceux-ci ne garantissent aucun SLA pour ces connexions. Par exemple, depuis notre point de peering de Seattle (site de Westin), nous pouvons accéder directement aux trois principaux fournisseurs cloud. Bien que ces connexions soient préférables à un simple acheminement via des fournisseurs de transit, nous avons commencé à compléter notre réseau par des connexions directes à ces fournisseurs cloud (appelées AWS Direct Connect, Azure Express Route et GCP Dedicated Interconnect), car elles sont assorties de SLA et de fonctionnalités supplémentaires. Bien que ces liaisons soient coûteuses et permettent uniquement d’accéder aux sous-réseaux VPC/VNET internes, elles offrent la meilleure connectivité.
- Passerelles logicielles — Dans les environnements cloud ou les sites périphériques qui ne sont pas directement connectés à nos points de présence (PoP), nous installons nos passerelles logicielles. Nous présenterons les fonctionnalités avancées de ces passerelles dans une section ultérieure de cet article de blog. Parmi les fonctionnalités liées à la couche de transport, ces passerelles créent automatiquement des tunnels VPN sécurisés (IPsec ou SSL) vers plusieurs PoP réseau afin d’assurer la redondance et de répartir le trafic entre les PoP. En outre, dans un déploiement cloud, elles établissent une connexion sortante vers notre PoP le plus proche via les passerelles NAT des fournisseurs de cloud, ainsi qu’un point d’accès à notre réseau privé mondial. Il n’est donc pas nécessaire de transiter par des réseaux publics ni de connecter des clusters d’applications répartis entre plusieurs environnements cloud à l’aide d’adresses IP publiques.
Nous avons compris très tôt dans notre développement que la création et l’exploitation d’un réseau mondial exigeaient du temps et des compétences, et qu’il nous fallait intégrer cette expertise. Après plusieurs mois de discussions avec les fondateurs d’Acorus Networks (un fournisseur de solutions de sécurité basé à Paris, en France), nous avons finalement fusionné Acorus avec Volterra. Cela nous a permis de résoudre la problématique du déploiement de notre infrastructure et de notre réseau à l’échelle mondiale. Acorus avait mis sur pied un excellent réseau ainsi qu’une équipe d’exploitation qui avait entièrement automatisé la configuration du réseau physique à l’aide d’Ansible et développé des API externes de télémétrie et de configuration utilisables par notre équipe logicielle.
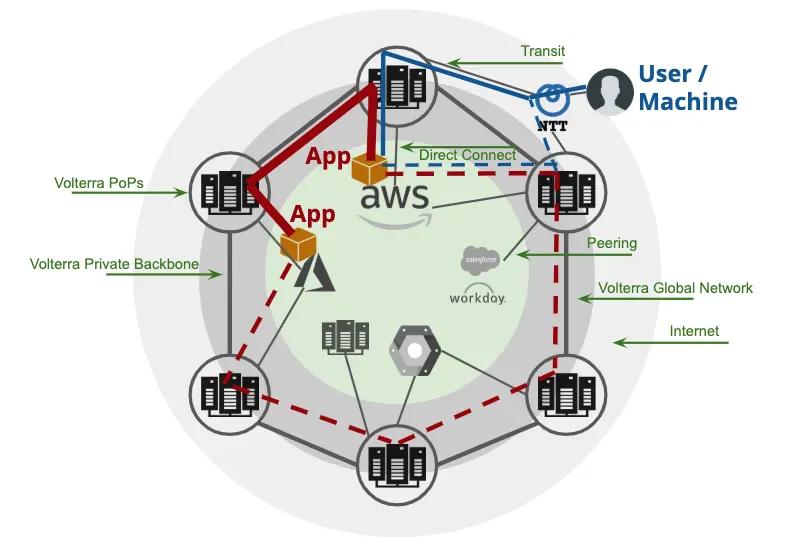
Maintenant que nous disposions d’une équipe dédiée au développement d’un réseau privé mondial hautement fiable et performant, nous pouvions facilement résoudre les problématiques liées aussi bien au trafic d’application à application qu’au trafic d’un utilisateur ou d’une machine vers une application, entre différents sites en périphérie ou dans le cloud, comme illustré à la Figure 1. En outre, les infrastructures de calcul et de stockage présentes dans les points de présence (PoP) de notre réseau nous permettaient également d’y ajouter la terminaison des API, la sécurité des applications et le délestage des charges de travail depuis la périphérie ou le cloud. Nous pourrons ainsi continuer à faire évoluer nos capacités sur le long terme et étendre facilement la couverture de notre réseau ainsi que notre catalogue de services en fonction de la demande.
Services réseau pour les applications — multicloud, cloud privé, edge ?
Une fois notre réseau mondial opérationnel, nous avons dû commencer à y ajouter des clusters d’applications et nos charges de travail. Ces charges de travail nécessitent leur propre ensemble de services de connectivité et de sécurité au niveau applicatif.
Comme nous l’avons expliqué dans notre précédent article de blog, notre objectif avec cette plateforme était d’améliorer la productivité et de réduire la complexité pour nos équipes qui gèrent des charges de travail exécutées dans plusieurs environnements (cloud, périphérie et nos points de présence réseau).
Chaque fournisseur de services cloud nécessite de configurer, gérer et surveiller de nombreuses ressources cloud différentes afin d’assurer une connectivité sécurisée aux clusters d’applications. Par exemple, dans Google Cloud, la configuration d’un service réseau de bout en bout pour un cluster d’applications nous oblige à gérer de nombreux ensembles de services différents :
Services de réseau étendu (WAN)
Services réseau applicatifs
- Équilibreurs de charge applicatifs, Équilibreurs de charge réseau (API publiques)
- Équilibreurs de charge applicatifs, Équilibreurs de charge réseau (Interne)
- Maillage de services (d’application à application)
Services de routage et d’isolation du réseau
- Réseau de cloud privé virtuel (réseau VPC)
- Sous-réseaux, Plages d’adresses IP, Routes
- Passerelles NAT, Règles de pare-feu
Certes, même si cela aurait représenté un défi de taille, nous aurions pu décider de nous y attaquer en créant une couche de configuration et d’exploitation afin d’harmoniser les différents fournisseurs de cloud. Cependant, nous savions que cela n’aurait pas résolu nos problèmes, car les services proposés par les fournisseurs de cloud ne répondaient pas à tous nos besoins (par exemple, les CSP ne permettent pas d’assurer la sécurité des applications et des API), ne sont pas les plus performants du marché et évoluent en permanence.
En outre, qu’en est-il de nos points de présence (PoP) réseau et de nos sites en périphérie ? Il nous faudrait obtenir des fonctionnalités similaires auprès de fournisseurs de matériel ou de logiciels, puis les intégrer toutes ensemble — par exemple, Cisco/Juniper pour le routage, le NAT et le VPN, F5 pour l’équilibrage de charge et le pare-feu, etc. Sur les sites en périphérie, le problème est encore plus complexe, car ni les fournisseurs de cloud ni les grands équipementiers réseau ne sont en mesure de répondre aux besoins en services réseau dans un environnement aux ressources limitées. Une autre option envisageable pour la périphérie aurait été de transférer l’ensemble des services de connectivité applicative, de sécurité et de réseau vers notre réseau mondial — mais il était évident que cela ne fonctionnerait pas, car le trafic entre applications au sein d’un même site en périphérie avait lui aussi besoin de certains de ces services.
Après de nombreuses discussions et une analyse approfondie des solutions disponibles, nous avons constaté que l’intégration de multiples prestataires de services et fournisseurs — configuration, télémétrie, supervision, alertes — ainsi que le suivi de l’évolution de leurs feuilles de route et de leurs API allaient à l’encontre de notre objectif de simplicité et de rapidité.
Un autre problème que nous devions résoudre à l’échelle de la plateforme était la mutualisation. Celle-ci était plus facile à mettre en œuvre pour les services WAN et le routage réseau, mais s’avérait complexe pour les services réseau applicatifs, car la plupart des répartiteurs de charge du marché ne prennent pas en charge la mutualisation, ou seulement de manière très limitée.
Un nouveau chemin de données réseau L3-L7+
Nous avons donc décidé de relever ce défi et de créer un chemin de données réseau hautes performances fournissant non seulement un service de routage réseau, mais aussi des services applicatifs, de sécurité et de réseau étendu. Nous pourrions ainsi unifier notre portefeuille de services dans l’ensemble de notre environnement cloud hybride et distribué, tout en limitant notre dépendance aux services natifs des clouds publics.
Compte tenu de la solide expérience de l’équipe en matière de réseaux et du fait que nous avions déjà été confrontés à ce type de problèmes chez Contrail/Juniper, nous avons estimé que la meilleure façon de les résoudre était de repartir de zéro et de concevoir une toute nouvelle solution réseau intégrant des services de couche L3 à L7+ dans un chemin de données unique, capable de fonctionner dans n’importe quel cloud ou environnement edge, tout en étant géré de manière centralisée par notre plateforme.
Nous avons sélectionné les meilleurs projets pour commencer à concevoir ce nouveau chemin de données : OpenContrail vRouter (pour les couches L3-L4), que nous développions déjà depuis six ans, et Envoy pour la couche L7, qui bénéficie du soutien d’une vaste communauté. Cela dit, nous avons dû apporter plusieurs modifications et ajouts afin de créer un nouveau chemin de données unifié L3-L7+ : prise en charge de plusieurs locataires dans Envoy, DPDK pour Envoy, pile TCP DPDK en espace utilisateur, politiques réseau, VPN SSL/IPSec, HTTP CONNECT, proxy inverse dynamique, proxy direct transparent, passerelle API, politiques applicatives programmables, ACL rapides pour la protection contre les attaques DDoS, intégration des identités PKI, moteur Chrome V8, sécurité des applications et du réseau, etc.
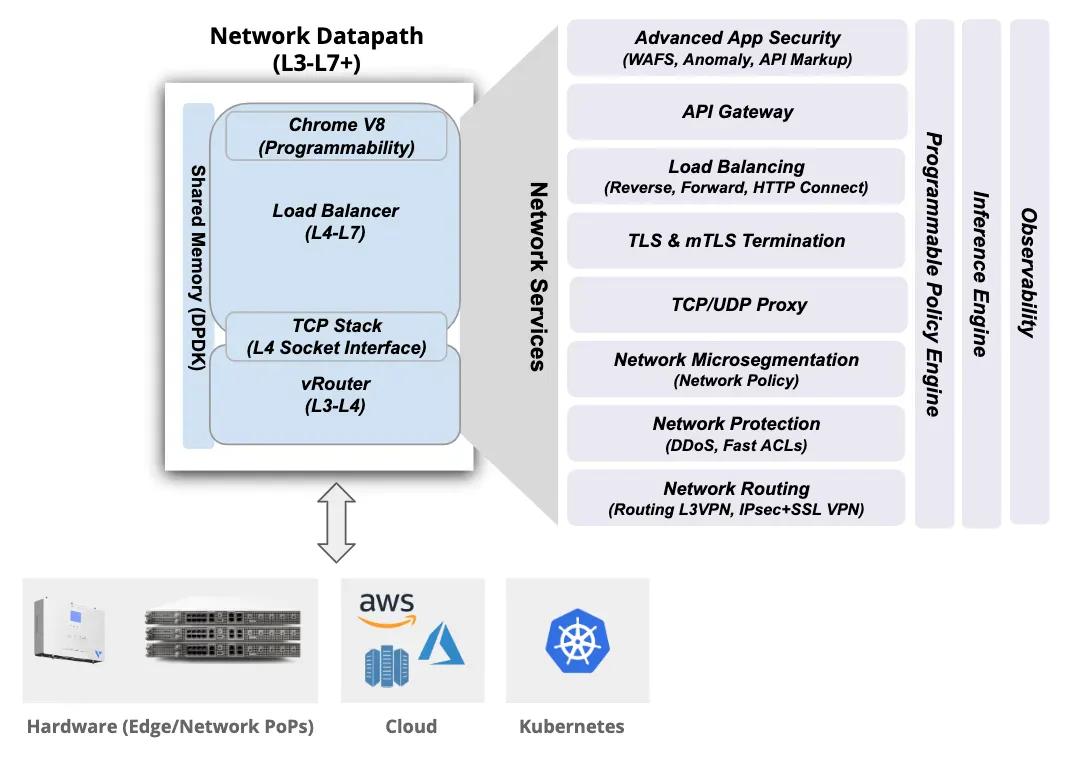
Ce chemin de données (comme illustré à la figure 2) est déployé en tant que passerelle d’entrée/sortie pour nos clusters d’applications, passerelle logicielle en périphérie, pour fournir des fonctionnalités de maillage de services au sein d’un cluster ou entre plusieurs clusters, ou pour fournir des services réseau depuis nos points de présence mondiaux.
Afin de répondre à notre besoin de mutualisation de la plateforme (abordé dans l’article de blog précédent), nous devions également assurer une mutualisation complète de ce chemin de données réseau. Cela a été relativement simple pour la couche de routage, car le vRouter prenait déjà en charge les VRF. Nous avons toutefois dû modifier Envoy pour le rendre mutualisé. Comme nous n’utilisions pas la pile TCP du noyau, nous avons modifié l’interface de socket TCP d’Envoy et ajouté la prise en charge des VRF.
Ce chemin de données devait également assurer la sécurité des API, la protection des applications par pare-feu et la sécurité du réseau. Pour ce faire, nous avons combiné des techniques algorithmiques et de l’inférence automatique. Nous aborderons ce sujet dans un prochain article de blog.
La création de ce chemin de données réseau nous a apporté de nombreux avantages :
Fonctionnalités L3 à L7+ complètes avec une configuration, un contrôle et une observabilité uniformes
La prise en charge de la mise à l’échelle horizontale au sein d’un même cluster nous permet de couvrir un large éventail de configurations, depuis les appareils en périphérie à très faible encombrement et aux performances modestes jusqu’aux déploiements offrant une capacité de 100 Gbit/s ou plus sur notre réseau ou dans des environnements de cloud public.
Ajoutez rapidement de nouvelles fonctionnalités au chemin de données réseau sans dépendre d’un fournisseur réseau et/ou d’un fournisseur de services cloud
Une solution commune présentant des caractéristiques similaires en matière de défaillance et de performances dans tous les environnements — un point essentiel pour nos équipes d’exploitation.
Maintenant que nous pouvions déployer plusieurs clusters d’applications avec ce nouveau chemin de données réseau, il était essentiel de mettre en place un plan de contrôle distribué à l’échelle mondiale afin de les configurer, de les contrôler et de les surveiller.
Plan de contrôle spécialement conçu pour un réseau distribué
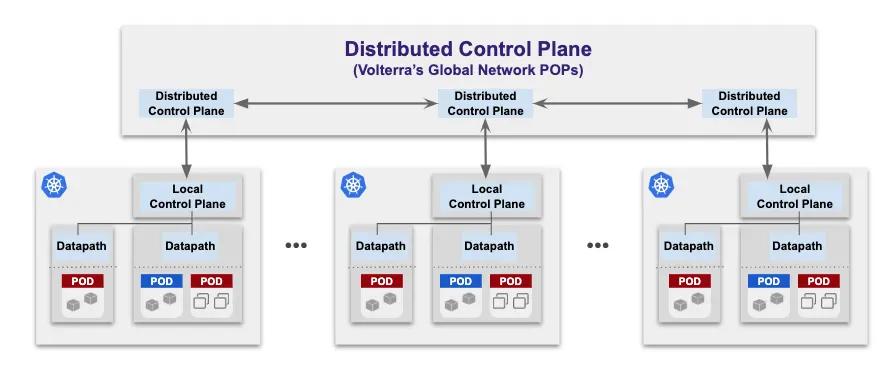
Notre équipe plateforme a dû relever plusieurs défis lors de la conception d’un plan de contrôle distribué destiné à gérer un grand nombre de nœuds distribués de traitement du plan de données. Comme nous avions créé un nouveau plan de données, il n’existait aucun plan de contrôle prêt à l’emploi sur lequel nous appuyer et nous avons dû développer le nôtre : un plan de contrôle local permettant de gérer plusieurs plans de données au sein d’un même cluster (cloud, périphérie ou PoP réseau). Ces nœuds du plan de données avaient besoin d’un plan de contrôle local pour gérer les modifications de configuration et les mises à jour des routes, effectuer des contrôles d’intégrité et la découverte de services, établir des sessions de peering avec d’autres équipements réseau à l’aide d’un protocole tel que BGP, agréger les métriques et les journaux d’accès, etc. Un plan de contrôle distribué permet de gérer plusieurs plans de contrôle locaux. Un tel plan de contrôle est déployé dans les PoP de notre réseau mondial (Figure 3) et assure la gestion de la configuration des plans de contrôle locaux, la distribution de l’état opérationnel entre chacun d’eux, ainsi que la collecte des données de chaque nœud. Pour distribuer l’état opérationnel, nous avons choisi BGP en raison de sa cohérence à terme et de sa robustesse. Comme nous avions développé dans le cadre d’OpenContrail une implémentation multithread de BGP capable de fonctionner à très grande échelle, nous l’avons réutilisée et enrichie d’extensions pour l’équilibrage de charge, notamment la distribution des contrôles d’intégrité, les points de terminaison http/api et la propagation des politiques.
En outre, un plan de gestion centralisé, déployé dans deux régions cloud — AWS et Azure —, est utilisé conjointement avec le plan de contrôle distribué afin d’assurer la mutualisation, comme illustré à la Figure 4. Notre équipe SRE peut créer plusieurs locataires, chacun étant totalement isolé des autres sur notre réseau mondial. Ils ne peuvent communiquer entre eux que via le « réseau public ». Au sein d’un même locataire, les services répartis entre différents espaces de noms peuvent communiquer selon les règles de routage HTTP/API/réseau et les règles de sécurité.
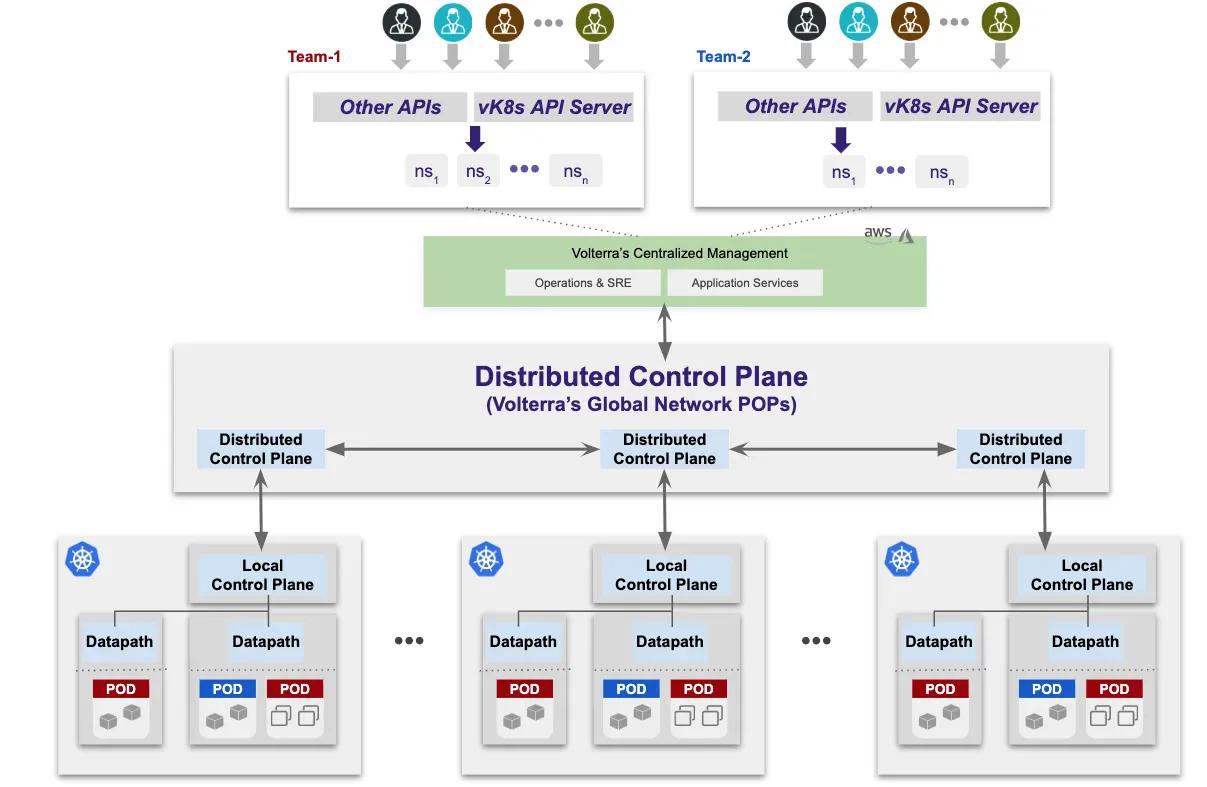
Les plans de contrôle s’exécutent sous forme de charges de travail Kubernetes dans un tenant distinct et un espace de noms isolé, placés sous le contrôle exclusif de nos équipes SRE. Ainsi, aucun développeur ni client ne peut perturber ce service. En outre, le plan de contrôle étant distribué, l’indisponibilité d’un plan de contrôle sur un site n’affecte pas le service dans son ensemble.
Passerelle d’applications distribuée à l’échelle mondiale ?
Une fois que nous avons cerné les besoins de notre réseau mondial et défini les exigences relatives aux services réseau L3-L7+ pour les clusters d’applications (un nouveau chemin de données et un plan de contrôle distribué), notre équipe produit a formulé de nouvelles exigences qui ont rendu notre travail encore plus passionnant. En résumé, elle souhaitait que nous mettions en place un maillage de services mondial interclusters doté des fonctionnalités suivantes :
- Fournir une connectivité applicative (routage, contrôle et observabilité) à l’échelle du réseau mondial, mais pas une connectivité réseau (du moins, pas par défaut) — La raison était simple : interconnecter des réseaux crée toutes sortes de failles de sécurité qui ne peuvent être corrigées qu’en mettant en place des règles de pare-feu complexes, ce qui complique la gestion des changements.
- Améliorer les équilibreurs de charge en périphérie dans les PoP du réseau en tenant compte de l’état de santé et de la fiabilité des points de terminaison — Actuellement, pour les équilibreurs de charge en périphérie (par exemple, AWS Global Accelerator ou Akamai Global Load Balancer), la décision de routage entre le site périphérique et le backend repose sur l’état de santé du serveur d’origine (dans la plupart des cas, ce serveur est lui-même un autre équilibreur de charge, et non le véritable point de terminaison qui traite les requêtes). Notre équipe souhaitait que chacun de nos équilibreurs de charge en périphérie puisse gérer le trafic en fonction de l’état de santé de tous les points de terminaison de l’ensemble des clusters, et pas seulement de celui des équilibreurs de charge d’origine.
- Améliorer la sélection du site périphérique (PoP réseau) dans le cadre de la prise de décision GSLB — Actuellement, l’anycast ou le GSLB achemine l’utilisateur/client vers le site périphérique le plus proche pour l’entrée du trafic. Toutefois, pour diverses raisons (charge sur le réseau fédérateur et/ou chez les fournisseurs de transit), il peut être préférable d’orienter l’utilisateur vers un autre site périphérique d’entrée.
Avec les exigences n° 2 et 3, l’objectif était d’améliorer le temps de réponse et les performances de la connectivité entre le client et le serveur, ce qui est particulièrement crucial pour les communications entre applications ou les applications SaaS à grande échelle. Pour répondre à ces exigences, il était évident que la meilleure approche consistait à mettre en place un proxy distribué (figure 5), composé d’un proxy d’entrée et d’un proxy de sortie, et à effectuer le routage en fonction de l’adressage applicatif plutôt que de l’adressage réseau. En outre, nous avons décidé de diffuser l’état de santé des points de terminaison de service (ou serveurs) en nous appuyant sur le plan de contrôle distribué et les extensions BGP (comme décrit précédemment). Cette mise en œuvre du proxy distribué est illustrée dans le schéma ci-dessous.
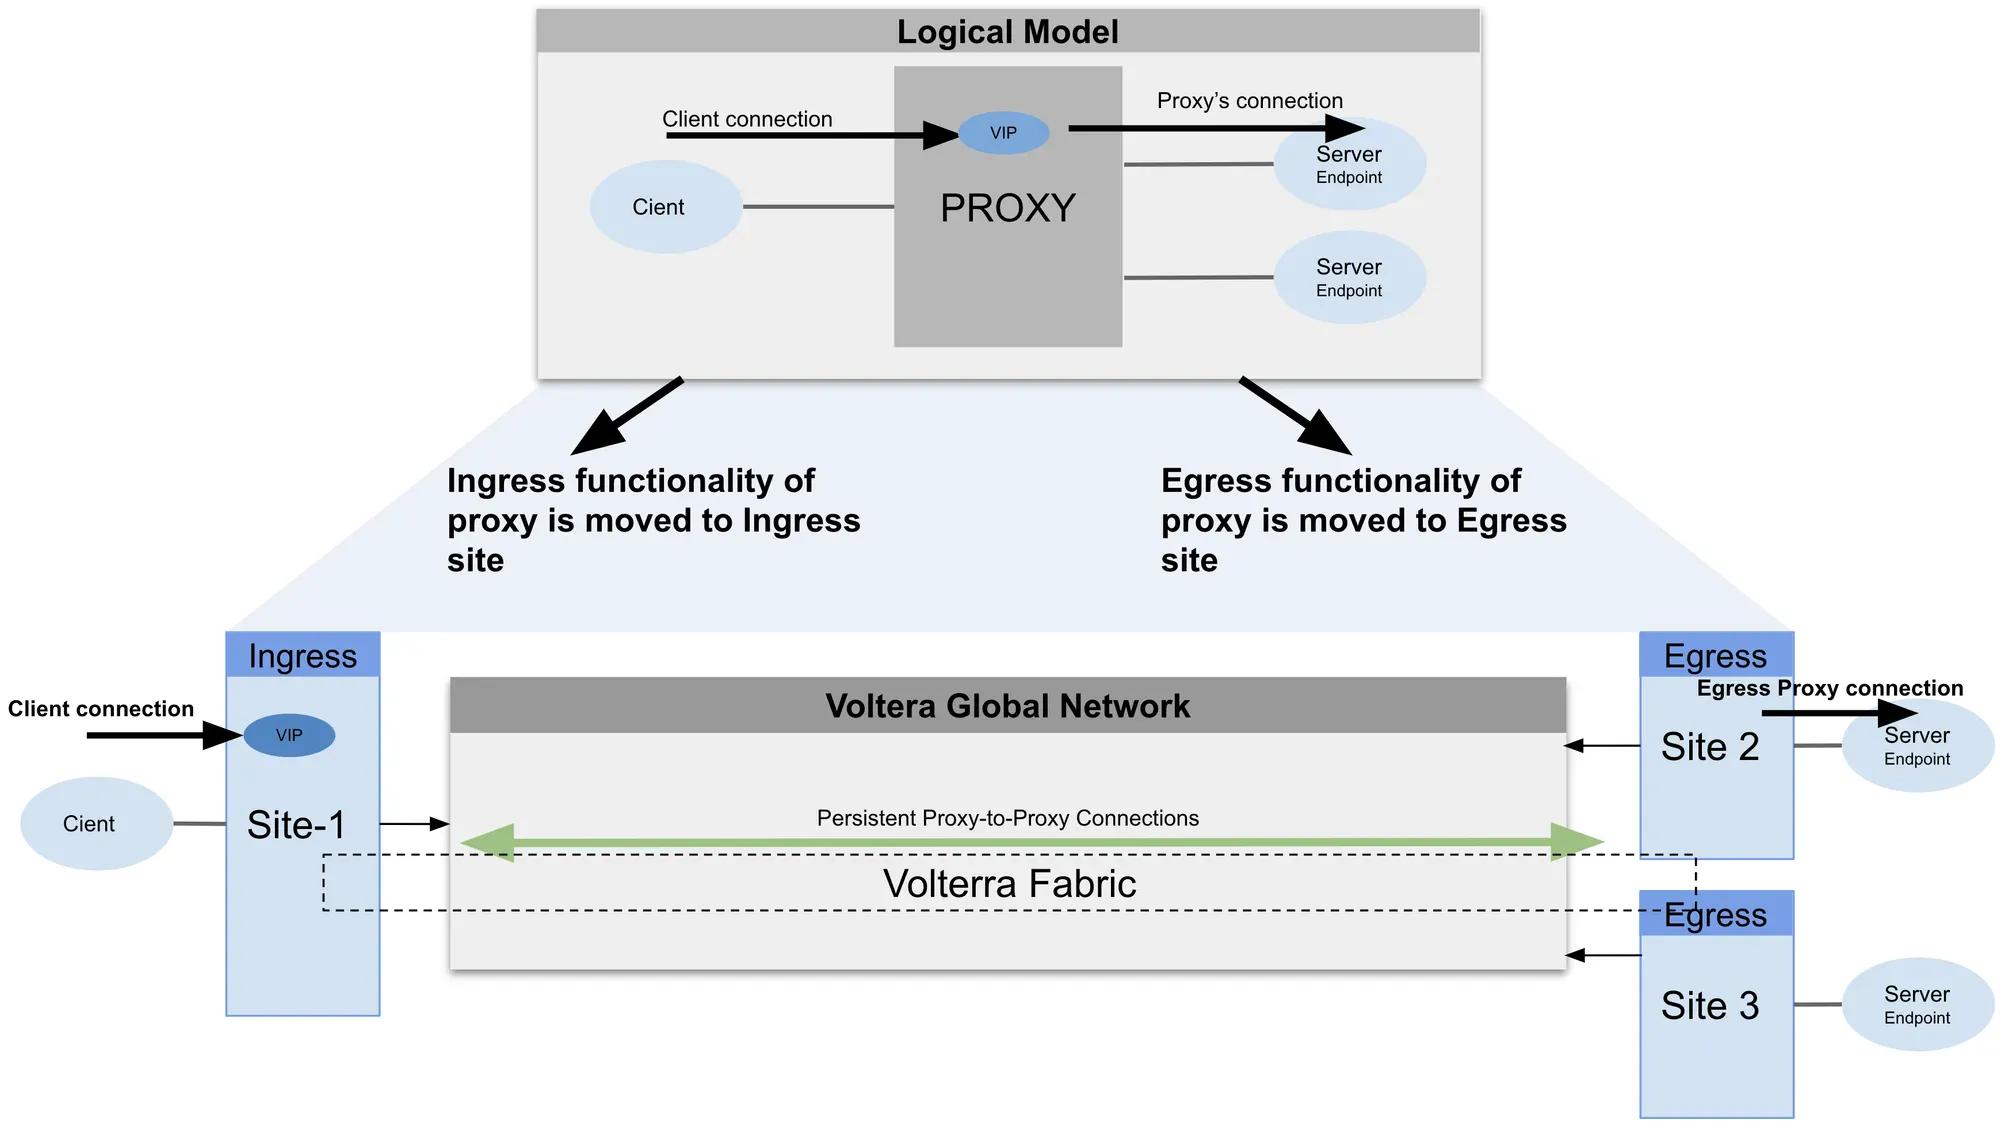
Depuis qu’il est devenu un proxy distribué doté d’une pile réseau L3-L7+ complète, nous le qualifions de passerelle applicative distribuée à l’échelle mondiale. Toutes les fonctionnalités disponibles dans notre plan de données réseau le sont désormais sur l’ensemble de notre réseau mondial — par exemple, l’équilibrage de charge et le routage basés sur HTTP ou les API, l’application des politiques en périphérie, la transformation des API, la terminaison TLS au plus près de l’utilisateur, etc.
Avantages apportés par la passerelle d’applications distribuée
La mise en œuvre d’une passerelle d’applications distribuée à l’échelle mondiale a permis à l’équipe de bénéficier de nombreux avantages en matière d’amélioration des opérations, de sécurité, de performances et de coût total de possession (TCO) :
- Sécurité et conformité — La possibilité de fournir un accès aux applications entre différents sites sans accès réseau a considérablement amélioré la sécurité et la conformité des clusters d’applications situés en périphérie ou dans le cloud. Cela a également réduit la nécessité d’une gestion complexe de la configuration des pare-feu, puisqu’il n’existe aucun accès réseau entre les sites et que les clusters d’applications peuvent être connectés tout en restant entièrement derrière un NAT sur chaque site.
- Charge opérationnelle — L’utilisation d’un ensemble commun de services réseau dans nos points de présence réseau et nos sites en périphérie ou dans le cloud évite à nos équipes SRE ou DevOps d’avoir à intégrer la configuration et l’observabilité de différents ensembles de services.
- Amélioration des performances et de la fiabilité — Comme nous acheminons le trafic depuis notre PoP réseau vers le point de terminaison optimal et opérationnel, plutôt que vers l’équilibreur de charge optimal, la plateforme offre des performances nettement supérieures à celles de toute autre solution du marché pour le trafic d’application à application ou d’utilisateur à application.
- Réduction du coût total de possession — Pour les applications SaaS à grande échelle, il est courant de disposer de centaines de réplicas du service, hébergés dans plusieurs centres de données à travers le monde. Pour y parvenir efficacement, le fournisseur SaaS doit développer des fonctionnalités complexes, désormais accessibles à tous nos clients grâce à cette passerelle d’applications distribuée.
À suivre…
Cette série d’articles de blog abordera les différents aspects de la conception et de l’exploitation de notre service SaaS distribué à l’échelle mondiale, avec de nombreux clusters d’applications dans le cloud public, nos points de présence (PoP) sur réseau privé et nos sites en périphérie. Le prochain article portera sur la sécurité de la plateforme et des données…
À propos de l’auteur
Articles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.