De nos jours, la nécessité de pouvoir monter en charge ne se pose même plus. La réponse est toujours oui : vous en avez besoin. La croissance de l’entreprise dépend de la capacité opérationnelle des applications qui, après tout, font partie intégrante des modèles économiques actuels, quel que soit le secteur d’activité. Les systèmes sont donc généralement déployés avec les éléments nécessaires pour assurer cette montée en charge lorsqu’elle sera requise — car ce n’est pas une éventualité, mais une certitude. Cela implique généralement le recours à un proxy. Les proxys chargés de la montée en charge (le plus souvent des répartiteurs de charge) sont donc des composants particulièrement critiques de toute architecture moderne.
Ces proxys ne servent pas seulement de mécanisme de mise à l’échelle ; on leur demande de plus en plus de le faire automatiquement, comme par magie, grâce aux merveilles de l’auto-scaling. Ce simple mot composé implique beaucoup de choses, notamment la possibilité de demander par programmation à un système non seulement de déployer des capacités supplémentaires, mais aussi de s’assurer que le proxy chargé de la mise à l’échelle en connaît l’existence et peut lui acheminer les requêtes.
On peut supposer que tout proxy digne de ce nom dispose des interfaces programmatiques nécessaires. Après tout, l’économie des API ne consiste pas seulement à permettre les échanges entre les applications et les personnes, mais aussi entre les systèmes, qu’ils soient sur site ou dans le cloud. Cependant, on oublie souvent que l’ajout d’une nouvelle ressource à un proxy d’équilibrage de charge s’effectue sur le plan de gestion ou de contrôle, et non sur le plan de données.
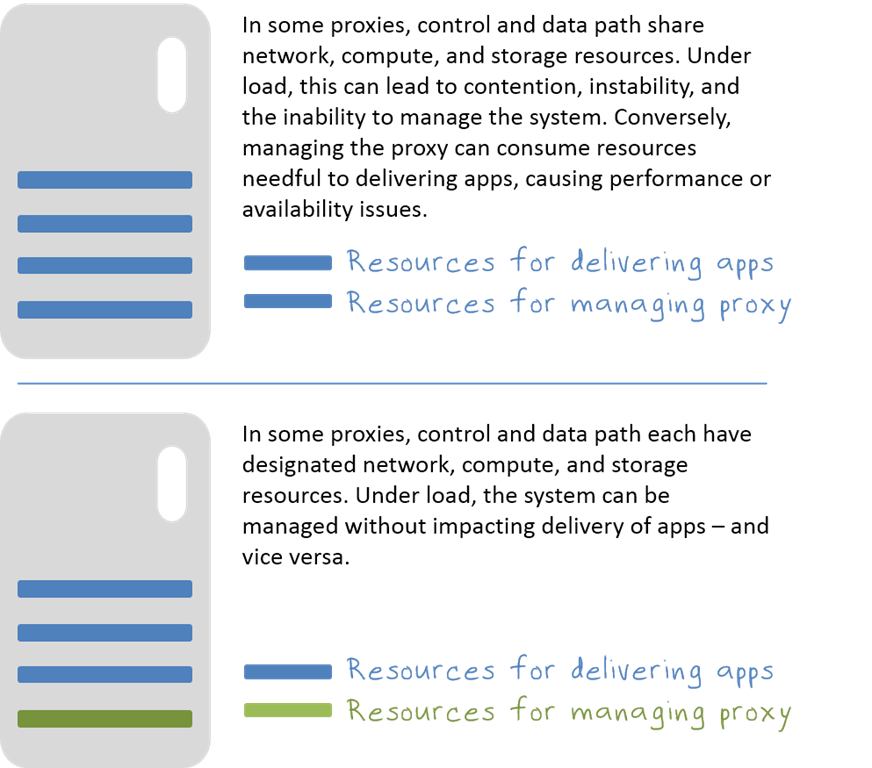
C’est logique. Nous ne voulons pas perturber le fonctionnement du système pendant que nous recueillons des statistiques ou modifions sa configuration. C’est à proscrire, surtout lorsque nous essayons d’augmenter la capacité parce que le système tourne à plein régime pour fournir des applications à des utilisateurs impatients.
Mais que se passe-t-il lorsque c’est l’inverse qui se produit ? Lorsque le fonctionnement du système entrave sa gestion ?
Votre mise à l’échelle automatique (ou manuelle, d’ailleurs) va échouer. La capacité de l’application n’augmentera donc pas, et l’activité de l’entreprise en pâtira.
C’est une mauvaise nouvelle, comme si vous aviez besoin que je vous le dise.
Cela s’explique par le fait que de nombreux proxys (qui n’ont pas été conçus en tenant compte de ce paradoxe) partagent les ressources système entre le plan de contrôle et le plan de données. Il n’existe aucune isolation entre les deux. Le réseau qui assure la diffusion des applications sert également à administrer le proxy. La mémoire vive et les ressources de calcul affectées à la diffusion des applications servent aussi à administrer le proxy. En cas de forte charge, un seul de ces deux plans obtient les ressources. Si vous essayez d’ajouter des ressources applicatives au proxy afin de monter en charge, mais que vous ne pouvez pas accéder au système pour le faire, vous êtes pour ainsi dire dans une situation délicate.
C’est pourquoi il est important d’évaluer votre choix de proxys sous l’angle de leur facilité de gestion. Il ne faut pas seulement tenir compte de leur simplicité d’administration, ni de leur API et de leurs capacités de script, mais aussi de leur facilité de gestion sous charge. Les proxys spécialement conçus pour fonctionner à très grande échelle doivent disposer d’un ensemble distinct de ressources dédiées à la gestion, afin de pouvoir continuer à être administrés et supervisés, quelle que soit la charge imposée au plan de données par la diffusion des applications.
Dans le monde des réseaux, on parle de gestion hors bande, car elle s’effectue en dehors du chemin des données, c’est-à-dire du chemin principal, le chemin critique.
La capacité à gérer un proxy sous charge, hors bande, est essentielle pour pouvoir faire évoluer globalement les applications — automatiquement ou manuellement — et, par leur intermédiaire, l’activité de l’entreprise.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.