GraphQLの役割と影響
Rajesh Narayanan 著
レビューおよび寄稿:OCTOチームほか
F5 Office of the CTOの見解
GraphQLは、従来のREST APIの制約を克服する、モダンで効率的なAPI開発手法として登場しました。RESTはWebの黎明期から広く利用されてきましたが、GraphQLは新たな視点をもたらし、開発者がより細かく制御できるようにします。GraphQLでは、開発者が強く型付けされたスキーマを定義することで、クライアントは必要なデータを正確にリクエストできます。データの過剰取得や取得不足を解消することで、GraphQLはパフォーマンスを最適化し、複雑なデータクエリやデータモデリングを必要とする、モダンでインタラクティブなWebアプリケーションの構築を容易にします。
一方で、GraphQLの導入には課題も伴います。本書では、GraphQLの導入に関連するセキュリティ上の懸念や学習コストについて解説します。また、GraphQLの導入に成功した著名企業が得たメリットを紹介する、実際の事例も取り上げます。
さらに、GraphQLに関する独自の調査を紹介し、そこで得た経験と知見を共有します。GraphQLの概要を簡潔に説明し、RESTとの比較を行ったうえで、GraphQLが解決する課題を掘り下げます。また、組織が十分な情報に基づいて判断できるよう、セキュリティ上の考慮事項についても解説します。調査からは、GraphQLが変革をもたらす可能性が明らかになりました。テスト管理スイートのソフトウェアアーキテクチャを簡素化し、JSONオブジェクト内に隠れていたデータをGraphQL経由で公開した結果、公開データ量が300%超増加した事例を紹介します。
結論として、REST APIインフラストラクチャの拡張、最適化、運用に課題を抱える企業には、有力な解決策としてGraphQLを検討することを強く推奨します。本稿で得られた知見は、GraphQLの導入に着手する企業に実践的な指針を提供し、そのメリットを活用しながら課題を効果的に克服できるよう支援します。
GraphQL入門
GraphQLを選ぶ理由
REST APIの制約を背景に、新たなAPI技術アプローチへの需要が高まっています。
REST(Representational State Transfer)ベースのアプローチは、もともとWeb APIを設計するための一連のアーキテクチャ原則として提唱されました。RESTはWeb 2.0の登場に伴い、Common Object Request Broker Architecture(CORBA)などの他の技術よりもサービス指向アーキテクチャ(SOA)を実装する優れた手段として、2000年代から2010年代にかけて発展しました。
モバイルの普及に伴ってクライアント数が増加すると、必要なデータを正確に取得したいというニーズが高まりました。しかし、RESTベースのAPIでは、データを過剰に取得したり、必要なデータを十分に取得できなかったりすることが多く、非効率が生じていました。Facebookのようなアプリに見られるこのアプローチでは、1回の更新に多数のREST API呼び出しが必要になることも多く、ネットワークトラフィックが増加し、パフォーマンスとユーザーエクスペリエンスが損なわれていました。
GraphQLは、強い型付けのスキーマと、より効率的なデータクエリ手法を提供することで、こうした制約に対処できるよう特別に設計されました。そのため、ネットワーク帯域幅を最適化するうえで特定のデータが必要となるユースケースに適しています。さらに、GraphQLにはスキーマをイントロスペクションする機能があり、ドキュメントやツールの充実にもつながります。RESTの実装がさらに標準化されていれば、ある程度は対抗できた可能性もありますが、GraphQL独自の機能と利点により、分散型でデータ集約型の最新アプリケーションアーキテクチャにとって有力な選択肢となっています。
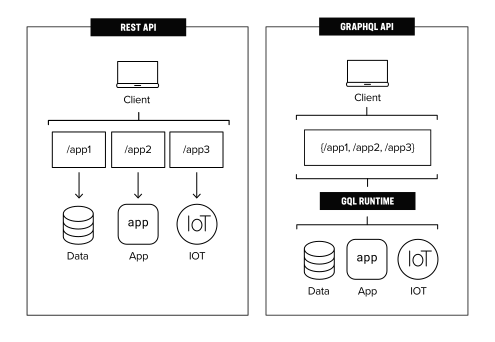
図1は、RESTとGraphQLの実装方法におけるトポロジー上の違いを示しています。REST APIとGraphQLの比較では、「GraphQL APIとREST APIの主な違いは、GraphQLがクエリ言語であるのに対し、RESTはネットワークベースのソフトウェアに関するアーキテクチャ概念である点です」と説明されています。
METAがGraphQLを開発した動機
Metaは2012年に、モバイルアプリのパフォーマンスと柔軟性を向上させるためにGraphQLを開発しました(オープンソース化は2015年)。GraphQLの導入以前、MetaのモバイルアプリはRESTful APIとネイティブコードを組み合わせて構築されていたため、アプリがサポートする必要のある多種多様なデバイス、画面サイズ、ネットワーク環境への対応が困難でした。
直面した主な課題の1つは、RESTful APIが返すデータ量が適切でないことが多く、多すぎる場合もあれば少なすぎる場合もあったことです。APIがモバイルアプリに不要な大量のデータを返すと、読み込み時間が長くなり、パフォーマンスが低下しました。一方、返されるデータが少なすぎると、モバイルアプリは必要なデータをすべて取得するために複数のエンドポイントへリクエストを送信する必要があり、処理の遅延と複雑さが増していました。
Metaは、あらゆるアプリが必要なデータだけを1回のリクエストで取得できるようにGraphQLを開発しました。これにより、モバイルアプリとバックエンドサービス間のデータ転送を最適化でき、読み込み時間の短縮とパフォーマンスの向上につながりました。さらに、GraphQLの強い型付けと自己文書化機能により、開発者はAPIを理解し、利用しやすくなりました。
GRAPHQLのメリット
GraphQLは、データの取得と操作に優れた機能を提供し、従来のAPIアプローチと比べて大きなメリットをもたらします。
強い型付けのスキーマ
GraphQLは強い型付けのスキーマを備えており、APIからクエリできるデータの構造と型を明確かつ正確に定義できます。たとえば、書籍、著者、出版社の情報を含む図書館向けAPIがあるとします。
a) GraphQLスキーマ:GraphQLの強い型付けを持つスキーマは、以下の図2のようになります。
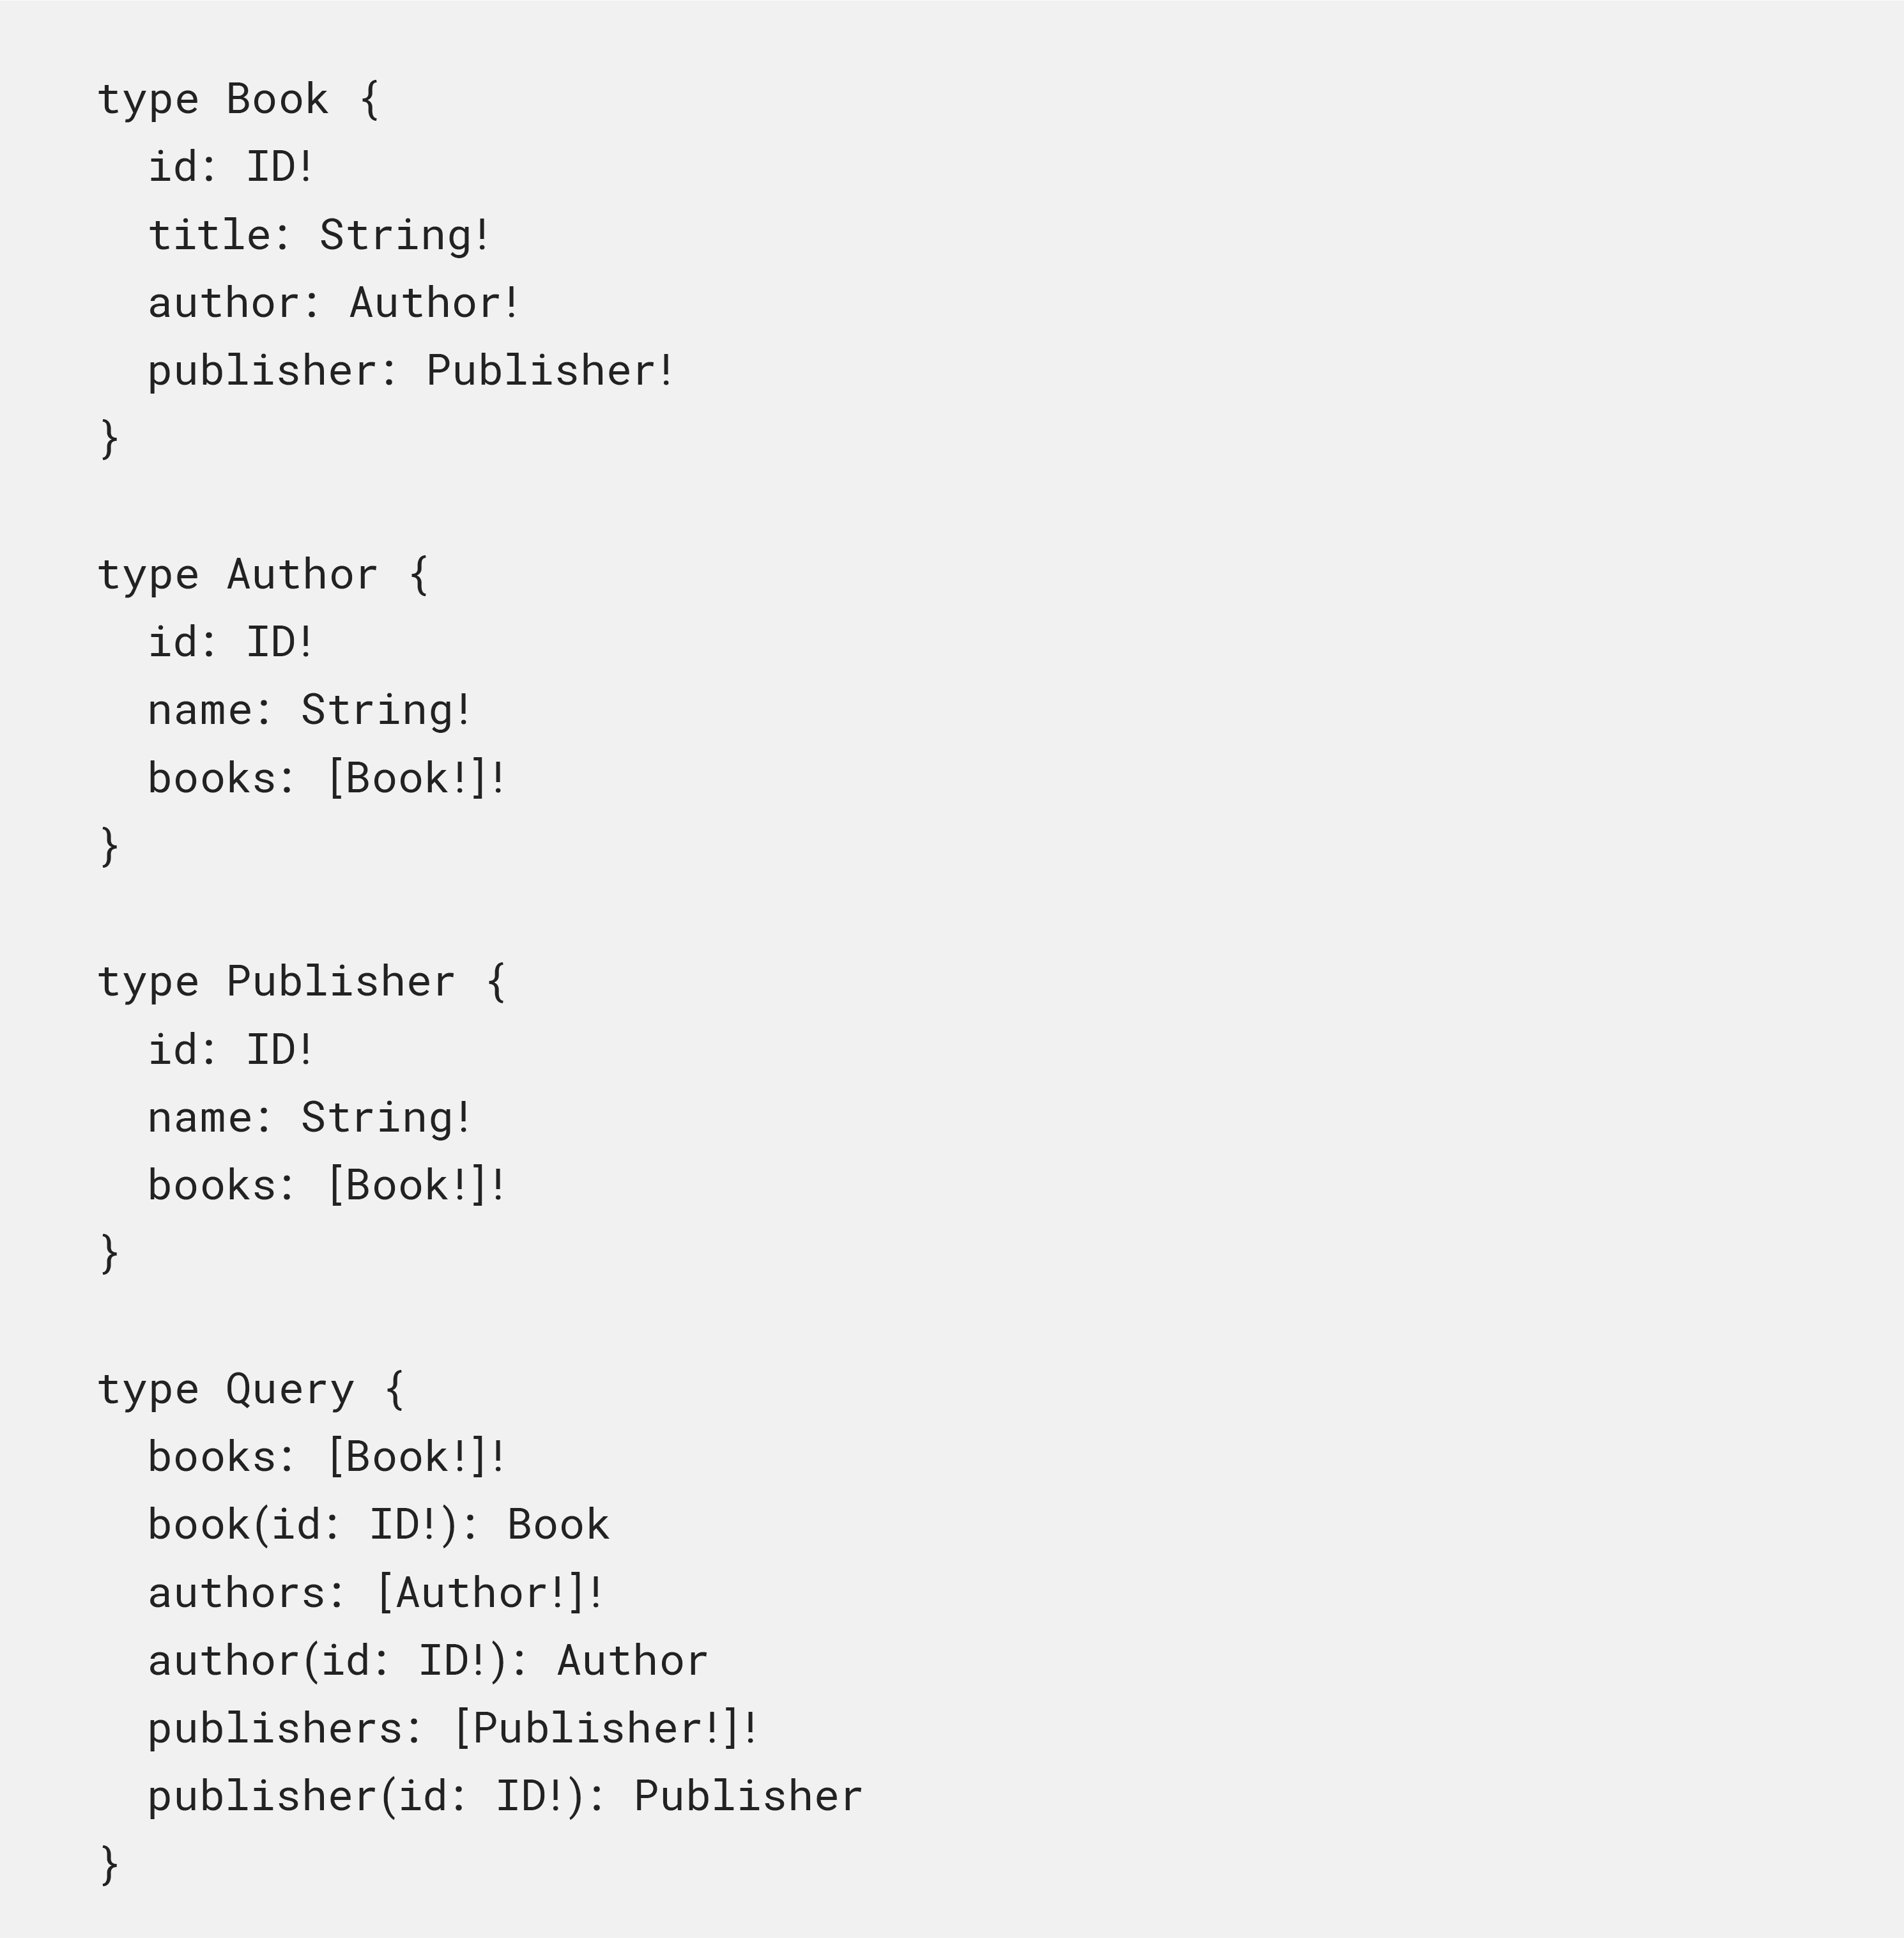
GraphQLの強い型付けを備えたスキーマは、入力検証を可能にし、データの過剰取得や取得不足を防ぎ、明確なドキュメントとツールのサポートを提供します。また、バージョン管理を容易にし、認可とアクセス制御にも役立つため、セキュリティ上のメリットがあります。これらの機能は、一般的な脆弱性のリスクを軽減し、データの適切な処理とアクセス管理を確保することで、APIセキュリティを強化します。
図2の例では、スキーマによって書籍、著者、出版社のデータ型と、それらの相互関係が定義されています。このスキーマは強い型付けがなされており、すべてのフィールドに特定のデータ型が指定されています。クライアントはスキーマを容易にイントロスペクションし、利用可能なフィールドとその型を確認できます。
b) RESTスキーマ: RESTでは、以下の図3に示すように、スキーマ定義は弱い型付けになります。
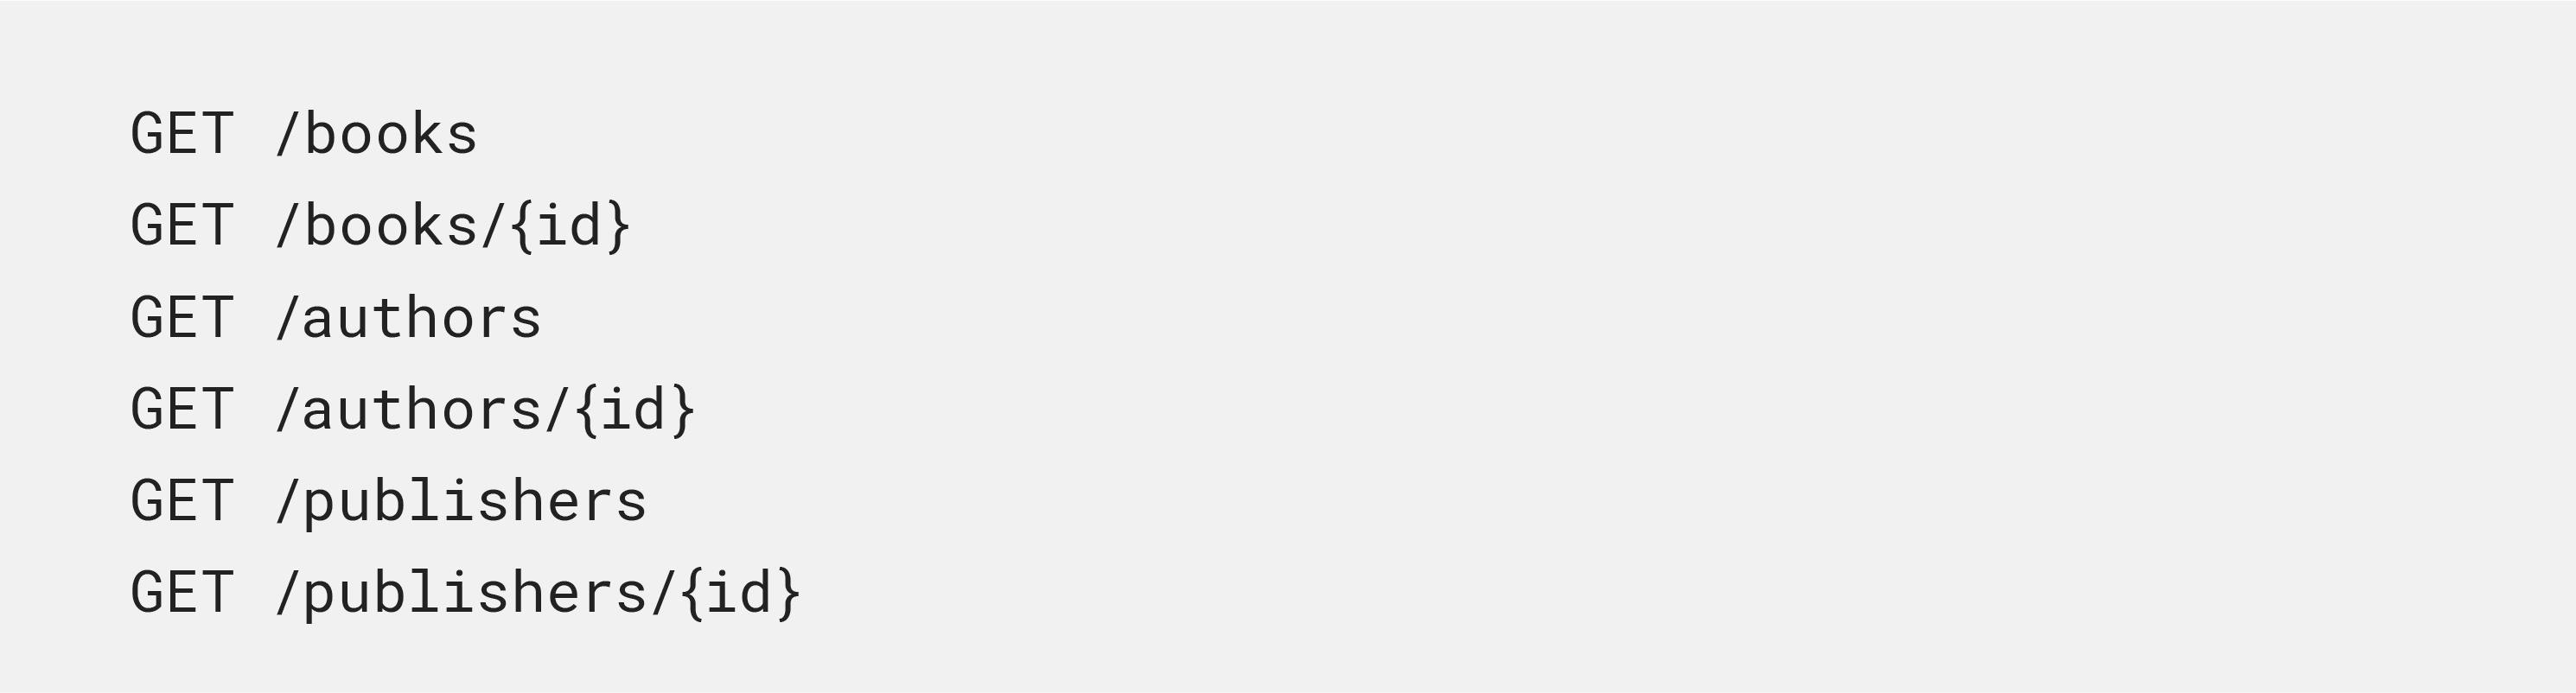
これらのエンドポイントは、書籍、著者、出版社を表すJSONオブジェクトを返します。ただし、スキーマ自体は明示的に定義されておらず、プログラマーのスキルと解釈に委ねられています。クライアントがデータ構造を理解するには、ドキュメントを参照する必要があります。
RESTを超えて
GraphQLは、RESTに代わるより優れた選択肢という位置付けを超えて進化しており、より優れたデータ戦略を検討する企業にとって、有力なアプローチとなる可能性があります。RESTの制約を解消することに加え、GraphQLがAPI設計の新たなアプローチへと進化した背景には、ほかにもいくつかの理由があります。表(図4)ではRESTに対するGraphQLの優位性を示していますが、GraphQLはREST自体の問題が明らかになったことへの対応というよりも、インターネットやさまざまなアプリケーションの進化に対応するものと捉えるのが適切です。
| ATTRIBUTES | GRAPHQL | REST |
|---|---|---|
FLEXIBLE DATA MODELING |
GraphQL allows developers to easily define and evolve APIs to match changing requirements. Clients can precisely specify the data they need using the query language, allowing for a more flexible and efficient data retrieval process. |
The server typically defines fixed endpoints that return predefined data structures. Clients have limited control over the shape and structure of the response, often resulting in overfetching or under-fetching of data. REST lacks the fine-grained control over data retrieval and composition that GraphQL offers. |
BATCHED QUERIES |
GraphQL allows multiple queries to be combined into a single request, which can significantly reduce the number of round trips between the client and server and improve performance. |
Rest has no built-in mechanism for batching multiple queries into a single request. Each REST request typically corresponds to a single resource or endpoint. Some REST frameworks or extensions may provide ways to bundle multiple requests together but are not native or standardized as in GraphQL |
TYPED QUERIES AND RESPONSES |
Clients can specify the exact data they need, and servers can respond with only the requested data, reducing over-fetching and under-fetching. Additionally, GraphQL is strongly typed, which helps prevent errors and improves tooling support. |
Typing is not inherently enforced in queries and responses. The structure and format of the data are typically predefined by the server, and clients must interpret and handle the data accordingly. This can lead to less type-safety. |
INTEGRATION WITH FRONT-END FRAMEWORKS |
GraphQL is designed to work well with front-end frameworks like React and Vue, making it easier to build modern, interactive web applications. GraphQL has dedicated libraries and tooling for seamless integration |
While REST can be used with front-end frameworks, the integration may require more manual effort and custom implementations. While there are third-party libraries, REST does not provide a standardized way of integrating with specific front-end frameworks like React or Vue. |
GRAPH BASED QUERYING |
GraphQL allows for complex queries that span multiple resources and relationships in a single request, making it easier to get the data needed to build complex user interfaces. |
REST typically follows a resource-centric approach, where each endpoint represents a specific resource or entity. It does not inherently provide a mechanism for querying data across multiple resources or relationships in a single request. |
PERFORMANCE |
GraphQL's ability to precisely request only the required data can lead to more efficient data retrieval and improved performance. |
REST APIs may suffer from over-fetching or under-fetching of data, as clients have limited control over the response structure. This can impact performance, particularly if the API returns excessive or unnecessary data. |
DEVELOPER PRODUCTIVITY |
GraphQL's self-documenting nature, with introspection capabilities, reduces the need for extensive documentation and fosters better understanding of the data model. Strongly-typed schema and query validation promote shared understanding and catch errors early. GraphQL has an intuitive query language and easier learning curve, facilitating better onboarding and knowledge transfer within dev teams. |
Due to the lack of a standardized contract between the client and server, tribal knowledge suffers. REST APIs typically rely on informal documentation or conventions varying across different implementations. The lack of a shared understanding leads to inconsistencies and knowledge gaps within teams. This puts the onus on developers who have been on the team longer to spend precious cycles educating team members rather than focusing on the business problem. This reliance on individuals for documentation results in fragmented tribal knowledge, making it difficult for all team members to have a comprehensive understanding of the API's capabilities and data structures. |
API VERSIONING |
GraphQL’s inherent advantage when it comes to versioning is in the ability to deprecate fields that are going to be removed, giving the developers on the client side time to adjust. Versioning similar to REST APIs is still possible. |
Deprecating fields is something not inherently available in REST. It is left up to the client-side developers to ensure they are using the correct version of the API. |
図4:RESTに対するGraphQLの利点
GRAPHQLの課題
GraphQLには従来のRESTful APIと比べて多くの利点がある一方、利用にあたってはいくつかの課題もあります。一般的な課題は次のとおりです。
- 学習コスト:ほとんどの開発者はRESTに慣れているため、GraphQLの導入を予定している組織は、チームがGraphQLを効果的に使用する方法を習得するための時間を確保する必要があります。GraphQLでは、APIの構築と利用についてRESTとは異なる考え方が求められ、導入に伴って基盤となるアプリケーションアーキテクチャの変更が必要になる可能性もあります。開発者は、スキーマ、リゾルバー、型などの新しい概念に加え、新しいツールやライブラリを習得しなければならない場合があります。GraphQLでは、クライアントがアクセスできるデータをより細かく制御できるため、APIのセキュリティ確保が難しくなる可能性があります。入力検証、認証、認可などの手法も、RESTful APIとは異なる方法で適用する必要が生じる場合があります。
- キャッシュ:GraphQLでは、クライアントがクエリごとに異なるデータをリクエストできるため、レスポンスのキャッシュと再利用が難しくなり、キャッシュ処理が複雑になる場合があります。
- パフォーマンス:GraphQLでは、クライアントが必要なデータのみをリクエストできる一方で、より複雑でリソース消費の多いクエリも実行可能になります。GraphQL APIでは、特に大規模なデータセットを照会する場合や、多数の同時リクエストが発生する場合に、パフォーマンス上の問題が生じる可能性があります。開発者は、クエリの深さを制限する、必要な特定のデータのみにクライアントのアクセスを許可するといった対策を講じる必要があります。
- エラー処理:GraphQLでは、エラーが個別のHTTPステータスコードではなくレスポンスの一部として返される場合があるため、エラー処理が複雑になる可能性があります。
- テスト:GraphQLのテストには、クエリの複雑さ、標準化されたテスト手法の欠如、スキーマの進化、実行時のクエリ検証などの課題があります。こうした課題に対処するには、適切なテストフレームワークやツールの選定に時間をかける必要があります。GraphQL APIを効果的にテストし、その機能と安定性を確保するには、適切なツールを選定し、スキーマの進化を考慮して、包括的なテストカバレッジを確保する必要があります。
- 監視:GraphQL APIの監視には、クエリの複雑さ、標準化されたログとメトリクスの欠如、パフォーマンス上の問題が発生する可能性があることから、課題が伴う場合があります。GraphQLクエリは動的であるため、リクエストされるデータの構造やサイズを予測して監視することが難しくなります。また、GraphQL API専用の標準化された監視ツールがないため、GraphQLクエリのパフォーマンス、エラー追跡、APIの健全性に関するインサイトを得ることも困難です。効率的なパフォーマンスと信頼性の高い運用を確保するには、GraphQL固有の特性に対応できる専用の監視ツールと手法を導入する必要があります。
GraphQLの利用パターン
GraphQLは、APIの構築からモバイルアプリの基盤まで、幅広い用途に活用できる強力なツールです。柔軟性に優れ、データソースを統合できるため、さまざまな利用パターンに適しています。
- 効率的なAPIの構築:GraphQLの主な用途の1つは、Webアプリケーションやモバイルアプリケーションから利用できるAPIを構築することです。GraphQLでは、データを柔軟かつ強力な方法で定義し、アクセスできるため、幅広いクライアントやユースケースに対応する必要があるAPIの構築に適しています。
- データの取得と操作:GraphQLを使用すると、データベース、クラウドサービス、その他のAPIなど、さまざまなソースからデータを取得して操作できます。データにアクセスするための統一された方法を提供することで、GraphQLはデータ駆動型アプリケーションの構築と保守を簡素化するのに役立ちます。
- リアルタイムのユースケース:GraphQLはリアルタイムのユースケースに適しています。クライアントは特定のデータの更新をサブスクライブし、データが変更されたときに通知を受け取ることができます。チャット、ライブストリーミング、リアルタイムダッシュボードなどのアプリケーションで利用できます。
- マイクロサービス:GraphQLを使用すると、異なるマイクロサービス間で一貫性のある明確に定義された方法で通信できる、柔軟で疎結合なアーキテクチャを構築できます。
- バックエンドからフロントエンドへ:GraphQLを使用してバックエンドフォーフロントエンド(BFF)アーキテクチャを構築することで、さまざまなフロントエンドクライアントが一貫性のある効率的な方法でデータやサービスにアクセスできるようになります。
- モバイル開発:GraphQLを使用すると、プラットフォームやデバイスを問わず、一貫性のある効率的な方法でデータやサービスにアクセスできるため、モバイルアプリを動作させることができます。
業界におけるGraphQL導入事例
以下の業界での導入事例からもわかるように、GraphQLが必要とされる理由は明らかです。
NETFLIX
Netflixは、GraphQLへの取り組みをまとめ、2020年に2部構成のブログシリーズとして公開しました。これは、GraphQLに携わるすべての方にとって必読の内容です。そこで紹介された事例は、Studio Edgeシステムです。これは、同社のスタジオAPIをGraphQL向けに再設計したものです。NetflixのStudio APIは、コンテンツチームがテレビ番組や映画の制作、ポストプロダクション、配信を管理・監視するために使用されています。このAPIでは、作品のメタデータや出演者・制作者に関する情報など、膨大なデータにアクセスできます。
当初、Studio APIは従来型のRESTfulアーキテクチャを使用して構築され、各エンドポイントはJSON形式でデータを返していました。しかし、APIの規模が拡大し、アクセスするクライアント数が増えるにつれて、より効率的なソリューションが必要であることが明らかになりました。
Netflixは、Studio APIの有力なソリューションとしてGraphQLの検討を開始しました。まず、Studio API向けに厳選されたグラフを構築しました。その結果、クライアントが必要なデータのみをリクエストできるため、ネットワーク使用量の削減、データアクセスの簡素化、パフォーマンスの向上など、いくつかの主なメリットが明らかになりました。
Netflixは、Studio APIにGraphQLを採用する際、特有の課題にも直面しました。特に、スキーマの複雑さを管理することや、クライアントがアクセス権限を持つデータのみにアクセスできるようにすることが課題となりました。
これらの課題に対処するため、Netflixは「Netflix GraphQL Federation」というカスタムソリューションを開発しました。このソリューションでは、Apollo Federation仕様を使用してStudio APIのスキーマを、より小さく管理しやすい単位に分割します。また、権限とアクセス制御を管理するシステムも実装し、クライアントがアクセスできるスキーマの範囲を制限できるようにしました。
同社はブログで、モノリスからフェデレーテッドゲートウェイに至るAPIアーキテクチャの変遷も公開しています。図5は、そのブログに掲載された図を基に作成したものです。
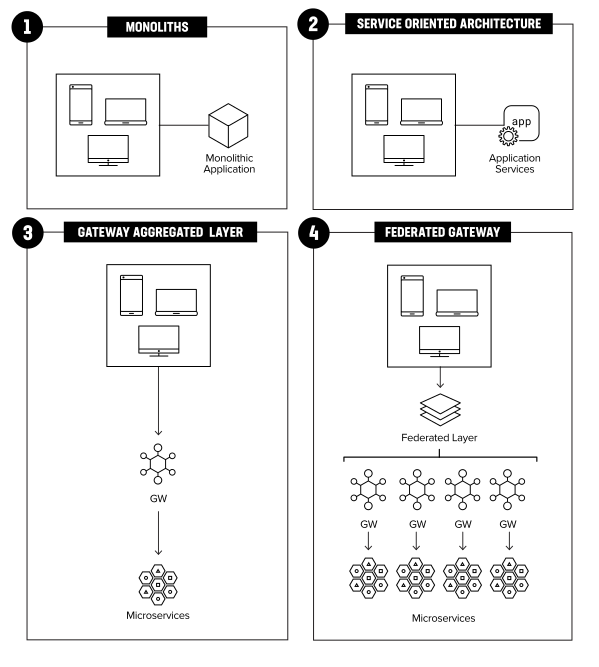
業界では広く採用されている可能性があるものの、まだ体系化されていない別のアプローチがあると考えています。
図5のゲートウェイ集約レイヤーとフェデレーテッドゲートウェイは、以下のように組み合わせることができます。
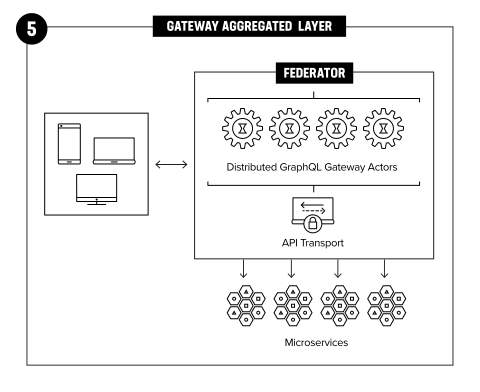
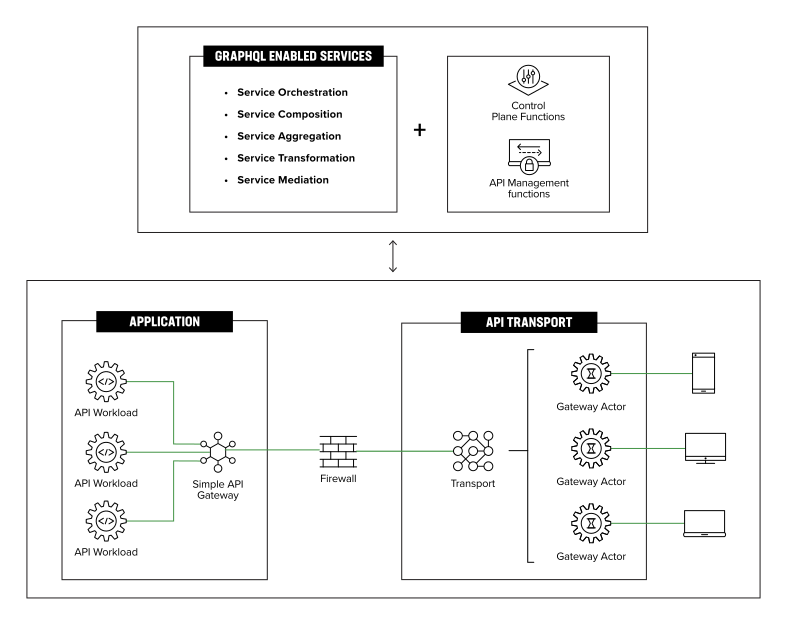
各歯車アイコンは、基本的に一時的なフェデレーションGraphQLインスタンス(別名ゲートウェイアクター)を表します。このインスタンスは、クライアントにトポロジー上近いエッジで、トランザクション単位を含めリアルタイムにインスタンス化でき、セキュアなAPIトランスポートを介してマイクロサービスに接続できます。この組み合わせにより、ゲートウェイ集約レイヤー(フェデレーションレイヤー)は、両方の機能の長所を兼ね備えた分散ゲートウェイアクターに実質的に置き換えられます。これを「分散GraphQLゲートウェイアクターアーキテクチャ」と呼びます(図7)。
その他の早期導入企業
PayPal
PayPalは、CheckoutアプリにGraphQLを導入した2018年から、GraphQLへの取り組みを続けています。RESTに関する主な懸念は、Metaと同様に、その設計原則がWebアプリやモバイルアプリ、およびそのユーザー向けに最適化されていないことでした。クライアントアプリケーションでは、クライアントとサーバー間で何度も往復通信が発生し、データの取得に約700 msかかっていました。その結果、レンダリング時間が長くなり、ユーザーの不満やコンバージョン率の低下につながっていました。PayPalはCheckoutアプリについて、ユーザーインターフェース(UI)開発者がUIの構築に費やす時間は全体の3分の1未満で、残りの時間はデータの取得方法や処理方法の検討に費やされていることを明らかにしました。
PayPalのエンジニアリングチームは、ほかにもオーケストレーションAPIとBulk RESTを検討しました。オーケストレーションAPIを構築すると、データの過剰取得が発生し、クライアントがサーバーに密結合することになります。PayPalは、このアプローチを長期的に採用すると、APIが肥大化して扱いにくくなり、複数の目的を担う可能性があると判断しました。Bulk RESTの試みも成功しませんでした。エンジニアリングチームはオーケストレーションAPIを調整する必要がなくなったものの、クライアント側ではAPIの仕組みを詳細に把握する必要がありました。
PayPalが新製品の開発にGraphQLを初めて使用したのは、PayPal Checkoutをアプリに統合するためのモバイルSDKでした。GraphQLの評価開始から1週間以内に、エンジニアリングチームは新製品への採用を決定しました。APIがまだ完成していなかったにもかかわらず、PayPal固有の知識をほとんど必要とせず、予定より早く製品を完成させることができました。開発者が効率的で使いやすいアプリを短期間で構築できたことから、エンジニアリングチームはGraphQLを自社のテクノロジースタックに全面的に採用することを決定しました。
Starbucks
Starbucksは、自社のプログレッシブウェブアプリ(PWA)の開発をサードパーティに委託しました。
チームには、複雑なビジネスロジックに効率的かつ効果的に対応できる注文システムの構築が求められました。顧客が注文内容をカスタマイズできるため、開発チームは、複数の固有のビジネスロジックに対応し、適切なデータを適切なタイミングで適切な場所に送信できるようにする必要がありました。
GraphQLにより、チームはサーバーサイドのキャッシュとレンダリングを備えた効率的なAPIを構築し、オフライン機能を向上させることができました。また、Reactを使用してアニメーションを組み込み、動的で魅力的なユーザー体験を実現しました。
F5におけるGraphQL
F5 Office of the CTOでは、F5エコシステム内でGraphQLをどのように活用できるかを把握することを目指しました。現在、GraphQLの活用を検討する2つのプロジェクトを進めています。
データモデルと可視性の向上
F5が提供するテスト管理スイート(TMS)を使用すると、自社システムのエンドポイントやクライアントをテストし、人間かボットかを確認できます。
これは、TMSソフトウェアの開発とテストの効率化を支援する社内向けプロジェクトでした。主な目標は、既存のSQLデータベースに格納されていたJSONデータを抽出してグラフデータに変換し、クエリ用のGraphQL APIを実装することでした。
これが必要だったのは、現在のデータベースに、メタデータを表形式データベース内のJSONオブジェクトとして保存することで生じる「JSON blob問題」などの課題があるためです。こうしたオブジェクトの解析と処理には、本質的に多くのコストがかかり、非効率です。さらに、JSON blobはグラフ構造を持つため、F5の製品とセキュリティをさらに向上させるうえで有用なデータを含んでいます。有向グラフデータベースに移行することで、JSON blobを効率的に解析し、有向関係を用いて管理できるようになり、データの転送と活用を最適化できます。
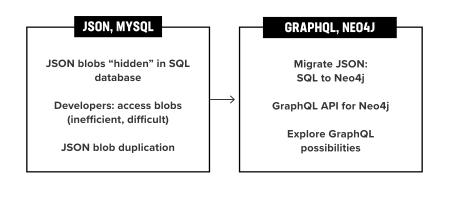
有望な結果が得られました。TMSのリレーショナルデータベース内でJSON blobを含むテーブルを特定した結果、GraphDBへ移行してGraphQLを使用することで、システムの可視性を数倍に高められる可能性があると判断しました。
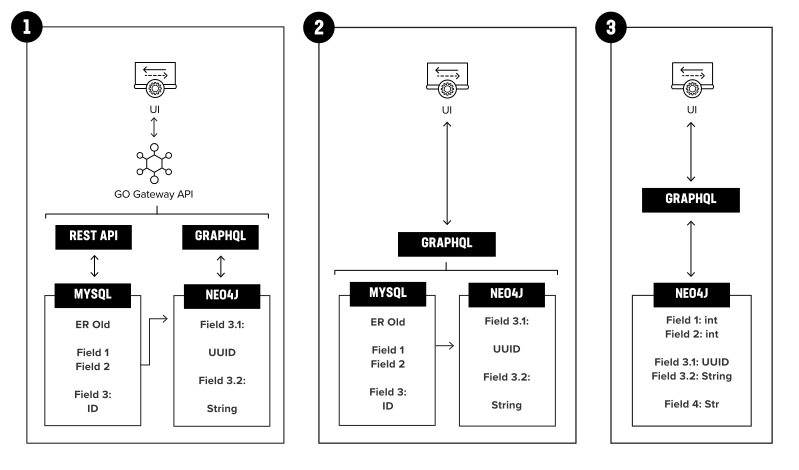
図9は、このプロジェクトで考えられる発展の方向性または実装の選択肢を示しています。各選択肢には、それぞれ異なる影響があります。
オプション1ではクライアントを変更する必要がないため、UIへの影響が最も小さくなります。オプション1または2のようなハイブリッドモードは、状況によっては適切に機能する可能性があります。特に、JSONオブジェクトを含む列の数が少ない場合に有効です。また、各JSONから導出されるスキーマも小さくなります。
しかし、計画を進める中で、JSONオブジェクトにはSQLデータベースの別の列に格納されているコンテキストが必要であることが分かりました。また、各JSONオブジェクトに格納されるスキーマもかなり大きく、コードベースの保守作業が増える可能性がありました。そのため、慎重に検討した結果、オプション3に示すように、GraphQLとNeo4Jをサポートするようアプリケーションのアーキテクチャを再設計することにしました。
CLOUDGRAPHとの統合
CloudGraphは、AWS、Azure、GCP、Kubernetes(K8s)に対応する、無料のオープンソースの汎用GraphQL APIおよびクラウドセキュリティ態勢管理(CSPM)ツールです。このプロジェクトの目的は、CloudGraphを使用して「CloudGraphプラグイン」(図10)を構築し、F5 Distributed Cloud(F5XC)のデータをCloudGraph上に表示することで、F5 Distributed Cloudを使用して接続されたクラウドリソースの可視性を高めることです。
F5XCデータ向けのCloudGraph連携、インサイト、GraphQL APIを今後構築できるよう、CloudGraphとの統合を通じて、そのテクノロジーへの理解を深めることを目指しています。
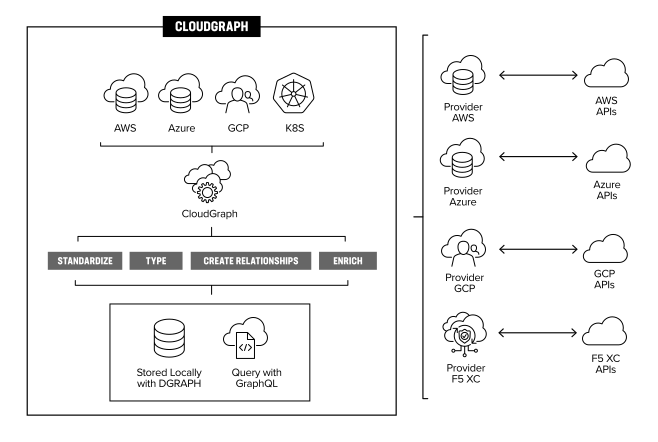
カスタムF5XCプロバイダーをCloudGraphプラットフォームに統合し、同プラットフォームの関係作成機能を使用することで、F5XCを使用して接続されたクラウドリソースと、他のクラウドにまたがるそれらの関係をより明確に把握できるようになります。その後、同一テナントの複数のクラウドにまたがるリソースに対して、複雑なクエリを生成できます。これにより、関係者にF5XCの包括的な概要を提供できるほか、追加のGraphQLプラグインや、F5とそのお客さまに関連するクラウド運用向けのカスタムインサイトを実現するため、CloudGraphとのさらなる統合を検討できるようになります。
上記の取り組みに基づく初期調査では、先に紹介したケーススタディに示された事例と同様の結果が得られています。
GraphQLのセキュリティ上の懸念
当初、GraphQLはセキュリティ面でRESTより優れていると考えられていましたが、この見方は誤りであることが明らかになっています。GraphQLも他のテクノロジーと同様に、適切に実装しなければ固有のリスクを伴います。GraphQLが本質的に他のテクノロジーより安全というわけではないことを認識することが重要です。GraphQL APIのセキュリティを確保するには、適切な実装とベストプラクティスの遵守が不可欠です。この誤解を解くことで、GraphQLのセキュリティ上の考慮事項を現実的に理解し、潜在的なリスクを軽減するための適切な対策を講じることができます。
イントロスペクション攻撃
GraphQLには、イントロスペクションと呼ばれる強力なツールが用意されています。開発者はこれを使用して、GraphQLサービスで使用されているスキーマに関する情報をリクエストし、サービスとその構造を把握できます。ただし、イントロスペクションにはリスクも伴います。本番環境のGraphQLサービスでイントロスペクションを有効にすると、スキーマ内の機密情報にもアクセスできるようになります。悪意のあるユーザーがイントロスペクションを悪用して機密データを取得し、損害をもたらす可能性があるため、これは重大なリスクとなります。さらに、悪意のあるユーザーはスキーマ全体を参照して実行するクエリを判断できるため、害を及ぼす可能性のある操作を容易に特定できます。このような情報漏えいがもたらす影響は、スキーマの性質やそこに含まれるデータによっては甚大なものになり得ます。
緩和策:イントロスペクションのリスクを緩和する方法の1つは、各種フレームワークを使用して本番APIでイントロスペクションを無効にすることです。イントロスペクションを無効にすると、開発者はその便利な機能の一部を利用できなくなります。ただし、利便性を取り戻すために、GraphOSなどのツールに本番APIのGraphQLスキーマを登録できます。これにより、スキーマとその情報へのアクセスを制御しながら維持できます。
SQLインジェクション
SQLインジェクションは、広く知られた一般的な攻撃であり、データの改ざんからデータベース全体の削除に至るまで、さまざまなリスクをもたらします。この単純な攻撃は文字列連結を悪用し、入力値に実行可能なコードを挿入することで、データベースへの不正アクセスや悪意のある変更を可能にします。注目すべき点として、この攻撃ベクトルはSQLデータベースに限らず、Neo4jのようなグラフデータベースにも影響を及ぼす可能性があります。Neo4jでは、SQLに似たCypherクエリ言語が使用されており、SQLと同様の脆弱性を抱えています。Cypherインジェクションと呼ばれるこの攻撃は、両言語の類似性を悪用する一方で、既存の対策を活用できるため、新たな対策を一から考案する必要はありません。
緩和策:対策としては、ユーザー入力をサニタイズして悪用を検知・防止することや、パラメーター化によってユーザー入力をクエリの直接生成から分離することが挙げられます。これらの対策により、インジェクション攻撃のリスクを効果的に軽減できます。GraphQLの実装では、このセキュリティ上の問題への対処が不可欠ですが、幸い、広く知られた容易に実装できる解決策があります。
RESTプロキシAPI攻撃
REST APIの上にGraphQL APIを重ねると、サーバーサイドリクエストフォージェリ(SSRF)の脆弱性が生じる可能性があります。攻撃者は、GraphQLプロキシ経由でREST APIに送信されるパラメーターを変更し、この脆弱性を悪用できます。どちらのAPIも特定の呼び出しに対してパラメーターを検証しない場合、攻撃者にバックエンドシステムを制御されるおそれがあります。たとえば、GraphQLクエリ内のユーザーIDに「/delete」を追加すると、その値がREST APIに渡された際に、意図せずデータが削除される可能性があります。
緩和策:この脆弱性は正当に懸念すべきものですが、GraphQLスキーマで型を定義し、外部のAPIやサービスに送信する前にパラメーターを徹底的に検証することで、効果的に対処できます。この脆弱性をはじめとするGraphQL関連の脆弱性は、GraphQL自体に内在する問題ではなく、実装上の問題に起因する点に留意することが重要です。このような問題は、GraphQLが大きな可能性を秘めた技術であるにもかかわらず、短期的な考え方によって誤用された場合に生じます。
バッチ処理攻撃
認証の脆弱性は、GraphQLを含むさまざまなシステムで広く悪用されている攻撃経路です。GraphQLでは、1回のリクエストで複数のクエリやミューテーションを送信できるため、ブルートフォース手法を用いるバッチ攻撃にさらされる可能性があります。
1つ目の攻撃は、ログインパスワードに対するブルートフォース攻撃です。攻撃者は、ログイン認証情報のペアを含む多数のミューテーションを1つのリクエストで送信します。GraphQLでは1つのリクエストで多数のミューテーションを実行できるため、この攻撃はレート制限のチェックを回避し、パスワードへのブルートフォース攻撃によってセッションを作成できるようにします。
2つ目の攻撃も同様の仕組みですが、ワンタイムパスワード(OTP)と呼ばれる一般的な二要素認証(2FA)方式を標的とします。1つのリクエストで複数のミューテーションを送信し、それぞれに有効なログイン認証情報と異なるOTPの候補を組み合わせます。いずれかのミューテーションに正しいOTPが含まれていると、リクエストが認証され、セッションが確立されます。
緩和策:これらの脆弱性には万全な解決策がないため、包括的なアプローチが必要です。開発者は、セキュアコーディングの実践を取り入れ、ビジネスロジックの観点を重視することで、重要な役割を果たします。Webサーバー側では、ログイン試行回数の制限やユーザー入力の検証などの対策が不可欠です。また、正当なログイン試行では通常、複数のミューテーションが含まれることはないため、リクエストに複数のミューテーションが含まれていないかをスキャンすることにも、特に注意を払う必要があります。
サービス拒否攻撃
これらの攻撃では、GraphQLサービスに過剰なトラフィックを集中させ、正規ユーザーからのリクエストを処理できない状態にし、サーバーをクラッシュさせる可能性があります。DoS攻撃は、再帰的なGraphQLクエリを実行するか、大規模なクエリリクエストを送信することで行われます。
再帰クエリのシナリオでは、攻撃者はGraphQLスキーマ定義の循環的な性質を悪用します。たとえば、スキーマに著者型と書籍型が含まれている場合、攻撃者は著者と書籍をループ内で繰り返しクエリし、サーバーに大量の再帰呼び出しを発生させて、その動作を妨害する可能性があります。
また、攻撃者はデータベースに大量のデータを要求するクエリを発行することもできます。たとえば、多数の著者と、それぞれに関連付けられたすべての書籍を取得するクエリが考えられます。このような大規模なデータ要求により、システムの動作が著しく遅くなったり、システムがクラッシュしたりする可能性があります。
緩和策:この問題を緩和する方法はいくつかあります。1つ目は、クエリにタイムアウトを設定し、指定した時間を超えるリクエストをユーザーが実行できないようにする方法です。ただし、割り当てられた時間内でも被害が発生する可能性があるため、これだけでは問題を完全に解決できない場合があります。もう1つは、クエリの深さと複雑さに制限を設ける方法です。指定された深さまたは複雑さを超え、スキーマの定義から逸脱するクエリは拒否できます。最後に、ユーザー単位のスロットリングも有効です。ユーザーが大量のリクエストや連続したリクエストを送信した場合、サーバーが追加のリクエストを処理できる状態になるまで、そのユーザーによるサーバーへのアクセスを一時的に拒否できます。
GraphQLのデプロイパターン
図に示すように、GraphQLには複数の「デプロイパターン」があり、それぞれにトレードオフと考慮事項があります。代表的なパターンは次のとおりです。
モノリシックデプロイ
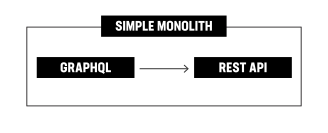
これは、GraphQL APIをデプロイするための最もシンプルで一般的なパターンです。モノリシックデプロイメントでは、GraphQLサーバー、データベース、その他の必要なサービスをすべて単一のユニットとしてまとめてデプロイします。この方法ではGraphQLを容易に導入できますが、アプリケーションの成長に伴い、スケーリングや保守が難しくなる可能性があります。
複合モノリス
コンポーズドモノリスとは、GraphQLをAPIレイヤーとして使用し、モノリスとマイクロサービスを組み合わせてモノリシックアプリケーションを構築するアーキテクチャを指します(図12)。このパターンでは、システム全体を個別のマイクロサービスに分割するのではなく、まず、すべてのビジネスロジックとデータアクセスレイヤーをカプセル化した複数の独立したモノリスとしてアプリケーションを開発します。
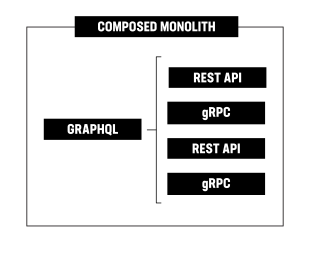
このモノリシック構造では、GraphQLがAPIレイヤーとして実装されており、クライアントは基盤となるさまざまなマイクロサービスにデータをリクエストし、取得できます。つまり、このアプリケーションはデプロイの観点ではモノリシックなままですが、GraphQLを使用して各種サービスのデータを統合し、柔軟かつ効率的な方法でクライアントに提供します。
このパターンには、開発とデプロイを簡素化できるほか、GraphQLの強力なクエリ機能とデータ取得機能を活用できるというメリットがあります。開発者は、GraphQLがもたらす柔軟性と使いやすさを活かしながら、マイクロサービスアーキテクチャを段階的に導入できます。
フェデレーションされたサブグラフ
GraphQLのデプロイパターンにおけるフェデレーテッドグラフでは、サブグラフと呼ばれる複数のGraphQLサービスを、単一の統合GraphQLスキーマにまとめます。各サブグラフは、独自のデータと機能を持つ個別のドメインまたはマイクロサービスを表します。このアーキテクチャでは、中央のゲートウェイが、リクエストされたフィールドに基づいてクライアントのクエリを適切なサブグラフにルーティングします。これらのサブグラフをフェデレーションすることで、開発者は、クライアントが異なるサービス間をシームレスに横断してクエリできる一体的なグラフを構築できます。
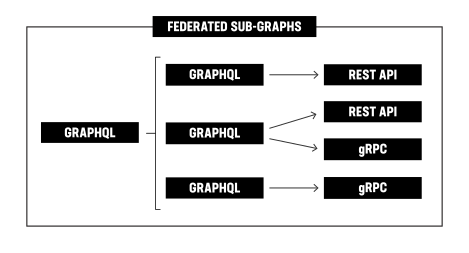
このアプローチは、モジュール性とスケーラビリティを高め、サービスの独立した開発を促進することで、GraphQL APIの構築におけるパフォーマンスと柔軟性を向上させます。フェデレーションサブグラフ(図13)を使用すると、さまざまなサービスのデータを効果的に統合し、分散型でスケーラブルなアーキテクチャを構築できます。
ハイブリッドグラフ
GraphQLのデプロイパターンにおけるハイブリッドグラフ(図14)は、スティッチング技術を使用して、フェデレーション対応のサブグラフと非フェデレーションスキーマを組み合わせます。このアプローチにより、既存のGraphQL APIやレガシーシステムをフェデレーション対応のマイクロサービスと統合し、両方のアプローチの利点を備えた統一GraphQL APIを構築できます。ハイブリッドグラフアーキテクチャは、スキーマをマージし、型とフィールド間の関係を解決することで、柔軟性、モジュール性、スケーラビリティを実現します。
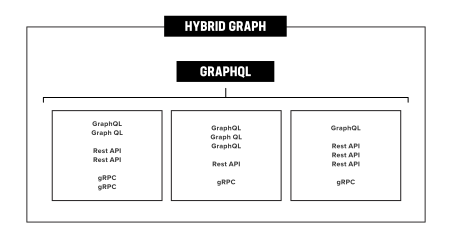
ハイブリッドグラフパターンにより、組織は既存のリソースを活用しながら、フェデレーションを段階的に導入できます。フェデレーション対応のサブグラフと非フェデレーションスキーマをシームレスに統合できるため、多様な要件に対応し、相互運用性を高められます。このアプローチにより、変化するニーズに応じて拡張および適応できる包括的なGraphQL APIを構築できます。ハイブリッドグラフは、フェデレーションサービスと非フェデレーションサービス双方の強みを組み合わせることで、GraphQL環境を構築するための柔軟かつ強力なソリューションを提供します。
GraphQLデプロイメントにおけるハイブリッドグラフの課題には、統合されたスキーマの複雑さの管理、潜在的なパフォーマンスオーバーヘッドへの対処、データの一貫性と整合性の確保、システムの進化とバージョン管理への対応、分散アーキテクチャにおける監視とデバッグの複雑さへの対処などがあります。こうした課題を克服し、ハイブリッドグラフのデプロイメントを円滑に運用するには、入念な計画と最適化、堅牢な開発プラクティスが必要です。
サーバーレスルーティング
このパターンでは、GraphQL APIをAWS LambdaやGoogle Cloud Functionsなどのサーバーレス関数群としてデプロイします。GraphQL APIをコスト効率と拡張性に優れた方法でデプロイできる一方、レイテンシーが増加し、アーキテクチャが複雑になる可能性もあります。
サーバーレスルーティングには多くの課題があります。その1つは、アプリケーションの拡大に伴い、分散したサブグラフをシームレスに接続することです。複数のチームとデプロイメントの調整は複雑になりやすく、サブグラフを効果的に管理、拡張することが難しくなります。サブグラフ間でデータの一貫性と同期を確保することも課題です。分散型サーバーレス環境では、監視とデバッグがより困難になる可能性があるため、適切なログ記録とエラー処理の仕組みが必要です。さらに、複数のサーバーレス関数とサブグラフにまたがるアクセス制御と認可の管理にも課題があります。サーバーレスベースのGraphQLデプロイメントを円滑に運用し、拡張性を確保するには、これらの課題への対処が不可欠です。
エッジデプロイメント
GraphQL APIのエッジデプロイパターンでは、CDNサービスを使用してAPIをクライアントの近くに配置します。これにより、レイテンシの低減による応答の高速化、オリジンサーバーの負荷軽減、DDoS攻撃からの保護など、複数のメリットが得られます。
APIインフラストラクチャを世界各地のエッジサーバーに分散することで、トラフィックをより効率的に処理し、世界中のユーザーにより優れたエクスペリエンスを提供できます。CDNのキャッシュ機能とフィルタリング機能は、スケーラビリティの向上に役立ち、大量のトラフィックや悪意のある攻撃を受けた場合でもAPIの可用性を確保します。エッジデプロイメントでは、CDNのサーバーネットワークを活用することで、APIのパフォーマンスと信頼性を最適化できる可能性があります。
まとめ
GraphQLテクノロジーは、従来型の企業にも採用されるほど成熟しています。Gartnerの「Hype Cycle for APIs 2022」によると、広く普及するまでにはまだ数年かかるものの、必要なツールがすでに整った重要な転換点を迎えています。GraphQLはまだ比較的新しいテクノロジーですが、実績ある大規模企業のニーズに対応できる段階まで進化しています。
GraphAPIテクノロジーの成熟は、GraphQLやその他のグラフデータベース技術を導入する企業の増加に支えられています。導入企業が増えるにつれて、これらの技術を支えるために必要なツールやリソースも充実し、他の企業も導入しやすくなっています。さらに、データクエリの改善や複雑さの軽減といったGraphAPIテクノロジーのメリットが広く認識されるようになり、企業での導入が一層進んでいます。
業界全体として、GraphQLなどのGraphAPIテクノロジーの重要性と、RESTの限界を克服し得る可能性を認識する必要があります。企業は、特にデータモデリング、多様性、不透明性の観点から、GraphQLへの投資と理解を早急に進める必要性を見過ごしてはなりません。GraphQLの機能や可能性に目を奪われがちですが、過度な期待がピークに達した後、「幻滅期」に陥る可能性も認識する必要があります。ベンダーは、GraphQLを全面的にサポートできるよう製品の強化を優先する必要があります。一方、ベンダーを含む企業のIT部門は、生産性向上のために、GraphQLを介した公開が有効なデータを特定する必要があります。
お客さまは、自社のデータを理解することを最優先し、一般的な企業の運用形態はGraphQLを最初に導入したハイパースケーラーとは異なることを認識する必要があります。GraphQLを効果的なソフトウェアアーキテクチャパターンとして活用し、生産性の向上とイノベーションに向けて業界をともに前進させましょう。