Antigamente, os serviços responsáveis pela entrega de aplicações formavam um caminho de dados direto e bem definido. Basicamente, todas as aplicações passavam pelo mesmo conjunto de serviços na mesma rede. Essa simplicidade arquitetônica facilitava a combinação de um único ponto de controle com um único ponto de execução. Isso, por sua vez, levou ao surgimento do controlador de entrega de aplicações (ADC). Por meio dele, o tráfego das aplicações podia ser moldado, direcionado, dimensionado e protegido — tudo em um só lugar. A combinação entre controle e execução proporcionava às equipes de operações um ponto estratégico no caminho de dados, no qual todo tipo de política podia ser aplicado e executado.
A ascensão da nuvem e a adoção contínua de contêineres transformaram esse caminho de dados. Agora, temos vários caminhos de dados, por vezes dinâmicos, pelos quais os aplicativos são entregues. Muitas vezes, um único ponto estratégico de controle e execução deixou de ser viável do ponto de vista operacional ou arquitetônico.
Mas isso não significa que um ponto unificado de controle não seja mais possível, mesmo quando a execução é delegada a um conjunto diversificado de serviços de aplicações.
É importante ter o menor número possível de pontos de controle por meio dos quais os serviços de aplicações no caminho de dados possam ser operados (implantados, configurados e gerenciados). Incentivar o uso de vários pontos de controle inevitavelmente resulta em políticas conflitantes que causam problemas para os consumidores das aplicações. A solução de problemas se torna mais complexa e demorada, aumentando a irritação e a ansiedade dos usuários. Infelizmente, a proliferação de ferramentas é uma reclamação comum entre aqueles que gerenciam a incorporação de arquiteturas nativas da nuvem a um portfólio de aplicações já diversificado.
Sabemos, com base em nossa pesquisa State of App Services de 2020, que a equipe de operações é a principal responsável pela operação dos serviços de aplicativos, mas não está sozinha. As equipes de DevOps, NetOps e SecOps também estão envolvidas na operação dos serviços de aplicativos, tanto no ambiente local quanto na nuvem pública.
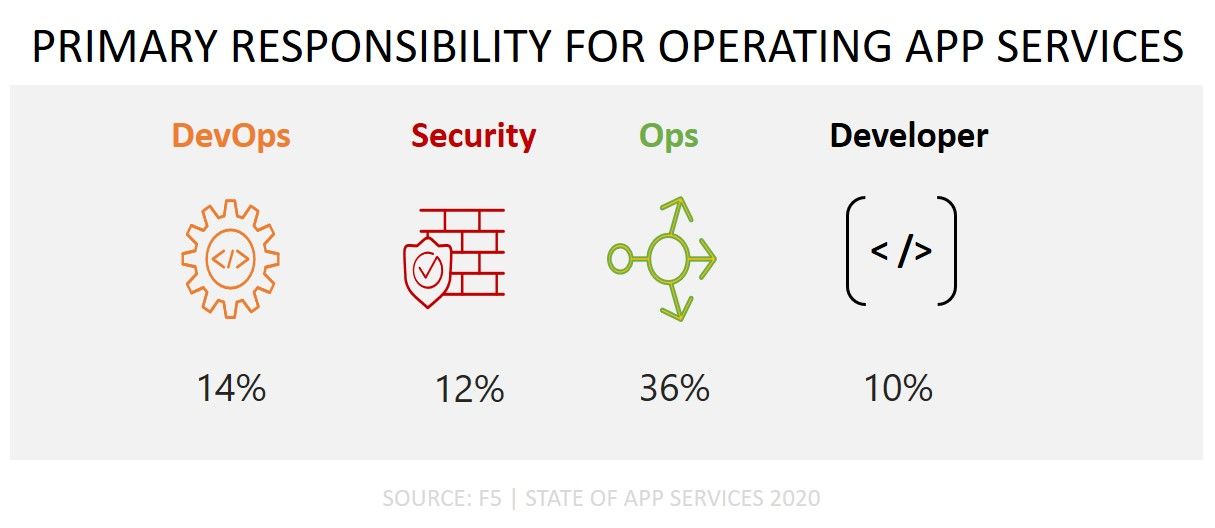
O que geralmente os diferencia são as funções específicas dos serviços de aplicativos pelas quais são responsáveis.
As equipes de DevOps são, em grande parte, responsáveis pela confiabilidade, pelo desempenho e pelas políticas específicas do aplicativo. Já as equipes de NetOps, como o próprio nome sugere, concentram-se mais nos atributos da rede. Em geral, são elas que mantêm os serviços do aplicativo sob a perspectiva da infraestrutura. As equipes de SecOps, por sua vez, cuidam da segurança relacionada à infraestrutura e ao aplicativo.
Mas o simples fato de haver uma divisão de responsabilidades não significa que devam existir ferramentas separadas para que cada equipe desempenhe suas funções. Hoje, há evidências de sobra de que os pipelines de CI/CD e de implantação contínua são criados com conjuntos de ferramentas distintos. Jenkins e repositórios git predominam no pipeline de CI/CD, enquanto Ansible e Python são as ferramentas preferidas para a implantação contínua. Grande parte da decisão consiste em adequar o conjunto de ferramentas às formas de trabalho dos diversos envolvidos que precisam interagir diariamente com elas.
Portanto, caso surja uma única ferramenta capaz de melhorar a consistência das políticas, agilizar a solução de problemas e eliminar a complexidade e o custo decorrentes da proliferação de ferramentas, ela deverá contar com as interfaces adequadas para garantir que todos os principais envolvidos nos serviços de aplicativos no caminho de dados possam utilizar o conjunto de ferramentas para desempenhar suas respectivas funções.
Isso é importante para a segurança e a confiabilidade gerais dos próprios serviços de aplicativos. Ao manter um ponto de controle unificado, as organizações podem ter a certeza de que as alterações são rastreadas e compreendidas. Embora não seja uma implementação imutável, ela dá vários passos nessa direção ao centralizar o controle em uma única ferramenta.
Um exemplo desse tipo de ferramenta é o NGINX Controller.
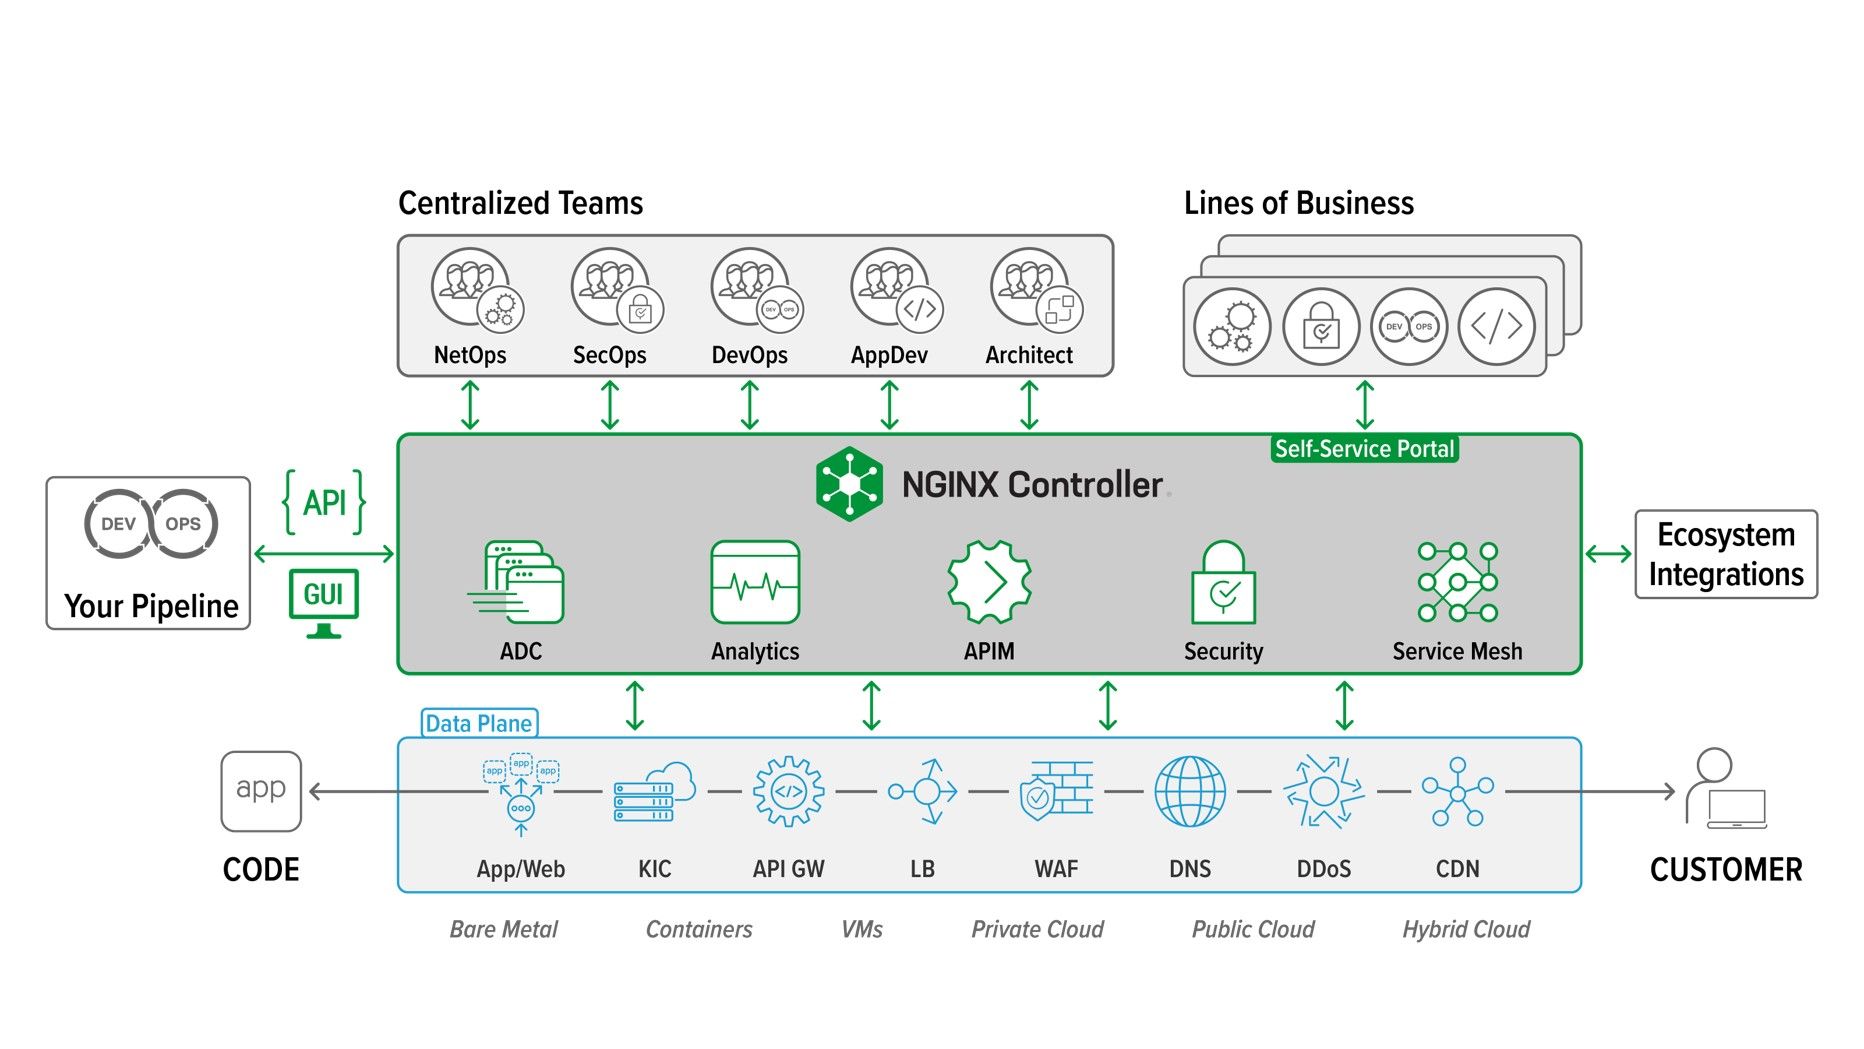
Você observará que, conforme previsto, diversos serviços de aplicativos (análise de dados, gerenciamento de APIs, segurança e malha de serviços) podem ser controlados de forma centralizada, embora a operação e a execução sejam distribuídas.
Em qualquer ambiente, é importante reduzir o número de ferramentas autorizadas a interagir com os componentes do caminho de dados (serviços de aplicativos) para mitigar possíveis problemas decorrentes de configurações incorretas ou conflitantes. Em um ambiente moderno e multinuvem, centralizar o controle é ainda mais essencial devido à complexidade gerada pelo crescimento, muitas vezes exponencial, dos serviços de aplicativos que compõem o caminho de dados.
Mais atraente para os responsáveis pelos orçamentos é a redução das despesas operacionais proporcionada pela automação, que elimina atividades manuais e repetitivas.
Unificar o controle em uma única ferramenta é uma forma de fazer isso.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...