Engenheiro de Confiabilidade de Sites (SRE) é uma função relativamente nova — geralmente dentro das áreas de engenharia ou operações — voltada, como era de se esperar, à manutenção da confiabilidade dos sites. Em geral, isso significa garantir a disponibilidade das aplicações, mas também inclui o desempenho. Isso faz sentido, pois, atualmente, a maioria dos usuários finais considera indisponíveis as aplicações que não respondem.
Ao analisar o Relatório de SRE de 2018 da Catchpoint, fiquei impressionado com os gráficos que comparavam indicadores de nível de serviço e métricas de SRE. Normalmente, quando “disponibilidade” aparece como um indicador de nível de serviço de alto nível, “tempo de atividade” ou “tempo de inatividade” também aparece como métrica. Mas esse não foi o caso dos SREs desta pesquisa.
Quando questionados sobre quais indicadores de nível de serviço eram mais importantes para seus serviços, uma esmagadora maioria de 84% apontou a “disponibilidade para o usuário final” como o principal. A latência ficou em segundo lugar, com 61%, e a taxa de erros veio logo atrás, em terceiro, com 60%. O desempenho — descrito no relatório como o tempo de resposta para o usuário final — recebeu expressivos 58% das respostas.
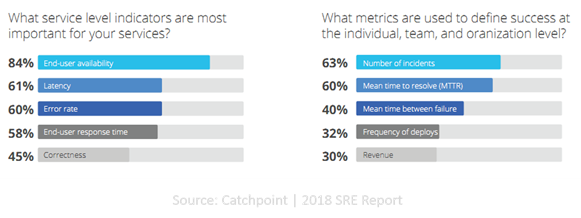
Agora, observe as métricas usadas para definir o sucesso. No mundo da infraestrutura e das operações, estamos mais acostumados a ver métricas como “tempo de atividade” e expressões marcantes como “cinco noves”.
Os SREs, por sua vez, tendem a avaliar o sucesso com base nas taxas de incidentes e no MTTR. Considerando que o mesmo relatório apontou que 41% dos SREs atuavam como “engenheiros de DevOps” antes de se tornarem SREs, isso não deveria ser uma surpresa. O próprio DevOps se preocupa mais com o MTTR do que com o cálculo do tempo de atividade, pois parte-se do pressuposto de que haverá indisponibilidade. O segredo é minimizá-la, resolvendo-a rapidamente, em vez de perder tempo tentando evitá-la por completo.
Ainda assim, leitores atentos perceberão que, ao minimizar o MTTR, você também minimiza o tempo de inatividade. Quanto mais rápida a resolução, menor o tempo de inatividade.
A diferença sutil entre os dois é que os seres humanos tendem a otimizar aquilo pelo qual são avaliados. Se você for avaliado pela quantidade de linhas de código, escreverá muitas linhas de código — sejam elas necessárias ou não. Se for avaliado por incidentes de segurança, você bloqueará tudo e gritará NÃO a qualquer mudança que possa favorecer uma violação. Se as pessoas forem avaliadas pelo tempo de atividade, a equipe de operações se concentrará em manter os sistemas funcionando e disponíveis — mas não em projetar e instrumentar sistemas e aplicações que reduzam o MTTR.
Esse é um daqueles aspectos “culturais” do DevOps — uma mudança na forma como abordamos as operações — que precisa ser incorporado ao NetOps. Se continuarmos otimizando apenas a disponibilidade, perderemos a oportunidade de implementar alertas e observabilidade (como monitoramento e registros detalhados), que reduzem o tempo médio de resolução e nos ajudam a alcançar o objetivo de minimizar o tempo de inatividade.
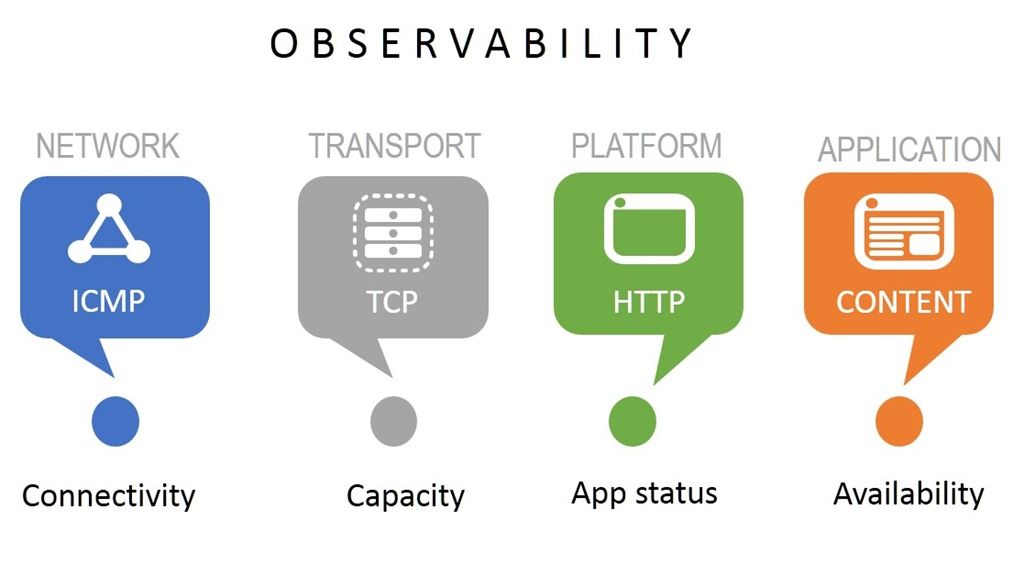
Vasculhar logs — mesmo os centralizados — não é uma maneira eficiente de chegar à raiz de um problema e resolvê-lo. O monitoramento em tempo real e os alertas sobre variáveis importantes que afetam a disponibilidade, como capacidade, conectividade e desempenho em todo o caminho dos dados (rede, infraestrutura e aplicação), invariavelmente reduzirão o tempo necessário para resolver problemas, pois permitem identificar sistemas ou serviços cujo desempenho está se deteriorando ou que falharam repentinamente.
A equipe de NetOps precisa adotar essa abordagem em relação à confiabilidade no pipeline de produção, pois, de modo geral, ela é mais adequada para lidar com falhas inevitáveis e está alinhada à abordagem de seus colegas de DevOps. Afinal, há um motivo para termos almejado apenas cinco noves, não é? Porque reconhecemos que falhas acontecem por mais que nos esforcemos e que a perfeição é impossível.
A mudança de tempo de atividade/inatividade para MTTR como métrica de sucesso incentiva a colaboração entre equipes e o uso de ferramentas de observabilidade em toda a extensão do pipeline de produção. Há um motivo para as ferramentas de monitoramento e alerta estarem no topo da lista de “ferramentas essenciais” para SREs na pesquisa. A observabilidade (com o objetivo de alertar sobre erros/incidentes), aliada à colaboração, é uma fórmula melhor para garantir que todos — NetOps, DevOps e também os desenvolvedores de aplicações — possam atingir a meta de manter as aplicações rápidas e disponíveis.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...