Um dos bordões de DevOps e computação em nuvem há, bem, muitos anos tem sido “projetar para falhar”. A ideia é que empresas demais enfrentam períodos de inatividade dispendiosos e perda de receita (e produtividade) devido a problemas de desempenho relacionados à capacidade; portanto, você deve projetar seu aplicativo e sua infraestrutura “para falhar”, a fim de garantir que acontecimentos tão assustadores não voltem para assombrá-lo. Heh. Viu o que eu fiz? Sim, trabalho remotamente, sozinho em um escritório. Às vezes, preciso me divertir.
Deixando os trocadilhos ruins de lado, o recente sucesso fenomenal de Pokémon Go (você ficou sabendo, não é?) também resultou em uma experiência extremamente frustrante para muitos. Especialmente para pais com filhos superempolgados que queriam sair, AGORA, mas não podiam porque a criação de contas foi temporariamente suspensa e, depois, rigidamente limitada devido à demanda avassaladora.
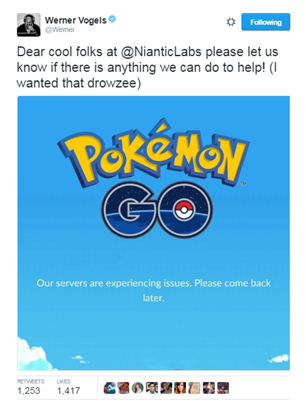
Agora, alguns podem apontar para a oferta de Werner Vogels, CTO da Amazon, para ajudar a empresa a lidar com seus problemas de capacidade como um indício de que ela não havia “migrado para a nuvem” e de que esse era o problema subjacente, mas isso pressupõe que ela não tivesse feito essa migração, o que, neste momento, não está muito claro para mim. Falando sério, segundo as atualizações da Wikipédia sobre a desenvolvedora de realidade aumentada, ela processa “mais de 200 milhões de ações de jogo por dia, à medida que as pessoas interagem com objetos reais e virtuais no mundo físico”. Acho que podemos dar um desconto a eles nesse caso — ou, pelo menos, aqueles de nós que entendem o que isso significa em termos de interações entre sistemas e tráfego de pacotes podem. As atualizações mencionaram “problemas no servidor”, mas, convenhamos, todos sabemos que “servidor” é um termo técnico para “15 componentes diferentes distribuídos entre o aplicativo e a infraestrutura de rede”.
De qualquer forma, a principal lição aqui não é que a nuvem seja necessariamente melhor para lidar com um sucesso inesperado. Pode muito bem ser, mas não por ser nuvem. É porque a nuvem não foi projetada apenas para falhar mas também para escalar.
Não tenho como determinar por que a Niantic Labs não conseguiu acompanhar a demanda. Talvez tenha sido por falta de capacidade, caso em que a nuvem seria uma boa opção, ou talvez os aplicativos e/ou a infraestrutura não tenham sido projetados para escalar, caso em que a nuvem talvez não tivesse ajudado em nada. A questão não é alfinetá-los (heh) pelo que fizeram ou deixaram de fazer. A questão é que eles são um exemplo perfeito da realidade de que, em um mundo movido por aplicativos, as organizações devem se preocupar tanto em se preparar para falhas quanto em se preparar para o sucesso. E não apenas para um sucesso gradual, mas para um sucesso instantâneo, da noite para o dia, como o de Pokémon Go.
Porque, se isso acontecer, você não vai querer que esse fracasso em meio ao sucesso fique estampado por toda a Internet.
Uma fonte comum de problemas de escalabilidade são as fontes de dados. Usuários antigos do Twitter se lembrarão de que os primeiros anos da rede social foram marcados por desafios de escalabilidade do banco de dados. O PayPal foi um dos primeiros e mais enfáticos defensores do particionamento como estratégia de escalabilidade para lidar com o desafio de atender a uma enorme quantidade de usuários, e a técnica passou a ser adotada de forma geral, aplicando-se a bancos de dados, serviços de desempenho, bem como a aplicações. O surgimento das fontes de dados NoSQL apresenta como um de seus benefícios uma escalabilidade maior do que a dos bancos de dados relacionais tradicionais.
Outra fonte de problemas de escalabilidade é de responsabilidade exclusiva da infraestrutura. O dimensionamento automático na nuvem depende da capacidade não apenas de adicionar automaticamente mais recursos computacionais, mas também de aumentar a capacidade do “endpoint da aplicação”. Em qualquer arquitetura que dependa do dimensionamento para aumentar a capacidade, isso implica algum tipo de serviço de balanceamento de carga. Quando os recursos computacionais são ampliados, eles precisam ser registrados no serviço de balanceamento de carga. Isso requer o uso de APIs e scripts, automação e orquestração. Esses componentes devem estar implementados antes de serem necessários; caso contrário, haverá atrasos se a demanda exigir um aumento de capacidade.
A inclusão de um serviço de balanceamento de carga em qualquer — ou melhor, em toda — arquitetura de aplicativo deveria ser um requisito. Um serviço de balanceamento de carga não só atende à necessidade de “projetar para falhas”, graças ao suporte inerente ao failover entre duas instâncias do aplicativo, como também à necessidade de “projetar para escalar”, essencial para o sucesso. Mas não pense que basta colocar um serviço de balanceamento de carga na frente de um aplicativo (ou microsserviço, se essa for a sua praia). É importante que a equipe de operações implemente a automação (scripts) e a orquestração (processos) que permitirão que o escalonamento automático atenda a essa demanda quando ela surgir. Hoje, a escalabilidade depende da arquitetura, não de algoritmos, e é importante considerar essa arquitetura desde o início, antes que a dívida arquitetural se torne tão restritiva que você fique preso ao que já tem.
Sinceramente, a Niantic Labs fez um bom trabalho ao se preparar para falhas. As falhas de capacidade foram tratadas com mensagens amigáveis, em vez das páginas padrão com códigos de status HTTP que encontro com frequência. Elas eram bem-humoradas e fáceis de ler e entender para as crianças (eu sei porque meu filho de 8 anos lia a mensagem para nós a cada 20 minutos). O que eles não previram foi o sucesso, talvez inesperado, que alcançaram. Isso serve como um bom lembrete para todos de que desenvolver pensando em escalabilidade é tão importante quanto desenvolver pensando em falhas.
Porque, quando você não faz isso, a Equipe Rocket vence.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...