
Load Balancing 101: Grundlagen und Funktionsweise
Einleitung
Auf dem heutigen dynamischen, anwendungsorientierten Markt stehen Unternehmen zunehmend unter Druck, die von ihren Kunden erwarteten Informationen, Dienste und Erlebnisse bereitzustellen – und zwar schnell, zuverlässig und sicher. Zentrale Netzwerk- und Anwendungsfunktionen wie Lastverteilung, Verschlüsselung, Beschleunigung und Sicherheit können über Application Delivery Controller (ADC) bereitgestellt werden. Dabei handelt es sich um physische oder virtuelle Appliances, die als Proxys für physische Server fungieren. Angesichts der explosionsartig wachsenden Zahl von Anwendungen und der Anforderungen, die der anspruchsvolle Zyklus aus Continuous Integration und Continuous Deployment (CI/CD) an Unternehmen stellt, überrascht es nicht, dass der Markt für ADCs bis 2020 voraussichtlich ein jährliches Volumen von 2,9 Milliarden US-Dollar erreichen wird.1
Doch bevor wir uns der Zukunft zuwenden, werfen wir einen Blick darauf, wie wir an diesen Punkt gelangt sind. Netzwerkbasierter Lastenausgleich bildet die wesentliche Grundlage für den Betrieb von ADCs. Mitte der 1990er-Jahre kamen die ersten Hardware-Appliances für den Lastenausgleich auf, die Unternehmen dabei unterstützten, ihre Anwendungen zu skalieren, indem sie Arbeitslasten auf Server und Netzwerke verteilten. Diese ersten Geräte waren anwendungsneutral und befanden sich außerhalb der Anwendungsserver selbst. Dadurch konnten sie den Lastenausgleich mithilfe einfacher Netzwerktechniken durchführen. Im Wesentlichen stellten diese Geräte der Außenwelt eine „virtuelle IP-Adresse“ bereit. Wenn Benutzer versuchten, eine Verbindung herzustellen, leiteten sie diese an den am besten geeigneten physischen Server weiter und führten dabei eine bidirektionale Netzwerkadressübersetzung (NAT) durch.
Mit dem Aufkommen von Virtualisierung und Cloud Computing entstand jedoch eine neue Generation von Load-Balancing-ADCs in Form softwarebasierter virtueller Editionen, die für den Betrieb auf Hypervisoren vorgesehen sind. Heute können virtuelle Appliances Anwendungsdienste mit demselben Funktionsumfang bereitstellen wie Appliances, die auf speziell entwickelter Hardware ausgeführt werden. Darüber hinaus reduzieren diese virtuellen Editionen die Komplexität bei der Verlagerung von Anwendungsdiensten zwischen virtuellen, Cloud- und Hybridumgebungen erheblich, sodass Unternehmen Anwendungsdienste schnell und einfach in privaten oder öffentlichen Cloud-Umgebungen bereitstellen können.
Der neueste Trend im Rechenzentrum ist die Containerisierung, eine Methode der Anwendungsvirtualisierung, die die Bereitstellung und Ausführung verteilter Anwendungen erleichtert. Dabei werden Anwendungen isoliert und in klar abgegrenzten Speicherbereichen auf einem gemeinsam genutzten Betriebssystem ausgeführt. Dies macht die Entwicklung und Bereitstellung einer Anwendung nicht nur einfacher, sondern auch schneller als die Erstellung einer virtuellen Appliance. Dank der erheblichen Verbesserungen bei Portabilität und Leistung kann die Containerisierung Unternehmen eine höhere Skalierbarkeit und Agilität ermöglichen. Künftig könnten Containerarchitekturen Unternehmen zudem dabei helfen, die Vorteile verschiedener Cloud-Umgebungen besser zu nutzen.
Die heutigen ADCs haben sich im Zuge der Servicevirtualisierung aus den ersten Load Balancern entwickelt. Mit rein softwarebasierten virtuellen Editionen können ADCs heute nicht nur die Verfügbarkeit verbessern, sondern Unternehmen auch dabei unterstützen, die skalierbaren, leistungsstarken und sicheren Anwendungen bereitzustellen, die sie für ihren Geschäftsbetrieb benötigen. Letztlich wären all diese virtualisierten Anwendungsdienste, Bereitstellungen gemeinsam genutzter Infrastrukturen und intelligenten Routing-Funktionen jedoch ohne das solide Fundament der Load-Balancing-Technologie nicht möglich.
Um zu verstehen, wie Unternehmen die komplexen Herausforderungen eines sich dynamisch entwickelnden Marktes besser bewältigen können, betrachten wir die Grundlage der Anwendungsbereitstellung: Grundlagen des Load Balancing.
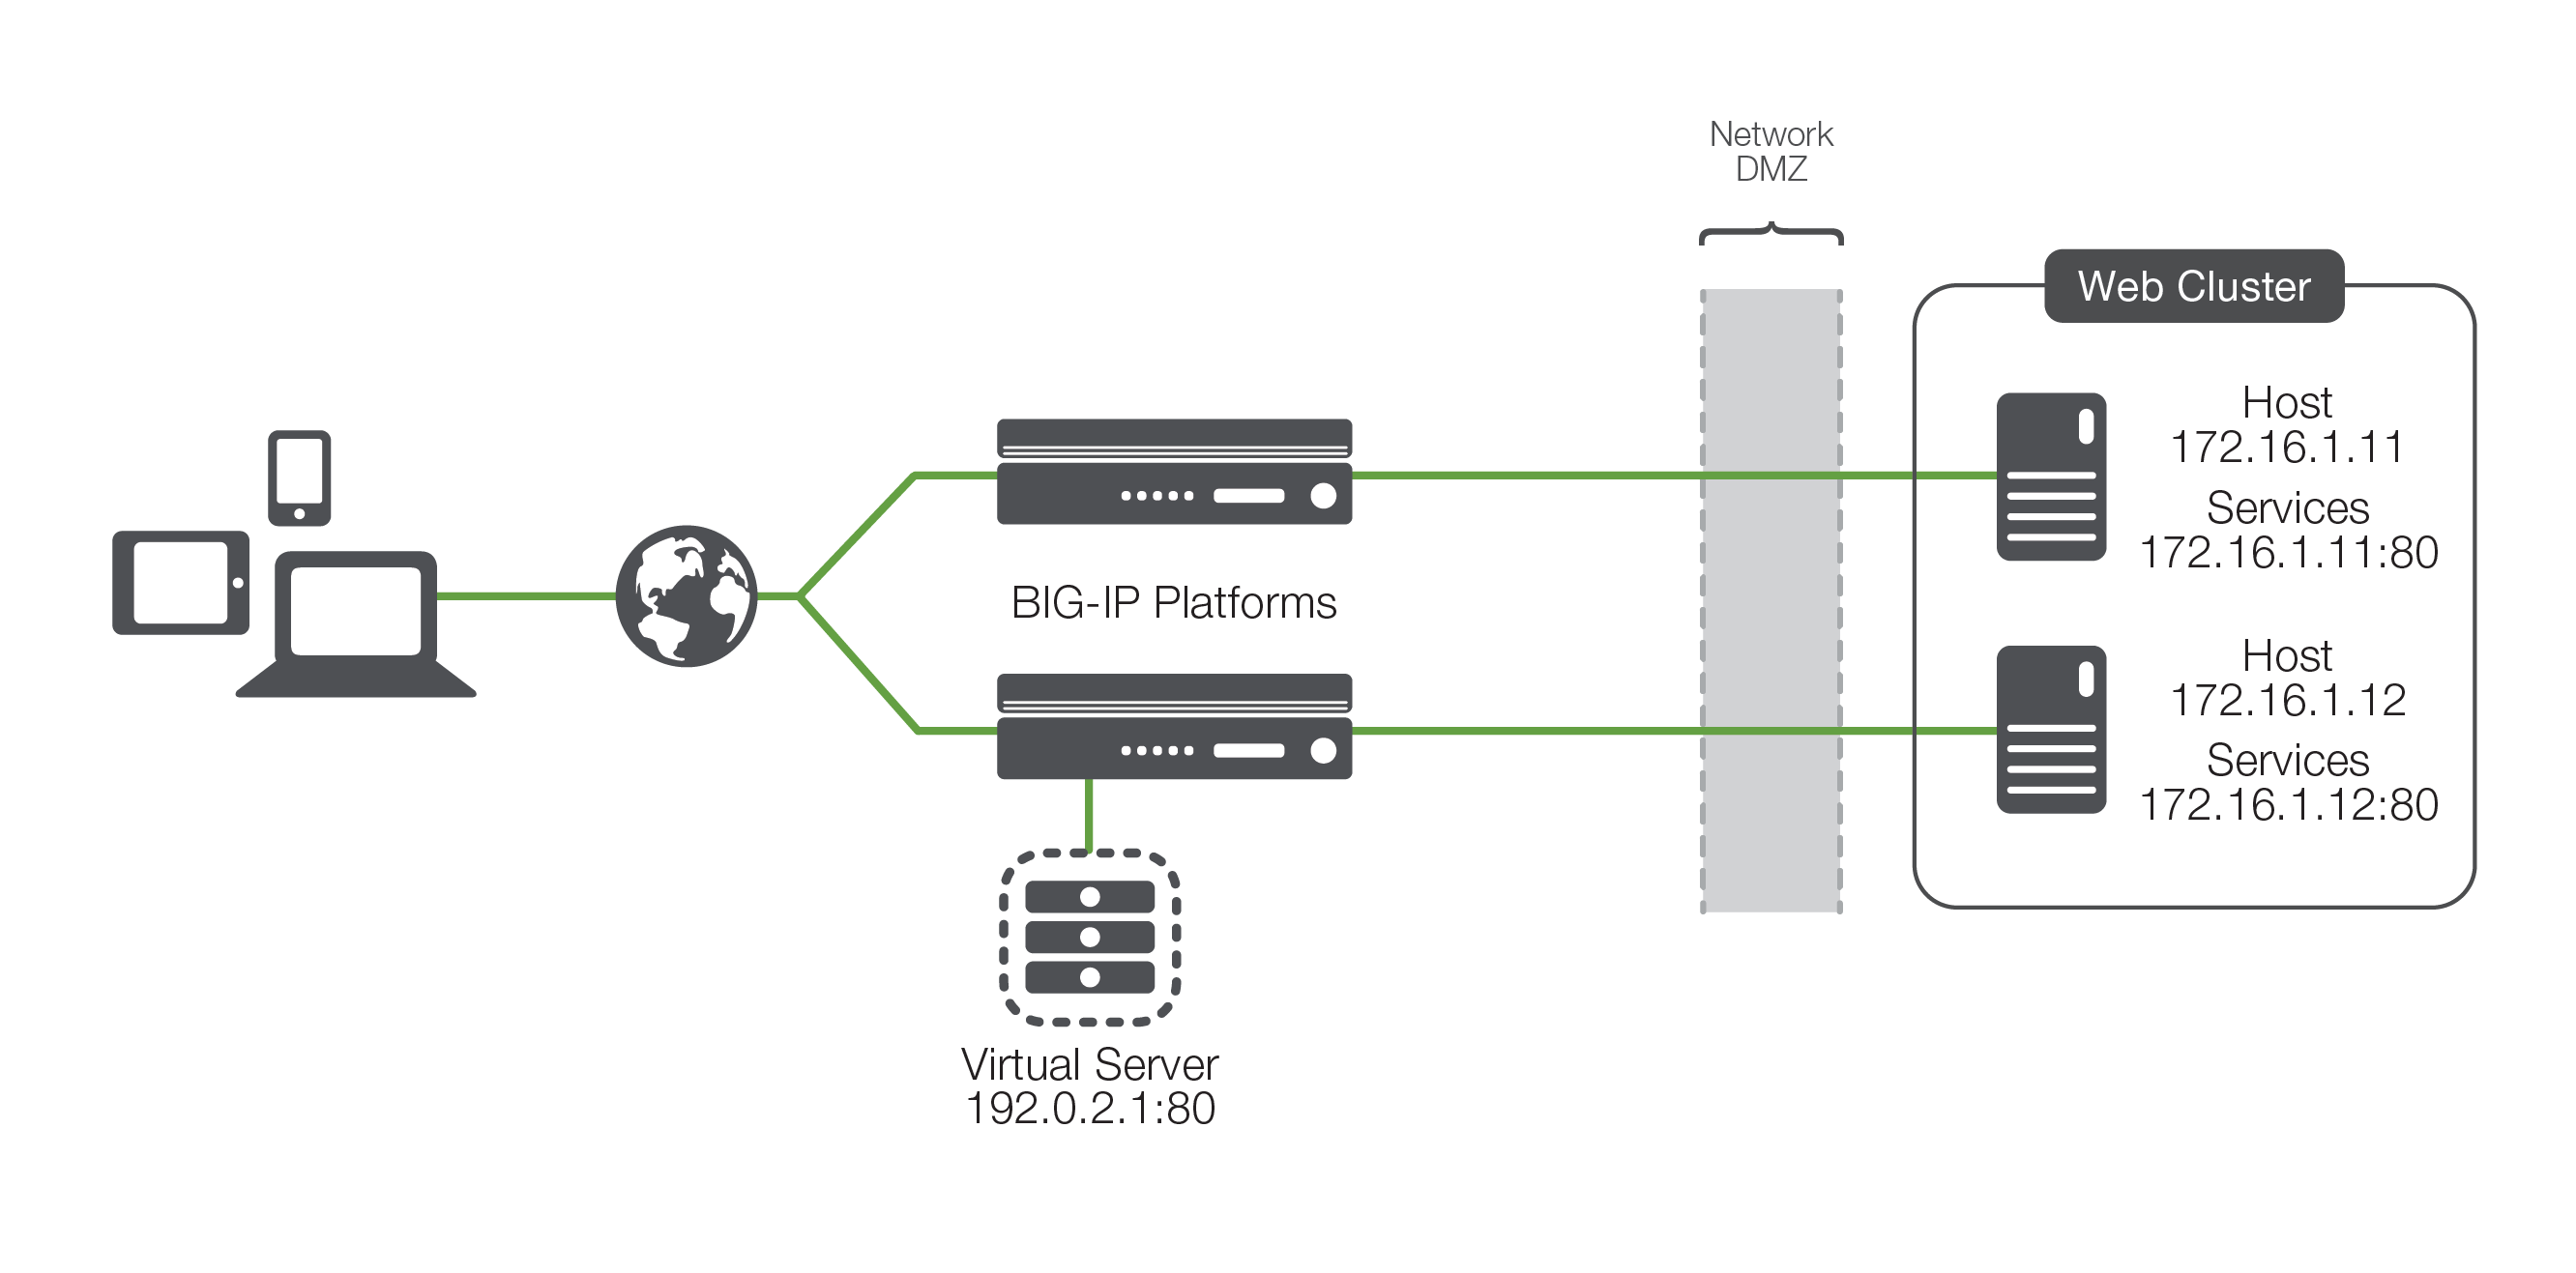
Die Grundlagen: Terminologie
Bevor wir beginnen, sehen wir uns die grundlegenden Begriffe des Load Balancings an. Das wäre einfacher, wenn alle dasselbe Vokabular verwenden würden. Leider scheint jedoch jeder Anbieter von Load-Balancing-Geräten (und damit auch von ADCs) andere Begriffe zu verwenden. Mit ein paar Erläuterungen lässt sich diese Verwirrung jedoch beseitigen.
Knoten, Host, Mitglied und Server
Die meisten ADCs für den Lastenausgleich verwenden die Begriffe Knoten, Host, Mitglied oder Server. Einige nutzen alle vier, wobei diese jedoch unterschiedliche Bedeutungen haben. Mit all diesen Begriffen sollen zwei grundlegende Konzepte ausgedrückt werden. Eines davon – üblicherweise als Knoten oder Server bezeichnet – beschreibt den physischen oder virtuellen Server selbst, der den Datenverkehr vom ADC empfängt. Dies entspricht der IP-Adresse des physischen Servers und wäre ohne einen Load Balancer die IP-Adresse, in die der Servername (z. B. www.example.com) aufgelöst würde. Im weiteren Verlauf dieses Dokuments bezeichnen wir dieses Konzept als Host.
Das zweite Konzept wird durch den Begriff „Member“ ausgedrückt (der von einigen Herstellern leider ebenfalls als „Node“ bezeichnet wird). Ein Member ist in der Regel etwas genauer definiert als ein Host, da er den TCP-Port der eigentlichen Anwendung umfasst, die den Datenverkehr empfängt. Beispielsweise kann ein Host namens www.example.com in die Adresse 172.16.1.10 aufgelöst werden, die den Host repräsentiert. Auf diesem Host kann eine Anwendung (ein Webserver) über TCP-Port 80 ausgeführt werden, sodass die Member-Adresse 172.16.1.10:80 lautet. Einfach ausgedrückt umfasst der Member neben der IP-Adresse des physischen bzw. virtuellen Servers auch die Definition des Anwendungsports. Im weiteren Verlauf dieses Dokuments bezeichnen wir dieses Konzept als Dienst.
Warum diese ganze Komplexität? Weil die Unterscheidung zwischen einem Server und den darauf ausgeführten Anwendungsdiensten es dem Load Balancer ermöglicht, mit den einzelnen Anwendungen statt mit der zugrunde liegenden Hardware oder dem Hypervisor zu interagieren – ob im Rechenzentrum oder in der Cloud. Auf einem Host (172.16.1.10) können mehrere Dienste verfügbar sein (HTTP, FTP, DNS usw.). Indem jede Anwendung eindeutig definiert wird (zum Beispiel 172.16.1.10:80, 172.16.1.10:21 und 172.16.1.10:53), kann der ADC für jeden Dienst ein individuelles Load Balancing und eine individuelle Zustandsüberwachung (ein Konzept, auf das wir später noch eingehen werden) anwenden, anstatt sich dabei am Host zu orientieren.
Denken Sie daran, dass die meisten auf Lastverteilung basierenden Technologien einen Begriff für den Host bzw. den physischen Server und einen anderen für die darauf verfügbaren Dienste verwenden – in diesem Fall einfach „Host“ und „Dienste“.
Pool, Cluster und Farm
Load Balancing ermöglicht es Unternehmen, eingehenden Anwendungsdatenverkehr auf mehrere Backend-Ziele zu verteilen, einschließlich Bereitstellungen in öffentlichen oder privaten Clouds. Daher ist ein Konzept zur Zusammenfassung von Backend-Zielen erforderlich. Cluster, wie wir sie im Folgenden nennen (auch als Pools oder Farmen bezeichnet), sind Gruppen ähnlicher Dienste, die auf einer beliebigen Anzahl von Hosts verfügbar sind. Beispielsweise würden alle Dienste, über die die Unternehmenswebsite bereitgestellt wird, in einem Cluster namens „Unternehmenswebsite“ zusammengefasst, während alle Dienste für den E-Commerce in einem Cluster namens „E-Commerce“ gebündelt würden.
Virtueller Server
Ein virtueller Server fungiert als Proxy für den eigentlichen Server (physisch, virtuell oder containerbasiert). Zusammen mit einer virtuellen IP-Adresse bildet er den Anwendungsendpunkt, der nach außen bereitgestellt wird.
Alles zusammenführen
Mit dem Verständnis dieser Begriffe kennen wir nun die Grundlagen der Lastverteilung. Der für die Lastverteilung zuständige ADC stellt der Außenwelt virtuelle Server bereit. Jeder virtuelle Server verweist auf einen Cluster von Diensten, die sich auf einem oder mehreren physischen Hosts befinden.
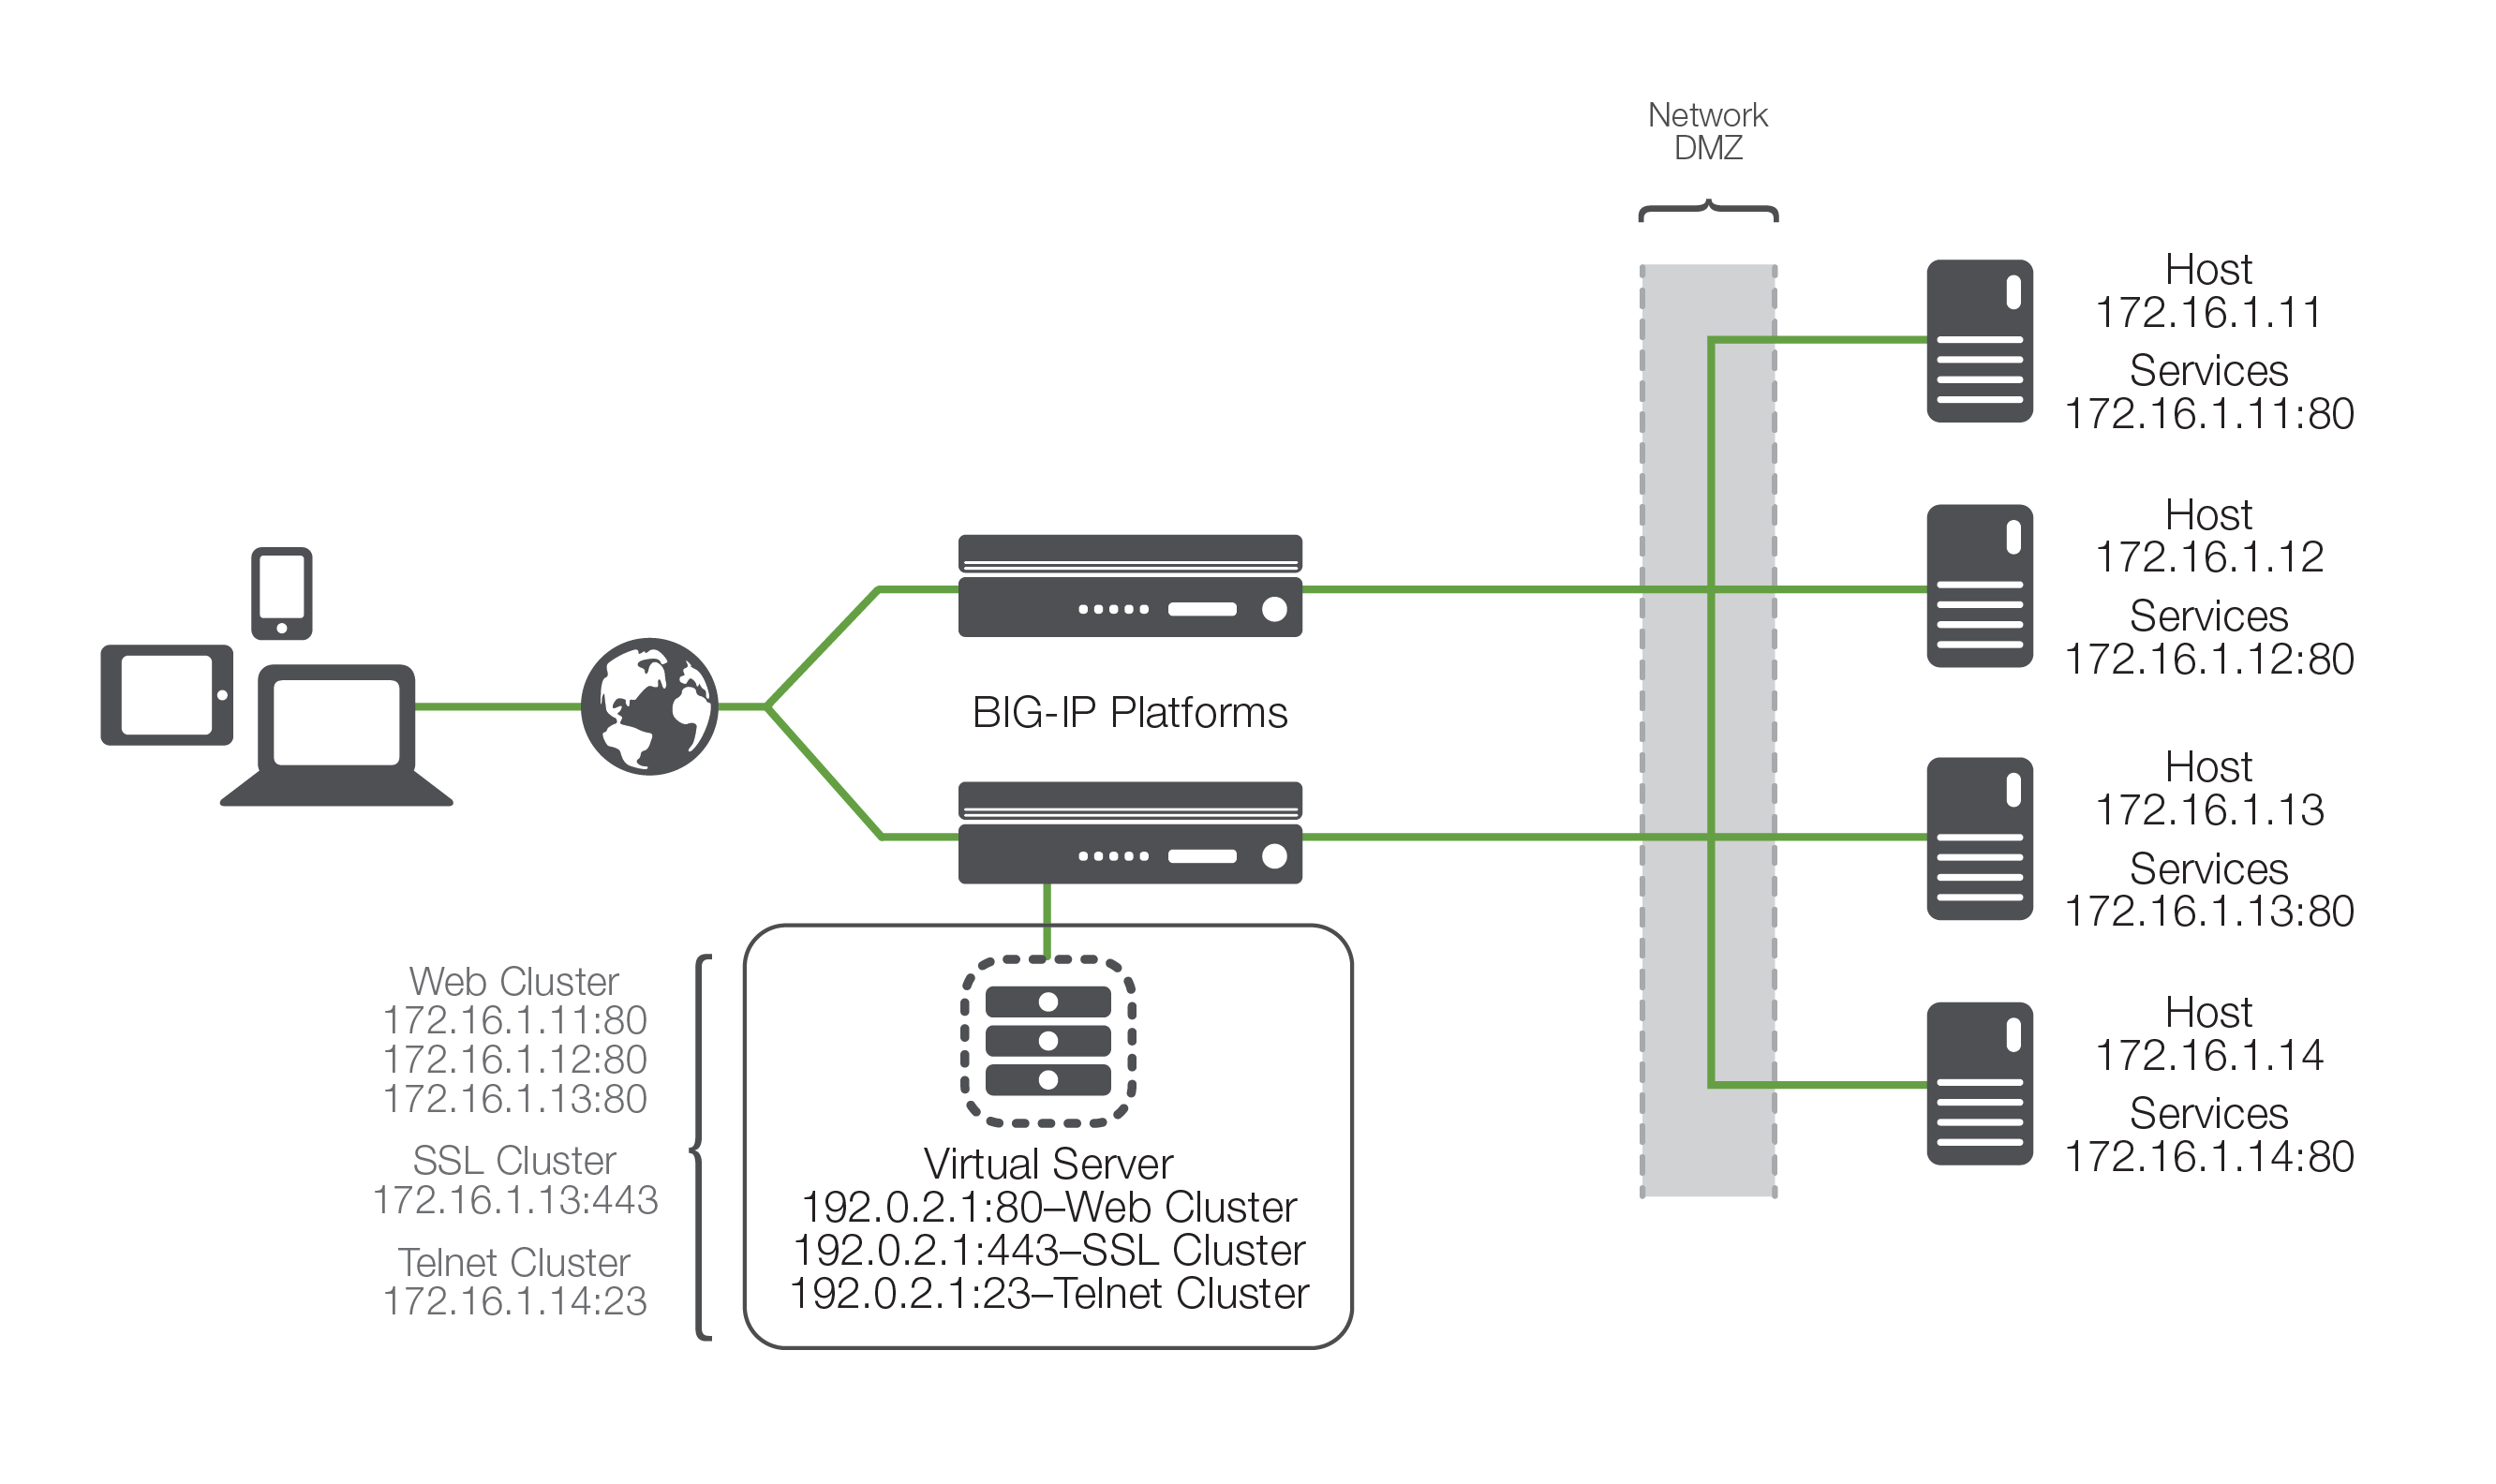
Auch wenn Abbildung 2 möglicherweise keine reale Bereitstellung widerspiegelt, veranschaulicht sie doch die grundlegende Struktur, die als Ausgangspunkt für die weitere Erläuterung des Prozesses der Lastverteilung und Anwendungsbereitstellung dient.
So funktioniert Lastverteilung
Nachdem wir nun eine gemeinsame Terminologie festgelegt haben, betrachten wir den einfachen Vorgang, mit dem die Anwendung für den Kunden bereitgestellt wird. Wie dargestellt, befindet sich der Load-Balancing-ADC in der Regel direkt zwischen dem Client und den Hosts, die die vom Client gewünschten Dienste bereitstellen. Wie bei den meisten Aspekten der Anwendungsbereitstellung ist diese Positionierung keine feste Regel, sondern vielmehr eine bewährte Vorgehensweise für jede Art von Bereitstellung. Nehmen wir außerdem an, dass der ADC bereits mit einem virtuellen Server konfiguriert ist, der auf einen Cluster aus zwei Dienstendpunkten verweist. In diesem Bereitstellungsszenario verfügen die Hosts üblicherweise über eine Rückroute zum Load Balancer, sodass der Rückverkehr auf dem Weg zum Client über diesen verarbeitet wird.
Der grundlegende Ablauf der Anwendungsbereitstellung sieht wie folgt aus:
- Der Client versucht, eine Verbindung mit dem Dienst herzustellen.
- Der ADC akzeptiert die Verbindung und ändert, nachdem er entschieden hat, welcher Host die Verbindung erhalten soll, die Ziel-IP-Adresse (und gegebenenfalls den Port) entsprechend dem Dienst des ausgewählten Hosts. (Beachten Sie, dass die Quell-IP-Adresse des Clients unverändert bleibt.)
- Der Host akzeptiert die Verbindung und antwortet der ursprünglichen Quelle, dem Client, über seine Standardroute, den ADC.
- Der ADC fängt das vom Host zurückgesendete Paket ab, ändert die Quell-IP-Adresse (und gegebenenfalls den Port) so, dass sie mit der IP-Adresse und dem Port des virtuellen Servers übereinstimmt, und leitet das Paket an den Client zurück.
- Der Client empfängt das Antwortpaket in der Annahme, dass es vom virtuellen Server stammt, und setzt den Vorgang fort.
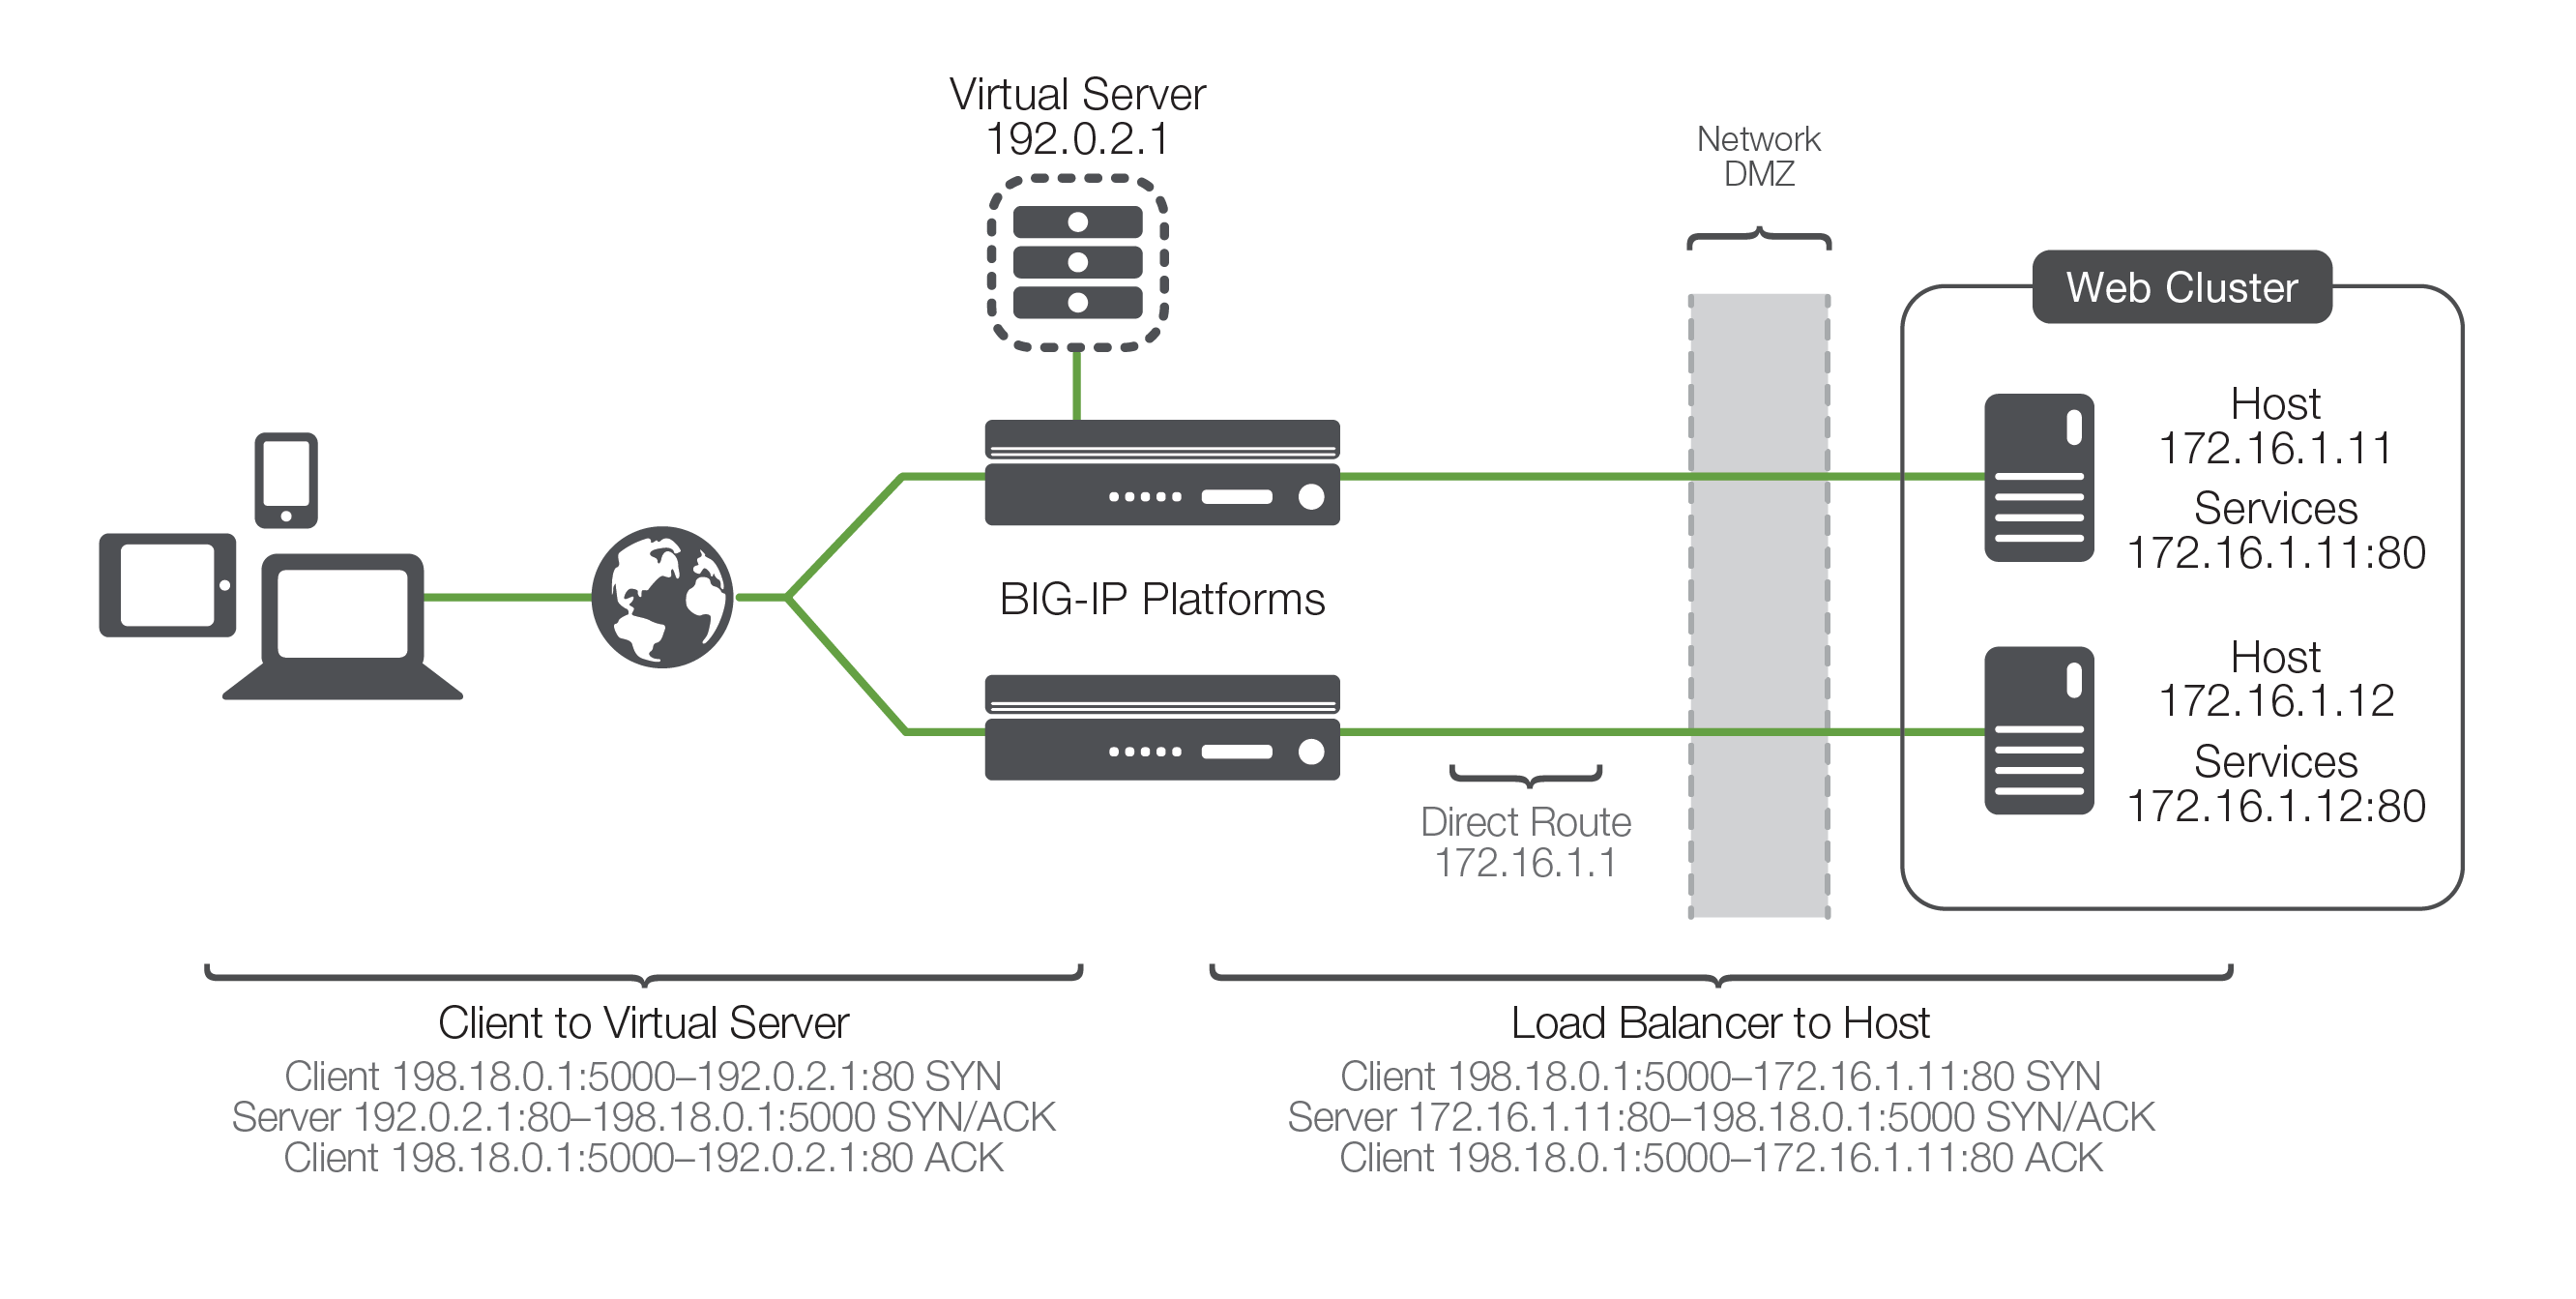
Dieses sehr einfache Beispiel ist relativ leicht nachvollziehbar, dennoch sind einige wichtige Punkte zu beachten. Erstens: Aus Sicht des Clients sendet er Pakete an den virtuellen Server, und der virtuelle Server antwortet – ganz einfach. Zweitens findet die NAT statt. Dabei ersetzt der ADC die vom Client gesendete Ziel-IP-Adresse des virtuellen Servers durch die Ziel-IP-Adresse des Hosts, an den er die Anfrage zur Lastverteilung weiterleiten möchte. Drittens gibt es den Teil dieses Vorgangs, durch den die NAT „bidirektional“ wird. Die Quell-IP-Adresse des Antwortpakets vom Host entspricht der IP-Adresse des Hosts. Würde diese Adresse nicht geändert und das Paket einfach an den Client weitergeleitet, würde der Client ein Paket von einem Absender erhalten, bei dem er keines angefordert hat, und es daher einfach verwerfen. Stattdessen schreibt der Load Balancer, der sich die Verbindung gemerkt hat, das Paket so um, dass als Quell-IP-Adresse die des virtuellen Servers angegeben ist. Dadurch wird dieses Problem gelöst.
Die Entscheidung zur Anwendungsbereitstellung
An dieser Stelle stellen sich normalerweise zwei Fragen: Wie entscheidet der für den Lastenausgleich zuständige ADC, an welchen Host die Verbindung weitergeleitet wird? Und was geschieht, wenn der ausgewählte Host nicht funktioniert?
Betrachten wir zunächst die zweite Frage. Was passiert, wenn der ausgewählte Host nicht funktioniert? Die einfache Antwort lautet: Er reagiert nicht auf die Clientanfrage, und der Verbindungsversuch wird schließlich wegen einer Zeitüberschreitung abgebrochen und schlägt fehl. Dies ist natürlich nicht wünschenswert, da so keine hohe Verfügbarkeit gewährleistet ist. Deshalb verfügen die meisten Load-Balancing-Technologien über eine Form der Zustandsüberwachung, mit der geprüft wird, ob ein Host tatsächlich verfügbar ist, bevor versucht wird, Verbindungen an ihn weiterzuleiten.
Die Zustandsüberwachung kann auf mehreren Ebenen erfolgen, die sich durch eine zunehmend feinere Granularität und gezieltere Prüfung auszeichnen. Eine einfache Überwachung würde lediglich den Host selbst anpingen. Reagiert der Host nicht auf den Ping, kann davon ausgegangen werden, dass die auf ihm bereitgestellten Dienste wahrscheinlich ebenfalls ausgefallen sind und aus dem Cluster der verfügbaren Dienste entfernt werden sollten. Doch selbst wenn der Host auf den Ping reagiert, bedeutet das nicht zwangsläufig, dass der Dienst selbst funktioniert. Daher können die meisten Geräte eine Art „Dienst-Ping“ durchführen – von einfachen TCP-Verbindungen bis hin zur Interaktion mit der Anwendung mithilfe eines Skripts oder einer intelligenten Logik. Diese höherstufigen Zustandsprüfungen bieten nicht nur größere Gewissheit hinsichtlich der Verfügbarkeit der eigentlichen Dienste (im Gegensatz zum Host), sondern ermöglichen es dem Load Balancer auch, zwischen mehreren Diensten auf demselben Host zu unterscheiden. Der Load Balancer erkennt, dass ein Dienst möglicherweise nicht verfügbar ist, während andere Dienste auf demselben Host einwandfrei funktionieren und weiterhin als gültige Ziele für den Benutzerverkehr berücksichtigt werden sollten.
Damit kommen wir zurück zur ersten Frage: Wie entscheidet der ADC, an welchen Host er eine Verbindungsanfrage weiterleitet? Jedem virtuellen Server ist ein bestimmter, dedizierter Dienstcluster zugeordnet, in dem die Hosts aufgeführt sind, die den jeweiligen Dienst anbieten. Diese Hosts bilden die Liste der möglichen Ziele. Zusätzlich passt die Zustandsüberwachung diese Liste an und erstellt daraus eine Liste der „aktuell verfügbaren“ Hosts, die den angegebenen Dienst bereitstellen. Aus dieser angepassten Liste wählt der ADC den Host aus, der eine neue Verbindung erhalten soll. Welcher Host genau ausgewählt wird, hängt von dem Lastverteilungsalgorithmus ab, der dem jeweiligen Cluster zugeordnet ist. Zu diesen Algorithmen gehören unter anderem „Least Connections“, „Dynamic Ratio“ und ein einfaches Round-Robin-Verfahren. Dabei arbeitet der Load Balancer die Liste von oben nach unten ab und weist jede neue Verbindung dem jeweils nächsten Host zu. Sobald er das Ende der Liste erreicht hat, beginnt er wieder von vorn. Dieses Verfahren ist zwar einfach und sehr gut vorhersehbar, setzt jedoch voraus, dass alle Verbindungen auf dem Backend-Host eine ähnliche Last und Dauer aufweisen, was nicht immer der Fall ist. Fortschrittlichere Algorithmen berücksichtigen Faktoren wie die Anzahl der aktuell bestehenden Verbindungen, die Hostauslastung und sogar die tatsächlichen Antwortzeiten des Hosts bei bestehendem Datenverkehr, um aus den verfügbaren Clusterdiensten den am besten geeigneten Host auszuwählen.
Ausreichend fortschrittliche Application-Delivery-Systeme können zudem Informationen aus der Zustandsüberwachung mit Lastverteilungsalgorithmen verknüpfen und dabei Abhängigkeiten zwischen Diensten berücksichtigen. Dies ist vor allem dann nützlich, wenn ein einzelner Host mehrere Dienste bereitstellt, die alle zur Bearbeitung der Benutzeranfrage erforderlich sind. In einem solchen Fall soll ein Benutzer nicht an einen Host weitergeleitet werden, auf dem zwar ein Dienst verfügbar ist, ein anderer jedoch nicht. Fällt also ein Dienst auf dem Host aus, soll auch der andere Dienst dieses Hosts aus der Clusterliste der verfügbaren Dienste entfernt werden. Diese Funktionalität gewinnt zunehmend an Bedeutung, da Dienste durch HTML und Skripting immer stärker ausdifferenziert werden.
Lastverteilung oder keine Lastverteilung?
Der Teil des Load Balancings, bei dem ein verfügbarer Dienst ausgewählt wird, sobald ein Client eine Transaktionsanfrage initiiert, ist nur die halbe Lösung. Nachdem die Verbindung hergestellt wurde, muss der ADC nachverfolgen, ob der nachfolgende Datenverkehr dieses Benutzers per Load Balancing verteilt werden soll. Bei der Verarbeitung des nachfolgenden Datenverkehrs nach dem Load Balancing sind im Allgemeinen zwei konkrete Aspekte zu berücksichtigen: die Aufrechterhaltung der Verbindung und die Persistenz.
Verbindungsverwaltung
Wenn der Benutzer versucht, eine langlebige TCP-Verbindung (Port 21: FTP, Port 23: Telnet oder eine andere) zu nutzen, die nicht sofort geschlossen wird, muss der Load Balancer sicherstellen, dass mehrere über diese Verbindung übertragene Datenpakete nicht auf andere verfügbare Diensthosts verteilt werden. Dies wird als Verbindungspflege bezeichnet und erfordert zwei wesentliche Funktionen. Erstens müssen offene Verbindungen und die zugehörigen Hostdienste nachverfolgt werden können. Zweitens muss der Load Balancer die Verbindung kontinuierlich überwachen können, damit die Verbindungstabelle aktualisiert werden kann, sobald die Verbindung geschlossen wird. Für die meisten ADCs gehört dies zum Standardumfang.
Persistenz
Immer häufiger kommt es jedoch vor, dass der Client mehrere kurzlebige TCP-Verbindungen (z. B. Port 80: HTTP) verwendet, um eine einzelne Aufgabe auszuführen. In manchen Fällen, etwa beim normalen Surfen im Internet, spielt dies keine Rolle, und jede neue Anfrage kann an einen beliebigen Back-End-Diensthost weitergeleitet werden. Es gibt jedoch viele Anwendungsfälle (XML, E-Commerce usw.), in denen es äußerst wichtig ist, dass mehrere Verbindungen desselben Benutzers an denselben Back-End-Diensthost weitergeleitet und nicht per Lastenausgleich verteilt werden. Dieses Konzept wird als Persistenz oder Serveraffinität bezeichnet.
Je nach Protokoll und gewünschtem Ergebnis gibt es mehrere Möglichkeiten, dieses Problem zu lösen. Bei modernen HTTP-Transaktionen kann der Server beispielsweise eine „Keep-Alive“-Verbindung festlegen. Dadurch werden mehrere kurzlebige Verbindungen zu einer einzigen langlebigen Verbindung zusammengefasst, die sich wie andere langlebige Verbindungen behandeln lässt. Dies schafft jedoch nur wenig Abhilfe, vor allem weil mit der zunehmenden Nutzung von Web- und mobilen Diensten die Ressourcen des gesamten Systems belastet werden, wenn alle Verbindungen länger als nötig offen bleiben. Aus Gründen der Skalierbarkeit und Portabilität setzen daher heute viele Unternehmen zunehmend auf zustandslose Anwendungen, die auf APIs basieren. Im Wesentlichen bedeutet dies, dass der Server sämtliche Sitzungsinformationen verwirft, um die Ressourcenbelastung zu verringern. In diesen Fällen wird der Zustand durch die Übermittlung von Sitzungs-IDs sowie mithilfe des Persistenzkonzepts aufrechterhalten.
Eine der grundlegendsten Formen der Persistenz ist die Quelladressenaffinität. Dabei werden lediglich die Quell-IP-Adresse eingehender Anfragen und der Diensthost erfasst, dem sie beim Load Balancing zugewiesen wurden, sodass alle zukünftigen Transaktionen an denselben Host weitergeleitet werden. Dies lässt sich unter anderem mithilfe von SSL-Sitzungs-IDs und Cookies erreichen. Bei der SSL-Persistenz werden SSL-Sitzungen anhand ihrer SSL-Sitzungs-IDs nachverfolgt. Dadurch erkennt der Load Balancer die Sitzung anhand der Sitzungs-ID als persistent, selbst wenn sich die IP-Adresse des Clients ändert. Bei der Cookie-basierten Persistenz kann auf dem Computer eines Clients ein Cookie gespeichert werden, um eine Sitzung eindeutig zu identifizieren. Bei nachfolgenden Anfragen wird dann auf dieses Cookie Bezug genommen, sodass die Verbindung an den richtigen Server weitergeleitet wird.
Dank der heutigen Intelligenz von ADCs können Unternehmen Datenpakete öffnen und für praktisch alle darin enthaltenen Informationen Persistenztabellen erstellen. So können sie eindeutige Informationen wie den Benutzernamen verwenden, um die Persistenz aufrechtzuerhalten. Unternehmen müssen jedoch sicherstellen, dass diese identifizierbaren Clientinformationen in jeder Anfrage enthalten sind. Pakete ohne diese Informationen werden nicht persistent zugeordnet, sondern erneut per Lastverteilung verteilt, wodurch die Anwendung höchstwahrscheinlich nicht mehr ordnungsgemäß funktioniert.
Fazit
Ursprünglich konzentrierte sich Load Balancing darauf, Arbeitslasten im gesamten Netzwerk zu verteilen und die Verfügbarkeit von Anwendungen und Diensten sicherzustellen. Mit der Weiterentwicklung der Technologie wurden Load Balancer jedoch zu Plattformen für die Anwendungsbereitstellung, die eine hohe Verfügbarkeit und Sicherheit der geschäftskritischen Anwendungen eines Unternehmens gewährleisteten. Während grundlegendes Load Balancing nach wie vor die Basis der Anwendungsbereitstellung bildet, bieten moderne ADCs einen deutlich größeren Funktionsumfang.
Unternehmen erkennen, dass die bloße Erreichbarkeit einer Anwendung noch lange nicht bedeutet, dass sie auch nutzbar ist – und nicht nutzbare Anwendungen bedeuten für das Unternehmen, das sie bereitstellt, eine Verschwendung von Zeit und Geld. Hier kommt der moderne ADC ins Spiel: Er ermöglicht es Unternehmen, netzwerkbasierte Dienste wie SSL/TLS-Offloading, Caching, Komprimierung, Bandbreitensteuerung, Angriffserkennung, Anwendungsfirewalls und sogar den Remotezugriff an einem zentralen strategischen Punkt zu bündeln. Dieser kann von allen Anwendungsdiensten und Hosts gemeinsam genutzt und wiederverwendet werden, um ein virtualisiertes Application Delivery Network zu schaffen. So können Netzwerk-, Anwendungs- und Betriebsteams besser auf geschäftliche Anforderungen nach kürzeren Bereitstellungszeiten und höherer Skalierbarkeit reagieren, ohne dabei Abstriche bei der Sicherheit zu machen.
Wenn Sie mehr darüber erfahren möchten, wie moderne Anwendungsbereitstellung funktioniert und wie die Zukunft von ADCs aussieht, lesen Sie Die Evolution von Application Delivery Controllern und Mehr als nur herkömmlicher Lastenausgleich.
1 http://www.strategyr.com/MarketResearch/Application_Delivery_Controllers_ADC_Market_Trends.asp
VERÖFFENTLICHT AM 10. MAI 2017