A maioria de nós, pelo simples fato de sermos humanos, já vivenciou o que é comumente chamado de “luta ou fuga” — uma reação física autonômica, muitas vezes intensa, que se manifesta por meio de coração acelerado, músculos tensos e palmas das mãos suadas. Uma sensação de pânico pode acompanhar essa reação, assim como uma paralisia decisória que praticamente elimina nossa capacidade de pensar de forma lógica.
As empresas têm sua própria versão dessa resposta, desenvolvida e aperfeiçoada ao longo de anos reagindo a situações digitais ameaçadoras.
O risco para as empresas é semelhante ao enfrentado pelos seres humanos. Nas pessoas, a ativação excessivamente frequente, intensa ou inadequada da resposta de luta ou fuga está associada a diversas condições clínicas. Em resumo, isso significa que ela pode causar danos físicos reais. No âmbito empresarial, o acionamento frequente, intenso ou potencialmente inadequado de uma resposta digital de luta ou fuga pode prejudicar a saúde da empresa — especialmente na área de segurança.
Assim como os conhecidos “estágios do luto”, ao longo de décadas de trabalho para mitigar ameaças relacionadas a aplicações e à infraestrutura, observamos o surgimento de “estágios das reações de segurança”.
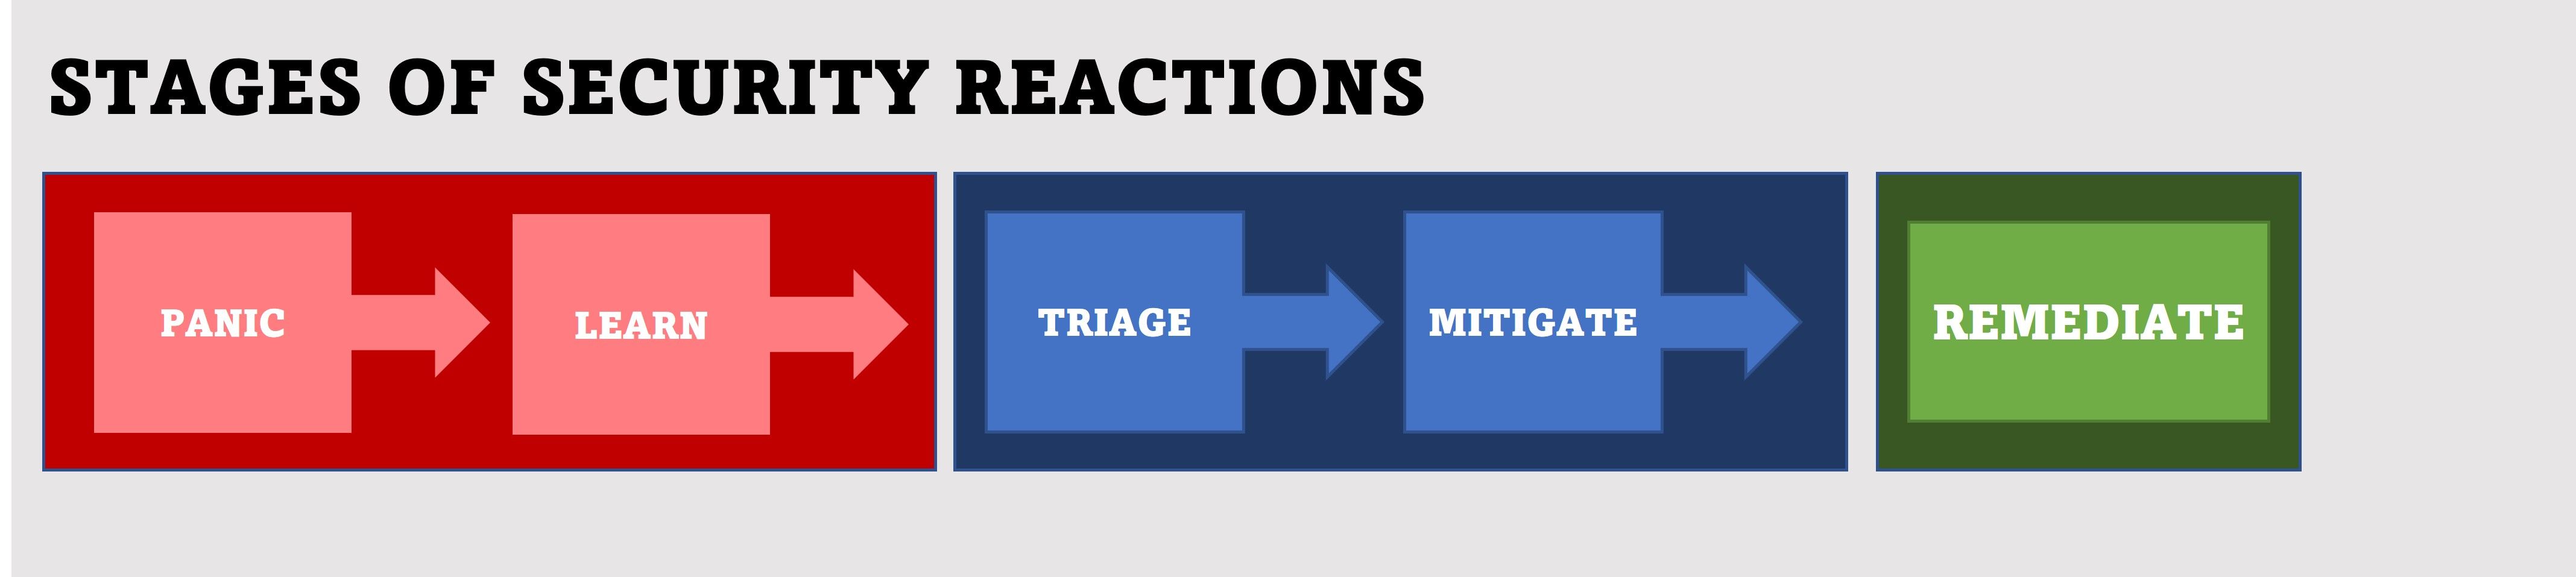
A importância de escolher a resposta certa Response
Apressar-se para corrigir o problema pode ser uma daquelas reações que, a longo prazo, não se mostram a melhor resposta. Vale lembrar que o primeiro patch lançado pela Apache para o Log4j também era vulnerável, portanto, as organizações que se apressaram para corrigir o problema basicamente tiveram que recomeçar e aplicar novos patches em todos os seus sistemas.
É neste ponto que faço uma pausa e afirmo enfaticamente que não se apressar para implementar a correção não significa ignorar o risco ou optar pela inação.
É particularmente importante lembrar disso porque não administrar de forma responsável os dados que impulsionam uma empresa digital traz consequências no mundo real. Após o Log4j, a Comissão Federal de Comércio dos EUA (FTC) “alertou que iria atrás das empresas do setor privado que não protegessem os dados dos consumidores expostos em decorrência do Log4j.” (ZDNet)
Por que a mitigação vem em primeiro lugar
A mitigação vem antes da remediação por um motivo, entre eles a necessidade de lidar com o instinto humano de “fazer alguma coisa” e partir às pressas para a remediação. A mitigação rápida também atende à necessidade de gerenciar os dados dos clientes com responsabilidade, protegendo-os contra exfiltração enquanto se formula o plano de ação de remediação correto.
A mitigação deve ser a primeira medida adotada, especialmente ao lidar com uma vulnerabilidade tão disseminada, que exigirá uma investigação aprofundada da cadeia de suprimentos de software. A ampla presença dessa vulnerabilidade e a dificuldade de descobrir exatamente onde pacotes e componentes vulneráveis podem estar escondidos provavelmente explicam a constatação de que “os downloads vulneráveis relacionados ao #log4shell ainda representam 46% do total” em 4 de janeiro. (Sonatype)
A realidade de um mundo em que o digital é o padrão é que vulnerabilidades de segurança novas e graves continuarão a causar interrupções nos negócios e a sobrecarregar recursos que já estão no limite. Devido à natureza robusta do portfólio de aplicações empresariais — que muitas vezes abrange cinco gerações de arquiteturas de aplicações distribuídas entre o núcleo, a nuvem e a borda —, devemos partir do princípio de que a correção consumirá a maior parte do tempo e da energia. É por isso que uma mitigação rápida é tão importante. Ela alivia a pressão e permite uma abordagem mais criteriosa e abrangente para a correção — uma abordagem que inclui verificar se os patches lançados são seguros e permitir que os desenvolvedores façam atualizações, apliquem patches e realizem testes de acordo com os ciclos de lançamento existentes.
As organizações devem garantir que tenham pontos de controle em todos os ambientes que ofereçam suporte à mitigação. A proteção de aplicações web e APIs, a inspeção de conteúdo e os recursos de bloqueio em pontos de controle estratégicos fornecem uma espécie de “plataforma” de mitigação diante desses tipos de vulnerabilidades generalizadas. Esses mesmos pontos de controle também podem fornecer informações valiosas ao revelar tentativas de exploração dessas vulnerabilidades.
Conclusão
A maioria de nós se lembra dos simulados de incêndio da infância, nos quais praticávamos como sair da escola com segurança em caso de incêndio. Eu também participei de simulados de tornado e imagino que haja crianças ao redor do mundo que já tenham feito treinamentos de preparação para terremotos ou tsunamis. Ter um plano e saber como colocá-lo em prática pode ser fundamental para reduzir o tempo passado em estado de pânico quando surge a notícia de uma vulnerabilidade significativa.
Portanto, não entre em pânico. Use pontos de controle estratégicos e concentre-se em uma mitigação rápida para que você possa realizar uma correção deliberada.
E lembre-se: a prática reduz o pânico. Planejar e realizar seu próprio “simulado de emergência de segurança” não é uma má ideia.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...