
Este é o terceiro artigo de uma série que aborda diversos aspectos do que foi necessário para desenvolver e operar nosso serviço de SaaS :
- Plano de controle para uma PaaS Kubernetes distribuída
- Malha de serviços global para aplicações distribuídas
- Segurança de plataforma para infraestrutura, aplicativos e dados distribuídos
- Segurança de aplicações e redes de clusters distribuídos
- Observabilidade em uma plataforma distribuída globalmente
- Operações e SRE de uma plataforma distribuída globalmente
- Framework de serviços em Golang para microsserviços distribuídos
Meu primeiro blog apresentou um pouco do contexto sobre as necessidades que nos levaram a criar uma nova plataforma para nuvens distribuídas. Usando essa plataforma, nossos clientes desenvolvem um conjunto complexo e diversificado de aplicações, como manufatura inteligente, análise forense de vídeo para segurança pública, negociação algorítmica e redes 5G de telecomunicações.
Como muitas dessas aplicações são de missão crítica, nossos clientes esperam que não apenas ofereçamos segurança em várias camadas, mas também tenhamos a capacidade de implementar melhorias contínuas para manter seus clusters distribuídos protegidos. Este blog abordará especificamente os desafios de proteger a infraestrutura, as aplicações e os dados em vários clusters.
TL;DR (Resumo)
- Embora seja relativamente bem compreendido como fornecer a usuários e funcionários acesso seguro a aplicativos (fazemos isso todos os dias ao acessar nossas contas bancárias ou nossos e-mails corporativos), não é tão simples fazer o mesmo para o acesso entre aplicativos ou entre aplicativos e dados, pois não há participação humana no processo de verificação.
- Proteger aplicativos e dados em um ambiente heterogêneo (edge, múltiplas nuvens e PoPs de rede) exigiu que solucionássemos um problema de várias camadas — identidade, autenticação e autorização, segredos e gerenciamento de chaves
- Embora existam muitas soluções pontuais disponíveis para esses quatro problemas (por exemplo, diversos serviços de provedores de nuvem individuais, Hashicorp Vault, SPIFFE/Spire etc.), não há uma solução integrada que funcione entre diferentes provedores de nuvem ou que combine perfeitamente cada um desses serviços para facilitar o uso.
- Dada a falta de conhecimento especializado em nossas equipes de desenvolvimento e DevOps sobre como integrar esses componentes, tornou-se essencial que nossa equipe de plataforma disponibilizasse esses recursos como uma solução integrada e fácil de usar. O cenário de segurança em constante evolução e as novas tecnologias tornam a situação ainda mais difícil para essas equipes, pois elas não têm o conhecimento necessário nem a disponibilidade para acompanhar todas as mudanças.
- Como parte da implementação de uma segurança de plataforma em várias camadas, criamos novos componentes de software que solucionaram três problemas críticos de uma forma totalmente inovadora: a inicialização segura de uma identidade universal que não enfrenta o problema da regressão infinita (“turtles all the way down”); segredos que podem ser armazenados e distribuídos sem a preocupação de que um cofre central seja comprometido (problema da mina de ouro); e o gerenciamento distribuído de chaves para facilitar a proteção dos dados em repouso.
Contexto do problema de segurança
Como mencionado acima, o problema de proteger o acesso dos usuários a aplicativos (por exemplo, o acesso às nossas contas bancárias ou aos nossos e-mails) é bem compreendido. No entanto, fazer o mesmo para o acesso entre aplicativos ou entre aplicativos e dados não é tão simples, pois não há nenhuma pessoa envolvida no processo de verificação.
Para que uma aplicação acesse outro recurso de forma segura — por exemplo, dados armazenados em um armazenamento de objetos ou faça uma chamada de API para outra aplicação etc. —, é necessário que ocorra o seguinte:
- Identidade — o solicitante precisa obter de forma segura uma identidade verificável que possa ser usada para fins de autenticação e autorização ao acessar os recursos necessários. O solicitante também precisa receber, de forma segura, as âncoras de confiança necessárias para verificar as identidades dos pares.
- Autenticação — No processo de acesso a um determinado recurso, o solicitante e o proprietário do recurso precisam verificar com segurança a identidade um do outro. O processo de verificar a identidade alegada por uma parte em relação à identidade apresentada é chamado de Autenticação.
- Autorização — depois que o solicitante é autenticado, o processo de verificar se ele tem permissão para acessar o recurso (ou não) é chamado de Autorização.
Como parte do processo de autenticação, o aplicativo solicitante pode apresentar sua identidade na forma de um certificado de PKI, um segredo (por exemplo, uma senha) ou uma chave. Há duas questões que precisam ser consideradas ao usar segredos ou uma chave como forma de identificação:
- Os segredos e as chaves não devem ser armazenados diretamente no código, pois isso cria um vetor de ataque fácil de explorar, e o vazamento de chaves pode ser um grande problema.
- Se os segredos forem armazenados em um cofre externo, qual identidade (geralmente outro segredo) deve ser usada para obtê-los e como podemos proteger essa identidade?
Executar essas operações de segurança (para a interação entre aplicativos) de maneira confiável e reproduzível é um problema complexo. Há muitos motivos para essa complexidade:
- Aplicações podem ser facilmente clonadas e replicadas (por exemplo, microsserviços). Como atribuir uma identidade única a cada clone, que pode ser necessária para fins de análise forense, auditoria ou observabilidade?
- A identidade da aplicação será diferente dependendo do ambiente em que ela estiver sendo executada. Por exemplo, nos ambientes de desenvolvimento e produção, a aplicação é a mesma, mas precisa ter uma identidade diferente em cada ambiente.
- Como estabelecer confiança de que a infraestrutura na qual a aplicação está sendo iniciada não roubará a identidade, os segredos ou as chaves sem que isso seja percebido?
- Como proteger o cofre central contra ataques e garantir a segurança de todos os segredos e chaves armazenados nele?
Como resultado, proteger a infraestrutura, as aplicações e os dados em um ambiente dinâmico é um problema bastante desafiador. Embora os provedores de nuvem tenham enfrentado esse desafio e disponibilizado diversas ferramentas para lidar com esses problemas, integrá-las e mantê-las não é fácil pelos seguintes motivos:
- Complexidade — Cada provedor de nuvem exige que o cliente configure e gerencie vários serviços. Por exemplo, na AWS: serviço de metadados, funções do IAM, conta de serviço, RBAC, KMS e gerenciador de segredos. Cada um desses serviços varia muito entre os provedores de nuvem, tanto em termos de semântica quanto de APIs e monitoramento.
- Interoperabilidade — Mesmo quando os serviços dos provedores de nuvem estão configurados e em operação, nenhum deles permite a interoperabilidade. Por exemplo, uma VM em execução no GCP não pode acessar um recurso na AWS porque a identidade atribuída por meio da conta de serviço do GCP não é reconhecida por um recurso da AWS.
- Ambientes heterogêneos — Se o ambiente estiver distribuído entre nuvens públicas e privadas, entre várias nuvens públicas ou — pior ainda — na borda, o desafio será definir como e onde armazenar segredos, como senhas, chaves etc. — de forma centralizada ou distribuída.
- Específico do ambiente — A solução para rotação e/ou revogação de credenciais é muito diferente em cada provedor de nuvem, enquanto nada disso existe para clusters de borda.
Embora muitas empresas utilizem um único provedor de nuvem e talvez seja suficiente para elas investir recursos no gerenciamento e aprimoramento dos mecanismos básicos de segurança desse provedor, operamos em um ambiente heterogêneo (nuvem híbrida e edge) e tivemos que desenvolver uma nova solução para resolver esses problemas.
Solução para proteger uma plataforma distribuída
Nossa equipe recebeu a tarefa de garantir a segurança dos aplicativos, da infraestrutura e dos dados que podem estar distribuídos por uma infraestrutura descentralizada, conforme mostrado na Figura 1.
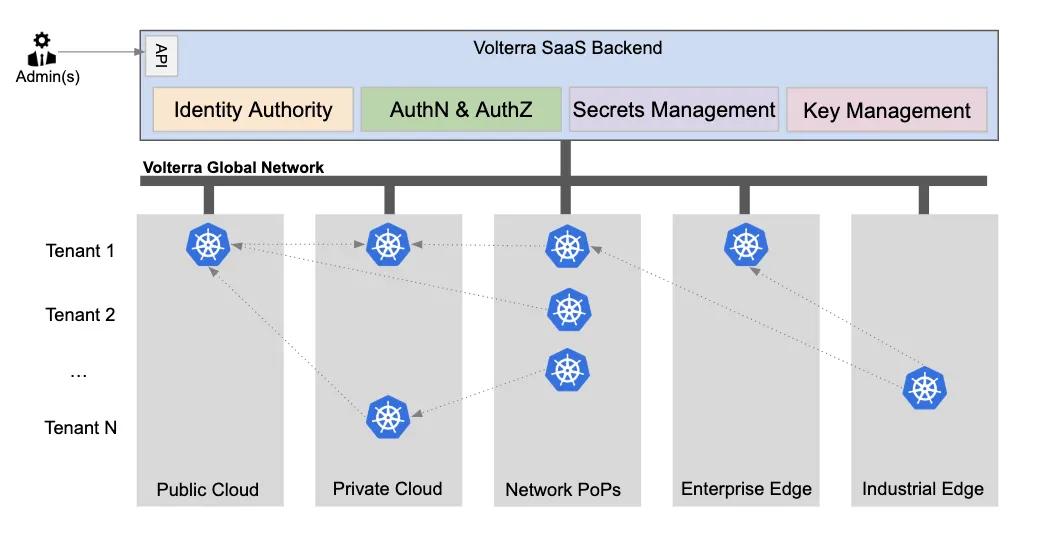
Como resultado, nossa equipe de plataforma decidiu desenvolver novos serviços de software que integrassem os quatro aspectos a seguir para garantir a segurança da plataforma na borda, em qualquer nuvem e em nossos PoPs de rede:
- Gerenciamento de identidades — descreveremos como fornecemos uma identidade baseada em PKI, criptograficamente segura e impossível de falsificar, não apenas para aplicações, mas também para a infraestrutura distribuída em um ambiente heterogêneo (várias nuvens, nossos PoPs globais e locais de borda geograficamente dispersos) e que opera em vários ambientes (por exemplo, máquina de desenvolvimento, teste unitário, produção etc.)
- Autenticação e autorização — nossa infraestrutura é baseada em microsserviços que utilizam uma identidade baseada em PKI e autenticam mutuamente todas as comunicações, independentemente do protocolo de comunicação utilizado. Também desacoplamos a autorização da autenticação para que um mecanismo de autorização comum possa ser usado para diversos tipos de decisão de autorização e para que a estrutura das políticas possa ser unificada.
- Sistema de gerenciamento de segredos — há muitos tipos de segredos (como certificados TLS, senhas, tokens etc.) necessários tanto para o nosso software quanto para as cargas de trabalho dos clientes. O método mais simples teria sido adotar um cofre centralizado para armazenar todos os segredos, mas essa abordagem apresentava a desvantagem de que qualquer comprometimento revelaria todos eles. Descreveremos uma abordagem diferente que implementamos para alcançar um nível mais elevado de segurança, abrindo mão de parte da simplicidade.
- Sistema de Gerenciamento de Chaves (KMS) — a segurança dos dados é fundamental para o nosso sistema distribuído, e a equipe precisou desenvolver um KMS que funcionasse perfeitamente entre diferentes provedores de nuvem. O KMS precisa gerenciar, versionar e rotacionar chaves usadas para criptografia e descriptografia simétricas de dados em repouso, geração de HMAC de tokens CSRF e assinatura digital de binários. Discutiremos como oferecemos recursos tanto para operações sensíveis à segurança, usando esse KMS, quanto para operações sensíveis à latência, usando o sistema de gerenciamento de segredos.
Identidade infalsificável para infraestrutura e aplicativos
A identidade é uma questão fundamental, pois muitos desafios de segurança podem ser enfrentados com mais facilidade quando o problema da identidade é resolvido. No entanto, para resolver essa questão, precisamos definir o que entendemos por identidade e como emiti-la de maneira confiável. Os geeks de criptografia gostam de dar seu toque particular a tudo, e a definição de identidade não é exceção:
O conjunto único e completo de características infalsificáveis e verificáveis criptograficamente certificadas criptograficamente por uma autoridade confiável, por meio de um protocolo seguro e sem delegação, que constituem aquilo que uma pessoa ou coisa é conhecida ou considerada ser.
Em essência, o que é necessário é uma identidade infalsificável e verificável criptograficamente, fornecida de forma segura. Emitir uma identidade desse tipo é um desafio por dois motivos: 1) inicialização da identidade e 2) raiz de confiança
Há algumas abordagens frequentemente discutidas em relação à identidade — SPIFFE e Hashicorp Vault. Gostaríamos de esclarecer que o SPIFFE é um esquema de nomenclatura que poderia ser usado em nosso sistema como um documento de identidade (certificado X.509) — no entanto, o formato não é adequado para alguns atributos de identidade que contêm dados binários. Embora o Vault possa ser usado para emitir um documento de identidade, ele não resolve os desafios da inicialização da identidade e do problema da raiz de confiança:
- Inicialização da identidade — na vida real, quando uma pessoa nasce, sua identidade é estabelecida pela certidão de nascimento. Isso inicializa logicamente a identidade da pessoa e, usando essa certidão, ela pode obter/solicitar outros documentos de identidade, como passaporte, carteira de motorista etc. Da mesma forma, no mundo da computação, toda inicialização de uma aplicação (ou de um microsserviço) precisa estabelecer uma identidade inicial. O estabelecimento da identidade é uma das primeiras etapas que qualquer código em execução precisa realizar para poder interagir com outros serviços. Além disso, como o mesmo código da aplicação pode ser iniciado várias vezes e em diferentes ambientes `(notebook do desenvolvedor vs. teste unitário vs. produção), também é necessário que cada uma dessas inicializações estabeleça uma identidade inicial distinta.
- Raiz de confiança — embora a emissão de uma identidade de inicialização possa parecer um processo simples, a questão é quem será responsável por provisionar essa identidade. Por exemplo, no mundo real, o provisionamento da identidade começa quando o hospital atesta que uma criança nasceu em determinada data e hora, de uma pessoa específica, partindo-se do pressuposto de que o hospital emite o registro de nascimento após as devidas verificações e que esse registro não pode ser falsificado. Assim, o documento de registro de nascimento pode ser usado como fonte da verdade (ou raiz de confiança). Da mesma forma, quando um aplicativo é iniciado por uma pessoa ou por um código automatizado, deve haver uma raiz de confiança capaz de atestar, de forma verificável, a identidade do aplicativo iniciado. Essa declaração pode então ser usada para gerar posteriormente um documento de identidade para o aplicativo.
Por exemplo, quando uma VM é iniciada na AWS, ela recebe uma identidade de inicialização, e o serviço de metadados da AWS atua como raiz de confiança. O documento de identidade (assinado pela AWS com sua própria chave criptográfica) tem uma aparência semelhante a esta:
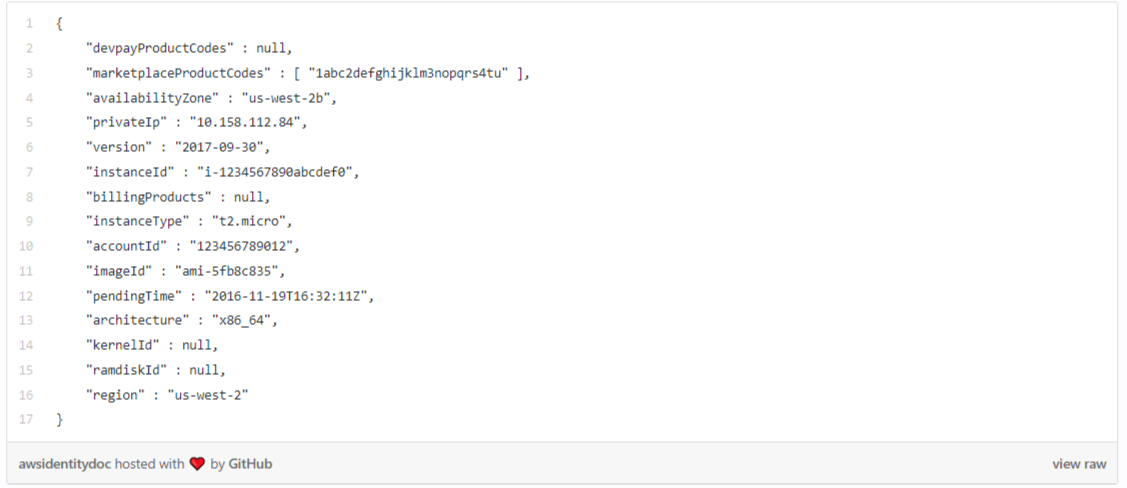
Embora o instanceId possa representar a identidade exclusiva da instância do aplicativo que foi iniciada, ele precisa ser vinculado a algum nome conhecido (myserver.acmecorp.com) que outros aplicativos usarão para se comunicar com essa instância específica. Como resultado, mesmo esse documento de identidade de inicialização da AWS é insuficiente, mas pode ser usado para emitir outra identidade que os aplicativos possam usar para se comunicar com outro aplicativo.
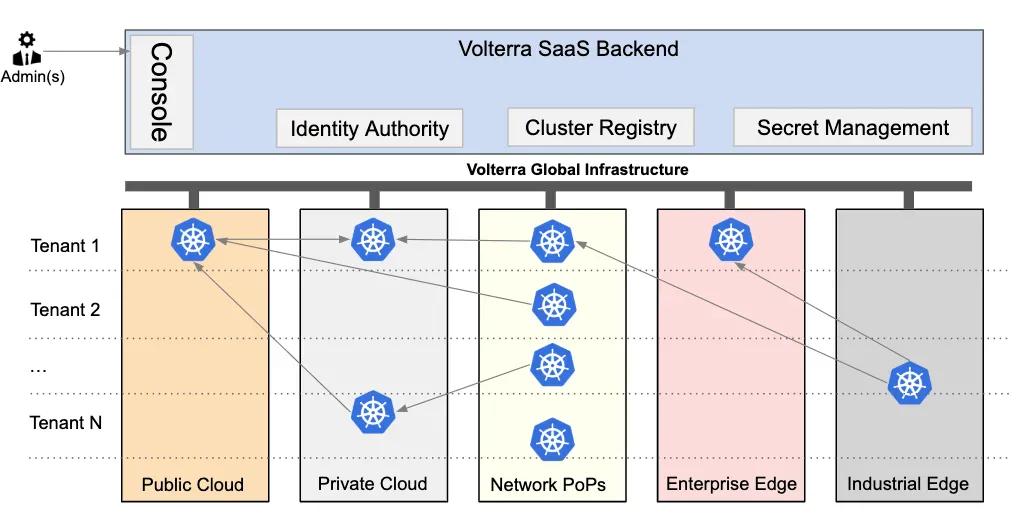
Como mencionado anteriormente, era fundamental para nós fornecer uma identidade que permitisse aos aplicativos se comunicar e compartilhar informações entre provedores de nuvem e/ou locais de borda (Figura 2). Isso significava que precisávamos criar um sistema tanto para a inicialização de identidade quanto para a raiz de confiança que funcionasse em todos esses ambientes.
Como usamos o Kubernetes para gerenciar e orquestrar aplicações (tanto microsserviços quanto VMs), foi necessário integrar a inicialização de uma identidade exclusiva para cada pod iniciado ao processo de criação de Pods do Kubernetes. A Figura 3 mostra como nos integramos ao processo de criação de pods usando o mecanismo de webhook do K8s. Esse webhook, chamado Voucher, injeta um sidecar de segurança chamado Wingman em todos os Pods criados no cluster e também fornece as informações necessárias, assinadas criptograficamente, que podem ser usadas como raiz de confiança. Esse webhook fornece um token assinado de curta duração, usado pelo Wingman para solicitar um certificado X.509 à Autoridade de Identidade no backend SaaS da Volterra.
A Autoridade de Identidade aplica as regras de emissão da identidade de forma a minimizar o “raio de impacto” caso um dos clusters K8s seja comprometido. Muitas outras soluções que dependem de uma CA raiz comum ou da federação de clusters K8s não conseguem limitar o raio de impacto, o que foi um fator determinante em nossa decisão de projeto.
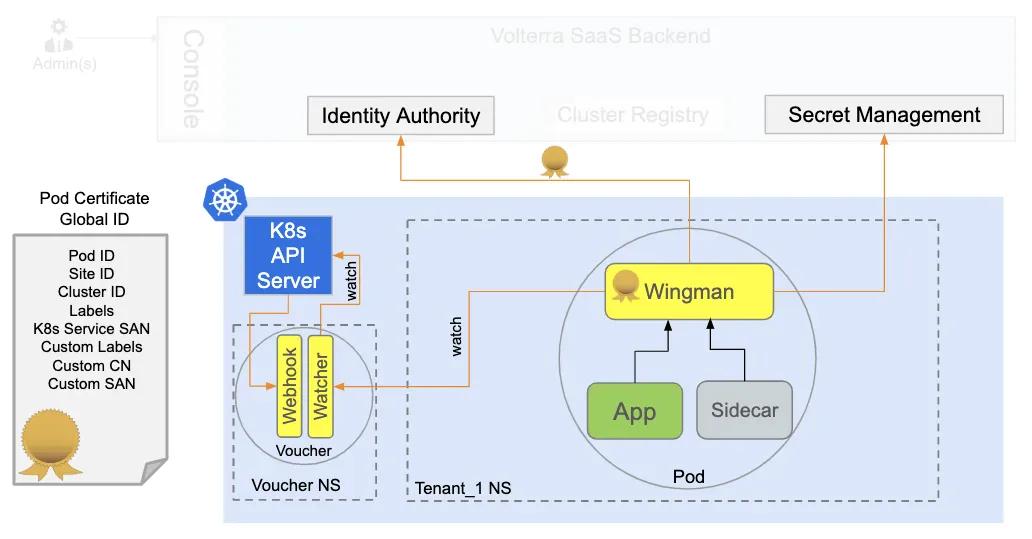
Para um determinado Pod no K8s, os atributos podem mudar após a criação do Pod — por exemplo, um Pod pode ser associado a um novo serviço após sua criação. Isso significa que os certificados de identidade precisam ser atualizados com o novo serviço. O Wingman monitora continuamente o Voucher, que acompanha o servidor de API do K8s, em busca dessas atualizações.
Esse mecanismo fornece uma identidade global única e universal a cada instância de aplicação executada em nossa plataforma, independentemente de se tratar de uma carga de trabalho nossa ou de um cliente. Essa identidade única e o sidecar (Wingman) são então usados para proteger todas as comunicações, os acessos e as chaves e os segredos em um sistema distribuído.
Autenticação e autorização
Ter uma identidade exclusiva por Pod é um ótimo começo, pois facilita a implementação da autenticação mútua entre os serviços que se comunicam. Nossa infraestrutura subjacente é composta por diversos serviços que utilizam diferentes protocolos, como gRPC, REST, IPSec, BGP etc. Desde o início, a equipe estabeleceu como meta garantir a autenticação mútua e a segurança da comunicação (canal criptografado) para todas as partes envolvidas, independentemente do protocolo. Isso também significava que não podíamos vincular nossa identidade a uma solução (por exemplo, o Istio) limitada a um conjunto específico de protocolos (por exemplo, HTTP/TCP em vez de protocolos baseados em IP).
Como nossa plataforma também permite que os clientes executem as cargas de trabalho que desejarem, esperamos que essas cargas possam usar diversos protocolos, e a plataforma não deve limitar essa capacidade fornecendo uma identidade restrita a um conjunto específico de protocolos. Em vez disso, a autenticação é desacoplada da identidade (por meio do Wingman), o que possibilita a integração com diversas tecnologias de malha de serviços. O sidecar/plano de dados da nossa malha de serviços (abordado em uma publicação anterior do blog) usa essa identidade para fornecer mTLS às cargas de trabalho dos clientes.
Como muitos dos nossos próprios serviços de infraestrutura foram desenvolvidos usando o Volterra Golang Service Framework (que será abordado em um futuro post no blog), decidimos incorporar diretamente ao framework a lógica de consumo da identidade (proveniente do Wingman). Isso ajudou nossos desenvolvedores a proteger, de forma nativa, as comunicações entre serviços sem depender de um sidecar de service mesh para mTLS.
A próxima etapa lógica após estabelecer um canal seguro com autenticação mútua é a autorização — um processo pelo qual o destinatário da solicitação (servidor) determina se deve ou não permitir a solicitação proveniente do chamador identificado (cliente). Pode haver vários motivos para não permitir a solicitação — limitações de cota, permissões etc. Como esses motivos e seus limites mudam dinamicamente, um conjunto de regras (política) de autorização codificado de forma rígida era inviável para a nossa plataforma.
Decidimos usar o mecanismo do Open Policy Agent como ponto de partida e criamos uma camada de abstração para autorização no sidecar Wingman. O código dessa camada busca dinamicamente as políticas relevantes e as mantém prontas para uma avaliação rápida. Assim como na Autenticação, desacoplar o mecanismo de Autorização da identidade (e da Autenticação) nos permitiu aplicar políticas de autorização em várias etapas do processamento das solicitações, inclusive nas camadas mais profundas da lógica de negócios, e não apenas logo após a autenticação.
Como o Wingman está presente em todas as cargas de trabalho, inclusive nas dos clientes, nossa plataforma oferece um mecanismo de autorização como recurso integrado. Embora o Open Policy Agent (OPA) seja baseado em uma linguagem poderosa chamada Rego, queríamos ocultar sua complexidade de nossos desenvolvedores e clientes. Todas as políticas da nossa plataforma também podem ser definidas por meio de uma estrutura de políticas muito mais intuitiva e fácil de entender, que dispensa os usuários (DevOps) de aprender Rego, evitando assim erros. Assim como na configuração da autenticação, nosso framework de serviços em Golang foi integrado ao mecanismo de autorização do Wingman, chamando-o automaticamente para realizar a autorização e ocultando dos desenvolvedores a complexidade desse processo.
Usando uma identidade exclusiva (emitida pelo Wingman) para autenticação e um mecanismo de políticas programável (integrado ao Wingman) para autorização, podemos proteger a comunicação usando mTLS e controlar cada acesso por meio de uma política robusta e programável.
Gerenciamento de segredos sem um cofre centralizado
Todos os dias, engenheiros cometem erros involuntários ao armazenar chaves e senhas no código, que, de alguma forma, acaba chegando a repositórios públicos de código ou de artefatos. Gerenciar segredos é difícil e, sem um conjunto de ferramentas fácil de usar e um processo bem definido, os desenvolvedores tendem a seguir o caminho mais curto. Por isso, desde o início da empresa, a missão da nossa equipe de segurança de plataforma (diferente das equipes de segurança de rede e de aplicações) tem sido garantir que os desenvolvedores não precisem fazer perguntas como: “Onde devo armazenar segredos — no código-fonte, em artefatos ou...?”
Quando começamos a desenvolver nossa plataforma, avaliamos duas abordagens comuns disponíveis para o gerenciamento de segredos, e ambas apresentavam algumas limitações:
- Secrets do Kubernetes — Embora usemos o Kubernetes e ele venha com sua própria solução de gerenciamento de secrets, ela não é particularmente útil por vários motivos — os secrets não são criptografados em repouso, os mecanismos de políticas não são abrangentes e a solução não atende a cenários com vários clusters.
- Cofre centralizado (por exemplo, Hashicorp ou Cyberark Vault) — Outra abordagem seria usar um cofre no qual os segredos fossem armazenados de forma centralizada e fornecidos aos solicitantes autorizados. Os segredos são protegidos por uma única chave de criptografia, usada para criptografar o armazenamento do cofre. No entanto, o problema dessa abordagem é que o sistema de gerenciamento de segredos tem acesso aos segredos em texto simples (mesmo que sejam armazenados de forma criptografada), e qualquer comprometimento do sistema poderia expor todos os segredos.
No nosso caso, por se tratar de um serviço SaaS, tivemos que desenvolver um método mais robusto para proteger os segredos dos nossos clientes, pois nenhuma violação deveria expô-los.
Como resultado, decidimos implementar uma nova técnica que chamamos de Volterra Blindfold (marca registrada), que funciona em conjunto com nosso sidecar de segurança, o Wingman, conforme mostrado na Figura 4. Essa abordagem permite que o proprietário do segredo o bloqueie (criptografe) de modo que ele nunca seja revelado em texto simples a nenhuma parte indesejada (incluindo o servidor de descriptografia). O segredo nem sequer é armazenado em um servidor central de descriptografia e, em alguns aspectos, esse modelo simplifica drasticamente a arquitetura do servidor.
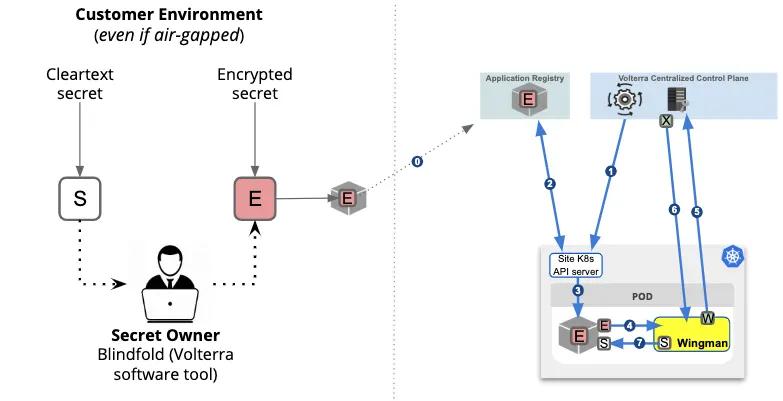
Fornecemos aos usuários uma ferramenta de blindagem que pode ser usada em um ambiente totalmente offline para criptografar o segredo (S), que então pode ser distribuído — por exemplo, o próprio segredo pode ser armazenado junto com a carga de trabalho e enviado ao registro. Feito isso, as seguintes etapas precisam ser realizadas:
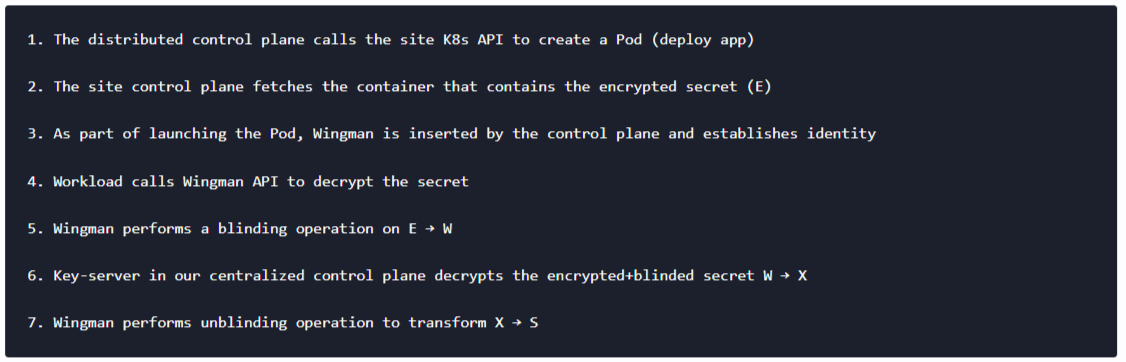
Isso garante que o plano de controle centralizado nunca tenha acesso ao segredo em texto simples (S) e que o segredo esteja disponível apenas na memória de execução do Pod durante o período de acesso. Além disso, uma política de acesso pode ser aplicada para definir quem terá acesso a um segredo. A política pode ser definida com base em atributos de identidade, como nome da aplicação, localização, nível de conformidade etc. Dessa forma, é possível delimitar qualquer subconjunto complexo de cargas de trabalho e obter um controle de acesso preciso. A política é incorporada criptograficamente aos processos de criptografia, ofuscação, descriptografia e desofuscação — é computacionalmente inviável contornar a finalidade da política.
Usando nossa técnica exclusiva Blindfold para bloquear cada segredo e o Wingman para desbloqueá-lo com base em políticas e em uma identidade infalsificável, conseguimos superar os problemas das soluções existentes e oferecer o gerenciamento de segredos em um ambiente distribuído, sem jamais nos preocuparmos com o comprometimento do repositório central.
Gerenciamento de chaves para sistemas distribuídos
Embora o gerenciamento de segredos e o gerenciamento de chaves possam parecer dois nomes diferentes para o mesmo problema, há diferenças sutis (mas importantes na prática) entre eles, dependendo de quem você consulta e de como se pretende implementar as soluções.
Segredo refere-se a qualquer informação que deva ser mantida em sigilo e não esteja disponível para partes não autorizadas. De certa forma, as chaves criptográficas são um tipo específico de segredo. Já o gerenciamento de chaves geralmente se refere a um sistema que armazena com segurança materiais criptográficos sensíveis e controla seu uso. Em alguns casos, o sistema de gerenciamento de chaves pode fornecer os bytes brutos da chave a partes autorizadas e, por isso, pode ser confundido com um sistema de gerenciamento de segredos. Na maioria dos casos, porém, o sistema de gerenciamento de chaves não fornece os bytes brutos do material da chave; em vez disso, realiza operações para solicitantes autorizados e envia apenas o resultado da operação. Muitos sistemas de gerenciamento de chaves também utilizam armazenamento em hardware (por exemplo, HSM) para o material da chave, de modo que a chave nunca seja exposta em texto simples ao software.
Em ambientes distribuídos, mesmo quando se utiliza um único provedor de nuvem, gerenciar, sincronizar e rotacionar chaves criptográficas é uma tarefa muito desafiadora, e as soluções atuais são propensas a erros, ineficientes e até mesmo inseguras. Por exemplo, se alguém utiliza atualmente três regiões da AWS e deseja usar a mesma chave criptográfica em todas elas, terá de sincronizar e rotacionar as chaves manualmente. O problema se agrava ainda mais quando o ambiente abrange vários provedores de nuvem (públicos e/ou privados). Mesmo depois de tudo isso, os responsáveis pelas aplicações ainda precisam escrever códigos complexos para utilizar esses recursos de KMS.
Nossa plataforma oculta da aplicação todas as complexidades do gerenciamento de chaves, fazendo com que o sidecar Wingman cuide de todo o trabalho pesado e forneça interfaces simples para que a aplicação faça solicitações de gerenciamento de chaves, incluindo criptografia, descriptografia, HMAC, verificação de HMAC, assinatura digital, verificação de assinatura, obtenção de chave (quando permitido) etc. Isso torna o gerenciamento de chaves muito mais simples tanto para nossos próprios serviços de infraestrutura quanto para as cargas de trabalho dos clientes.
O diagrama a seguir (Figura 5) mostra como o KMS da Volterra funciona em diferentes ambientes e ajuda as cargas de trabalho a transferir o gerenciamento de chaves e as operações criptográficas para o sidecar Wingman. Dependendo da configuração, o Wingman pode armazenar chaves em cache e atualizar o cache sem que a aplicação sequer perceba. O fator que viabiliza isso é a identidade universal e infalsificável que apresentamos anteriormente. Como cada Pod, independentemente de sua localização, recebe uma identidade globalmente exclusiva, o sistema KMS da Volterra consegue aplicar com grande precisão políticas de acesso a chaves criptográficas e a operações específicas, como criptografia, descriptografia, HMAC, verificação de HMAC, assinatura digital e verificação de assinatura.
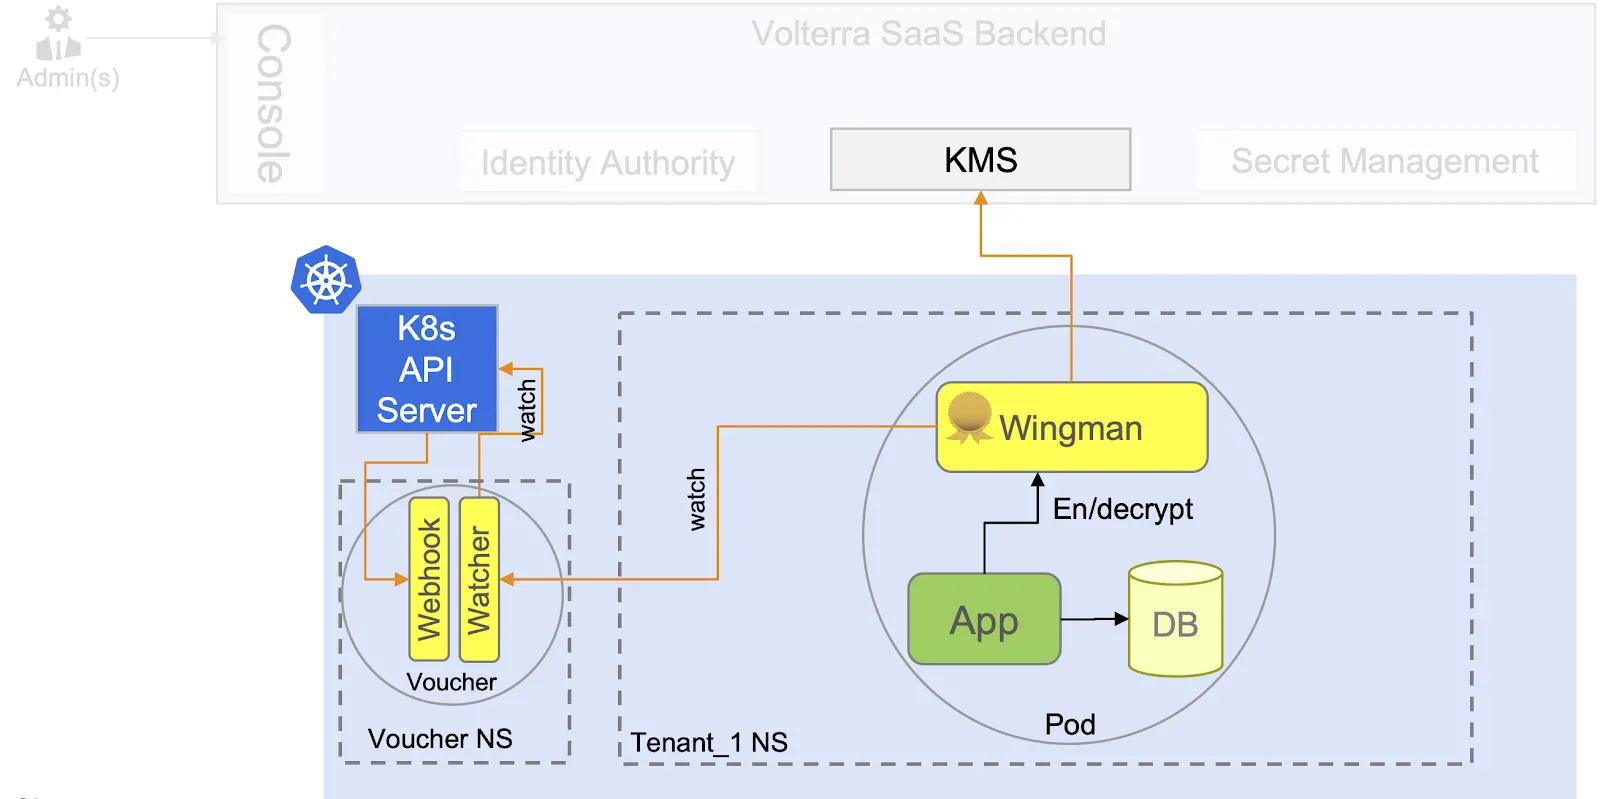
Como todas as chaves são gerenciadas pelo backend SaaS da Volterra, as cargas de trabalho executadas em ambientes heterogêneos não precisam lidar com sincronização, rotação, revogação de chaves etc. — elas só precisam conhecer as APIs simples do Wingman para atender a todas as suas necessidades de segurança de dados em repouso.
Benefícios proporcionados por nossa solução de segurança de plataforma
Com o uso de segurança de plataforma em várias camadas, conseguimos oferecer uma solução abrangente para três problemas críticos de uma forma totalmente nova! Nosso sistema é capaz de inicializar com segurança uma identidade universal que não sofre do problema de “tartarugas até o fim”, gerenciar segredos que podem ser armazenados e distribuídos sem a preocupação com o problema da mina de ouro e fornecer gerenciamento de chaves para facilitar a proteção de dados em repouso em um ambiente distribuído. Isso trouxe os seguintes benefícios para nossas equipes internas e nossos clientes:
- Segurança e conformidade — identidade universal e impossível de falsificar, Blindfold e sidecar de segurança (Wingman), totalmente integrado e gerenciado automaticamente pela plataforma para proteger todas as comunicações, autorizar cada acesso e gerenciar chaves/segredos em um sistema distribuído. Com esses avanços, conseguimos oferecer uma solução de segurança mais robusta, que facilitou tanto para nós quanto para nossos clientes o cumprimento dos requisitos de conformidade.
- Melhorias de produtividade — ao usar uma solução de segurança integrada ao nosso processo de DevOps e à nossa estrutura de serviços, desenvolvedores e equipes de DevOps podem se concentrar facilmente em suas entregas sem se preocupar com aspectos essenciais da segurança de aplicações e dados.
- Evolução contínua — o cenário de segurança em constante transformação e as novas tecnologias impulsionam a evolução contínua do Blindfold, do Wingman e do nosso framework de serviços em Golang. Como resultado, a plataforma disponibiliza automaticamente novos recursos, sem exigir alterações na lógica da aplicação.
Continua…
Esta série de posts abordará vários aspectos do que foi necessário para desenvolver e operar nosso serviço SaaS distribuído globalmente, com diversos clusters de aplicações na nuvem pública, nossos PoPs de rede privada e sites de borda. O próximo tema será Segurança de Aplicações e de Redes…
Estamos procurando alguns desenvolvedores e arquitetos de soluções voluntários para nos ajudar a disponibilizar esse recurso para uma comunidade mais ampla como um projeto de código aberto. Entre em contato diretamente pelo e-mail asingla@volterra.io caso tenha interesse em participar de algo divertido!
Sobre o autor
Publicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...