
Hay un dicho en el ámbito militar: «Los aficionados hablan de táctica, pero los profesionales estudian logística». Esta idea puede resultar sorprendente a primera vista, si pensamos en la brillantez de Lee en Chancellorsville o en el genio de Aníbal durante las guerras púnicas; sin embargo, la historia demuestra que ni Lee ni Aníbal ganaron sus respectivas guerras. La principal razón fue la logística: la capacidad de abastecer a un ejército de alimentos, ropa y armas en el momento y el lugar adecuados. Pese a sus brillantes tácticas, fue la logística la que, en última instancia, decidió la victoria. En otras palabras, la táctica permite aprovechar al máximo los recursos disponibles sobre el terreno, pero la logística es lo que permite llegar a él y permanecer allí.
Me gusta la analogía militar porque creo que guarda paralelismos con la forma en que suelen presentarse hoy en día las soluciones basadas en datos. El atractivo de las «tácticas» —técnicas avanzadas de IA como el aprendizaje profundo, la clasificación mediante bosques aleatorios, el boosting de gradiente, etc.— suele eclipsar la «logística», menos llamativa, de los fundamentos de la arquitectura de datos que hacen posibles esas técnicas avanzadas.
El primer paso para hablar de arquitectura de datos es definir qué abarca el concepto de «arquitectura de datos». Como era de esperar, la respuesta tiene sus matices: consta de varias capas y facetas. Para sentar las bases del debate, resulta útil empezar por analizarlo desde la perspectiva del recorrido que siguen los datos de telemetría recopilados. El diagrama siguiente muestra un flujo de datos de alto nivel y destaca los puntos de contacto entre dicho flujo y los fundamentos de la arquitectura de datos.
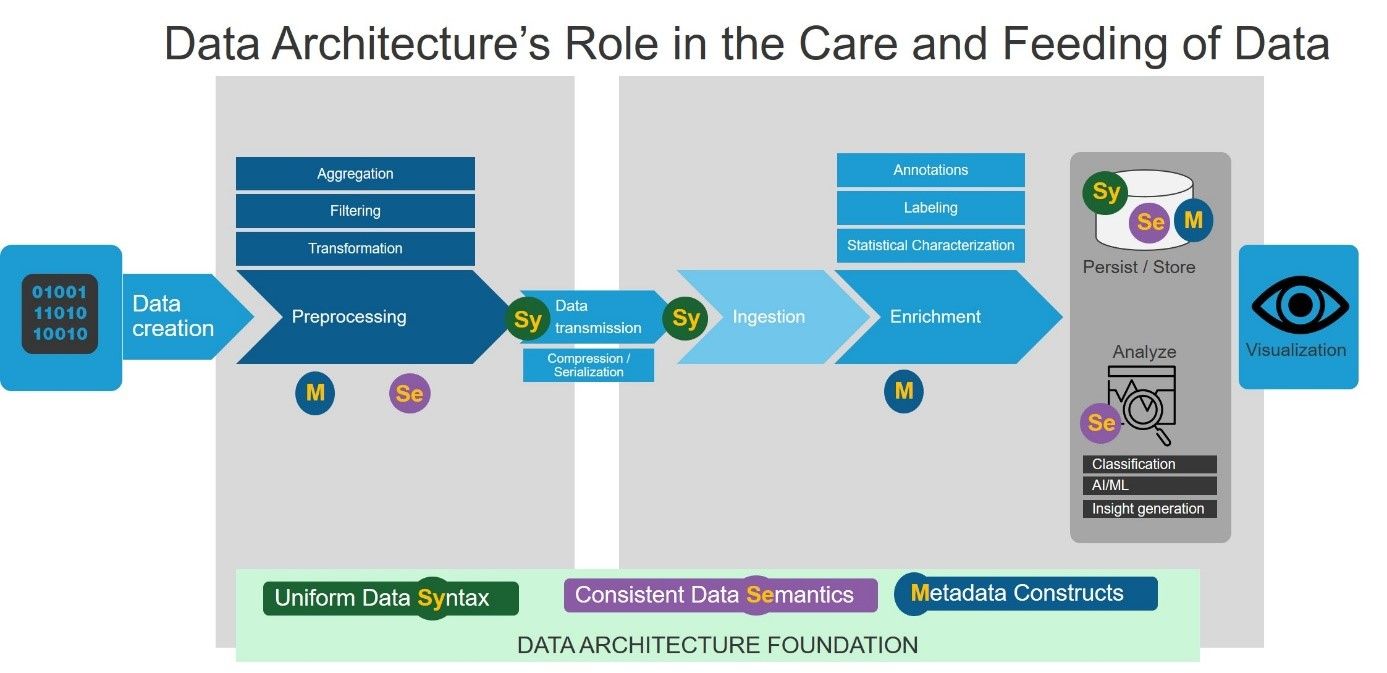
El recorrido de cada elemento de datos comienza con su creación, a la que suele seguir cierto preprocesamiento antes de serializarlo y transmitirlo a un recopilador/agregador de datos, normalmente alojado en la nube. A continuación, el propio recopilador de datos puede realizar (tras la deserialización y la ingesta) tareas adicionales de procesamiento y enriquecimiento antes de enviar los datos a un almacén persistente o incorporarlos a un flujo de análisis de datos, o ambas cosas. Por último, los resultados enriquecidos o analizados se ponen a disposición de los usuarios mediante una plataforma de visualización, e incluso pueden ser utilizados por sistemas automatizados como datos de retroalimentación para sistemas de bucle cerrado con capacidad de autoajuste o autorreparación.
Una vez establecido el contexto de la canalización de datos, podemos retomar la cuestión de qué se entiende por «arquitectura de datos». La primera respuesta, en el nivel más superficial, se centra en la representación de los datos y la sintaxis de serialización. Por ejemplo, si un evento de datos contiene un campo de objeto denominado «cliente», la perspectiva sintáctica determina si esos datos se representan como una cadena, un UUID entero o de alguna otra forma.
Sin embargo, si profundizamos un poco más, una segunda respuesta va algo más allá de la mera sintaxis: se refiere a la semántica de los datos, es decir, a disponer de una interpretación bien definida y coherente de su contenido. Una vez más, tomando como ejemplo el campo «customer», supongamos que ya se ha resuelto la cuestión sintáctica y que, en efecto, el elemento de datos se ha definido como un campo de cadena de texto. A continuación, la arquitectura de datos debe poder responder a la cuestión de su significado o interpretación: ¿su semántica corresponde al nombre de una persona o al de una empresa? Si se trata del nombre de una persona, ¿es <last-name>, <first-name> o ambos? Cuando se combinan con una sintaxis uniforme, unas semánticas coherentes permiten que la canalización de datos realice funciones como el filtrado y la agregación de datos de forma genérica y robusta, basándose en una interpretación lógica coherente de su contenido. Además, el almacén de datos también puede realizar fácilmente consultas federadas de datos entre distintas instancias de la canalización de creación de datos, siempre que los datos creados sigan una sintaxis y una semántica coherentes.
Por último, si profundizamos aún más, en muchos casos es importante que la arquitectura de datos cuente con una tercera capacidad: un vocabulario que permita contextualizar la telemetría y razonar sobre los propios datos, es decir, el vocabulario de metadatos. Esto resulta especialmente importante en el contexto de los requisitos de gobernanza de datos empresariales, ya sea para fines de cumplimiento normativo, auditoría o incluso para flujos de trabajo internos que requieran una comprensión integral de los datos gestionados en un almacén de datos. Los metadatos suelen presentarse en forma de anotaciones sobre los datos, y estas anotaciones mantienen el mismo tipo de coherencia sintáctica y semántica que los propios datos. Por ejemplo, los campos de metadatos probablemente se utilizarían para registrar la identidad de la fuente de datos y la cronología del procesamiento de los datos recopilados, a fin de cumplir los requisitos legales de conservación de datos.
Otra forma de utilizar los campos de metadatos en el vocabulario de un esquema de descripción de datos es para analizar aspectos de los propios campos de datos, como la ordinalidad de un elemento de datos o su grado de sensibilidad en materia de privacidad. Volviendo una vez más a nuestro ejemplo del campo de datos «cliente», las anotaciones de metadatos del esquema de datos podrían marcar el elemento de datos como único, mientras que otras anotaciones, en el contexto de un flujo de datos (como el de las transacciones de compra minorista), podrían marcar los elementos de datos como obligatorios y de valor único; es decir, los metadatos se utilizarían para indicar que el campo customerID debe ser único (y poder utilizarse como clave primaria de la base de datos) y que cada evento de compra debe tener asociado uno, y solo uno, customerID. La utilidad del conjunto de capacidades de los metadatos, en el contexto de la canalización de datos, radica en que pueden aprovecharse para añadir anotaciones relativas al cumplimiento normativo de los datos, proporcionar un vocabulario para su enriquecimiento y habilitar flujos de trabajo flexibles de gobernanza para el almacén de datos.
Así pues, en resumen, la respuesta a la pregunta «¿Qué es la arquitectura de datos?» es que consiste, como mínimo, en proporcionar un marco que garantice la coherencia, tanto sintáctica como semántica, de los datos recopilados. Además, una arquitectura de datos sólida también debe incluir una estrategia de metadatos lo suficientemente potente como para no solo especificar restricciones sobre los datos, sino también permitir razonar sobre los propios datos.
Cuando se considera un área de interés específica y se ejecuta correctamente, una arquitectura de datos se asemeja mucho a una buena infraestructura logística militar. Al igual que en el ámbito militar, proporciona una base que multiplica la eficiencia y la solidez de todos los componentes de los sistemas construidos sobre ella, lo que permite aprovechar al máximo esos sistemas más visibles. En el contexto de un sistema de procesamiento de datos, los cimientos de la arquitectura de datos sirven de base para modelos de gobernanza de datos más flexibles y potentes, facilitan el intercambio de datos entre distintas fuentes mediante un almacén de datos sólido y permiten adoptar un enfoque más ágil para incorporar nuevos flujos de datos, favoreciendo así la agilidad empresarial.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.