Ces dernières années, à mesure que la virtualisation, puis la conteneurisation, ont accru la densité des applications sur chaque équipement matériel, nous nous sommes focalisés sur la gestion du trafic est-ouest plutôt que du trafic nord-sud.
Pour ceux qui ne maîtrisent pas encore très bien les schémas de trafic des centres de données, récapitulons : Le trafic nord-sud correspond aux échanges entre utilisateur et application, entre client et serveur, ou entre l’intérieur et l’extérieur du centre de données. Le trafic est-ouest correspond aux échanges de serveur à serveur, d’application à application, de service à service, ou tout simplement au sein du centre de données.
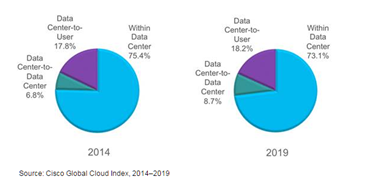
Les schémas de trafic nord-sud sont affectés par l’augmentation du nombre d’utilisateurs, d’applications et d’objets. Plus les connexions entre utilisateurs et applications sont nombreuses, plus le trafic nord-sud augmente. Le trafic est-ouest est influencé par les architectures applicatives et les technologies d’infrastructure. Lorsque vous associez des technologies telles que la virtualisation et les conteneurs à des architectures émergentes comme les microservices, le nombre d’« applications » ou de « services » devant communiquer entre eux augmente de façon exponentielle à travers le centre de données.
En résumé, plus l’architecture d’une application et son infrastructure sont distribuées, plus le trafic est-ouest est important.
Cette augmentation est accentuée par la tendance au « dimensionnement au plus juste » des applications. Au lieu de planifier les capacités en fonction des prévisions de croissance, on les dimensionne selon les besoins actuels, avec une petite marge supplémentaire. Grâce à la maturité croissante de technologies telles que la mise à l’échelle automatique, nous pouvons utiliser les ressources plus efficacement, ce qui réduit les ressources de calcul et de réseau inutilisées qui restent en attente, tout en consommant du budget sans produire une valeur équivalente. C’est d’ailleurs l’un des avantages du cloud privé : il permet de mieux exploiter des ressources qui, autrement, resteraient inutilement inexploitées, grâce à un provisionnement et à une gestion orientés services permettant leur utilisation en temps réel.
Mais je m’égare. L’idée était que, sous l’effet des architectures et des technologies, le trafic est-ouest augmente à un rythme probablement supérieur à celui du trafic nord-sud.
Or, au cours des vingt dernières années, chaque évolution majeure des architectures applicatives et des technologies a entraîné une réaction équivalente au niveau du « réseau ». En effet, le réseau est chargé de gérer le trafic, quelle que soit sa direction. Est-ouest ou nord-sud, peu importe. Qu’il soit virtuel ou physique, le réseau intervient pour garantir que le trafic parvienne de son point d’origine à sa destination.
La question qui se pose désormais, alors que nous observons une augmentation encore plus importante du trafic est-ouest en raison de la décomposition des applications en microservices, est la suivante : comment le réseau doit-il réagir ? Plus précisément, comment les services du réseau doivent-ils s’adapter afin d’assurer les fonctions essentielles (disponibilité, sécurité, optimisation) nécessaires à la mise à disposition des applications auprès des utilisateurs ou, de plus en plus, d’autres applications ?
PREMIER IMPACT : SE RAPPROCHER DE L’APPLICATION
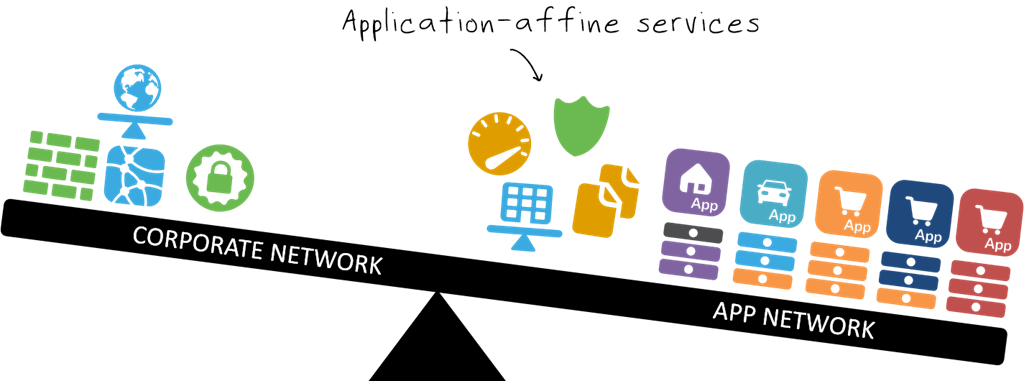
De toute évidence, la première réponse à cette question est que les services étroitement liés aux applications doivent se rapprocher de celles-ci. Ils ne peuvent pas rester à l’extérieur, à la périphérie du modèle nord-sud, tout en fournissant des services à des applications qui les utilisent principalement selon un modèle est-ouest. Cela constitue une utilisation inefficace des ressources réseau, et les schémas de routage qui en résultent augmentent la latence des communications entre applications. C’est là qu’apparaissent des termes comme « tromboning » et « hairpinning », qui désignent des schémas de trafic où le parcours à travers le réseau impose de quitter une machine, de remonter le réseau vers le nord, puis de revenir à cette même machine. Cette latence se traduit par des coûts réels pour l’entreprise, sous la forme d’une baisse de productivité (« un instant, mon “ordinateur” est lent aujourd’hui ») et d’une augmentation du nombre de paniers d’achat et d’applications web abandonnés par les consommateurs. C’est précisément ce que nous voulons éviter : si le trafic circule d’est en ouest, les services doivent se trouver sur ce chemin de données.
DEUXIÈME IMPACT : COMPATIBILITÉ OPÉRATIONNELLE
La deuxième réponse est que ces services, tels que l’équilibrage de charge et la sécurité des applications web, doivent pouvoir être déployés dans des formats compatibles sur le plan opérationnel. En d’autres termes, nous n’allons pas installer du matériel réseau devant chaque application (ou microservice) qui voit le jour. Les plateformes sur lesquelles ces services sont fournis doivent donc être virtualisées ou conteneurisées afin d’être compatibles, sur le plan opérationnel, avec les architectures et technologies émergentes. Elles doivent également être programmables et proposer des API et des modèles permettant d’adopter une approche DevOps du provisionnement et de la gestion. Les services, qu’ils soient applicatifs ou réseau, doivent pouvoir être orchestrés. Le SDN peut lui aussi répondre à ce besoin, à condition de pouvoir s’intégrer aux outils et aux frameworks qui prédominent dans les environnements d’exploitation des infrastructures et des applications.
TROISIÈME IMPACT : L’ARCHITECTURE EST CRUCIALE
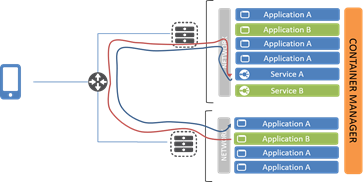
La troisième réponse est que l’architecture devient plus importante que jamais. Ce n’est pas parce qu’un service réseau peut être déployé sur le même hôte que son application qu’il doit nécessairement l’être. Selon sa nature et la manière dont il interagira avec d’autres services (et instances de services), son emplacement devient une question cruciale à prendre en compte. Une architecture d’équilibrage de charge mal conçue, par exemple, peut engendrer des schémas de trafic désastreux qui entraînent une latence inutile ; une latence qui se traduit directement par des bénéfices — ou des pertes — pour l’entreprise. Dans ce scénario, toute défaillance (matérielle, logicielle, réseau ou de stockage) sur l’hôte où les services sont déployés entraîne une interruption de service (particulièrement problématique), car les services chargés de garantir la disponibilité des applications sont eux aussi indisponibles. Dans une architecture applicative fortement décomposée (microservices), cela pourrait être catastrophique si ces applications font l’objet de nombreuses dépendances.
Une réflexion approfondie sur l’architecture est nécessaire pour éviter que l’attrait de la solution la plus évidente (et la plus simple) ne conduise à négliger les bonnes pratiques en matière de performances et de disponibilité.
LA MISE EN RÉSEAU RESTE UN EXERCICE D’ARCHITECTURE
La mise en réseau est et reste une démarche architecturale. Il ne s’agit pas seulement de formats physiques : ceux-ci ne sont qu’un moyen de déployer les ressources réseau là où vous en avez besoin, plus rapidement et plus efficacement. L’enjeu réside dans le positionnement de ces ressources et dans son incidence sur tous les éléments situés en amont dans la pile : les services réseau, les services applicatifs, les performances des applications et, en définitive, la réussite — ou l’échec — de l’entreprise.
À l’ère des conteneurs, de la virtualisation et du cloud, la mise en réseau relève autant de l’architecture que de l’exploitation.
À propos de l’auteur

Lori MacVittie est ingénieure émérite et évangéliste en chef au sein du bureau du directeur technique de F5. Elle possède une expertise approfondie dans la fourniture d’applications, les stratégies d’automatisation et les infrastructures. Elle est réputée pour sa capacité à rendre la complexité intelligible, qu’elle définisse des garde-fous pour les agents d’IA, analyse des architectures multicloud fragiles ou explore les limites des systèmes évolutifs. Elle cumule plus de trente ans d’expérience dans le secteur, couvrant le développement d’applications, l’architecture informatique ainsi que l’exploitation des réseaux et des systèmes. Avant de rejoindre F5, elle a été rédactrice spécialisée dans les technologies et a reçu plusieurs distinctions. MacVittie est titulaire d’un master en informatique et est une autrice prolifique dont les publications couvrent la sécurité, le cloud et l’architecture d’entreprise. Elle est également une passionnée de jeux de société et de jeux vidéo, et assume pleinement ses avis bien tranchés sur le fromage.
Autres articles de Lori Mac VittieArticles de blog associés

F5 NGINXaaS pour Google Cloud : des applications résilientes et évolutives
Découvrez comment NGINXaaS s’intègre à Google Cloud pour renforcer les performances et la sécurité, et préparer vos applications critiques à un avenir propulsé par l’IA.

L’intégration de F5 Web Application Firewall (WAF) à AWS est disponible dès aujourd’hui
En faisant appel à un partenaire de déploiement AWS WAF tel que F5, vous pouvez renforcer la sécurité de vos applications web grâce à des règles personnalisées qui bloquent les schémas d’attaque courants, comme les injections SQL ou les attaques par scripts intersites (XSS).
Appliquer le principe de Peter Parker à l’inspection TLS
« Un grand pouvoir implique de grandes responsabilités. » Si l’on en trouve des échos chez Voltaire et Churchill, cette citation est surtout connue grâce aux bandes dessinées Spider-Man, où elle est attribuée à l’oncle Ben. Bien entendu, si cette phrase est si répandue dans la culture populaire, c’est notamment parce qu’elle peut s’appliquer à une multitude de situations et de sujets, y compris à l’inspection TLS.
Le NetOps a besoin de défenseurs, pas d’adversaires
Il est important de reconnaître que les équipes NetOps ne sont pas toujours celles qui font obstacle au déploiement de la dernière nouveauté, application ou service. Les freins à la rapidité sont souvent dus au fait que les organisations n’adoptent pas tous les principes du DevOps lorsqu’elles cherchent à transformer leurs opérations informatiques.
Mise à jour des services applicatifs : sécurité, rapidité et visiteurs suspects
Il est de nouveau temps de nous pencher sur les services applicatifs que les entreprises utilisent réellement pour rendre leurs applications plus rapides et plus sûres. On constate notamment une hausse du recours aux services de protection contre les bots, ainsi que la progression lente mais régulière de HTTP/2. Bien qu’il ne s’agisse pas d’une application…
Les templates prennent le contrôle du cloud
Les modèles s’imposent dans le cloud. Lisez le blog de F5 pour découvrir comment l’infrastructure en tant que code et les API déclaratives automatisent la mise à disposition des applications.